

হাল হাল, বাস্তবে খুব কুল, নতুন, ইউনিক লিনাক্স সফ্টওয়্যার খুঁজে পাওয়া একটি কঠিন কাজ। একটি চোর। এবং "হাল হাল" বলতে আমি আসলে গত চার-পাঁচ বছর বোঝাচ্ছি, এমনকি ডেস্কটপ স্পেসে এনথusiasম এবং ইনোভেশনের ধীর অবনতির শুরু থেকেও। আসলে, একসině finite volume of intellect-এ কতটুকু ভালো জিনিস থাকতে পারে তার একটি লিমিট আছে, কিন্তু মোবাইলে ফোকাসের ভুল শিফট এবং year-of-the-Linux স্বপ্নের ভাঙন ভুলবেন না।
এটি আমার চার বছর পুরনো একটি সফ্টওয়্যার OCRFeeder-এর টেস্টকে valid করে, আমি মনে করি। দুটি কারণে। যদি এটা ভালো হয়, তবে এটা ভালো। দ্বিতীয়, আমি সবসময় optical character recognition-এর প্রগ্রেসে ইন্টেরেস্টেড থাকেছি, এবং আমাদের টুলস (পড়ুন AI) কি এখানে একটিリーズনেবল কাজ করতে পারে। আমি এর সম্পর্কে একসময় বিস্তারিত লিখেছিলাম, এবং ২০১৫ সালে YAGF রিভিউ করেছিলাম। এখন, OCRFeeder এবং এটি কী করতে পারে সেটি দেখি। আমার পেছনে, বীর লিনাক্স যোদ্ধারা।
jpg-এ শব্দ আসে সহজে নয়
আমি প্রোগ্রামটি ইনস্টল করলাম। আপনার যা গ্র্যাব করতে হবে সেসব লাইব্রেরির একটি বড় তালিকা আছে। Ubuntu 18.04-এ, তালিকা কয়েক লাইন ধাপে চলে। আপনি এই প্রোগ্রামের জন্য ডিফল্ট কিট হিসেবে Tesseract OCR engine পাবেন।
The following additional packages will be installed:
blt gir1.2-goocanvas-2.0 gir1.2-gtkspell3-3.0 libgoocanvas-2.0-9 libgoocanvas-2.0-common libgtkspell3-3-0 liblept5 libtesseract4 libyelp0 python-bs4 python-chardet python-enchant python-html5lib python-lxml python-numpy python-olefile python-pil python-renderpm python-reportlab python-reportlab-accel python-sane python-tk python-webencodings tesseract-ocr tesseract-ocr-eng tesseract-ocr-osd tk8.6-blt2.5 unpaper yelp yelp-xsl
Suggested packages:
blt-demo python-gobject python-wxgtk3.0 python-genshi python-lxml-dbg python-lxml-doc gfortran python-dev python-nose python-numpy-dbg python-numpy-doc python-pil-doc python-pil-dbg python-renderpm-dbg python-egenix-mxtexttools python-reportlab-doc python-sane-dbg tix python-tk-dbg
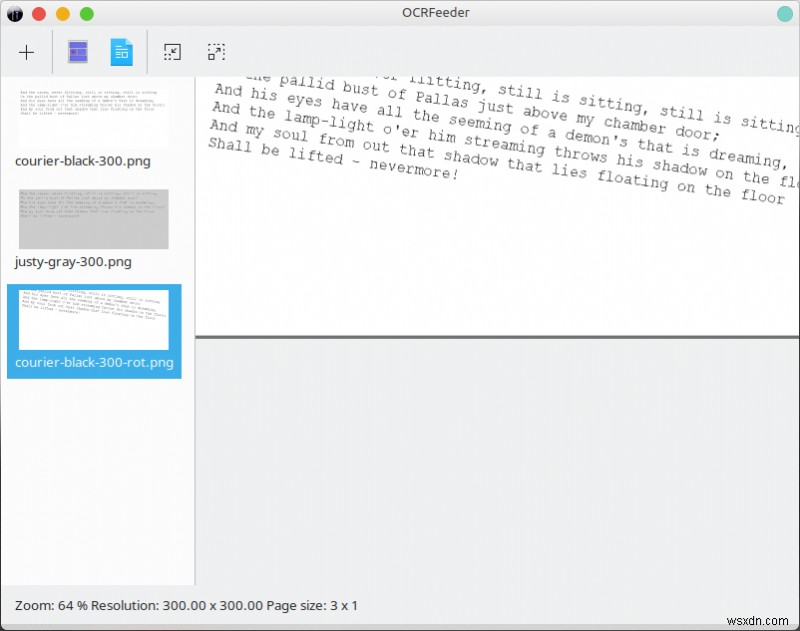
লঞ্চ করলাম। ইন্টারফেস কিছুটা utilitarian। আপনাকে প্রথমে এক বা একাধিক ইমেজ লোড করতে হবে, যেগুলো আপনি আপনার OCR engine-এ ফিড করবেন, এবং আশা করবেন যে অন্য প্রান্তে এটিリーズনেবল-accuracy টেক্সট প্রডিউস করবে। একবার এটি হয়ে গেলে, আপনি টেক্সটটি LibreOffice-এ এক্সপোর্ট করতে পারেন।
OCR ইঞ্জিনগুলো
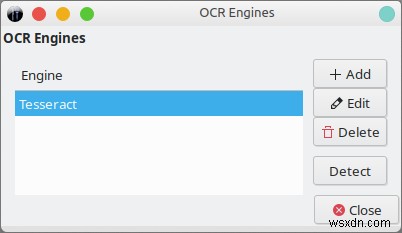
যেমন আমি বললাম, ডিফল্টভাবে OCRFeeder Tesseract ব্যবহার করবে, কিন্তু আপনি যেকোনো অন্য ইঞ্জিন যোগ করতে পারেন। আসলে, আমি CuneiForm, GOCR এবং Ocrad ট্রাই করেছিলাম, এবং প্রোগ্রাম সঠিকভাবে সবগুলো ডিটেক্ট এবং লোড করেছিল। খুব neat। এটি আপনাকে আপনার ডকুমেন্টগুলো একাধিকভাবে ট্রাই করার ক্ষমতা দেয়, কারণ আপনার কিছু ইঞ্জিনের সাথে ভাগ্য ভালো হতে পারে।
sudo apt-get install cuneiform gocr ocrad
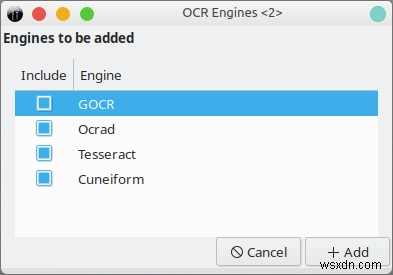
ইমেজ-টু-টেক্সট কনভার্সন
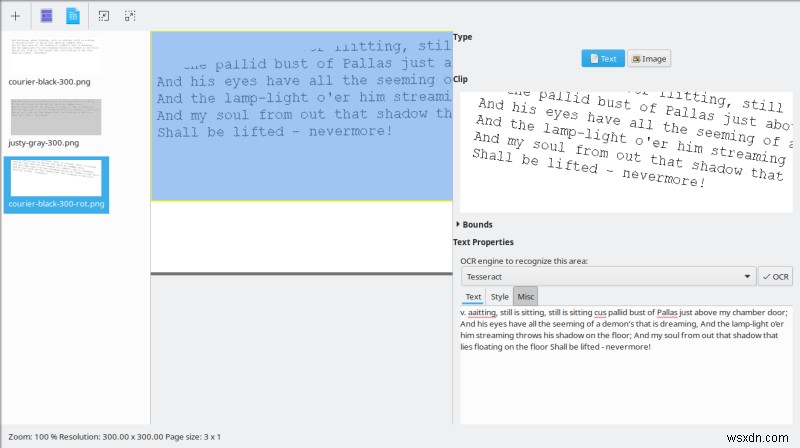
এখন, গুরুত্বপূর্ণ অংশ। আমি এখানে কিছুটা struggle করলাম। আমি প্রোগ্রামকে অটো-ডিটেক্ট টেক্সট (recognize all pages) সকল উপলব্ধ ইমেজে করতে দিলাম, এবং আমি কিছু wired color-marked আউটপুট পেলাম। এই জিনিসটি তিনটি লোডেড PNG ফাইলের জন্য প্রায় তিন মিনিট নিল, এবং সেই সময়ে, OCRFeeder CPU utilization ছিল প্রায় ১৭%, এবং Tesseract প্রায় ৪-৫% ব্যবহার করছিল। তাই টাইম অবশ্যই সংক্ষিপ্ত করা যেতে পারে যদি অ্যাপ্লিকেশন সব প্রসেসর কোর ব্যবহার করার ভালো কাজ করে। তারপর, wired আউটপুট। আমি নিশ্চিত ছিলাম না কী করব। odd। মনে হচ্ছিল আমি কোনো প্রগ্রেস করছি না।
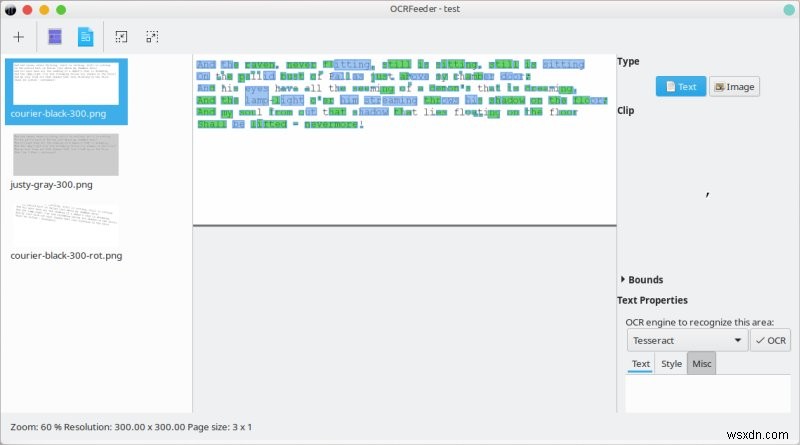
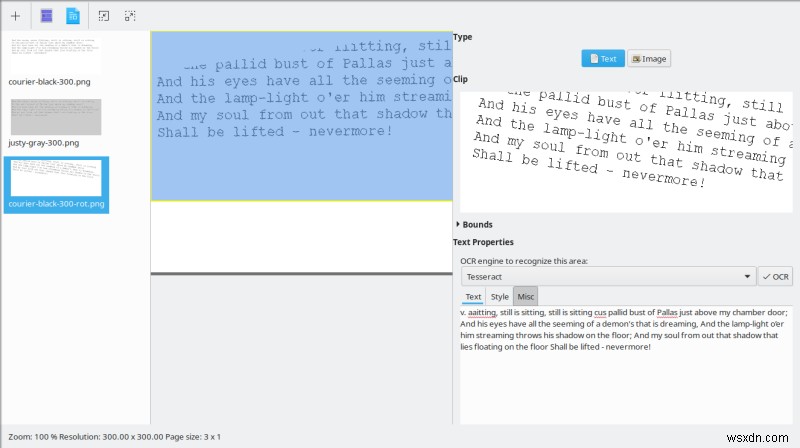
তারপর, আমি বুঝলাম আমি মাউস ব্যবহার করে ডিসপ্লেড ইমেজের অংশগুলো ড্র্যাগ অ্যান্ড সিলেক্ট করতে পারি, এবং তারপর, একটি আলাদা পেন খুলবে, যেখানে আমি ডিজায়ারড OCR ইঞ্জিন চয়ন করতে পারি, এবং একচুটি আসল কনভার্সন চালাতে পারি। ভিজ্যুয়াল গ্লিচছাড়া, এটি reasonably well কাজ করল, এবং প্রতিটি ইমেজ প্রসেস করতে কয়েক সেকেন্ডই লাগল।
কোনো ট্রেনিং বা ডিফল্টস পরিবর্তন ছাড়া, চারটি উপলব্ধ ইঞ্জিনের মধ্যে ফলাফলের variation enorme ছিল। Tesseract সবচেয়ে ভালো - এবং একমাত্র acceptable কনভার্সন দেখাল। বাকিগুলো কেবল ব্যবহার করার জন্য পর্যাপ্ত ভালো নই। কেন নিশ্চিত নই, কেবল এটাই الطريق।
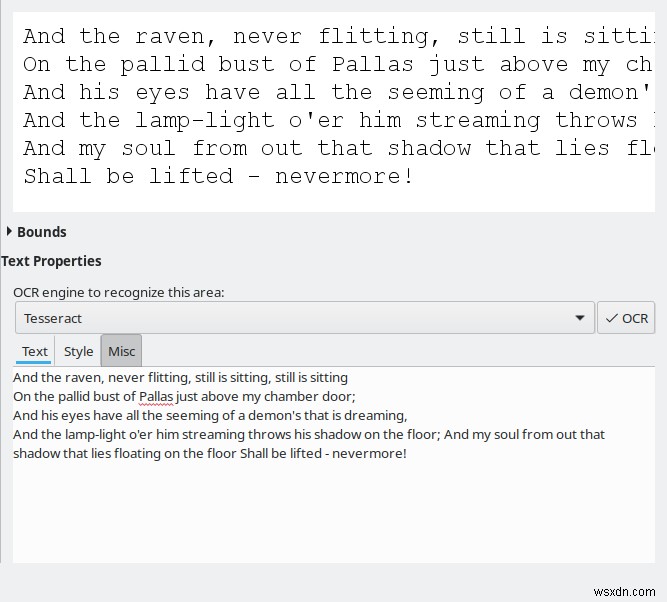
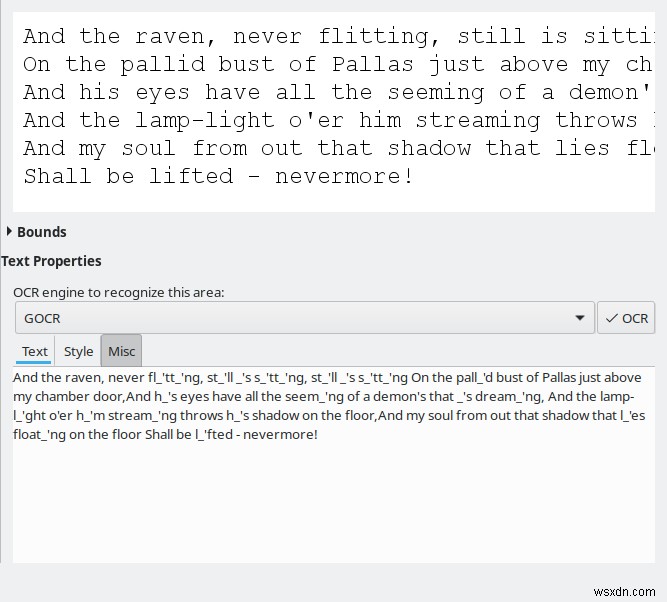
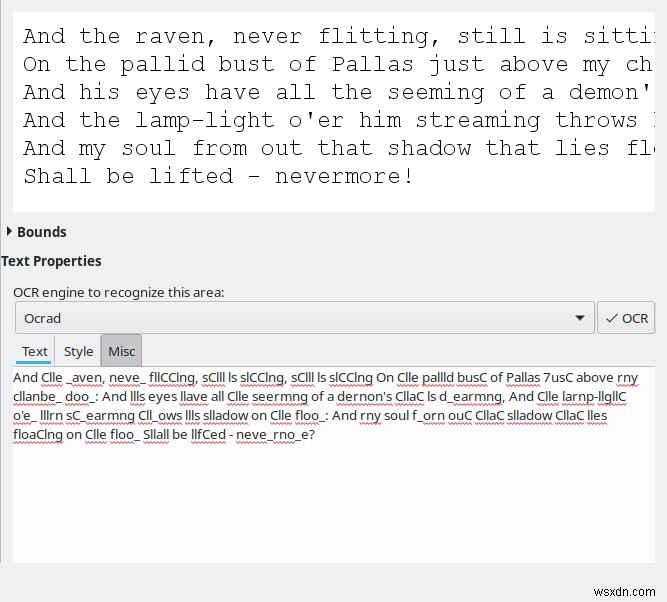
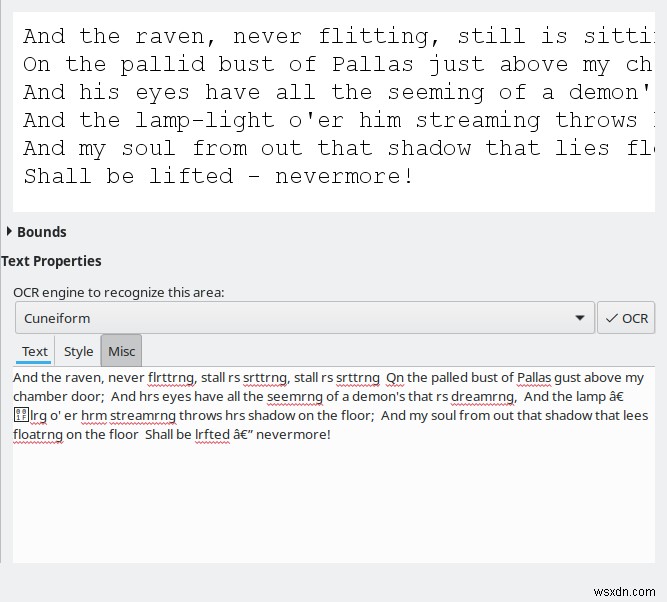
আমি গ্রে-ব্যাকগ্রাউন্ড ইমেজের সাথে ভালো ফলাফলও লক্ষ্য করলাম। অতীতে, Tesseract struggle করত, তাই এই ইঞ্জিনে যা উন্নতি গেলো, সেগুলো সবচেয়ে welcome। কিন্তু তবুও, এটি স্ট্রিক্টলি OCRFeeder-এর জিনিস নয়, এবং আপনি চাইলে Tesseract নিজে কম্যান্ড লাইন থেকে রান করতে পারেন।
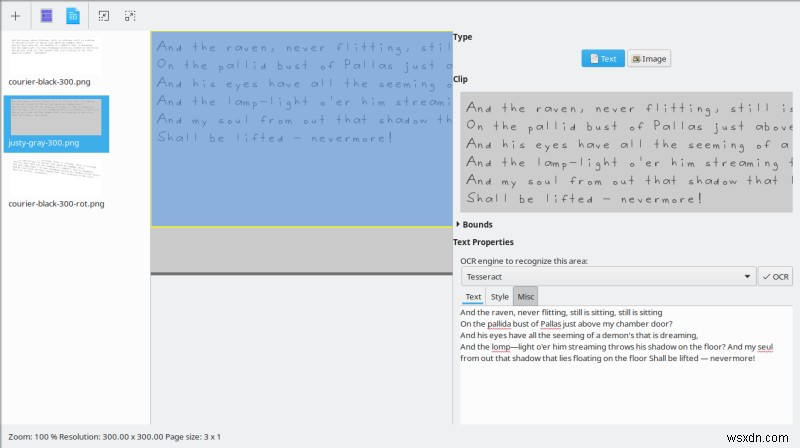
Deskewing এবং unpapering
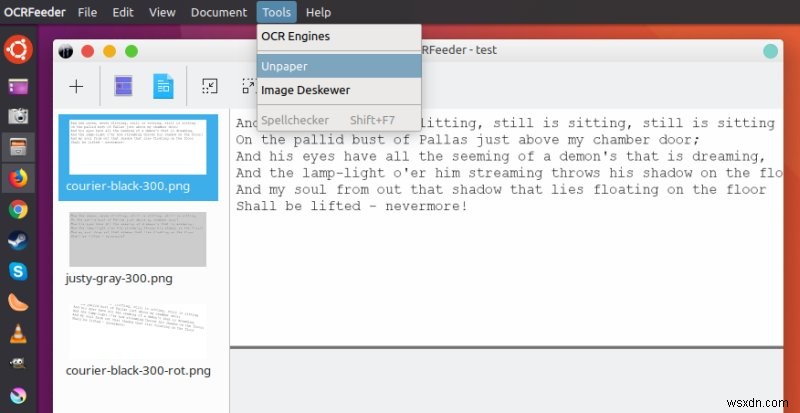
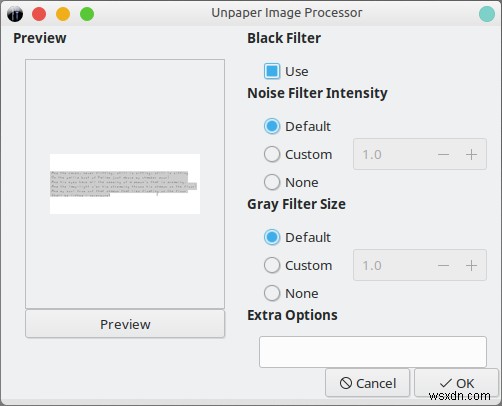
OCRFeeder দুটি nifty ফাংশন নিয়ে আসে - skewed ইমেজ স্ক্যানে টেক্সট অটো-রোটেট করার চেষ্টা করার ক্ষমতা, এবং কাগজের ব্যাকগ্রাউন্ড রিমুভ করার ক্ষমতা নয়জ কমাতে এবং আরও accurate কনভার্সনের জন্য অনুমতি দেওয়া। আমি দুটি অপশনই ট্রাই করলাম, এবং Deskew ঠিকঠাক কাজ করল। Unpapering, so-so। কিন্তু আমার টেক্সট রোটেট করা után (যা আমি GIMP-এ কন্ট্রোল ইমেজে অনেক আগে করেছিলাম), কনভার্সনের ফলাফল আরও ভালো হয়েছিল।
ODT-এ এক্সপোর্ট
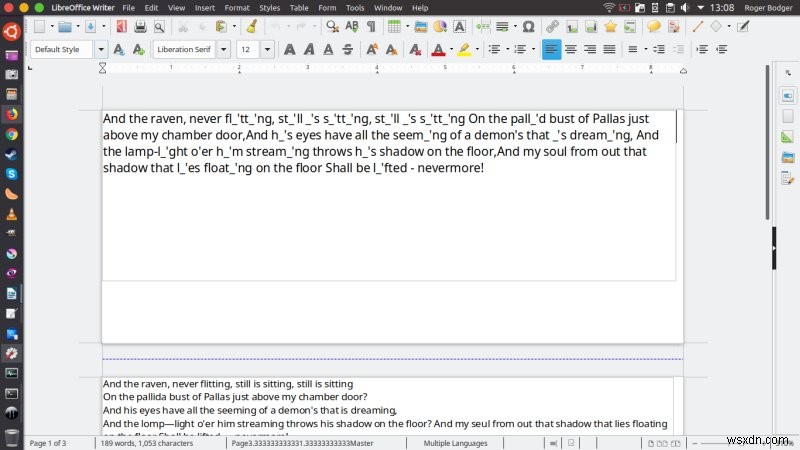
এটি কিছুটা tricky ছিল। আমি এটি কয়েকবার ট্রাই করলাম, এবং একবেচে এরর পেলাম। শেষে এটি কাজ করল। আউটপুট সবচেয়ে সুন্দর নয়, কিন্তু ভালো জিনিস হলো, আপনি একই সাথে একাধিক কনভার্সন এক্সপোর্ট করতে পারেন, বিভিন্ন ইমেজের জন্য বিভিন্ন ইঞ্জিন ব্যবহার করেও। quite nifty।
Preferences
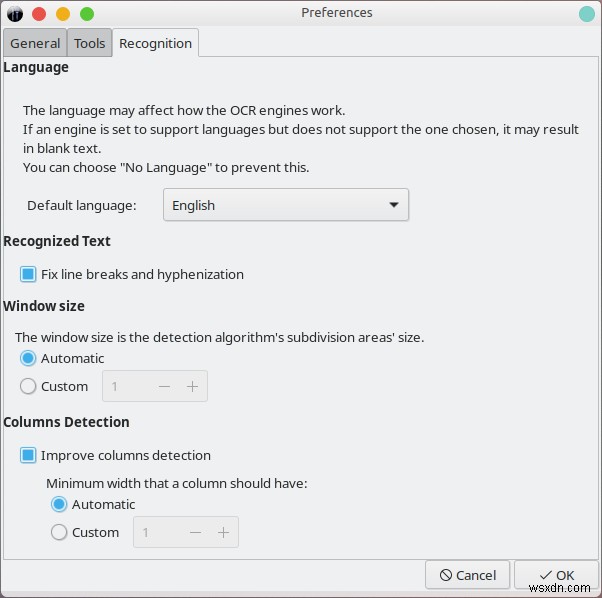
শেষে, আপনার প্রোগ্রামের behavior পরিবর্তন করার অপশন আছে। কিছু বড় নেই, কিন্তু ডিটেকশন এবং accuracy-এ সাহায্য করতে পারে। অধিকাংশটা আসে কিভাবে আপনি টেক্সট কলামের width, মার্জিন, ল্যাঙ্গুয়েজ সিলেকশন, এবং সমান موارد ডিটেক্ট করেন। অধিকাংশ মানুষের জন্য, ডিফল্টস একটিリーズনেবল স্টার্টিং পয়েন্ট।
উপসংহার
OCRFeeder একটিリーズনেবল, flexible সফ্টওয়্যার। এটি একাধিক ইঞ্জিন ব্যবহার করতে পারে, এবং ইমেজ-ফিক্সিং অ্যালগরিদমগুলো একটি সুন্দর যোগাযোগ। এটি OCRFeeder-কে ফ্রি মার্কেটে এই ধরণের সবচেয়ে promising সফ্টওয়্যার করে তোলে, কিন্তু আপনার আশা অবশ্যই সরাসরি দasco দিতে হবে, কারণ এটি অনলিকেলি কোনো আপডেট পাবে निकট ভবিষ্যতে, যদি কেউ এটি নেয় না। কারণ এখানে মার্কেট আছে, কিন্তু লিনাক্স ওয়ার্ল্ড একটি কঠিন পজিশনে আটকে আছে, ক্লান্তি এবং উদাসীনতার মাঝপথে।
এই পার্ট বাদে, বয়স এবং আপডেট জিনিসটি বাদে, অধিকাংশ অংশে, OCRFeeder deliver করল। কনভার্সন কোয়ালিটি খারাপ ছিল না, UI ব্যবহার করে কাজ করার জন্য আপনি কিছু হারান না, এবং এক্সপোর্ট ফাংশন আপনাকে further editing ইত্যাদির জন্য সুন্দর ডকুমেন্ট তৈরি করতে দেয়। আমি Tesseract-এ উন্নতিগুলোর সাথে খুশিও। তাই আপনার যদি একবেচে text-happy ইমেজ থাকে, এবং আপনি প্রাচীন ফর্মে হাতে লেখা টেক্সটকে কিছু মডার্ন এবং usable-এ কনভার্ট করার চেষ্টা করতে চান, আপনি এটি করতে পারেন। OCRFeeder PDF সাপোর্ট করে এবং স্ক্যানার থেকে সরাসরি পড়তেও পারে। এক্সপেরিমেন্ট করার পুরোপুরি যোগ্য। এখন যাওয়ার সময়, বায় বায়।
চিয়ার্স।
