

এক্সেলে কোয়ালিটেটিভ ডেটা অ্যানালাইজ করার উপায় খুঁজছেন? তবে এটি আপনার জন্য সঠিক আর্টিকেল। যখন ডেটা গণনা করা যায় না এবং সংখ্যাগত মান দিয়ে ব্যাখ্যা করা কঠিন হয়, তখন সেই ডেটা-কে কোয়ালিটেটিভ বলা হয়। আমরা এই কোয়ালিটেটিভ ডেটা সংগ্রহ করতে পারি ফোকাস গ্রুপ ডিসকাশন, ইন-ডেপথ ইন্টারভিউ, সেন্টেন্স কমপ্লিশন, ওয়ার্ড অ্যাসোসিয়েশন, আয়োজনহীন কথোপকথন ইত্যাদি থেকে।
এক্সেলে কোয়ালিটেটিভ ডেটা অ্যানালাইসিসের ৮ ধাপ
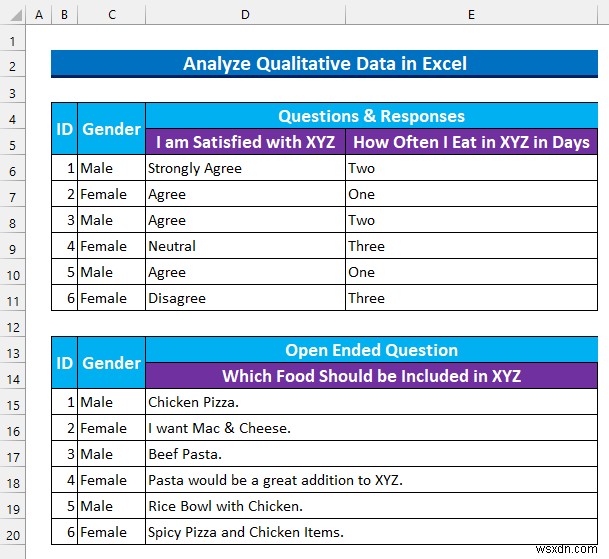
আমরা একটি সার্ভে কুয়েশনাইর থেকে তিনটি উত্তরের নমুনা নিয়ে আমাদের পদ্ধতি দেখাব। এখানে, XYZ হলো একটি শহরের শেষে অবস্থিত একটি ক্যাফে যেখানে ছাত্রগণ কখনো কখনো আড্ডা মারে। তিনটি প্রশ্ন নিচে দেওয়া হলো:
- প্রথমে, একটি লিকার্ট স্কেল প্রশ্ন “আমি XYZ-এর সাথে সন্তুষ্ট”। এই প্রশ্নের উত্তর দিতে ৫ লেভেল আছে।
- দ্বিতীয়, একটি মাল্টিপল-চয়েস প্রশ্ন “আমি কতদিন পর পর XYZ-এ খাই দিনে”। পার্টিসিপেন্টরা ৩ অপশন থেকে একটা বেছে নিতে পারেন।
- তৃতীয়, একটি ওপেন-এন্ডেড প্রশ্ন: “XYZ-এ কোন খাবার যোগ করা উচিত”। এখানে যেকোনো দৈর্ঘ্যের টেক্সট গ্রহণযোগ্য ছিল।
সাধারণত, আমাদের ডেটাসেটে ৩ কলাম আছে: “ID”, “Gender”, এবং “Questions & Responses”। കൂടায়, নিচের স্ন্যাপশটে, তিনটি প্রশ্ন একটি কমপ্যাক্ট কাঠামোতে দেখানো হয়েছে। আমরা প্রতিটি টাইপ থেকে কিভাবে তথ্য বের করতে হয় সেটি আলোচনা করব।
ধাপ ১: এক্সেলে অ্যানালাইসিসের জন্য কোয়ালিটেটিভ ডেটা কোডিং ও সোর্টিং
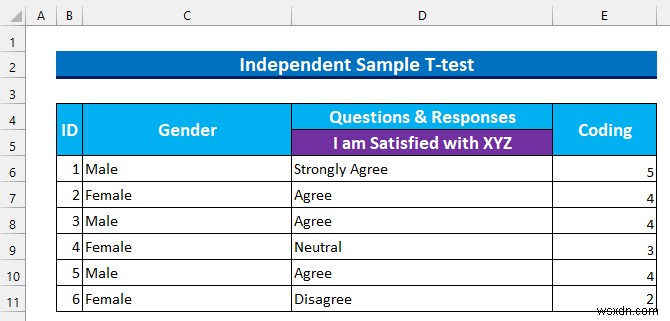
আমরা কোয়ালিটেটিভ ডেটা-কে কোড ব্যবহার করে সংখ্যাগত মানে রূপান্তর করব। তারপর, পরবর্তী ধাপের জন্য ডেটা সোর্ট করব। আমাদের Likert Scale-এর ৫ লেভেল আছে, তাই মানগুলো হবে এইভাবে:
- Strongly Agree -> 5।
- Agree -> 4।
- Neutral -> 3।
- Disagree -> 2।
- Strongly Disagree -> 1।
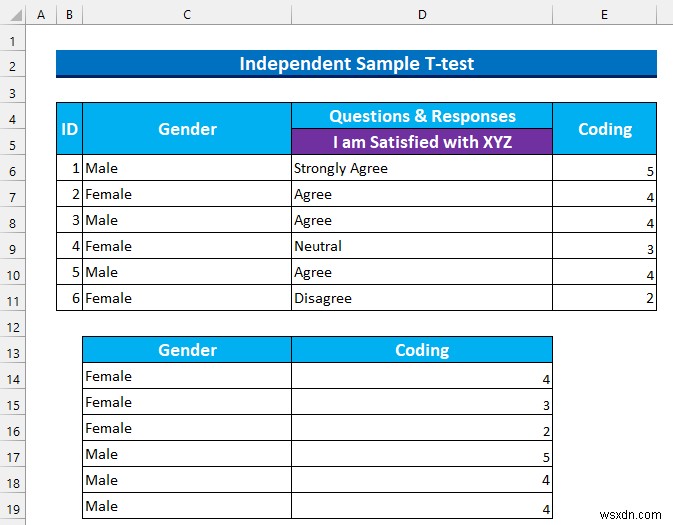
- সুতরাং, আমরা সেল রেঞ্জ E6:E11-এ এই মানগুলো ইনপুট করি।
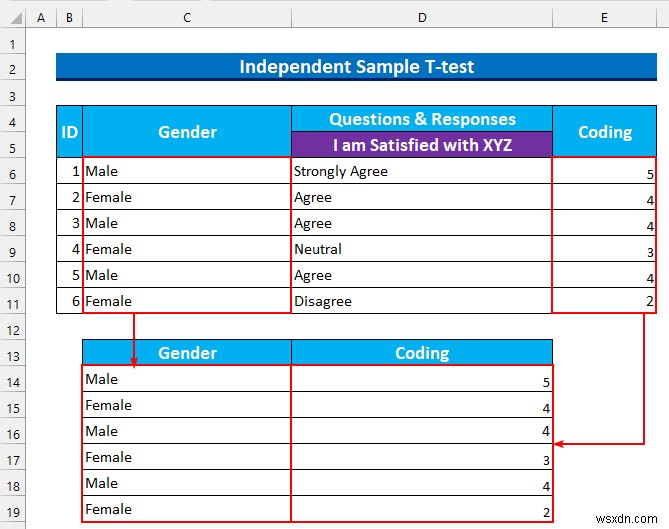
- তারপর, “Gender” এবং “Coding” কলামগুলো আলাদা আলাদা সেল রেঞ্জে পৃথক করি।
- পরে, সেল রেঞ্জ C14:D19 সিলেক্ট করুন এবং রাইট ক্লিক করে Context Menu আনা করুন।
- এরপর, Sort >>> থেকে “Sort A to Z” সিলেক্ট করুন।
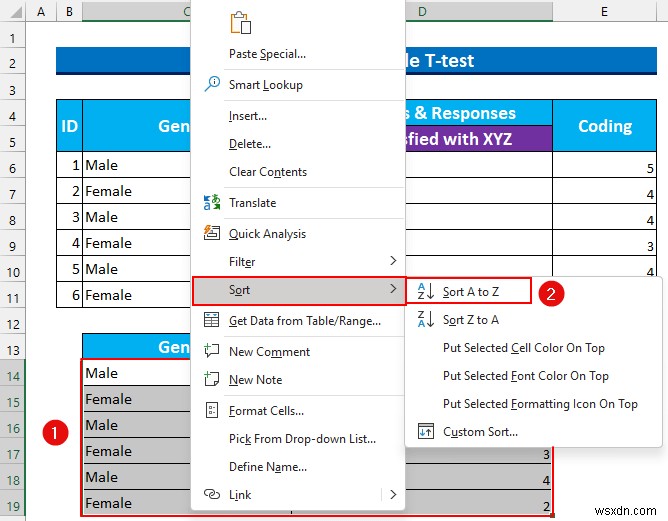
- সুতরাং, একই জেন্ডারের মানগুলো একসাথে থাকবে।
আরও পড়ুন: এক্সেলে Analyze Data ব্যবহার করা (৫ সহজ পদ্ধতি)
ধাপ ২: Analysis Toolpak ইনেবল করা
এক্সেলে যেকোনো স্ট্যাটিস্টিক্যাল টেস্ট করার আগে আমাদের Data Analysis ফিচারটি Excel-এ ইনেবল করতে হবে।
- শুরুতে, ALT, F, তারপর T চাপুন Excel Options উইন্ডো আনার জন্য।
- তারপর, Add-ins থেকে >>> “Go…” সিলেক্ট করুন।
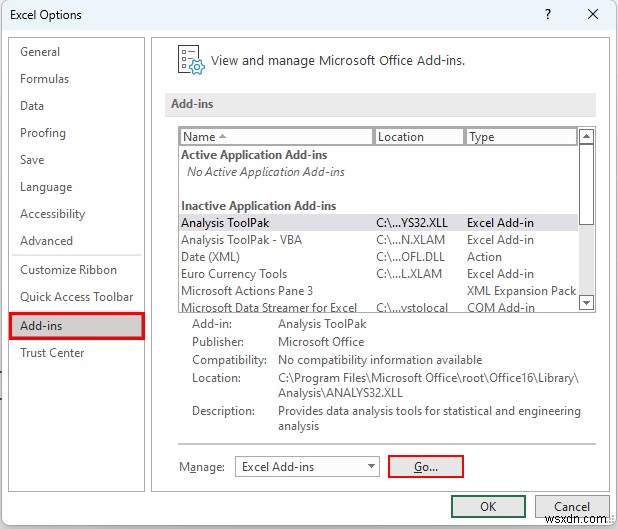
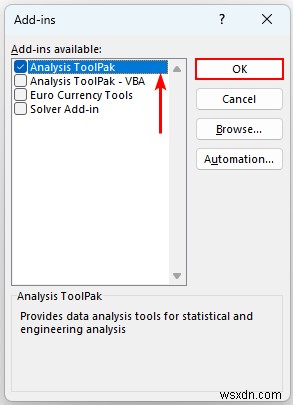
- সুতরাং, Add-ins dialog box পপ আপ হবে।
- এপরে, “Analysis Toolpak” সিলেক্ট করুন এবং OK চাপুন।
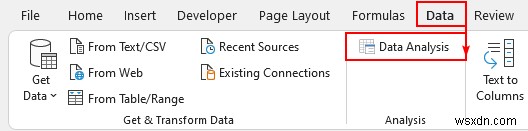
- শেষে, আমরা Data ট্যাবে Data Analysis কমান্ডটি দেখতে পাব।
আরও পড়ুন: [Fixed:] এক্সেলে Data Analysis না দেখানোর সমস্যা সমাধান (২ কার্যকর সমাধান)
ধাপ ৩: কোয়ালিটেটিভ ডেটার সাথে মানে তুলনা করার জন্য T-test
আমরা “Two-Sample t-test” ব্যবহার করব, যাকে “Independent Sample t-test” ও বলা হয়, কোয়ালিটেটিভ ডেটা অ্যানালাইজ করার জন্য। আমাদের দুটি হাইপোথেসিস বা অনুমান আছে:
Null Hypothesis H0: “দুই গ্রুপ XYZ-এর সাথে সমানভাবে সন্তুষ্ট”।
Alternative Hypothesis Ha: “দুই গ্রুপ XYZ-এর সাথে সমানভাবে সন্তুষ্ট নয়”।
আমরা আমাদের p-value 0.05-এর চেয়ে কম পেলে আমরা null hypothesis রিজেক্ট করতে পারব না। অন্যথায়, আমরা null hypothesis রিজেক্ট করব।
- গত ধাপে, আমরা Analysis Toolpak ইনেবল করলাম। এটি Analysis সেকশনে দেখা যাবে।
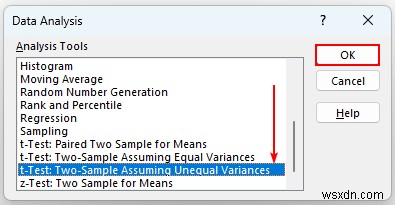
- তারপর, “Data Analysis”-এ ক্লিক করুন।
- পরে, “t-test: Two-Sample Assuming Unequal Variances” সিলেক্ট করুন এবং OK চাপুন।
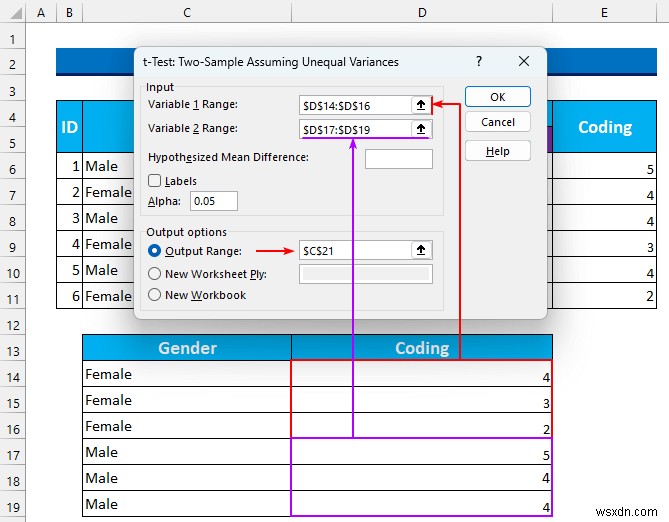
- এপরে, একটি dialog box আসবে। এই অপশনগুলো সিলেক্ট করুন:
- Variable 1 Range – D14:D16।
- Variable 2 Range – D17:D19।
- এই দুটি সোয়াপ করলেও আউটপুট একই থাকবে।
- তারপর, “Output Range” সিলেক্ট করুন এবং আউটপুট লোকেশন হিসেবে সেল C21 বেছে নিন।
- তারপর, OK চাপুন।
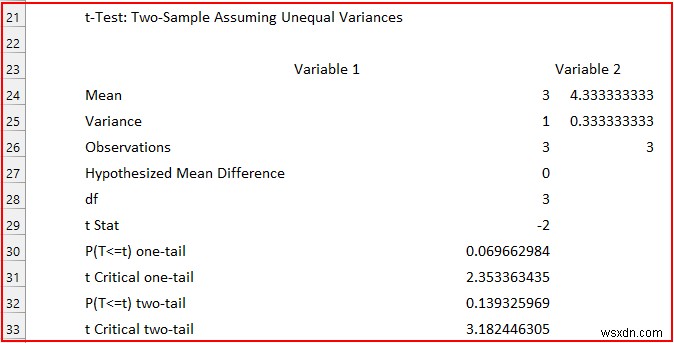
- সুতরাং, আউটপুট এরকম হবে।
- এরপর, আমরা দেখতে পাচ্ছি মিন হলো 3 এবং 4.33। আমরা p-value ব্যবহার করে চেক করব এই পার্থক্যটি σημαντিক কিনা। এছাড়া, ভ্যারিয়্যান্সগুলো হলো 1 এবং 0.33, তাই আমাদের অনইকোয়াল ভ্যারিয়্যান্সের অনুমানটি সঠিক ছিল। যদি এই মানপ্রায় সমান হতো তবে আপনাকে এটিকে “t-test: Two-Sample Assuming Equal Variances”-এ পরিবর্তন করতে হতো।
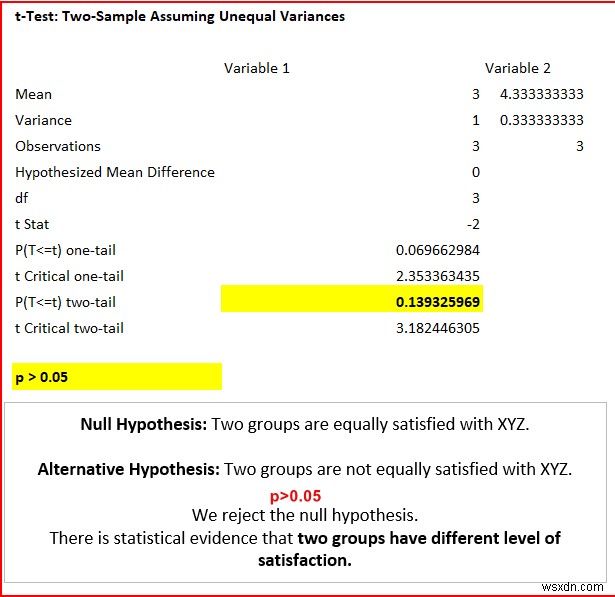
- সুতরাং, আমাদের শুধু P(T<=t) two-tail ভ্যালুতে ফোকাস করতে হবে। এটি 0.05-এর চেয়ে কম হতে হবে σημαντিক হওয়ার জন্য। যেহেতু এটি (0.14 রাউন্ড আপ করলে) 0.05-এর চেয়ে বেশি, অতএব, আমরা null hypothesis রিজেক্ট করব।
- সুতরাং, অ্যানালাইসিস থেকে আমরা বলতে পারি যে পুরুষ ও মহিলাদের cafe XYZ-এর সাথে সন্তুষ্টির লেভেল আলাদা, যা স্ট্যাটিস্টিক্যালি সিগনিফিক্যান্ট।
ধাপ ৪: ক্যাটাগরিক্যাল ডেটাসেট প্রস্তুত করা কাই-স্কয়ার টেস্টের জন্য
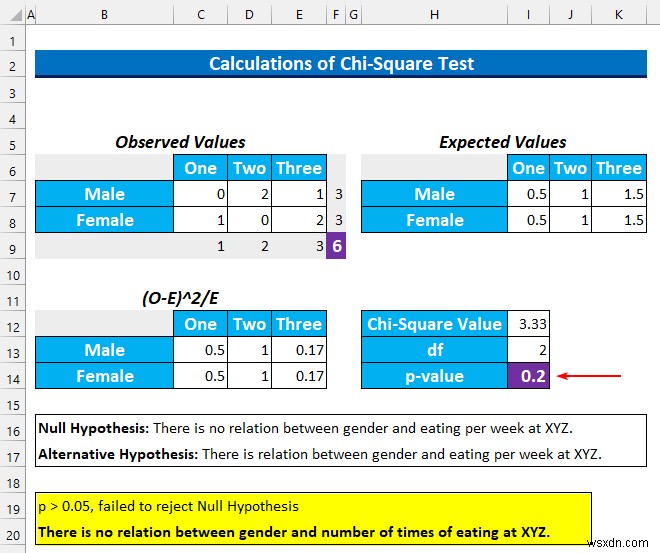
এই ধাপে আমরা SUM এবং COUNTIFS ফাংশন ব্যবহার করব। এখন, আমরা দ্বিতীয় প্রশ্নের অ্যানালাইসিস আলোচনা করব। আমরা দুটি ক্যাটাগরিক্যাল ডেটার মধ্যে সম্পর্ক বের করতে Chi-Square test ব্যবহার করব। এছাড়া এটি এক্সপেক্টেড এবং অবসার্ভড মানের মধ্যে পার্থক্য রিটার্ন করতে পারে। আমরা জানতে চাই জেন্ডার এবং XYZ cafe-এ খাওয়ার বারम्बারতার মধ্যে কোনো সম্পর্ক আছে কিনা।
Null Hypothesis H0: “জেন্ডার এবং XYZ-এ সপ্তাহে খাওয়ার মধ্যে কোনো সম্পর্ক নেই”।
Alternative Hypothesis Ha: “জেন্ডার এবং XYZ-এ সপ্তাহে খাওয়ার মধ্যে সম্পর্ক আছে”।
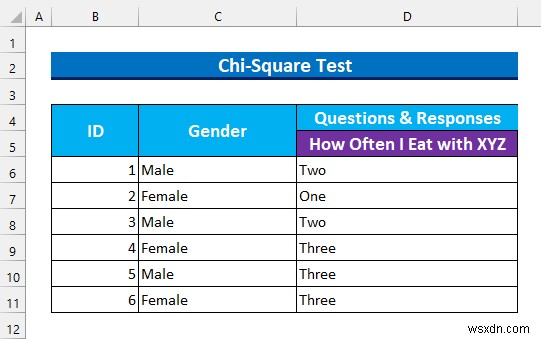
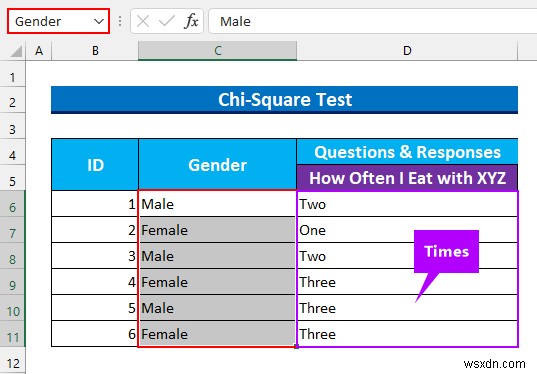
- প্রথমে, আমরা রেঞ্জ C6:C11 কে “Gender” এবং D6:D11 কে “Times” নামে নামকরণ করব।
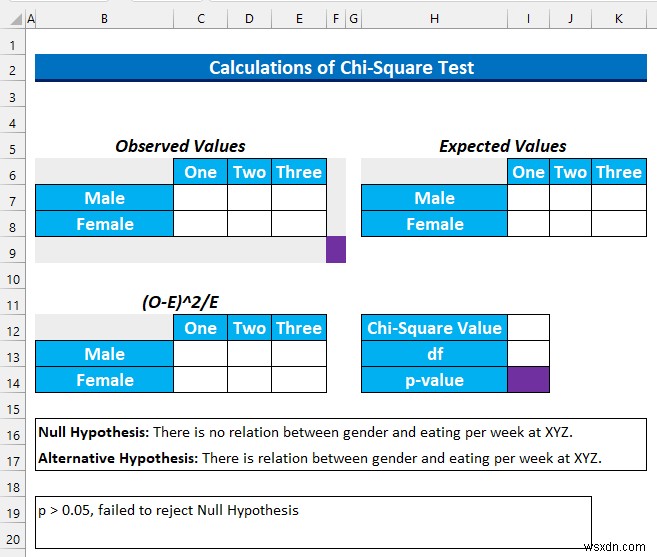
- এরপর, Chi-Squared ভ্যালু ক্যালকুলেট করার জন্য একটি টেমপ্লেট তৈরি করব।
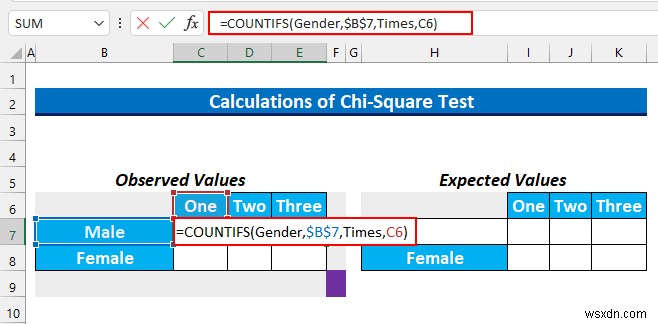
- তারপর, সেল রেঞ্জ C7:E7 সিলেক্ট করুন এবং নিচের ফর্মুলা টাইপ করুন।
=COUNTIFS(Gender,$B$7,Times,C6)
এই ফর্মুলা মেলে এবং One টাইম cafe XYZ-এ খাওয়ার সেল সংখ্যা।
- এরপর, CTRL+ENTER চাপুন। এটি ফর্মুলা অটোফিল করবে।
- এপরে, সেল রেঞ্জ C8:E8 সিলেক্ট করুন এবং নিচের ফর্মুলা টাইপ করুন।
=COUNTIFS(Gender,$B$8,Times,C6)
এই ফর্মুলা ফিমেল এবং One টাইম cafe XYZ-এ খাওয়ার সেল সংখ্যা বের করে।
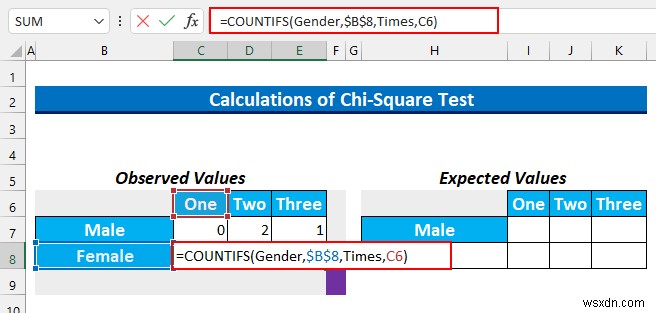
- তারপর, CTRL+ENTER চাপুন।
- এপরে, সারি ও কলামের সমষ্টি করব।
- সেল রেঞ্জ C9:E9 সিলেক্ট করুন এবং এই ফর্মুলা টাইপ করুন।
=SUM(C7:C8)
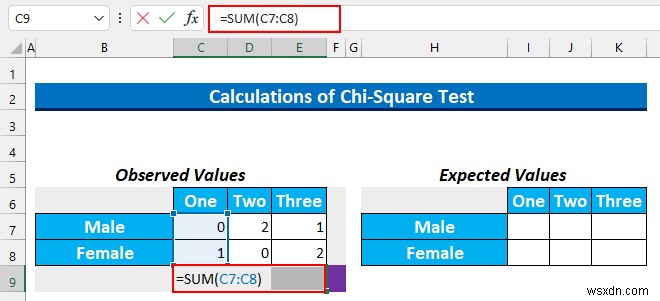
- CTRL+ENTER চাপুন।
- তারপর, সেল রেঞ্জ F7:F8 সিলেক্ট করুন এবং এই ফর্মুলা টাইপ করুন।
=SUM(C7:E7)
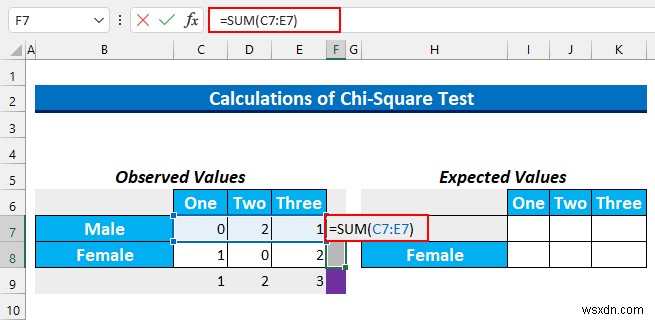
- CTRL+ENTER চাপুন।
- তারপর, সেল F9-এ 6 টাইপ করুন কারণ রেসপন্ডেন্টের সংখ্যা ৬ ছিল।
- এখন, আমরা এক্সপেক্টেড ভ্যালু বের করব। তার ফর্মুলা হলো Row Total * Column Total/Total।
- এপরে, সেল রেঞ্জ I7:K7 সিলেক্ট করে আগে এই ফর্মুলা টাইপ করুন।
=$F$7*C9/$F$9
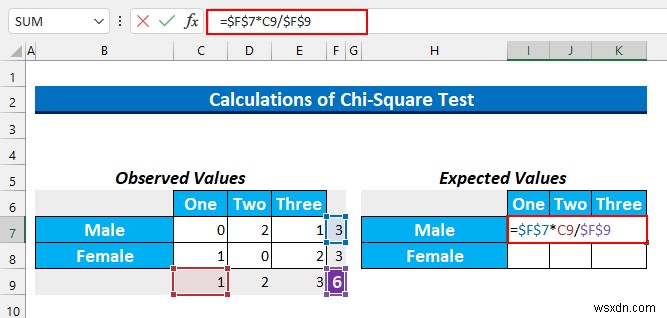
- CTRL+ENTER চাপুন।
- তারপর, সেল রেঞ্জ I8:K8 সিলেক্ট করুন এবং এই ফর্মুলা টাইপ করুন।
=$F$8*C9/$F$9
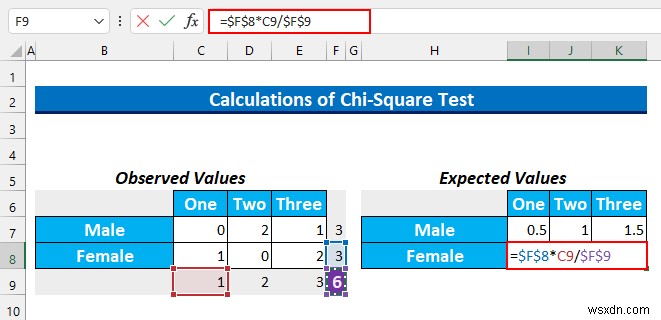
- এপরে, CTRL+ENTER চাপুন।
- এখন, আমরা Chi-Squared ভ্যালু বের করব।
- সুতরাং, সেল রেঞ্জ C13:E14 সিলেক্ট করুন এবং নিচের ফর্মুলা টাইপ করুন।
=(C7-I7)^2/I7
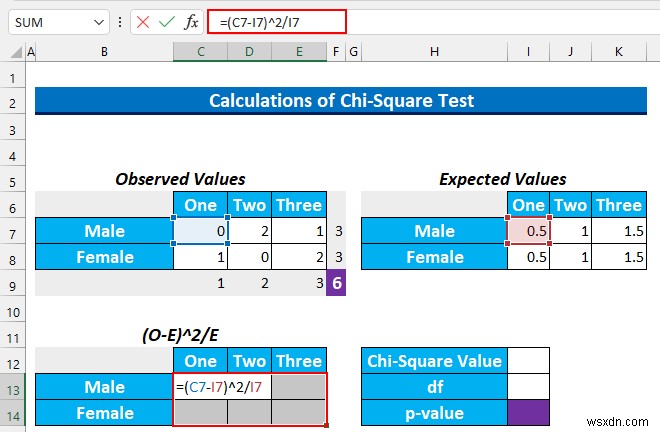
- এপরে, CTRL+ENTER চাপুন।
- তারপর, সেল I12-এ এই ফর্মুলা টাইপ করে এই ভ্যালুগুলো যোগ করব।
=SUM(C13:E14)
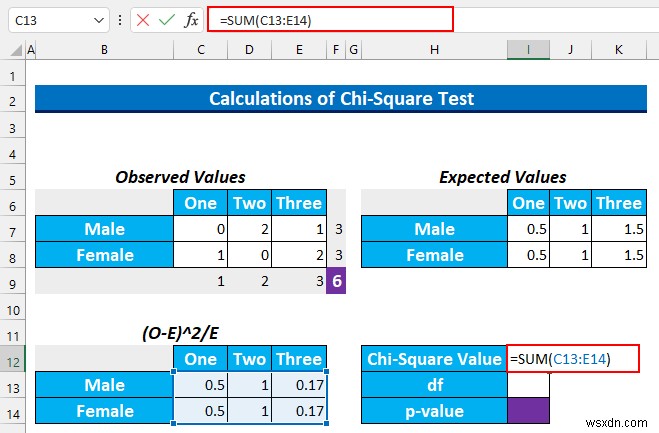
- এপরে, ENTER চাপুন।
- এখন, df মানে degrees of freedom। এটি বের করার ফর্মুলা হলো (Number of Columns -1) * (Number of Rows-1)। আমাদের ২ সারি এবং ৩ কলাম আছে। তাই আমাদের df হবে (3-1)*(2-1) = 2।
আরও পড়ুন: এক্সেলে বড় ডেটাসেট অ্যানালাইজ করা (৬ কার্যকর পদ্ধতি)
সাদৃশ্য পড়ুন
- এক্সেলে সেলস ডেটা অ্যানালাইজ করা (১০ সহজ পদ্ধতি)
- পিভট টেবিল ব্যবহার করে এক্সেলে ডেটা অ্যানালাইজ করা (৯ উপযুক্ত উদাহরণ)
- এক্সেলে টাইম-স্কেলড ডেটা অ্যানালাইজ করা (সহজ ধাপে)
ধাপ ৫: কাই-স্কয়ার টেস্ট দিয়ে ক্যাটাগরিক্যাল কোয়ালিটেটিভ ডেটা অ্যানালাইজ করা
আমরা এই টেস্টের জন্য p-value বের করতে CHISQ.DIST.RT ব্যবহার করব।
- সুতরাং, সেল I14-এ এই ফর্মুলা টাইপ করুন।
=CHISQ.DIST.RT(I12,I13)
এই ফাংশন রিটার্ন করে “the right-tailed probability of the chi-squared distribution”।
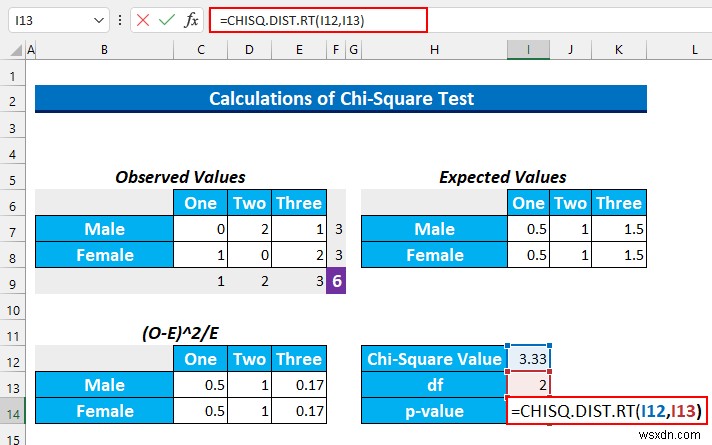
- এরপর, ENTER চাপুন। আমরা 0.2 ভ্যালু পাবো যা 0.05-এর চেয়ে বড়। তাই আমরা null hypothesis রিজেক্ট করতে পারব না। সহজ কথায়, আমরা বলতে পারি যে দুটি ক্যাটাগরির মধ্যে কোনো সম্পর্ক নেই।
ধাপ ৬: ওপেন-এন্ডেড কোয়ালিটেটিভ ডেটার জন্য সেন্টিমেন্ট অ্যানালাইসিস
এখন, আমরা আমাদের শেষ প্রশ্ন ও উত্তরগুলো দেখব। আমরা ম্যানুয়াল প্রক্রিয়ায় রেসপন্সের থিমগুলো বের করব। আমরা ডেটাসেটে দুটি কলাম যোগ করেছি: “Topic1” এবং “Topic2”।
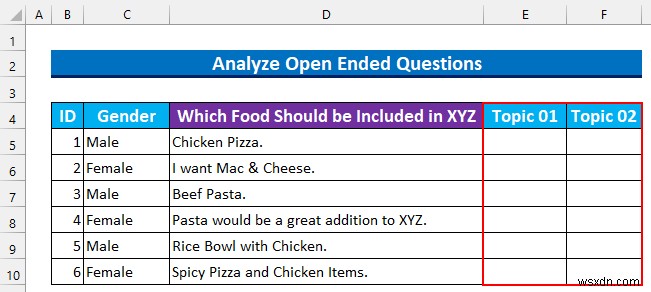
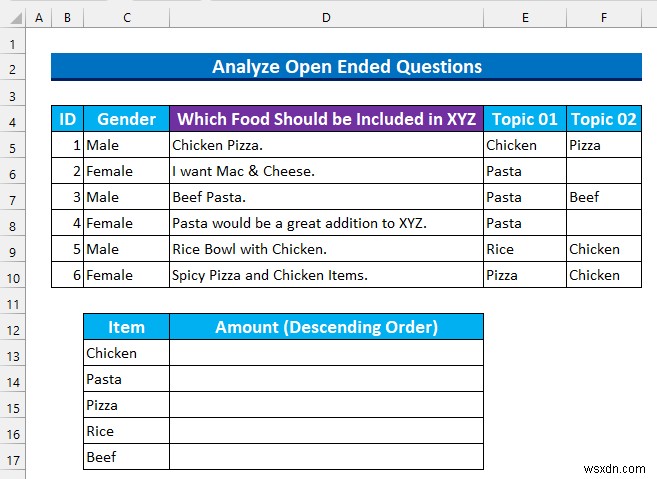
- তারপর, আমরা রেসপন্সগুলো পড়ব এবং সেগুলোর সাথে ফুড টপিক যুক্ত করব। উদাহরণস্বরূপ, “Chicken Pizza”-র ২ টপিক আছে: “Chicken” এবং “Pizza” এবং এরকম লাগি।
- এপরে, আমরা শুধু যুনিক টপিকগুলো একটি নতুন টেবিলে যোগ করলাম।
ধাপ ৭: COUNTIF ফাংশন ব্যবহার করে ওপেন-এন্ডেড কোয়ালিটেটিভ ডেটা অ্যানালাইজ করা
আমরা ফ্রিকোয়েন্সি ডিস্ট্রিবিউশনে অন্তর্দৃষ্টি পাওয়ার জন্য COUNTIF ফাংশন ব্যবহার করব।
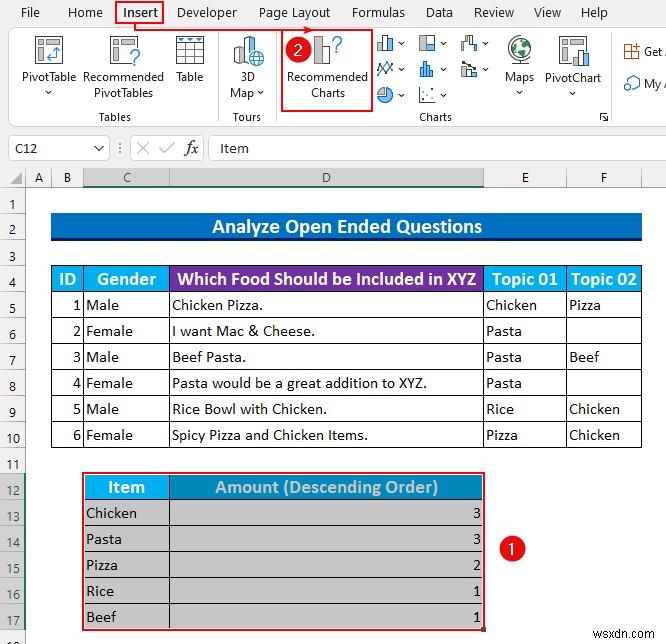
- প্রথমে, সেল রেঞ্জ D13:D17 সিলেক্ট করুন এবং নিচের ফর্মুলা টাইপ করুন।
=COUNTIF($E$5:$F$10,C13)
এই ফর্মুলা F5:F10 রেঞ্জে কতগুলো ভ্যালু সেল C13-এর ভ্যালু دار করে সেটি গণনা করে।
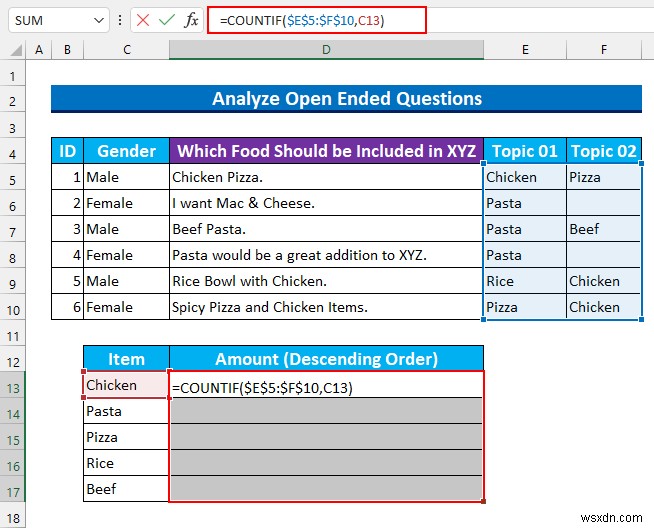
- এপরে, ফর্মুলা AutoFill করার জন্য CTRL+ENTER চাপুন।
- এরপর, ফ্রিকোয়েন্সি ডিস্ট্রিবিউশন ভিজ্যুয়ালাইজ করার জন্য একটি Chart ইনসার্ট করব।
ধাপ ৮: ওপেন-এন্ডেড কোয়ালিটেটিভ ডেটা ভিজ্যুয়ালাইজ করার জন্য ক্লাস্টারড কলাম চার্ট
এই ধাপে, আমরা Clustered Column Chart তৈরি করব কোয়ালিটেটিভ ডেটা আরও স্পষ্টভাবে বুঝতে।
- সুতরাং, সেল রেঞ্জ C12:D17 সিলেক্ট করুন এবং Insert ট্যাব থেকে Recommended Charts সিলেক্ট করুন।
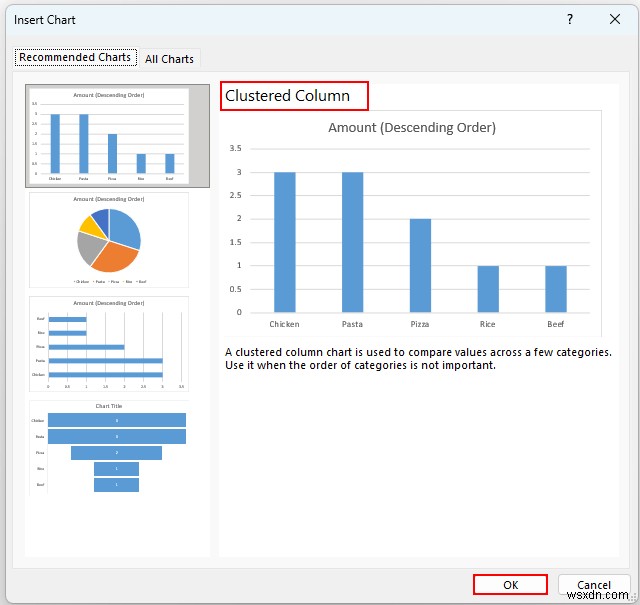
- তারপর, Insert Chart dialog box আসবে এবং ডিফল্টভাবে Clustered Column সিলেক্টেড থাকবে। না থাকলে সিলেক্ট করুন।
- এপরে, OK চাপুন।
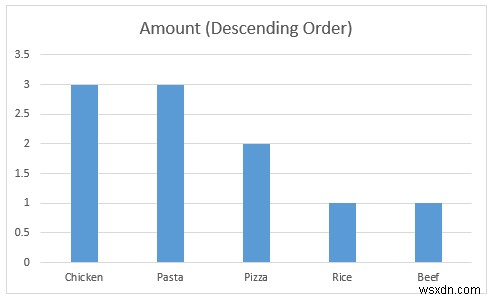
- তারপর, আমরা দেখতে পাচ্ছি যে কাস্টমাররা Chicken, Pasta, এবং Pizza কামনে করছেন XYZ cafe-এ টপ ৩ ফুড আইটেম হিসেবে। XYZ cafe-এর ম্যানেজমেন্ট এই প্রোডাক্টগুলো বেশি অফার করতে পারেন বেশি রেভেনিউ জেনারেট করার জন্য।
সারসংক্ষেপ
- আমরা t-test ব্যবহার করি যখন দুটি গ্রুপের মানে তুলনা করি এবং chi-square test ব্যবহার করি যখন ক্যাটাগরিক্যাল ভ্যালু নিয়ে কাজ করি।
- আমাদের ডেটাসেটের জন্য, সার্ভে কুয়েশনাইরের তিনটি প্রশ্ন থেকে আমরা এই ফলাফল পেলাম-
- পুরুষ ও মহিলাদের cafe XYZ-এর সাথে সন্তুষ্টির লেভেল আলাদা।
- জেন্ডার এবং cafe XYZ-এ খাওয়ার সংখ্যা সম্পর্কিত নয়।
- ছাত্র বা কাস্টমাররা Chicken, Pasta, এবং Pizza কামনে করছেন Cafe XYZ-এ অন্তর্ভুক্ত করার জন্য টপ থ্রি আইটেম হিসেবে।
প্র্যাকটিস সেকশন
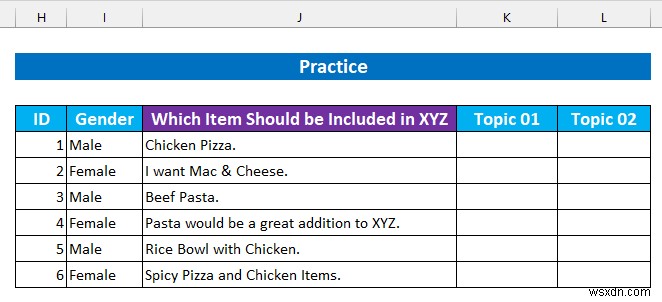
আমরা প্রতিটি পদ্ধতির জন্য প্র্যাকটিস ডেটাসেট Excel ফাইলে যোগ করেছি। তাই আপনি সহজে আমাদের পদ্ধতিগুলো অনুসরণ করতে পারবেন।
উপসংহার
আমরা আপনাকে এক্সেলে কোয়ালিটেটিভ ডেটা অ্যানালাইজ করার ৮ ধাপ দেখিয়েছি। এই পদ্ধতিগুলো সম্পর্কে আপনার কোনো সমস্যা থাকলে বা আমার জন্য যেকোনো ফিডব্যাক থাকলে নিচে কমেন্ট করুন। এছাড়া, আরও এক্সেল-সম্পর্কিত আর্টিকেলের জন্য আমাদের সাইট ExcelDemy ভিজিট করতে পারেন। পড়ার জন্য ধন্যবাদ, এগিয়ে যান!
সম্পর্কিত আর্টিকেল
- এক্সেলে qPCR ডেটা অ্যানালাইজ করা (২ সহজ পদ্ধতি)
- এক্সেল ডেটা অ্যানালাইসিস ব্যবহার করে কেস স্টাডি পারফর্ম করা
- এক্সেলে টেক্সট ডেটা অ্যানালাইজ করা (৫ উপযুক্ত পদ্ধতি)
