

পদ্ধতি ১ - কেন্দ্রীয় প্রবণতা এবং পরিবর্তনশীলতা হিসাব করা
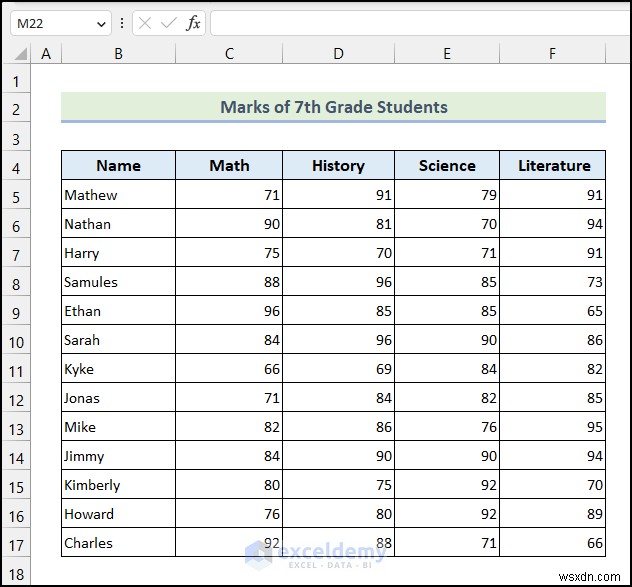
উপরোক্ত ডেটাসেটে ৭ম শ্রেণির ছাত্রদের নম্বর দেওয়া আছে গণিত, ইতিহাস, বিজ্ঞান, এবং সাহিত্য বিষয় অনুযায়ী।
১.১ AVERAGE ফাংশন ব্যবহার করা
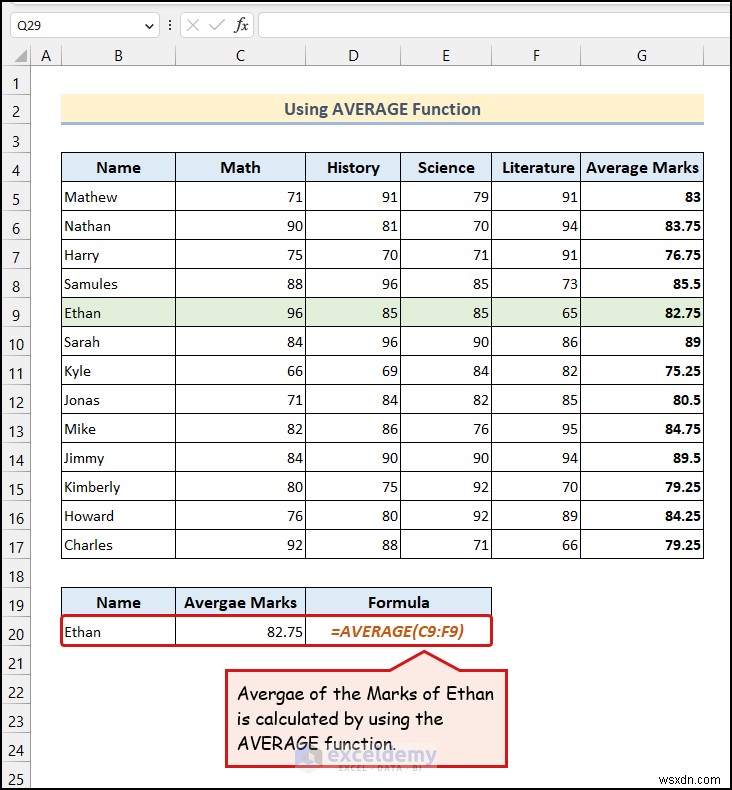
আপনি সেল C20-এ ইথান-এর গড় নম্বর দেখছেন।
এখানে, আমরা AVERAGE ফাংশন ব্যবহার করেছি, যা একটি ডেটাসেটের গাণিতিক গড় ফেরত দেয়।
- সেল C20-এ নিচের ফর্মুলা লিখুন:
এখানে, সেলের রেঞ্জ C9:F9 ইথান-এর বিভিন্ন বিষয়ের নম্বরকে বোঝায়।
১.২ AVERAGEIF এবং AVERAGEIFS ফাংশন ব্যবহার করা
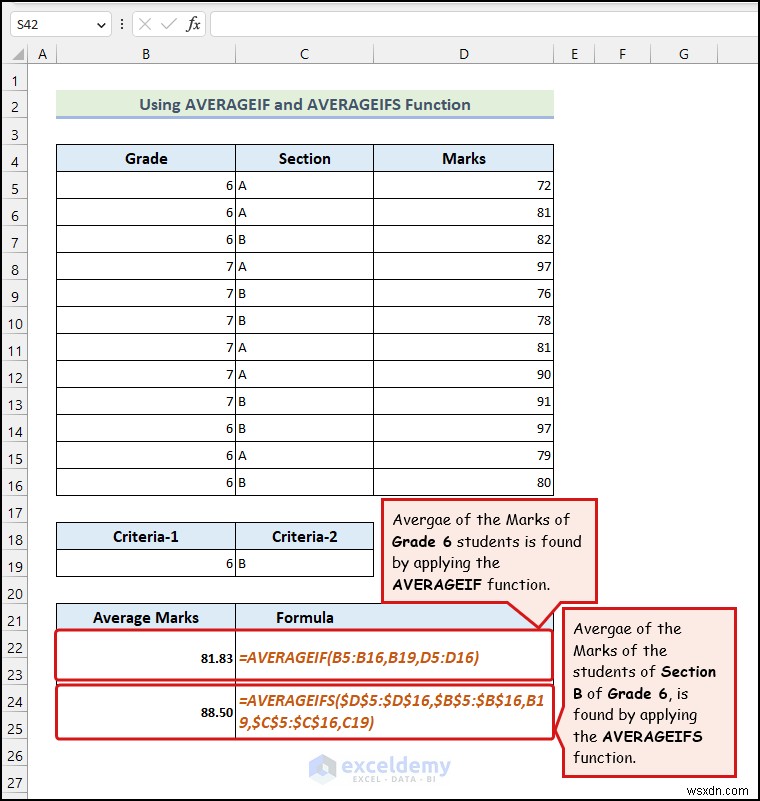
উপরোক্ত ডেটাসেট AVERAGEIF এবং AVERAGEIFS ফাংশনগুলোর বিভিন্ন ব্যবহার দেখাচ্ছে।
আপনি ৬ষ্ঠ শ্রেণির ছাত্রদের প্রাপ্ত নম্বরের গড় খুঁজতে চান। এটি করতে,
- সেল B22-এ নিচের ফর্মুলা লিখুন:
=AVERAGEIF(B5:B16,B19,D5:D16)
এখানে, সেল B19 সেই κριটিয়া নির্দেশ করে যার ভিত্তিতে আমরা গড় নম্বর খুঁজব।
আরেকটি পরিস্থিতি মনে করুন যেখানে আমরা দুটি κριটিয়া-এর ভিত্তিতে ছাত্রদের গড় নম্বর খুঁজতে চাই: তাদের শ্রেণি এবং সেকশন।
- সেল C24-এ নিচের ফর্মুলা লিখুন:
=AVERAGEIFS($D$5:$D$16,$B$5:$B$16,B19,$C$5:$C$16,C19)
এখানে, সেলের রেঞ্জ $D$5:$D$16 নম্বর কলামের সেলগুলোকে বোঝায়, সেলের রেঞ্জ $B$5:$B$16 শ্রেণি কলামের সেলগুলোকে বোঝায়, এবং সেলের রেঞ্জ $C$5:$C$16 সেকশন কলামের সেলগুলোকে বোঝায়। সেল B19 এবং C19 দুটি κριটিয়া-কে প্রতীক করে।
১.৩ HARMEAN এবং GEOMEAN ফাংশন ব্যবহার করা
মনে করুন আমাদের ডেটা হিসেবে ছয়টি সংখ্যা আছে। সংখ্যাগুলো হলো ১,২,৩,৪,৫ এবং ৬। তাহলে আমাদের হারমোনিক মিন মান হবে নিচের মতো।
হারমোনিক মিন = ১/(১+১/২+১/৩+১/৪+১/৫+১/৬)৬ = ২.৪৪৮৯
GEOMEAN ফাংশন একটি নির্বাচিত ডেটাসেটের জ্যামিতিক গড় হিসাব করে। জ্যামিতিক গড় হলো ডেটাসেটের n মানগুলো গুণ করে nth রুট বের করে হিসাব করা। এখানে, n হলো ডেটাসেটে মোট মানের সংখ্যা। উদাহরণস্বরূপ, মনে করুন আমাদের ডেটাসেট হিসেবে ৫টি সংখ্যা আছে। এগুলো হলো ১, ২, ৩, ৪, এবং ৫। তাহলে জ্যামিতিক গড় হবে,
জ্যামিতিক গড় = ৫√(১*২*৩*৪*৫) = ২.৬০৫১।
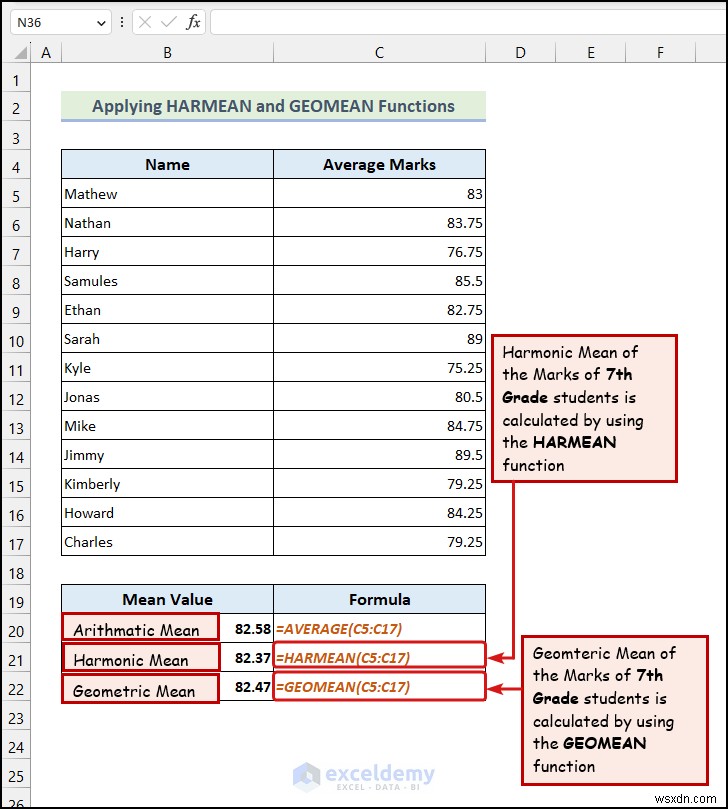
উপরোক্ত ছবিটি HARMEAN এবং GEOMEAN ফাংশন ব্যবহারের একটি ব্যবহারিক উদাহরণ দেখাচ্ছে।
- B21 সেলে হারমোনিক মিন হিসাব করার ফর্মুলা:
এখানে, সেলের রেঞ্জ C5:C17 গড় নম্বর কলামের সেলগুলোকে প্রতীক করে।
একটি বিষয় স্পষ্ট: এই ক্ষেত্রে হারমোনিক মিনের মান গড় নম্বরের গড় মানের চেয়ে কম। গাণিতিক গড় হলো ৮২.৫৮, কিন্তু হারমোনিক মিন হলো ৮২.৩৭। অর্থাৎ এটি গড় নম্বর-এর বড় মানের মান সীমাবদ্ধ করে।
- জ্যামিতিক গড় বের করার জন্য, আমরা সেল C22-এ নিচের ফর্মুলা ব্যবহার করেছি:
হারমোনিক মিনের মতো, জ্যামিতিক গড় (৮২.৪৭) গাণিতিক গড় (৮২.৫৮)-এর থেকে আলাদা। বিনিয়োগকারীরা জ্যামিতিক গড় ব্যবহার করে কারণ এটি অনেক সময়ের გড়ে সারি মান দেওয়া হলে আরও নির্ভুল গড় মান প্রদান করে।
১.৪ STANDARDIZE ফাংশন প্রয়োগ করা
ধাপগুলো:
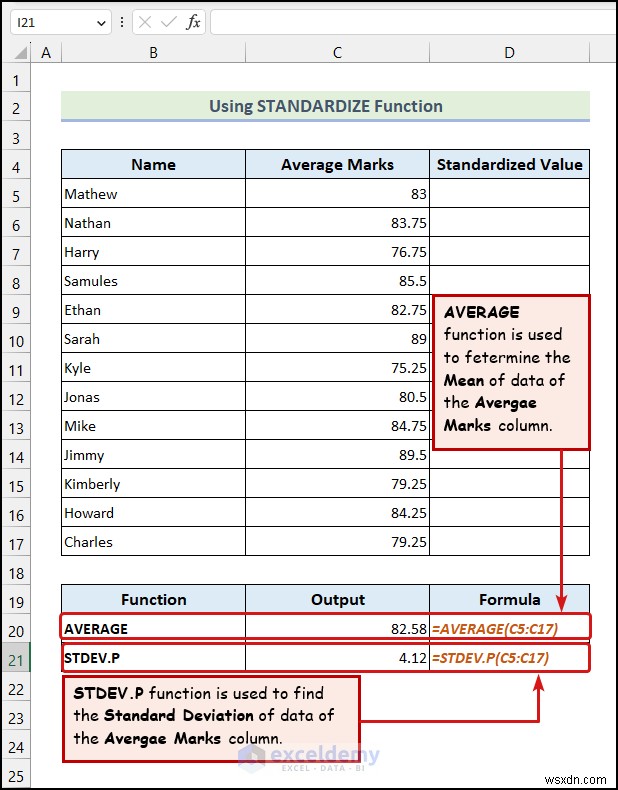
- ডেটাসেটের গড় এবং স্ট্যান্ডার্ড ডেভিয়েশন হিসাব করুন।
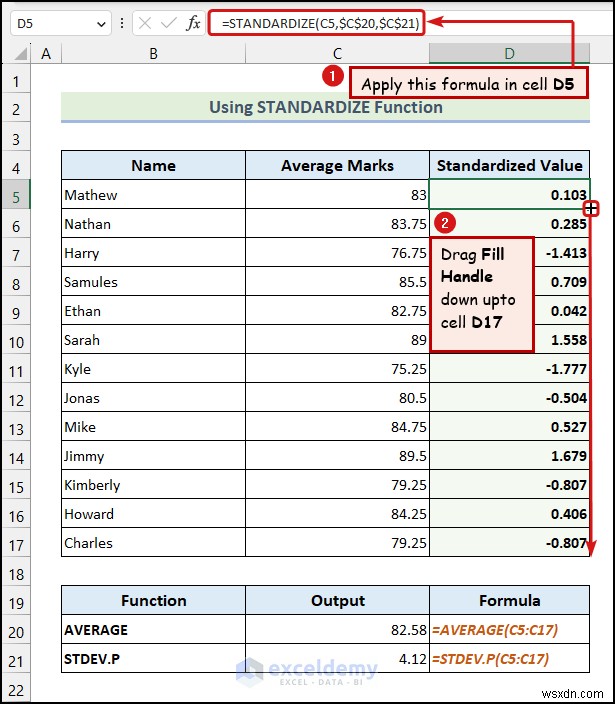
- সেল D5-এ নিচের ফর্মুলা লিখুন:
=STANDARDIZE(C5,$C$20,$C$21)
এখানে, সেল C5 ম্যাথিউ-এর গড় নম্বর-কে প্রতীক করে, সেল $C$20 গড় মান-কে নির্দেশ করে, এবং সেল $C$21 STDEV.P(স্ট্যান্ডার্ড ডেভিয়েশন) মানকে বোঝায়।
আপনি MODE.SNGL, MEDIAN, VAR.S, VAR.P, STDEV.S, এবং STDEV.P ফাংশনগুলো ব্যবহার করে এক্সেলে আরও পরিসংখ্যানগতভাবে ডেটা বিশ্লেষণ করতে পারেন।
পদ্ধতি ২ - আপেক্ষিক অবস্থান নির্ণয় করা
মনে করুন ৫ম এবং ৬ষ্ঠ-র্যাঙ্কের মান একই। সেক্ষেত্রে, RANK.EQ ফাংশন দুটি মানের জন্যও র্যাঙ্ক ৫ ফেরত দেবে, এবং পরবর্তী র্যাঙ্ক মান হবে র্যাঙ্ক ৭। এখানে, আমাদের ডেটাসেট হিসেবে ৭ম শ্রেণির ছাত্রদের মোট নম্বর আছে।
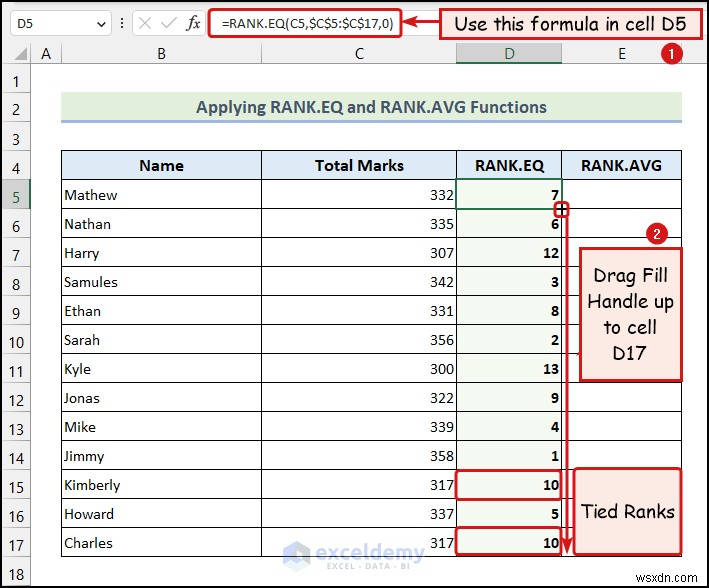
এখানে, আপনি দেখতে পাচ্ছেন যে ১০ম এবং ১১ম মানগুলো টাই ছিল। তাই, RANK.EQ ফাংশন দুটি মানের জন্যও র্যাঙ্ক ১০ ফেরত দিয়েছে।
- আমরা সেল D5-এ নিচের ফর্মুলা প্রয়োগ করেছি।
=RANK.EQ(C5,$C$5:$C$17,0)
এখানে, সেল C5 মোট নম্বর কলামের প্রথম সেলকে বোঝায়, এবং সেলের রেঞ্জ $C$5:$C$17 মোট নম্বর কলামের সেলগুলোকে প্রতীক করে।
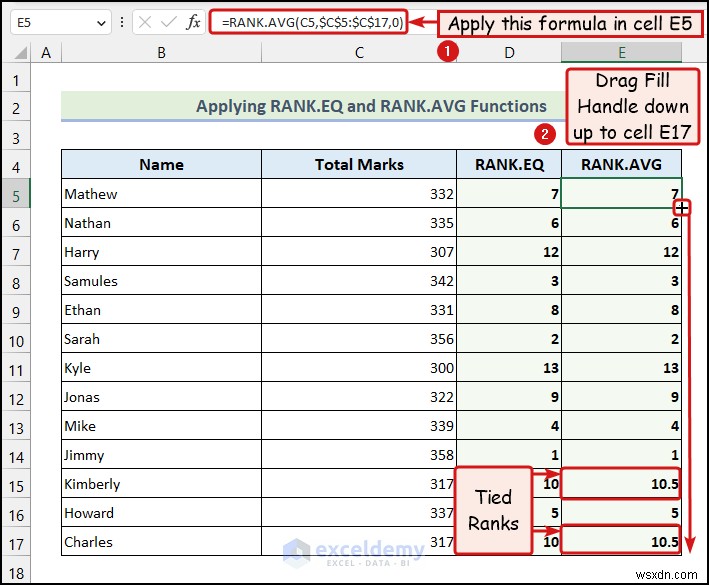
এখানে, ১০ম এবং ১১ম মানগুলো টাই ছিল, তাই RANK.AVG ফাংশন দুটির জন্যও গড় ১০.৫ ফেরত দিয়েছে।
RANK.AVG ফাংশনও একটি ডেটাসেটের আপেক্ষিক র্যাঙ্ক ফেরত দেয়। কিন্তু, টাই হওয়ার ক্ষেত্রে, এটি টাই করা মানগুলোর জন্য একটি গড় র্যাঙ্ক ফেরত দেয়। উদাহরণস্বরূপ, মনে করুন ৪র্থ এবং ৫ম র্যাঙ্কের মানগুলো টাই। তাহলে, RANK.AVG ফাংশন দুটির জন্যও র্যাঙ্ক ৪.৫ ফেরত দেবে। পরবর্তী মানটির র্যাঙ্ক হবে ৬। এখন, এক্সেলে ডেটা পরিসংখ্যানগতভাবে বিশ্লেষণ করতে RANK.AVG ফাংশন ব্যবহার করার জন্য নিচের নির্দেশাবলী অনুসরণ করুন।
- আমরা সেল E5-এ নিচের ফর্মুলা ব্যবহার করেছি:
=RANK.AVG(C5,$C$5:$C$17,0)
আরো、〈PERCENTRANK.INC, PERCENTRANK.EXC, PERCENTILE.INC, PERCENTILE.EXC, QUARTILE.INC এবং QUARTILE.EXC ফাংশন ব্যবহার করে এক্সেলে ডেটার আপেক্ষিক অবস্থান হিসাব করা যায়।
পদ্ধতি ৩ - корелেশন এবং রিগ্রেশন নির্ণয় করা
৩.১ SLOPE, INTERCEPT, এবং STEYX ফাংশন ব্যবহার করা
STEYX ফাংশন আমাদের দiber bâtiments X মান জন্য Y মান-এর স্ট্যান্ডার্ড এরর। আমরা এটি ব্যবহার করে X মান থেকে Y মান অনুমান করতে পারি।
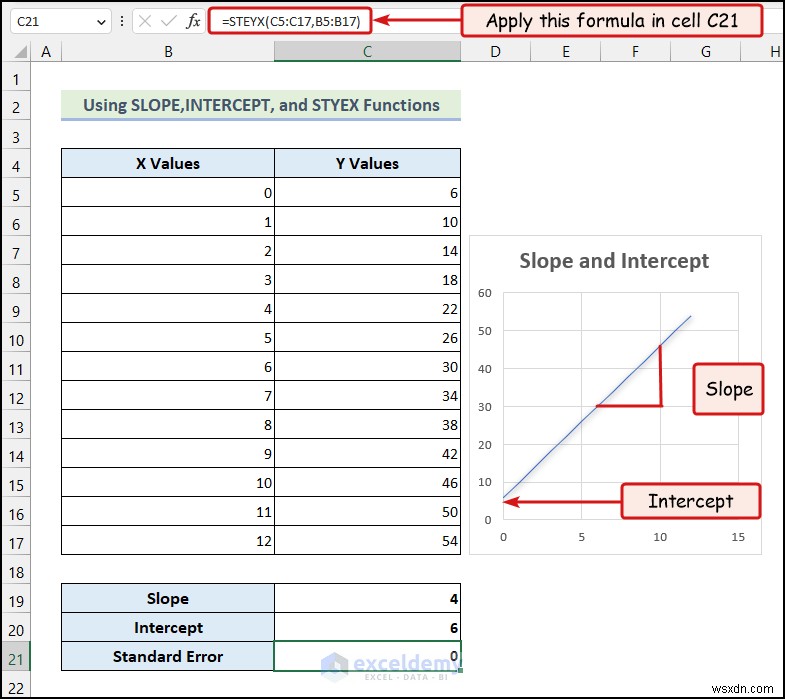
ধাপগুলো:
- সেল C21-এ নিচের ফর্মুলা লিখুন:
এখানে, সেলের রেঞ্জ C5:C17 Y মান কলামের সেলগুলোকে বোঝায়, এবং সেলের রেঞ্জ B5:B17 X মান কলামের সেলগুলোকে বোঝায়।
- ENTER চাপুন।
আপনি সেল C21-এ দেওয়া X মানের জন্য Y মান-এর স্ট্যান্ডার্ড এরর পাবেন।
৩.২ CORREL ফাংশন প্রয়োগ করা
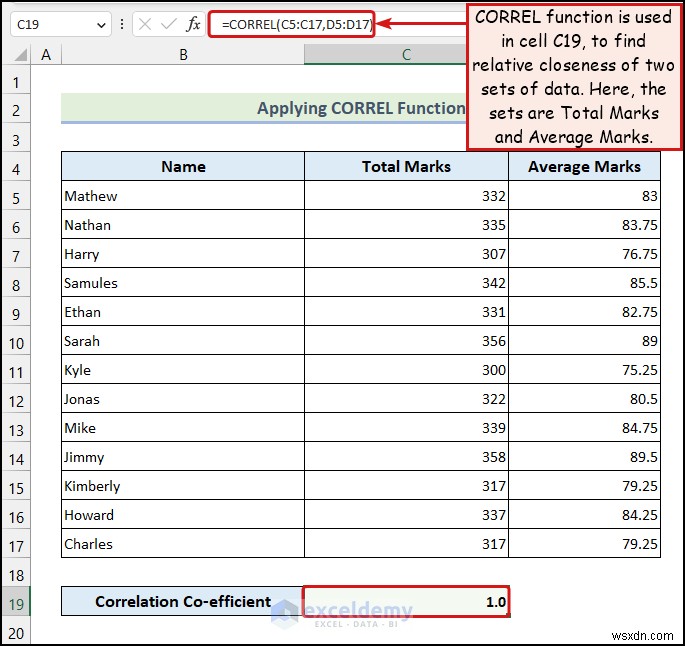
CORREL ফাংশন আমাদের দুটি ডেটা সেট কতটুকু ঘনিষ্ঠভাবে সম্পর্কিত সেটা জানতে সাহায্য করে।
- আমরা C19 সেলে নিচের ফর্মুলা ব্যবহার করেছি:
এখানে, রেঞ্জ C5:C17 মোট নম্বর কলামের সেলগুলোকো নির্দেশ করে, এবং রেঞ্জ D5:D17 গড় নম্বর কলামের সেলগুলোকো বোঝায়।
৪. সাঙ্কetik বিশ্লেষণের জন্য অ্যারে ফাংশন প্রয়োগ করা
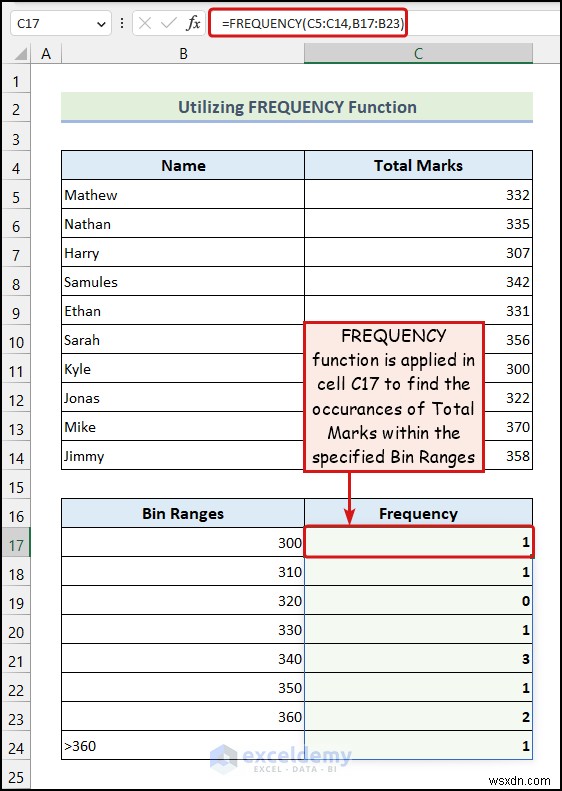
এখানে, নিচের ছবির तरह প্রতিটি বিন রেঞ্জ-এর জন্য ফ্রিকোয়েন্সি দেওয়া আছে। আমরা এক্সেলে ডেটা পরিসংখ্যানগতভাবে বিশ্লেষণ করতে সবচেয়ে সাধারণ অ্যারে ফাংশনগুলোতে একটি FREQUENCY ফাংশন ব্যবহার করেছি।
- সেল C17-এ নিচের ফর্মুলা লিখুন:
=FREQUENCY(C5:C14,B17:B23)
এখানে, রেঞ্জ B17:B23 বিন রেঞ্জ কলামের প্রথম সাত সেলকে প্রতীক করে।
আপনি MODE.MULT ফাংশন, LINEST ফাংশন, TREND ফাংশন, এবং GROWTH ফাংশন ব্যবহার করে এক্সেলে ডেটা পরিসংখ্যানগতভাবে বিশ্লেষণ করতে পারেন।
নোট: আপনি যদি পুরানো এক্সেল ভার্সন ব্যবহার করেন, তবে অ্যারে ফর্মুলা ব্যবহার করার জন্য আপনাকে CTRL + SHIFT + ENTER চাপতে হতে পারে। আমরা এক্সেল ৩৬৫ ব্যবহার করছি, তাই শুধু ENTER চাপলেই হবে।
পদ্ধতি ৫ - ডেটা অ্যানালিসিস টুলপ্যাক ব্যবহার করে মুভিং এভারেজ হিসাব করা
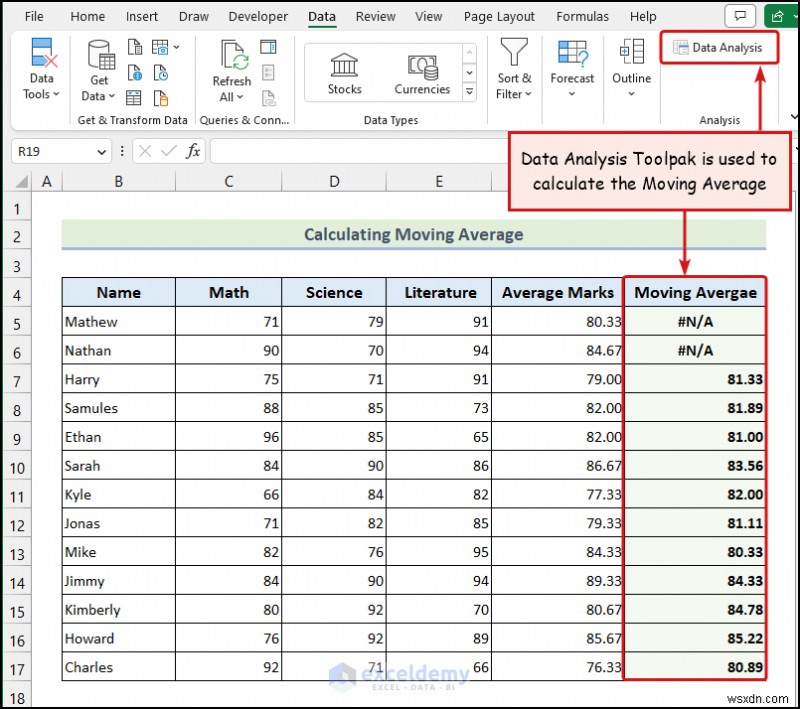
উপরোক্ত ছবিটি আমাদের ডেটাসেটের মুভিং এভারেজ-কে প্রতীক করে। ডেটা অ্যানালিসিস টুলপ্যাক অপশন এক্সেল রিবনে ডিফল্টভাবে থাকে না। আপনাকে এই ফিচারটি ম্যানুয়ালি সক্রিয় করতে হবে। আপনি এই আর্টিকেলটি ফলো করে ডেটা অ্যানালিসিস টুলপ্যাক সক্রিয় করতে এবং এর বিভিন্ন ব্যবহার সম্পর্কে জানতে পারেন।
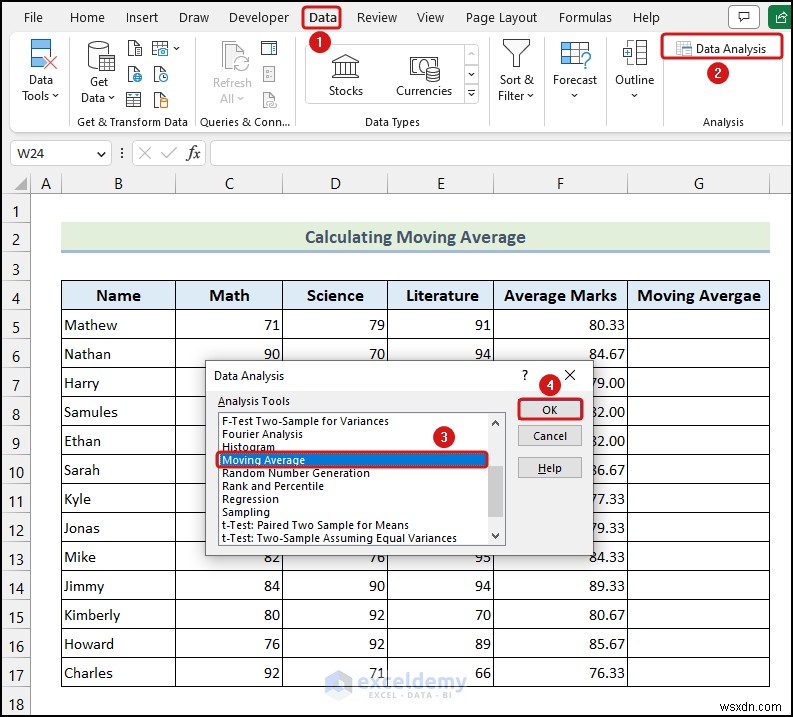
- রিবন থেকে ডেটা ট্যাবে যান >> Analysis গ্রুপ থেকে Data Analysis অপশন বেছে নিন।
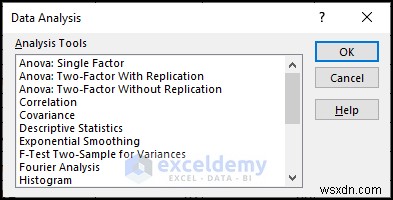
Data Analysis ডায়ালগ বক্স আপনার ওয়ার্কশিটে আসবে, যেমন উপরের ছবিতে দেখানো হয়েছে।
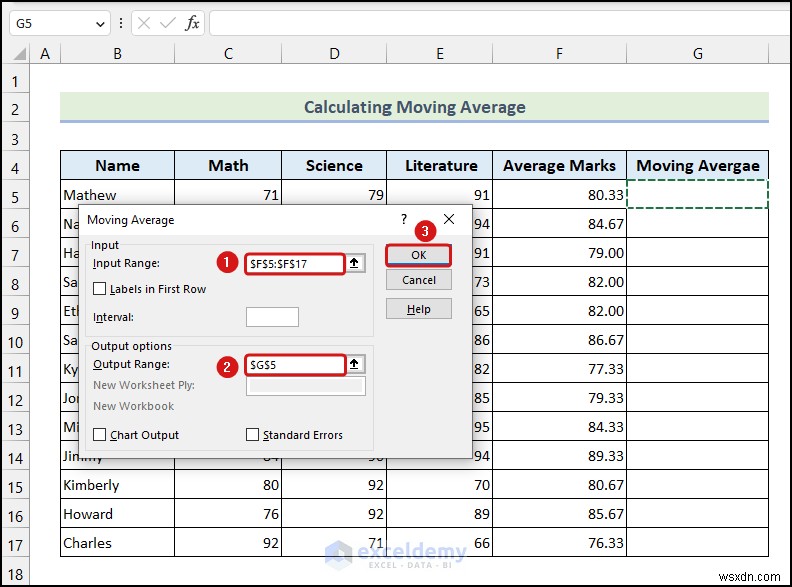
- Input Range ফিল্ডে যান গড় নম্বর কলামের সেলগুলো নির্বাচন করতে >> Output Range ফিল্ডে ক্লিক করুন এবং সেল G5 নির্বাচন করুন >> OK-এ ক্লিক করুন।
এক্সেলে কিছু সাধারণ ডেটা অ্যানালিসিস টুল
- Anova: Single Factor → দুটি বা তার বেশি পর্যবেক্ষণের জন্য ভেরিয়েন্স বিশ্লেষণ করে।
- Anova: Two Factor with Replication → ভেরিয়েবলগুলোর লেভেলের প্রতিটি কম্বিনেশনের জন্য, এটি দুটি স্বাধীন ভেরিয়েবল এবং বিভিন্ন পর্যবেক্ষণের সাথে ভেরিয়েন্স বিশ্লেষণ তৈরি করে।
- Anova: Two Factor Without Replication → ভেরিয়েবলগুলোর লেভেলের প্রতিটি কম্বিনেশনের জন্য, এটি দুটি স্বাধীন ভেরিয়েবল এবং একক পর্যবেক্ষণের সাথে ভেরিয়েন্স বিশ্লেষণ তৈরি করে।
- Correlation → যখন একটি নমুনার মানুষের উপর দুটির চেয়ে বেশি পরিমাপ থাকে, তখন প্রতিটি সম্ভাব্য পরিমাপের জোড়ার জন্য корелেশন কোএফিসিয়েন্টের একটি ম্যাট্রিক্স গণনা করা হয়।
- Covariance → যখন একটি নমুনার মানুষের উপর দুটির চেয়ে বেশি পরিমাপ থাকে, তখন প্রতিটি সম্ভাব্য পরিমাপের জোড়ার জন্য কোভেরিয়েন্স কোএফিসিয়েন্টের একটি ম্যাট্রিক্স গণনা করা হয়।
- Descriptive Statistics → এটি একটি নির্দিষ্ট সেল রেঞ্জের মধ্যে মানগুলোর কেন্দ্রীয় প্রবণতা, পরিবর্তনশীলতা এবং অন্যান্য বৈশিষ্ট্য সংক্ষেপে একটি রিপোর্ট তৈরি করে।
- Exponential Smoothing → এটি পূর্বের মান এবং পূর্বের অনুমানের সিকোয়েন্স ব্যবহার করে একটি সিকোয়েন্সের পরবর্তী মান অনুমান করে।
- F-Test Two-Sample for Variances → এটি F-Test eseguire করে দুটি ভেরিয়েন্স তুলনা করে।
- Histogram → এটি একটি নির্বাচিত সেল রেঞ্জের মধ্যে মানগুলোর ফ্রিকোয়েন্সি ডিস্ট্রিবিউশনের একটি টেবুলার চিত্র তৈরি করে।
- Random Number Generation → সাতটি সম্ভাব্য ডিস্ট্রিবিউশনের যেকোনো একটি ভিত্তিতে নির্দিষ্ট পরিমাণ র্যান্ডম নাম্বার জেনারেট করে।
- Rank and Percentile → এটি একটি মান সেটের প্রতিটি মান এবং এর অর্ডিনাল ও পেরসেন্টাইল র্যাঙ্ক দেখানোর একটি টেবিল তৈরি করে।
- Regression → এটি একটি ডিপেন্ডেন্ট ভেরিয়েবল এবং এক বা একাধিক ইনডিপেন্ডেন্ট ভেরিয়েবল ধারণকারী ডেটা সেটে প্রয়োগ করা লিনিয়ার রিগ্রেশন পরিসংখ্যানের একটি রিপোর্ট তৈরি করে।
- Sampling → এটি নির্দিষ্ট রেঞ্জের সেলগুলোর থেকে একটি নমুনা মান জেনারেট করে।
Data Analysis ToolPak-এ আপনি নিচের অ্যানালিসিস টুলগুলো পাবেন।
মনে রাখার বিষয়গুলো
- এক্সেলে যেকোনো ডেটা অ্যানালিসিস করার আগে, আপনাকে আপনার ডেটার ধরন নিয়ে স্পষ্ট ধারণা থাকতে হবে, যেমন: συνεχি বা শ্রেণিবদ্ধ।
- এরপর, আপনাকে পরিসংখ্যানগত বিশ্লেষণের সমৃদ্ধ তালিকা থেকে টুলগুলো বেছে নিতে হবে, যেমন: t-test, ANOVA, রিগ্রেশন, এবং কোরিলেশন।
- আপনি একবার আপনার বিশ্লেষণ সম্পন্ন করলে, আপনার ফলাফলকে অর্থপূর্ণভাবে ব্যাখ্যা করা গুরুত্বপূর্ণ। এর মানে হলো সংখ্যাগুলোর অর্থ বুঝতে পারা এবং সেগুলো কীভাবে আপনার গবেষণার প্রশ্নের সাথে সম্পর্কিত।
- শেষে, ত্রুটি চেক করে এবং নিশ্চিত করে যে আপনার বিশ্লেষণ সুদৃঢ়, আপনার ফলাফলগুলো যাচাই করা গুরুত্বপূর্ণ। এতে আউটলায়ার চেক করা, অনুমানগুলো টেস্ট করা, এবং সেনসিটিভিটি অ্যানালিসিস করা অন্তর্ভুক্ত।
অনুশীলন বিভাগ
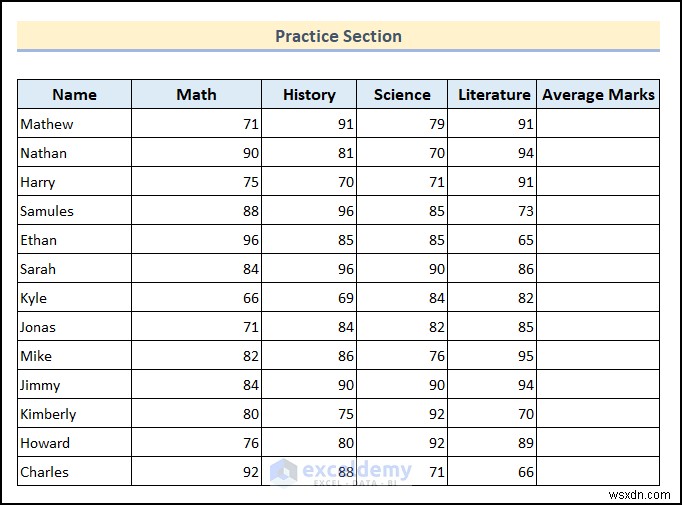
এক্সেল ওয়ার্কবুকে, আমরা অনুশীলন বিভাগ প্রদান করেছি ওয়ার্কশিটের ডান পাশে।
প্র্যাকটিস ওয়ার্কবুকের প্রতিটি ওয়ার্কশিটে একটি নমুনা অনুশীলন বিভাগ প্রদান করা হয়েছে।
অনুশীলন ওয়ার্কবুক ডাউনলোড করুন
নিচের ওয়ার্কবুকটি ডাউনলোড করুন এবং অনুশীলন করুন।
ফ্রি অ্যাডভান্সড এক্সেল অনুশীলনী সমাধানসহ পান!
