

বৈচিত্র্য বিশ্লেষণ বা ANOVA একটি উপকারী অ্যানালাইসিস। ১৯১৮ সালে এর বিকাশের শুরু থেকে ही এটি ব্যাপকভাবে ব্যবহৃত হয়েছে। এটি মিন এবং বিভিন্ন গ্রুপের মধ্যে স্ট্যাটিস্টিক্যাল পার্থক্য দেখায় এবং নির্ধারণ করে তাদের প্রতিটি ভ্যালু কতটুকু কোরিলেট করে। একটি নেস্টেড ANOVA হলো সেখানে এই গ্রুপগুলো আরও অনেক গ্রুপে সাব-ডিভাইডেড থাকে যাদের আমরা আলাদা আলাদা কোরিলেট করতে পারি বা নাও পারি। এই আর্টিকেলে নেস্টेड ANOVA-র ওভারভিউ এবং এক্সেলে কীভাবে অ্যানালাইসিস করা যায় সেটা আলোচনা করা হবে।
প্রদর্শনে ব্যবহৃত ওয়ার্কবুকটি নিচের লিংক থেকে ডাউনলোড করতে পারেন।
ANOVA অ্যানালাইসিস কী?
ANOVA একটি স্ট্যাটিস্টিক্যাল পদ্ধতি যা একটি ডেটাসেটে পর্যবেক্ষিত বৈচিত্র্য বিশ্লেষণ করতে ব্যবহৃত হয়। এটি করতে হলে, ডেটাসেটকে দুটি বিভাগে ভাগ করতে হয়- সিস্টেম্যাটিক এবং র্যান্ডম ফ্যাক্টর।
ANOVA আমাদের নির্ধারণ করতে দেয় কোন ফ্যাক্টরগুলো একটি দেওয়া ডেটা সেটকে উল্লেখযোগ্যভাবে প্রভাবিত করে। অ্যানালাইসিস কমপ্লিট হলে, একজন অ্যানালিস্ট সাধারণত méthodological ফ্যাক্টরগুলোর উপর অতিরিক্ত অ্যানালাইসিস করে যেগুলো ডেটা সেটের অসঙ্গতিপূর্ণ প্রকৃতিকে উল্লেখযোগ্যভাবে প্রভাবিত করে। সেক্ষেত্রে, সে রিগ্রেশন অ্যানালাইসিস অনুমানের জন্য প্রাসঙ্গিক অতিরিক্ত ডেটা তৈরি করতে ANOVA ফাইন্ডিংস ব্যবহার করে। ANOVA অনেক ডেটা সেট তুলনা করে দেখে তাদের মধ্যে কোনো লিংক আছে কিনা।
ANOVA-এর দুটি টাইপ রয়েছে, একটা হলো সিঙ্গল ফ্যাক্টর আরেকটা হলো টু ফ্যাক্টর। সিঙ্গল ফ্যাক্টরে, ANOVA একটি ফ্যাক্টর একটি ভেরিয়েবলের ওপর প্রভাব খুঁজে বের করে। অন্যদিকে, টু ফ্যাক্টর ANOVA-এ একাধিক ডিপেন্ডেন্ট ভেরিয়েবল থাকে।
নেস্টेड ANOVA-র ওভারভিউ
নেস্টেড ANOVA, নাম অনুযায়ী, অন্তত একটি ফ্যাক্টর অন্য একটি ফ্যাক্টরের ভেতরে নেস্টেড থাকে।
মান লইয়া, একটি নির্দিষ্ট প্রতিষ্ঠানের দুটি স্টোর দুটি ভিন্ন জায়গায় আছে। উদাহরণস্বরূপ, প্রথম স্টোরে ২টি টিম- টিম A এবং B আছে এবং দ্বিতীয় স্টোরে টিম C এবং D। তাদের নিজস্ব টিমের ভেতর তাদের বিক্রয় নেস্টেড থাকবে স্টোরের ভেতরে।
আলंকারিকভাবে, এটি এরকম হবে।
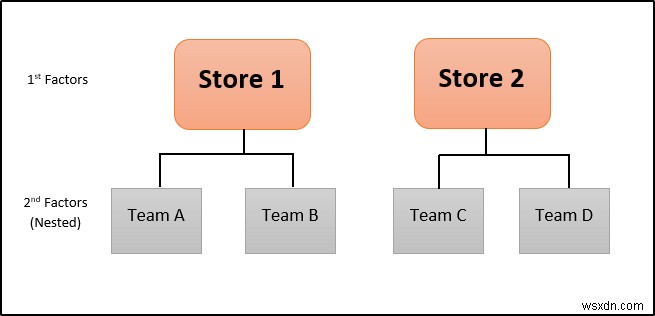
চিত্র থেকে আপনি দেখতে পাচ্ছেন, দ্বিতীয় ফ্যাক্টরগুলো প্রথম ফ্যাক্টরের ভেতরে নেস্টেড। সুতরাং, এধরনের বিক্রয়ের ANOVA অ্যানালাইসিস নেস্টেড ANOVA ক্যাটাগরিতে পড়বে।
এখন রিডিং বা ডেটা এন্ট্রি থেকে ডেটা স্প্রেডশীটে এরকম দেখাবে।
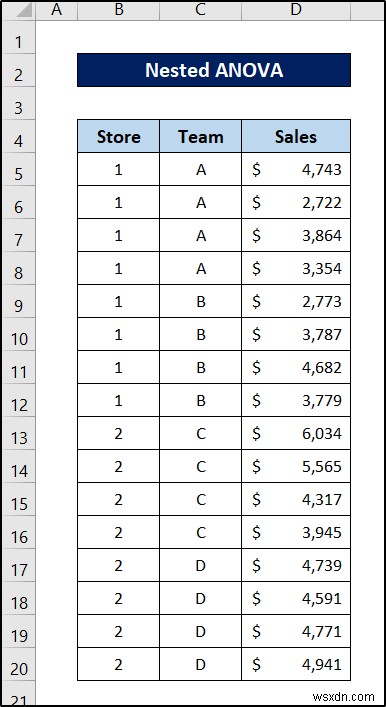
এই ডেটা থেকে আমরা দুটি জিনিস অ্যানালাইসিস করতে পারি- প্রতিটি স্টোরে (ফ্যাক্টর ১) এবং প্রতিটি টিমে (ফ্যাক্টর ২) বিক্রয় সমান কিনা?
এই ডেটার ওপর ANOVA পারফর্ম করলে (এর বিস্তারিত পরবর্তী সেকশনে), আমরা নিচের ধরনের কিছু পাব।
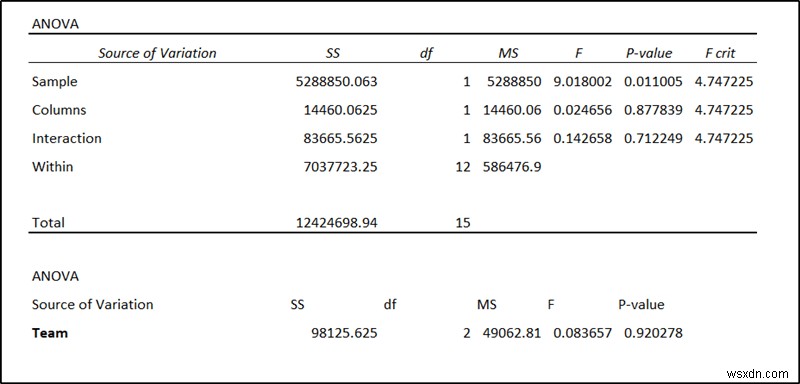
এখানে p-values প্রতিটি ফ্যাক্টরrabes bedeutendতা জাজ করবে। এই ডেটা থেকে আমরা দেখতে পাচ্ছি যে, স্টোরের স্ট্যাটিস্টিক্যালি উল্লেখযোগ্য ইফেক্ট আছে তবে তাদের ভেতরের টিমগুলোর নেই।
এই ক্যালকুলেশন ও ইন্টারপ্রেটেশনের আরও বিস্তারিত পরবর্তী সেকশনে।
এক্সেলে নেস্টেড ANOVA কীভাবে পারফর্ম করবেন
এক্সেলে নেস্টেড ANOVA করার কোনো ডায়রেক্ট উপায় নেই। কিন্তু আমরা ডেটাসেট মডিফাই করে এবং কিছু ম্যানুয়াল ক্যালকুলেশন করে অপারেশনটি পারফর্ম করতে পারি। এখানে আমরা Data Analysis Toolpak-এর Two Factor with Replication ফিচার ব্যবহার করব। মনে রাখবেন, ডিফল্টভাবে আপনার রিবনে Data Analysis Toolpak নাও থাকতে পারে। এখানে ক্লিক করুন Data Analysis Toolpak সক্রিয় করার পদ্ধতি জানতে। শেষে, আমাদের ম্যানুয়াল ক্যালকুলেশনের জন্য F.DIST.RT ফাংশন লাগবে।
কিন্তু প্রথমে, আসল কাঁচা ডেটাসেটে কিছু মডিফিকেশন আনার দরকার। কারণ আমরা এতে Two Factor with Replication পারফর্ম করব। আগের সেকশন থেকে কাঁচা ডেটাসেট নিই।
এখন নেস্টেড ANOVA এক্সেলে করার ধাপগুলো দেখতে নিচের স্টেপগুলো ফলো করুন।
ধাপগুলো:
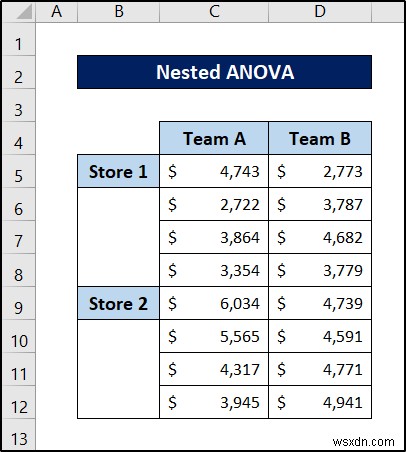
- প্রথমে, ডেটাসেটকে নিচের মত রি-অ্যারেঞ্জ করুন। আমরা টিম C এবং D-এর বিক্রয় ভ্যালুগুলো A এবং B-এর অধীনে রেখেছি যাতে এক্সেল সেগুলো পড়তে পারে।
- এখন আপনার রিবনের Data ট্যাবে যান।
- তারপর Analyze গ্রুপ সেকশন থেকে Data Analysis সিলেক্ট করুন।
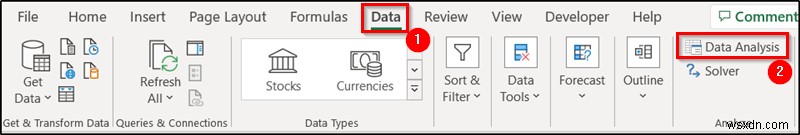
- Data Analysis বক্স প্রদর্শিত হবে।
- এখন Analysis Tools এর অধীনে Anova: Two-Factor with Replication সিলেক্ট করুন।
- তারপর OK চাপুন।
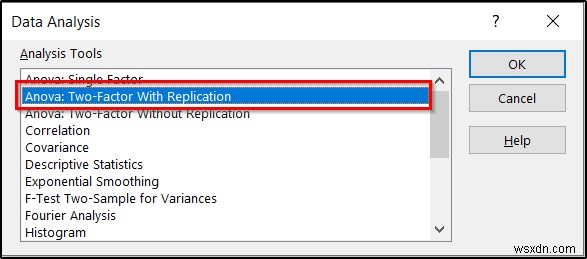
- পরবর্তী, Anova:Two-Factor With Replication বক্স প্রদর্শিত হবে। বক্সে নিচের विवরণ সিলেক্ট করুন।
- প্রথমে, ইনপুট রেঞ্জ হিসেবে রেঞ্জ B4:D12 ইনপুট করুন।
- দ্বিতীয়, Rows per sample ফিল্ডে 4 ইনপুট করুন, কারণ আমাদের নেস্টেড ফ্যাক্টরের প্রতিটি জন্য চারটি এন্ট্রি আছে।
- আপনি Alpha ভ্যালুও চেঞ্জ করতে পারেন। কিন্তু আমরা এখন 0.05-এ রাখব।
- তৃতীয়, Output options-এ আপনি কোথায় রেজাল্ট দেখাতে চান সেটি সিলেক্ট করুন।
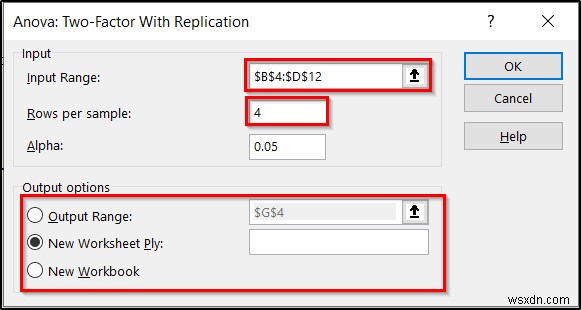
- এই সব কাজ হলে OK চাপুন।
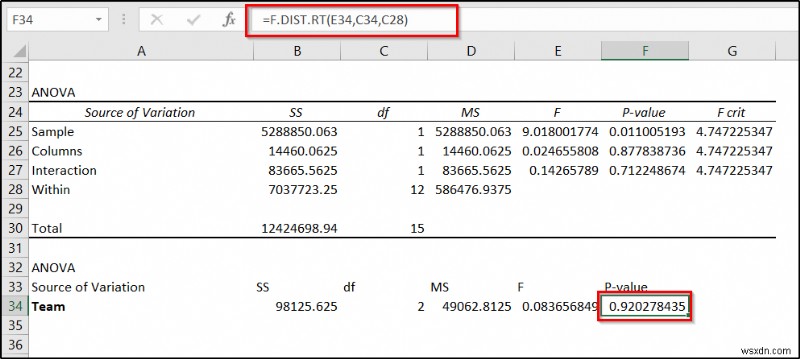
- ফলস্বরূপ, আপনি যেই লোকেশন সিলেক্ট করেছেন সেখানে রেজাল্ট পপ-আপ হবে। আমরা ANOVA-র লাস্ট পোশন ব্যবহার করব নেস্টেড ANOVA অ্যানালাইসিসের জন্য এক্সেলে।
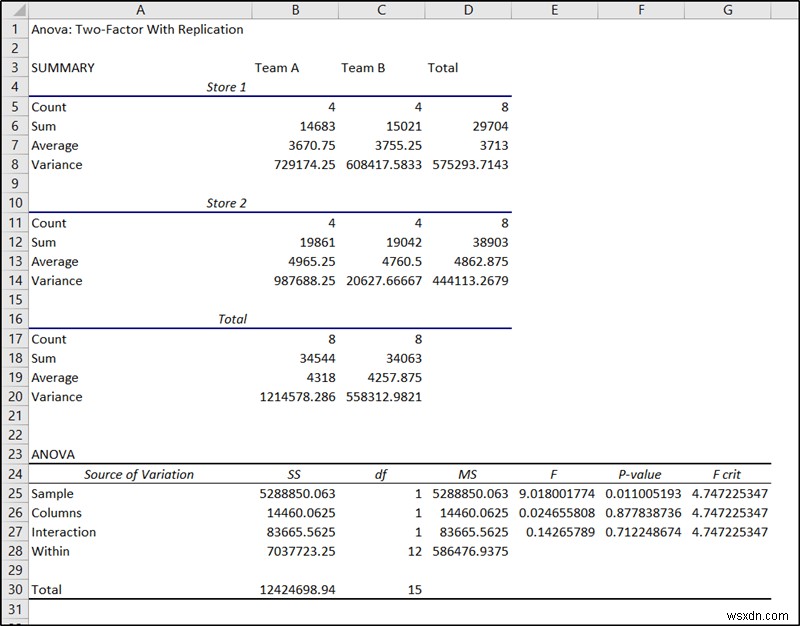
- সেল F25-এ স্যাম্পলের p-value নির্দেশ করে স্যাম্পলের σημαντত্ব যা এই কেসে প্রথম ফ্যাক্টর, স্টোর।
- অন্যান্য ফ্যাক্টরদের σημαντত্বের জন্য, আমাদের এখন কিছু ম্যানুয়াল ক্যালকুলেশন করতে হবে।
- প্রথমে, সেল B34 সিলেক্ট করুন এবং নিচের ফর্মুলা লিখুন।
=B26+B27
- তারপর Enter চাপুন।
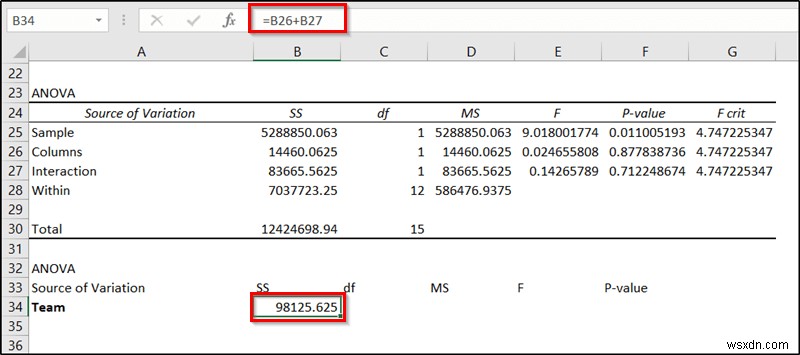
- এখন সেল C34-এ নিচের ফর্মুলা ইনপুট করুন এবং Enter চাপুন।
=C26+C27
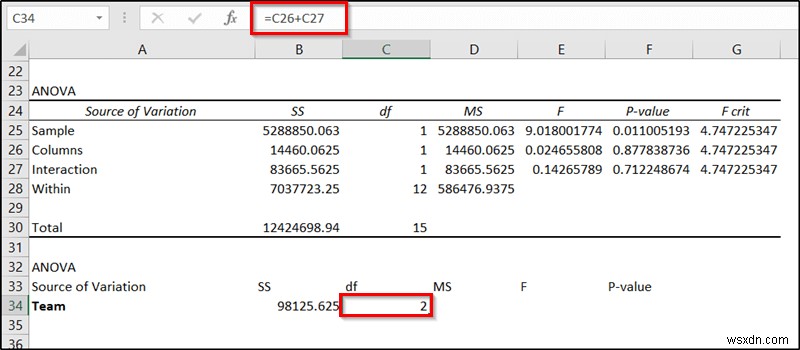
- পরবর্তী, সেল D34-এ নিচের ফর্মুলা ইনপুট করুন এবং Enter চাপুন।
=B34/C34
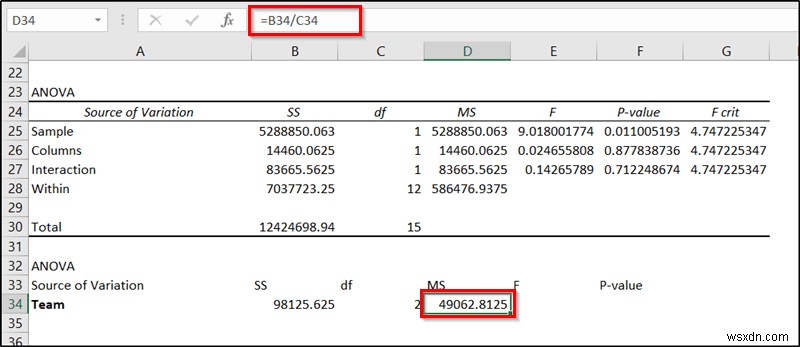
- उसके बाद, সেল E34-এ নিচের ফর্মুলা ব্যবহার করুন।
=D34/D28
- শেষে, সেল F34-এ নিচের ফর্মুলা ব্যবহার করুন এবং তারপর Enter চাপুন।
=F.DIST.RT(E34,C34,C28)
ফলাফলের ইন্টারপ্রেটেশন
ANOVA অ্যানালাইসিস থেকে কোনো ফ্যাক্টরের p-value ০.০৫-র চেয়ে কম দিলে সেটি ডেটার ওপর উল্লেখযোগ্য প্রভাব ফেলে বলে বোঝায়। এই উদাহরণে, আমাদের দুটি ফ্যাক্টর ছিল- স্টোর এবং টিম, যেখানে টিমগুলো স্টোরের ভেতরে নেস্টেড। এই ডেটার জন্য স্টোরের p-value সেল F25-এ এবং টিমের p-value সেল F34-এ রয়েছে।
ফলাফল থেকে দেখতে পাচ্ছি, স্টোরের p-value হলো 0.011005 যা 0.05-র চেয়ে কম। এটি এই ফ্যাক্টরের বিক্রয়ের ওপর উল্লেখযোগ্য প্রভাব 있음을 নির্দেশ করে। যদপি টিম ফ্যাক্টরের p-value হলো 0.9202 যা 0.05-র চেয়ে বেশি। যা ডেটা বা বিক্রয়ের ওপর কোনো উল্লেখযোগ্য প্রভাব নেই বলে বোঝায়। সুতরাং, আমরা নিরাপদে নিষ্কর্ষ করতে পারি যে, এই কেসে স্টোর লোকেশন টিমের কর্মচারীদের কম্বিনেশনের চেয়ে বেশি গুরুত্বপূর্ণ।
এভাবেই আমরা এক্সেলে নেস্টেড ANOVA পারফর্ম করতে পারি।
এক্সেলে নেস্টেড ANOVA-র ২টি উপযুক্ত উদাহরণ
এক্সেলে নেস্টেড ANOVA পারফর্ম করার জেনারেল আইডিয়া একই। এখন আমরা একই পদ্ধতিটি দুটি ভিন্ন উদাহরণে প্রয়োগ করব যাতে এর ব্যবহার ভিন্ন কেসে দেখানো যায়। মনে রাখবেন, রিবনে Data Analysis Toolpak থাকতে হবে। না থাকলে, Data Analysis Toolpak সক্রিয় করার পদ্ধতি জানতে এখানে ক্লিক করুন।
১. ভিন্ন লেন্থের রেজিস্ট্যান্সের বৈচিত্র্য ক্যালকুলেট করা
এই প্রথম উদাহরণে, আমরা নিচের ডেটাসেটটি ব্যবহার করব।
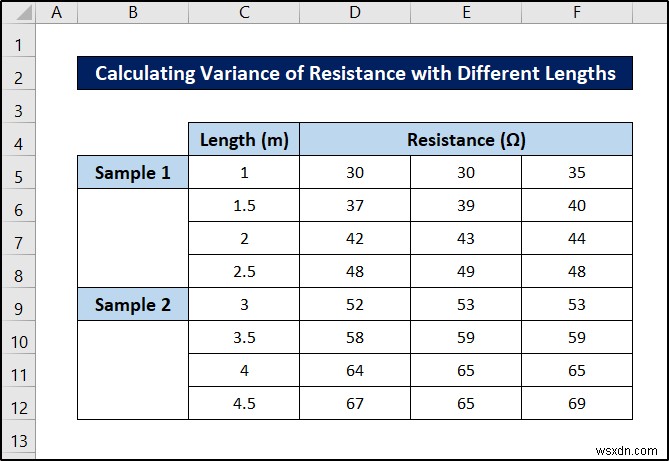
আপনি বলতে পারেন এখানে দুটি নেস্ট আছে- রেজিস্ট্যান্স ভ্যালুগুলো লেন্থের ভেতরে নেস্টেড, যা আবার ভিন্ন স্যাম্পলের ভেতরে নেস্টেড।
কিন্তু মূল আইডিয়া হলো ডেটাসেটের জন্য Two-Factor With Replication ব্যবহার করা। তাই ডেটাসেটকে এইভাবে থাকতে হবে। এবং আগের মত, শেষে ম্যানুয়াল ক্যালকুলেশনের জন্য F.DIST.RT ফাংশন লাগবে। এক্সেলে এই নেস্টেড ডেটাসেটে ANOVA পারফর্ম করার ধাপগুলো দেখতে স্টেপগুলো ফলো করুন।
ধাপগুলো:
- প্রথমে, আপনার রিবনের Data ট্যাবে যান।
- তারপর Analyze গ্রুপ সেকশন থেকে Data Analysis সিলেক্ট করুন।
- Data Analysis বক্স প্রদর্শিত হবে।
- এখন Analysis Tools এর অধীনে Anova: Two-Factor with Replication সিলেক্ট করুন।
- তারপর OK চাপুন।
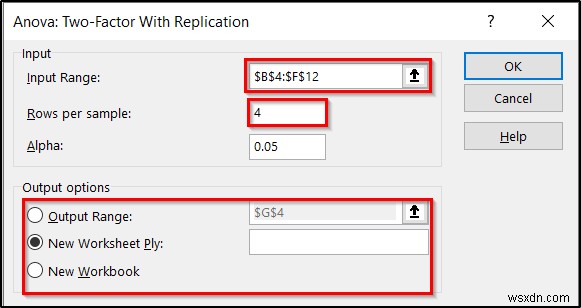
- পরবর্তী, Anova:Two-Factor With Replication বক্স প্রদর্শিত হবে। বক্সে নিচের বিবরণ সিলেক্ট করুন।
- প্রথমে, ইনপুট রেঞ্জ হিসেবে রেঞ্জ B4:F12 ইনপুট করুন।
- দ্বিতীয়, Rows per sample ফিল্ডে 4 ইনপুট করুন, কারণ আমাদের নেস্টেড ফ্যাক্টরের প্রতিটি জন্য চারটি এন্ট্রি আছে।
- আপনি Alpha ভ্যালুও চেঞ্জ করতে পারেন। কিন্তু আমরা এখন 0.05-এ রাখব।
- তৃতীয়, Output options-এ আপনি কোথায় রেজাল্ট দেখাতে চান সেটি সিলেক্ট করুন।
- এই সব কাজ হলে OK চাপুন।
- ফলস্বরূপ, আপনি যেই লোকেশন সিলেক্ট করেছেন সেখানে রেজাল্ট পপ-আপ হবে। আমরা ANOVA-র লাস্ট পোশন ব্যবহার করব নেস্টেড ANOVA অ্যানালাইসিসের জন্য এক্সেলে।
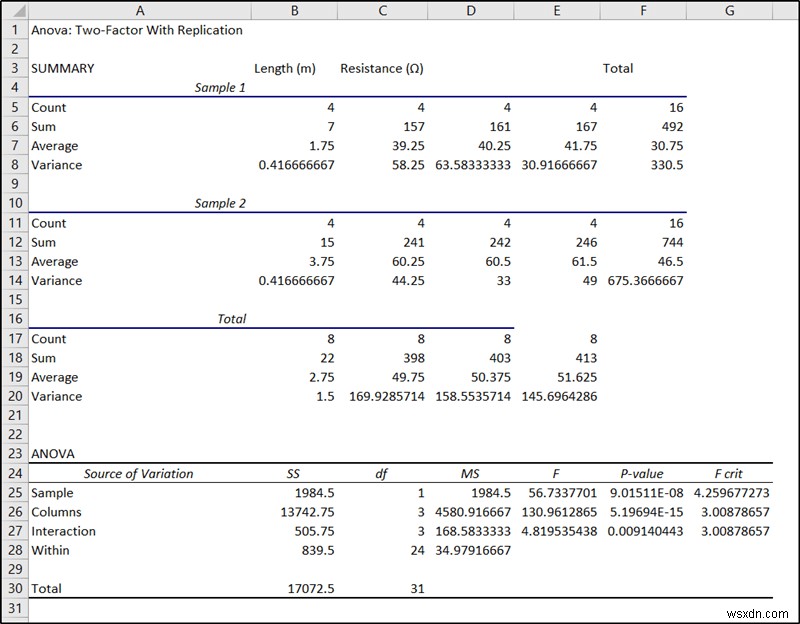
- সেল F25-এ স্যাম্পলের p-value নির্দেশ করে স্যাম্পলের σημαντত্ব যা এই কেসে প্রথম ফ্যাক্টর, স্যাম্পল।
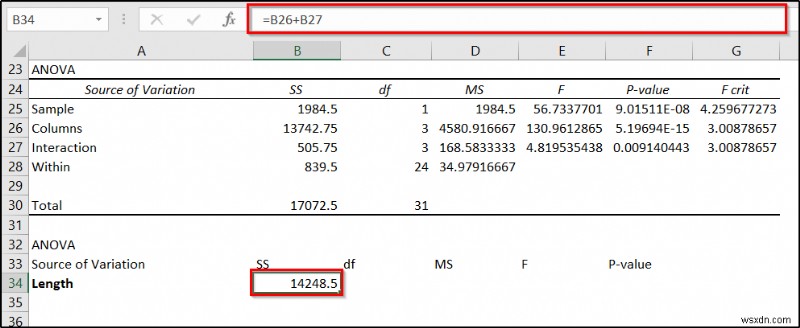
- এখন সেল B34 সিলেক্ট করুন এবং নিচের ফর্মুলা লিখুন।
=B26+B27
- তারপর Enter চাপুন।
- এখন সেল C34-এ নিচের ফর্মুলা ইনপুট করুন এবং Enter চাপুন।
=C26+C27
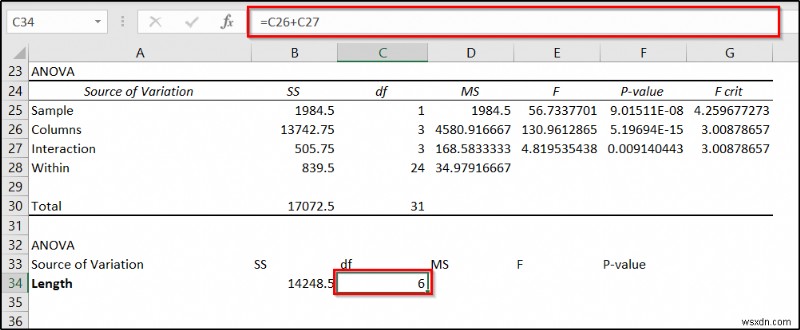
- পরবর্তী, সেল D34-এ নিচের ফর্মুলা ইনপুট করুন এবং Enter চাপুন।
=B34/C34
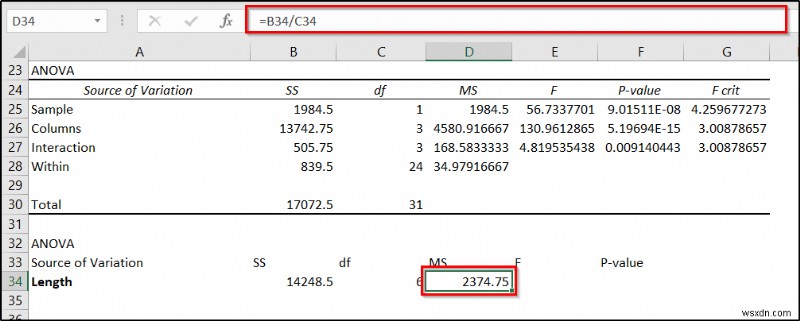
- उसके बाद, সেল E34-এ নিচের ফর্মুলা ব্যবহার করুন।
=D34/D28
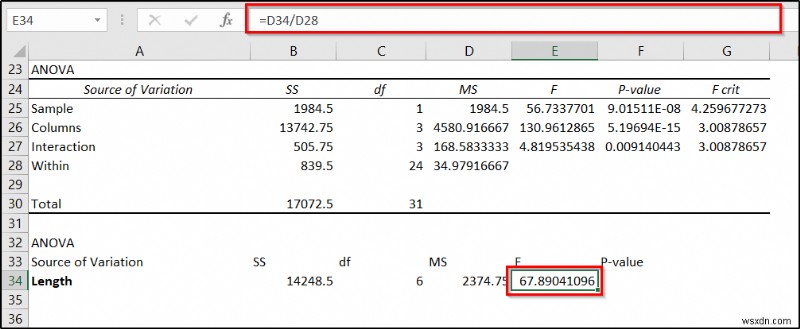
- শেষে, সেল F34-এ নিচের ফর্মুলা ব্যবহার করুন এবং তারপর Enter চাপুন।
=F.DIST.RT(E34,C34,C28)
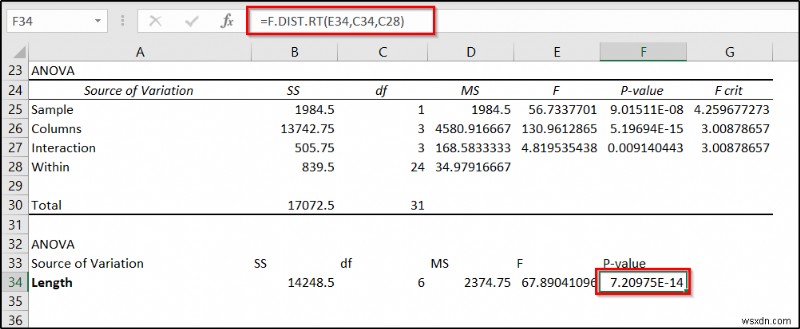
ফলাফলের ইন্টারপ্রেটেশন
চূড়ান্ত ফলাফলে, সেল F25-এ p-value নির্দেশ করে স্যাম্পল (ভিন্ন লেন্থের) গুরুত্ব এবং সেল F34-এর ভ্যালু নির্দেশ করে রেজিস্ট্যান্সের ওপর লেন্থের গুরুত্ব। যেহেতু দুটোই 0.05 আলফা ভ্যালুর নিচে, তাই এই উদাহরণে তারা উভয়ই উল্লেখযোগ্য ফ্যাক্টর।
আরও পড়ুন: এক্সেলে ANOVA ফলাফল ইন্টারপ্রেট (৩ পদ্ধতি)
সদৃশ পাঠ্যগুলো
- এক্সেলে রিগ্রেশন পারফর্ম এবং ANOVA ইন্টারপ্রেটেশন
- এক্সেলে One Way ANOVA (২টি উপযুক্ত উদাহরণ)
- এক্সেলে Anova ফলাফল গ্রাফ (৩টি উপযুক্ত উদাহরণ)
- এক্সেলে Repeated Measures ANOVA (সহজ ধাপ সহ)
২. ভিন্ন সেকশন থেকে নম্বরের বৈচিত্র্য অ্যানালাইসিস
এই দ্বিতীয় উদাহরণে, আমরা নিচের ডেটাসেটটি ব্যবহার করব।
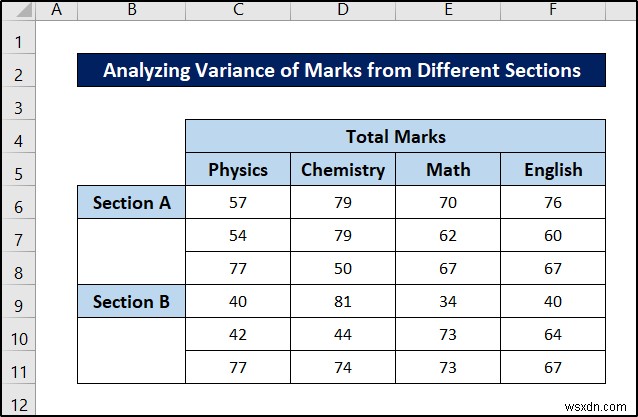
আবার, এটি two-way ANOVA-র ডেটাসেটের মতো দেখতে পারে। কিন্তু এক্সেলে অ্যানালাইসিস করার জন্য এটি একটি রি-অ্যারেঞ্জড নেস্টेड ANOVA। এবং আগের মত, শেষে ম্যানুয়াল ক্যালকুলেশনের জন্য F.DIST.RT ফাংশন লাগবে।
এই নেস্টেড ANOVA এক্সেলে কীভাবে পারফর্ম করবেন সেটা দেখতে এই ধাপগুলো ফলো করুন।
ধাপগুলো:
- প্রথমে, আপনার রিবনের Data ট্যাবে যান।
- তারপর Analyze গ্রুপ সেকশন থেকে Data Analysis সিলেক্ট করুন।
- Data Analysis বক্স প্রদর্শিত হবে।
- এখন Analysis Tools এর অধীনে Anova: Two-Factor with Replication সিলেক্ট করুন।
- তারপর OK চাপুন।
- পরবর্তী, Anova:Two-Factor With Replication বক্স প্রদর্শিত হবে। বক্সে নিচের বিবরণ সিলেক্ট করুন।
- প্রথমে, ইনপুট রেঞ্জ হিসেবে রেঞ্জ B5:F11 ইনপুট করুন।
- দ্বিতীয়, Rows per sample ফিল্ডে 3 ইনপুট করুন, কারণ আমাদের নেস্টেড ফ্যাক্টরের প্রতিটি জন্য তিনটি এন্ট্রি আছে।
- আপনি Alpha ভ্যালুও চেঞ্জ করতে পারেন। কিন্তু আমরা এখন 0.05-এ রাখব।
- তৃতীয়, Output options-এ আপনি কোথায় রেজাল্ট দেখাতে চান সেটি সিলেক্ট করুন।
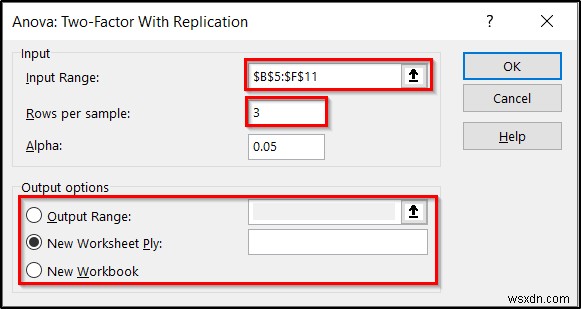
- এই সব কাজ হলে OK চাপুন।
- ফলস্বরূপ, আপনি যেই লোকেশন সিলেক্ট করেছেন সেখানে রেজাল্ট পপ-আপ হবে। আমরা ANOVA-র লাস্ট পোশন ব্যবহার করব নেস্টেড ANOVA অ্যানালাইসিসের জন্য এক্সেলে।
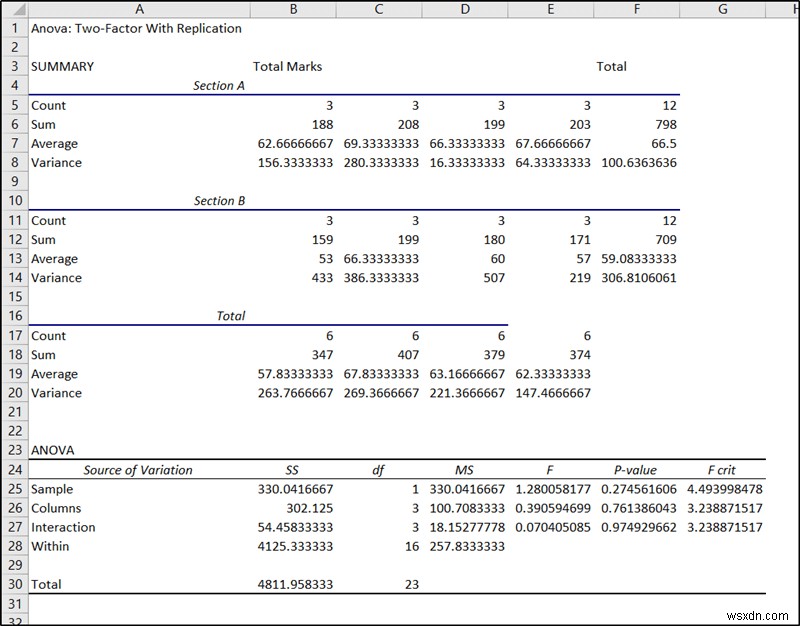
- সেল F25-এ স্যাম্পলের p-value নির্দেশ করে স্যাম্পলের σημαντত্ব যা এই কেসে প্রথম ফ্যাক্টর, সেকশন।
- এখন সেল B34 সিলেক্ট করুন এবং নিচের ফর্মুলা লিখুন।
=B26+B27
- তারপর Enter চাপুন।
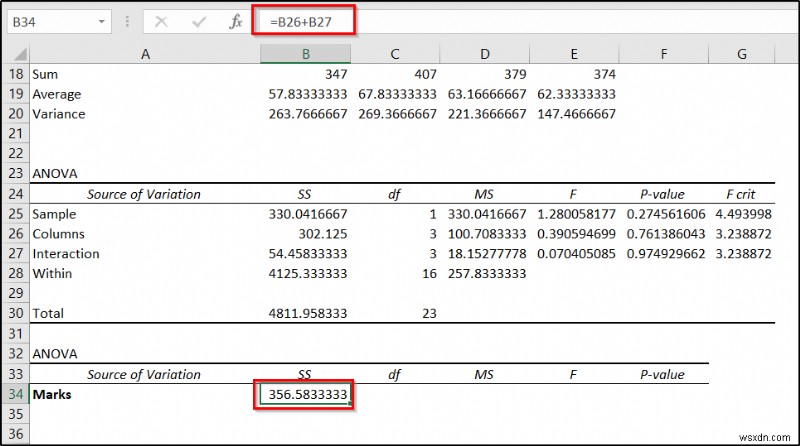
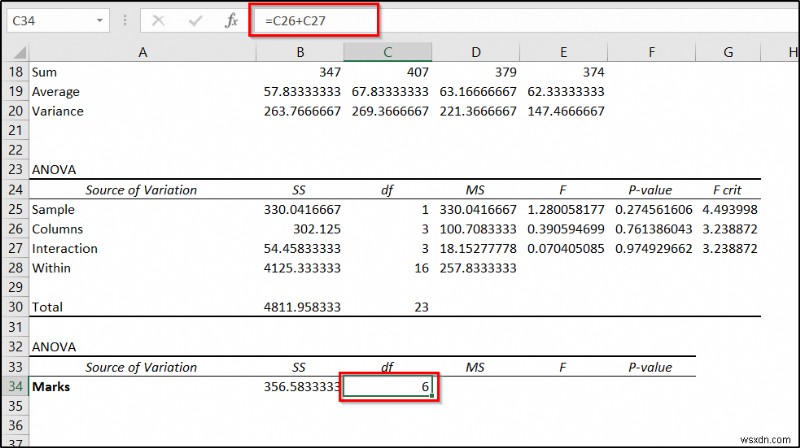
- এখন সেল C34-এ নিচের ফর্মুলা ইনপুট করুন এবং Enter চাপুন।
=C26+C27
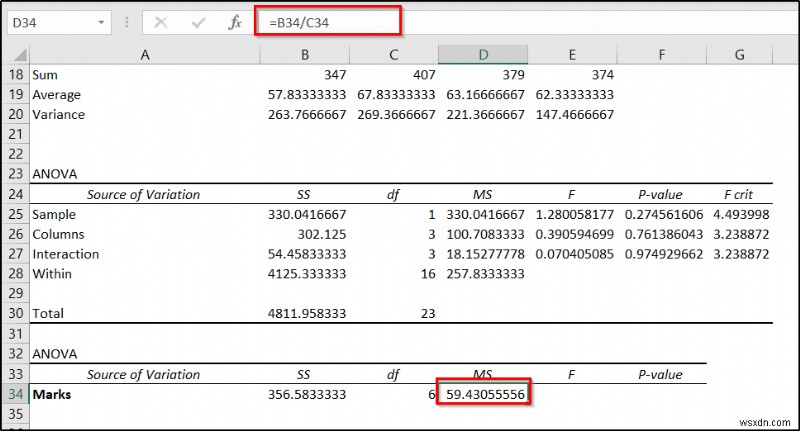
- পরবর্তী, সেল D34-এ নিচের ফর্মুলা ইনপুট করুন এবং Enter চাপুন।
=B34/C34
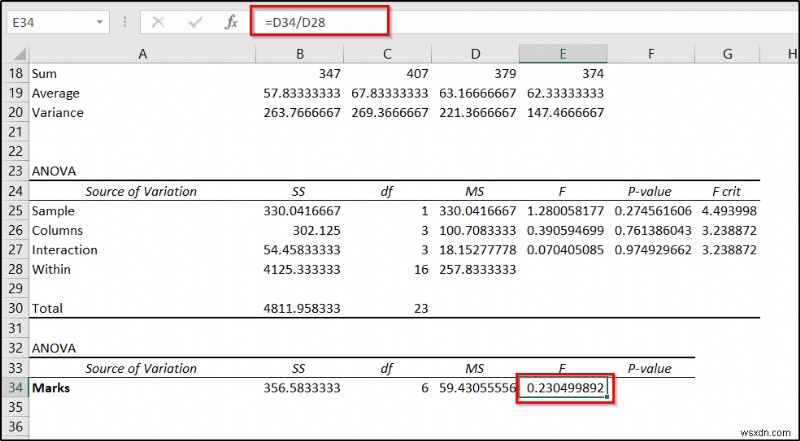
- उसके बाद, সেল E34-এ নিচের ফর্মুলা ব্যবহার করুন।
=D34/D28
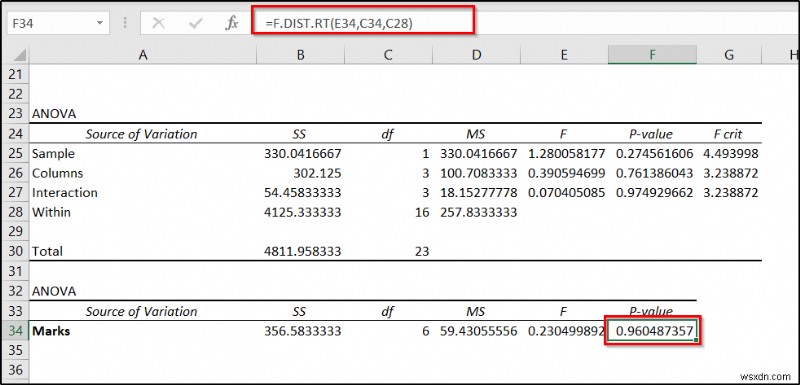
- শেষে, সেল F34-এ নিচের ফর্মুলা ব্যবহার করুন এবং তারপর Enter চাপুন।
=F.DIST.RT(E34,C34,C28)
ফলাফলের ইন্টারপ্রেটেশন
সেল F25-এ p-value স্ট্যাটিস্টিক্সের ওপর সেকশনের গুরুত্ব নির্দেশ করে। এই মান 0.05 আলফা ভ্যালুর চেয়ে বেশি। তাই এটার বেশি গুরুত্ব নেই। F34 সেলের ভ্যালু হলো ডেটাসেটে বিষয়ভিত্তিক নম্বরের p-value। এটি ও 0.05-র চেয়ে বেশি। তাই, এই ডেটাসেটে ভিন্ন সেকশনে ভিন্ন বিষয়ের নম্বরের ওপর ও কোনো উল্লেখযোগ্য ইফেক্ট নেই।
এটি এক্সেলে নেস্টেড ANOVA পারফর্ম করার আরেক উদাহরণ।
আরও পড়ুন: এক্সেল ANOVA-এ P Value ক্যালকুলেট (৩টি উপযুক্ত উদাহরণ)
নেস্টেড ANOVA-র বিষয়ে মনে রাখা উচিত কিছু কথা
- একটি নেস্টেড ANOVA-তে দুইটির চেয়ে অধিক ফ্যাক্টর থাকতে পারে। আগের সেকশনের প্রথম উদাহরণে ব্যবহৃত মত, একটি ফ্যাক্টর অন্য একটি ফ্যাক্টরের ভেতরে নেস্টেড থাকতে পারে। সেই ফ্যাক্টরও অন্য একটি ফ্যাক্টরের ভেতরে হায়ারার্কি আologiesে অন্যান্য একই লেভেলের ফ্যাক্টরসহ নেস্টেড থাকতে পারে।
- একটি নেস্টেড ANOVA, two-way ANOVA-থেকে আলাদা। টু-ফ্যাক্টর ANOVA-তে দুটি ফ্যাক্টর থাকে। কিন্তু একটি নেস্টেড ANOVA-তে অবশ্যই একটি ফ্যাক্টর অন্যটির ভেতরে নেস্টেড থাকতে হবে। যা টু-ওয়ে ANOVA-র কেসে নয়।
উপসংহার
তাহলে এক্সেলে নেস্টেড ANOVA করার পদ্ধতিটি এই ছিল। আশা করি আপনি টু-ওয়ে রেপ্লিকেশন ফিচার ব্যবহার করে এক্সেলে নেস্টেড ANOVA ব্যবহারের কনসেপ্টটি বুঝতে পেরেছেন এবং আপনার ডেটাসেট অনুযায়ী এটি ব্যবহার করতে পারবেন। আশা করি এই গাইড আপনার জন্য সহায়ক ও তথ্যপূর্ণ হয়েছে। আপনার যেকোনো প্রশ্ন বা সুপারিশ থাকলে নিচে কমেন্টে জানান।
আরও এই ধরনের গাইডের জন্য, Exceldemy.com ভিজিট করুন।
সম্পর্কিত আর্টিকেলগুলো
- এক্সেলে রো-পার-স্যাম্পল ANOVA প্রয়োগ (২ সহজ পদ্ধতি)
- এক্সেলে ANOVA টেবিল তৈরি (৩টি উপযুক্ত পদ্ধতি)
- Randomized Block Design ANOVA এক্সেলে (সহজ ধাপ সহ)
- এক্সেলে ANOVA Two Factor Without Replication ব্যবহার
