

এক্সেল অনেক ডেটা অ্যানালিস্টের জন্য এর সادगी এবং ফ্লেক্সিবিলিটির কারণে গো-টু টুল। কিন্তু বড়, পুনরাবৃত্ত, বা জটিল ডেটা টাস্কের জন্য, পাইথন গতি, অটোমেশন, এবং উন্নত অ্যানালিটিক্স প্রদান করে। এক্সেলকে পাইথনের সাথে ইন্টিগ্রেট করে, আপনি দুটির সেরা দিক ব্যবহার করতে পারেন।
এই টিউটোরিয়ালে, আমরা দেখব কিভাবে এক্সেলকে পাইথনের সাথে কম্বাইন করে একটি শক্তিশালী ডেটা সায়েন্স ওয়ার্কফ্লো তৈরি করা যায়।
প্রয়োজনীয় টুলস এবং সেটআপ
এক্সেলকে পাইথনের সাথে কম্বাইন করার আগে, এনভায়রনমেন্ট সেট আপ করুন। এটি নিশ্চিত করে যে আপনার ওয়ার্কফ্লো প্রথম ধাপ থেকে স্মুথ এবং প্রোডাক্টিভ।
পূর্বশর্ত:
- মাইক্রোসফট এক্সেল: প্রাথমিক ডেটা রিভিউ এবং রিপোর্টিং-এর জন্য।
- পাইথন ৩.x: আপনার ডেটা সায়েন্স ওয়ার্কফ্লোর ইঞ্জিন।
- পাইথন লাইব্রেরি:
- pandas ডেটা অ্যানালিসিসের জন্য।
- matplotlib প্লটিং-এর জন্য।
- openpyxl (ঐচ্ছিক, এক্সেল ফাইল লেখার জন্য)।
- numpy (নামেরিক্স)।
- matplotlib/seaborn ভিজ্যুয়ালাইজেশনের জন্য।
পাইথন লাইব্রেরি ইনস্টল করুন:
pip install pandas matplotlib openpyxl
১. পাইথনে ডেটা পড়ুন
আপনি প্যান্ডাস ব্যবহার করে আপনার ডেটা পাইথনে লোড করতে পারেন, যা টেবুলার ডেটা ম্যানিপুলেট এবং অ্যানালাইজ করা সহজ করে।
import pandas as pd # Read data from Excel file df = pd.read_excel('SalesData.xlsx') # Preview data print(df.head()) # Show the first 5 rows of the data print(df.info()) # Show info about columns, datatypes, and missing values
- pd.read_csv() এক্সেল ফাইলকে প্যান্ডাস DataFrame-এ পড়ে।
- df.head() প্রথম পাঁচ সারি দেখায়, দ্রুত চেকের জন্য চমৎকার।
- df.info() রো, কলাম, এবং ডেটা টাইপের সংখ্যা দেখায়।
আপনি আপনার সেলস ডেটার প্রথম কয়েক সারি দেখবেন, এর সাথে একটি সামারি যেমন:
TransactionID Date CustomerID ProductID ProductName Category Quantity UnitPrice Region Channel SalesRep 0 100001 2024-01-02 C-100 P-101 Laptop Electronics 2.0 800.0 East Online Smith 1 100002 2024-01-02 C-101 P-102 Printer Electronics 1.0 200.0 West Retail Johnson 2 100003 2024-01-03 C-102 P-103 Mouse Electronics 5.0 25.0 North Online Lee 3 100004 2024-01-04 C-103 P-104 Desk Furniture 1.0 150.0 South Retail Brown 4 100005 2024-01-05 C-104 P-105 Monitor Electronics 3.0 175.0 NaN Online Davis <class 'pandas.core.frame.DataFrame'> RangeIndex: 63 entries, 0 to 62 Data columns (total 11 columns): # Column Non-Null Count Dtype --- ------ -------------- ----- 0 TransactionID 63 non-null int64 1 Date 62 non-null datetime64[ns] 2 CustomerID 62 non-null object 3 ProductID 61 non-null object 4 ProductName 63 non-null object 5 Category 61 non-null object 6 Quantity 61 non-null float64 7 UnitPrice 62 non-null float64 8 Region 62 non-null object 9 Channel 62 non-null object 10 SalesRep 62 non-null object dtypes: datetime64[ns](1), float64(2), int64(1), object(7) memory usage: 5.5+ KB None
২. ডেটা ক্লিনিং এবং ট্রান্সফরমেশন
কাঁচা ডেটা কদাচিত অ্যানালিসিসের জন্য রেডি থাকে। এই ধাপে, আপনি মিসিং মান ঠিক করবেন, কলামগুলো সঠিক টাইপে কনভার্ট করবেন, এবং নতুন ক্যালকুলেটেড ফিল্ড যোগ করবেন।
ডুপ্লিকেট রিমুভ করুন:
# Remove Duplicates df = df.drop_duplicates()
- ডুপ্লিকেট ভ্যালু ড্রপ করে।
মিসিং মান চেক করুন:
# Print count of missing values per column print(df.isnull().sum())
- এটি প্রতিটি কলামে কতটুকু মিসিং (NaN) ভ্যালু আছে সেটা দেখায়। যদি কোনো থাকে, আপনি সেগুলো ড্রপ বা ফিল করার সিদ্ধান্ত নিতে পারেন।
#Output: TransactionID 0 Date 1 CustomerID 1 ProductID 2 ProductName 0 Category 2 Quantity 2 UnitPrice 1 Region 1 Channel 1 SalesRep 1 dtype: int64
ডেটা টাইপ কনভার্ট করুন:
# Convert 'Date' column to pandas datetime type for easier filtering/grouping df['Date'] = pd.to_datetime(df['Date'])
- এটি Date কলামকে টেক্সট থেকে প্যান্ডাস ডেটাইম ফরম্যাটে কনভার্ট করে সহজ ফিল্টারিং এবং গ্রুপিং-এর জন্য।
'TotalSales' কলাম তৈরি করুন:
# Add a new column: total value for each transaction df['TotalSales'] = df['Quantity'] * df['UnitPrice']
- প্রতিটি ট্রানজ্যাকশনের টোটাল ভ্যালু দেখানোর জন্য একটি নতুন কলাম যোগ করে।
টাইম সিরিজ অ্যানালিসিসের জন্য Month এক্সট্রাক্ট করুন:
df['Month'] = df['Date'].dt.to_period('M')
- এটি সেলস মাস অনুযায়ী গ্রুপ এবং অ্যানালাইজ করার জন্য একটি Month কলাম তৈরি করে।
- এখন print(df.head()) ব্যবহার করে ক্লিনড ডেটা প্রিভিউ করুন।
#Ouput: TransactionID Date CustomerID ProductID ProductName Category ... UnitPrice Region Channel SalesRep TotalSales Month 0 100001 2024-01-02 C-100 P-101 Laptop Electronics ... 800.0 East Online Smith 1600.0 2024-01 1 100002 2024-01-02 C-101 P-102 Printer Electronics ... 200.0 West Retail Johnson 200.0 2024-01 2 100003 2024-01-03 C-102 P-103 Mouse Electronics ... 25.0 North Online Lee 125.0 2024-01 3 100004 2024-01-04 C-103 P-104 Desk Furniture ... 150.0 South Retail Brown 150.0 2024-01 4 100005 2024-01-05 C-104 P-105 Monitor Electronics ... 175.0 NaN Online Davis 525.0 2024-01
৩. আপনার ডেটা অ্যানালাইজ করুন
একটি ক্লিন ডেটাসেটের সাথে, আপনি এখন ইনসাইট জেনারেট করতে পারেন যা ব্যবসায়িক মূল্য চালায়। এতে মাস, প্রোডাক্ট, এবং অঞ্চল অনুযায়ী সেলস অ্যাগ্রিগেট করা অন্তর্ভুক্ত।
মাস অনুযায়ী টোটাল সেলস:
# Group by month and sum the total sales for each month monthly_sales = df.groupby('Month')['TotalSales'].sum() print(monthly_sales)
- ডেটাকে Month অনুযায়ী গ্রুপ করে এবং প্রতিটি মাসের জন্য TotalSales যোগ করে।
#Output: Month 2024-01 9075.0 2024-02 9800.0 2024-03 9075.0 Freq: M, Name: TotalSales, dtype: float64
টপ-সেলিং প্রোডাক্ট:
# Group by product, sum total sales, and sort from highest to lowest product_sales = df.groupby('ProductName')['TotalSales'].sum().sort_values(ascending=False) print(product_sales)
- প্রতি প্রোডাক্ট সেলস যোগ করে, তারপর সবচেয়ে জনপ্রিয় থেকে কম জনপ্রিয় পর্যন্ত সোর্ট করে।
#Output: ProductName Laptop 15200.0 Monitor 3850.0 Printer 3200.0 Desk 2550.0 Chair 2325.0 Mouse 1125.0 Name: TotalSales, dtype: float64
অঞ্চল অনুযায়ী সেলস:
# Group by region and sum total sales per region region_sales = df.groupby('Region')['TotalSales'].sum() print(region_sales)
- প্রতিটি অঞ্চলের জন্য টোটাল সেলস অ্যাগ্রিগেট করে।
#Output: Region East 6075.0 North 5925.0 South 8225.0 West 7500.0
৪. মূল ইনসাইট ভিজ্যুয়ালাইজ করুন
ডেটা ভিজ্যুয়ালাইজ করলে আরও শক্তিশালী হয়। চলুন কুইক চার্ট তৈরি করি যাতে আপনি এবং স্টেকহোল্ডাররা কী ট্রেন্ড এক নজরে বুঝতে পারেন।
৪.১. মাসিক সেলস ট্রেন্ড
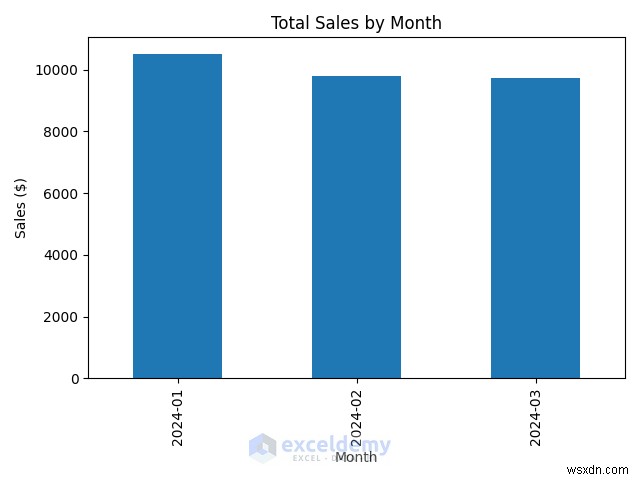
import matplotlib.pyplot as plt # Import for plotting # Create a bar chart of sales by month monthly_sales.plot( kind='bar', title='Total Sales by Month', ylabel='Sales ($)', xlabel='Month' ) plt.tight_layout() # Avoid label overlap plt.savefig('monthly_sales.png') # Save the figure as a PNG file plt.show() # Display the chart
- মাসিক সেলসকে বার চার্ট হিসেবে প্লট করে।
- plt.savefig চার্টটি রিপোর্টের জন্য সংরক্ষণ করে
- একটি বার চার্ট প্রতিটি মাসে সেলস পরিবর্তন দেখাবে।
৪.২. অঞ্চল অনুযায়ী সেলস
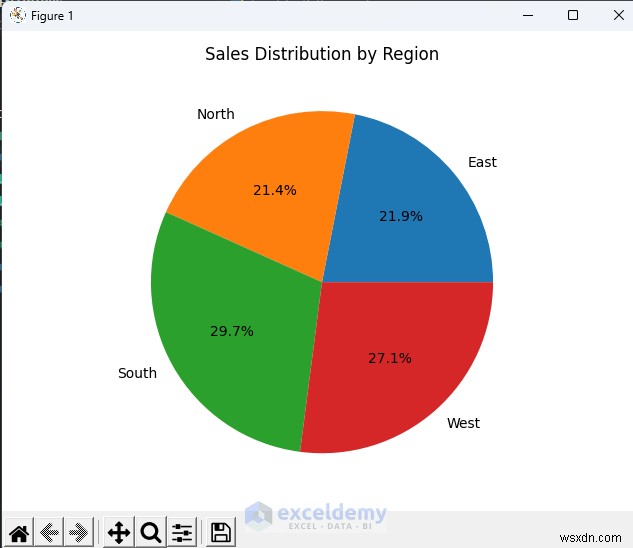
# Pie chart of sales by region region_sales.plot( kind='pie', autopct='%1.1f%%', title='Sales Distribution by Region' ) plt.ylabel('') # Remove default y-label plt.tight_layout() plt.savefig('region_sales.png') plt.show()
- অঞ্চল অনুযায়ী সেলসের পাই চার্ট, ম্যানেজমেন্ট বা মার্কেটিং-এর জন্য চমৎকার।
৫. উন্নত অ্যানালাইসিস এবং মডেলিং
বেসিক গ্রুপিং এবং সারসংক্ষেপের বাইরে, পাইথন কয়েক লাইন কোডে উন্নত σταтистиক্যাল অ্যানালিসিস, পিভট টেবিল, এবং এমনকি মেশিন লার্নিং সক্ষম করে। চলুন ডেটা আরও গভীরে খনন করি আরও ইনসাইট আনলক করার জন্য।
৫.১. ডেসক্রিপ্টিভ স্ট্যাটিস্টিক্স
ডেসক্রিপ্টিভ স্ট্যাটিস্টিক্স আপনার ডেটাসেটের একটি কুইক সামারি দেয়, নামেরিক কলামের জন্য মিন, স্ট্যান্ডার্ড ডেভিয়েশন, এবং কোয়ার্টাইল দেখায়।
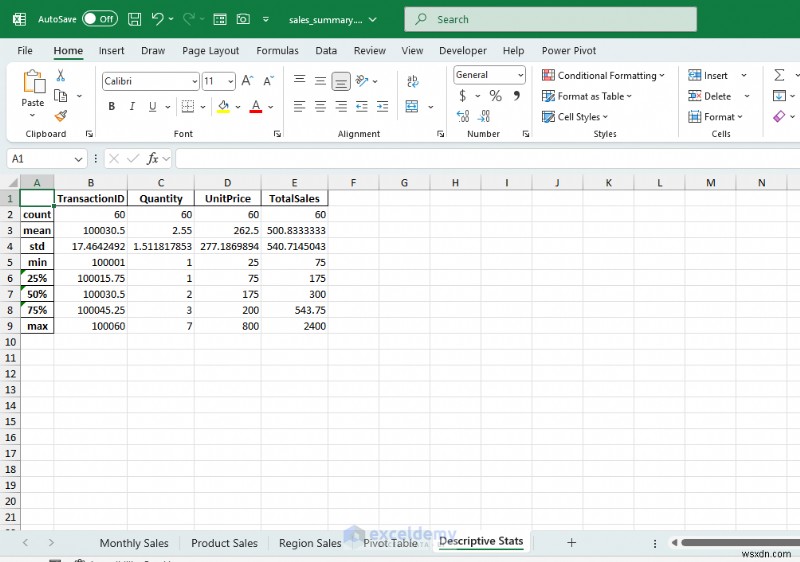
# Show summary statistics for numeric columns (mean, std, min, max, quartiles, etc.) print(df.describe())
- df.describe() দ্রুত সব নামেরিক কলাম সারসংক্ষেপ করে (যেমন Quantity, UnitPrice, TotalSales)।
#Output: TransactionID Quantity UnitPrice TotalSales count 61.000000 59.000000 60.000000 59.000000 mean 100030.180328 2.542373 262.083333 478.813559 std 17.497150 1.534905 277.339497 527.085627 min 100001.000000 1.000000 25.000000 75.000000 25% 100015.000000 1.000000 75.000000 162.500000 50% 100030.000000 2.000000 175.000000 300.000000 75% 100045.000000 3.000000 200.000000 525.000000 max 100060.000000 7.000000 800.000000 2400.000000
৫.২. প্যান্ডাসে পিভট টেবিল
পিভট টেবিল এক্সেলে ইন্টারঅ্যাক্টিভ রিপোর্টিং-এর জন্য শক্তিশালী, এবং প্যান্ডাসও সেটা করতে পারে।
# Create a pivot table: sum TotalSales for each Region pivot = df.pivot_table(index='Region', values='TotalSales', aggfunc='sum') print(pivot)
- pivot_table() প্রতিটি অঞ্চলের জন্য TotalSales সারসংক্ষেপ করে, এক্সেলের Pivot Table-এর মতো।
#Output TotalSales Region East 6075.0 North 5925.0 South 8225.0 West 7500.0
৫.৩. সিম্পল মেশিন লার্নিং উদাহরণ
দেখি কি শুধু কোয়ান্টিটি সেলড থেকে টোটাল সেলস প্রেডিক্ট করতে পারি একটি সিম্পল লিনিয়ার রিগ্রেশন (মেশিন লার্নিং) মডেল ব্যবহার করে।
from sklearn.linear_model import LinearRegression # Import linear regression from scikit-learn # Prepare features and target variable X = df[['Quantity']] # Feature: Quantity sold y = df['TotalSales'] # Target: Total sales value # Create and fit the regression model model = LinearRegression() model.fit(X, y) # Print the regression coefficient (slope) print('Coefficient:', model.coef_) # Print the intercept (base value when Quantity=0) print('Intercept:', model.intercept_)
- scikit-learn থেকে LinearRegression ইম্পোর্ট করে।
- Quantity ব্যবহার করে TotalSales প্রেডিক্ট করে।
- মডেল ফিট করে এবং কোইফিশিয়েন্ট প্রিন্ট করে (প্রতি এক্সট্রা ইউনিট সেলড-এ সেলস কতটুকু বাড়ে)।
#Output: Coefficient: [-37.65294772] Intercept: 596.8483500185391
৬. ক্লিনড/অ্যানালাইজড ডেটা এক্সেলে এক্সপোর্ট করুন
ডেটা ক্লিনিং, অ্যানালাইসিস, এবং মডেলিং করার পর, আপনি আপনার সারসংক্ষেপ টেবিল এবং ইনসাইটকে একটি মাল্টি-শীট এক্সেল ফাইলে এক্সপোর্ট করতে পারেন। এটি আপনার সব মূল ফাইন্ডিং একসাথে রাখে এবং এক্সেলে রিভিউর জন্য রেডি করে।
# Export summary and advanced analysis tables to a multi-sheet Excel file with pd.ExcelWriter('sales_summary.xlsx') as writer: # Monthly summary monthly_sales.to_frame().to_excel(writer, sheet_name='Monthly Sales') # Product summary product_sales.to_frame().to_excel(writer, sheet_name='Product Sales') # Region summary region_sales.to_frame().to_excel(writer, sheet_name='Region Sales') # Pivot table (total sales by region) pivot.to_excel(writer, sheet_name='Pivot Table') # Optionally, you can export descriptive statistics df.describe().to_excel(writer, sheet_name='Descriptive Stats')
- Context Manager (with … as writer): এক্সেল ফাইলটি সঠিকভাবে সংরক্ষণ এবং ক্লোজ হওয়া নিশ্চিত করে লেখার পর।
- প্রতিটি টেবিলের জন্য .to_excel(): প্রতিটি DataFrame বা সারসংক্ষেপকে তার নিজস্ব শীতে সংরক্ষণ করে সহজ অ্যাক্সেসের জন্য।
- কাস্টম শীট নাম: প্রতিটি শীট আপনার অ্যানালিসিস স্টেপের সাথে মেলাতে নামকরণ করা হয়েছে।
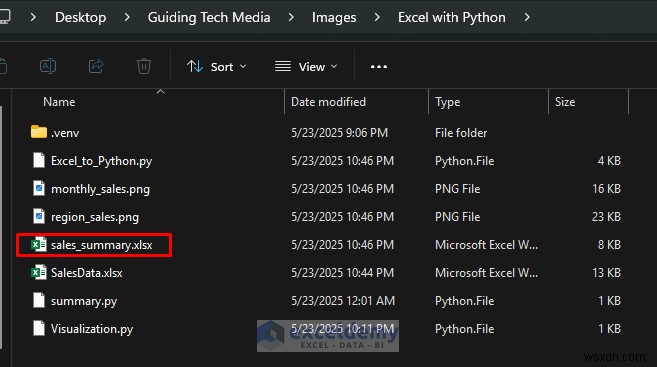
- sales_summary.xlsx এক্সেলে খুলুন।
- আপনি Monthly Sales, Product Sales, Region Sales, আপনার Pivot Table, এবং Descriptive Statistics-এর জন্য আলাদা শীট দেখবেন।
৭. আপনার ওয়ার্কফ্লো অটোমেট এবং স্কেল করুন
পাইথন ব্যবহার করে, আপনি পুনরাবৃত্ত রিপোর্ট বা অ্যানালিসিস অটোমেট করতে পারেন। পরবর্তীবার আপনি একটি নতুন এক্সেল ফাইল পেলে, শুধু ফাইলটি রিপ্লেস করুন এবং আপনার স্ক্রিপ্ট রি-রান করুন; সব অ্যানালিসিস এবং রিপোর্ট ইনস্ট্যান্টলি রিফ্রেশ হবে।
- সকল অ্যানালিসিস কোড এক পাইথন ফাইলে রাখুন।
- আপনার রিপোর্ট আপডেট করতে, CSV রিপ্লেস করুন এবং রান করুন:
python Excel_to_Python.py
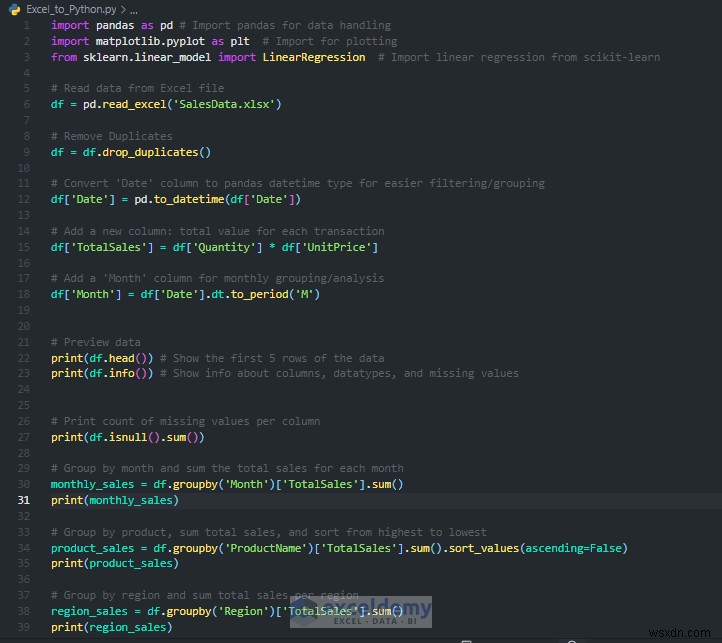
- এখন আরও শক্তির জন্য, আপনি এটিকে সাপ্তাহিক/মাসিক টাস্ক হিসেবে শিডিউল করতে পারেন।
উপসংহার
এক্সেলের ইনটুইটিভ ডেটা এন্ট্রি এবং রিপোর্টিংকে পাইথনের ডেটা সায়েন্স পাওয়ারের সাথে কম্বাইন করে, আপনি বড়, মেসি ডেটাসেট দক্ষতার সাথে প্রসেস এবং অ্যানালাইজ করতে পারেন। এটি পুনরাবৃত্ত রিপোর্টিং টাস্ক অটোমেট করে। মেশিন লার্নিং এবং উন্নত ভিজ্যুয়ালাইজেশন আনলক করে। আপনাকে একদিনে পাইথন এক্সপার্ট হতে হবে না। একটি সিম্পল টাস্ক দিয়ে শুরু করুন; একটা কাজ করলে, আরেকটা স্টেপ যোগ করুন। আপনি জানার আগেই জটিল রিপোর্ট অটোমেট করছেন।
