

ডেটা অ্যানালিসিস টুলপ্যাক এক্সেলের সেরা ফিচারগুলোর একটি যখন আমাদের উন্নত পরিসংখ্যানিক বিশ্লেষণ করতে হয়। আপনি যদি এক্সেলে ডেটা অ্যানালিসিস টুলপ্যাক ব্যবহারের কিছু বিশেষ ট্রিক খুঁজছেন, তবে আপনি সঠিক জায়গায় এসেছেন। এক্সেলে ডেটা অ্যানালিসিস টুলপ্যাক ব্যবহার করার অনেক পথ আছে। এই আর্টিকেলটি এক্সেল ডেটা অ্যানালিসিস টুলপ্যাক ব্যবহারের ১৩টি উপযুক্ত উদাহরণ আলোচনা করবে। সম্পূর্ণ গাইডটি ফলো করুন সব শিখতে।
এক্সেলে ডেটা অ্যানালিসিস টুলপ্যাক সক্ষম করার ধাপসমূহ
এক্সেল ডেটা অ্যানালিসিস টুলপ্যাকের সব ফিচার বিশ্লেষণ করার আগে, আমাদের এই টুলপ্যাক কীভাবে ইনস্টল করতে হয় তা দেখাতে হবে। এখানে আমরা দেখাব কিভাবে এক্সেলে ডেটা অ্যানালিসিস টুলপ্যাক সক্রিয় করতে হয়। এটি করতে আপনাকে নিচের প্রক্রিয়াটি অনুসরণ করতে হবে।
📌 ধাপসমূহ:
- প্রথমে, File-এ থেকে Options-এ যান।
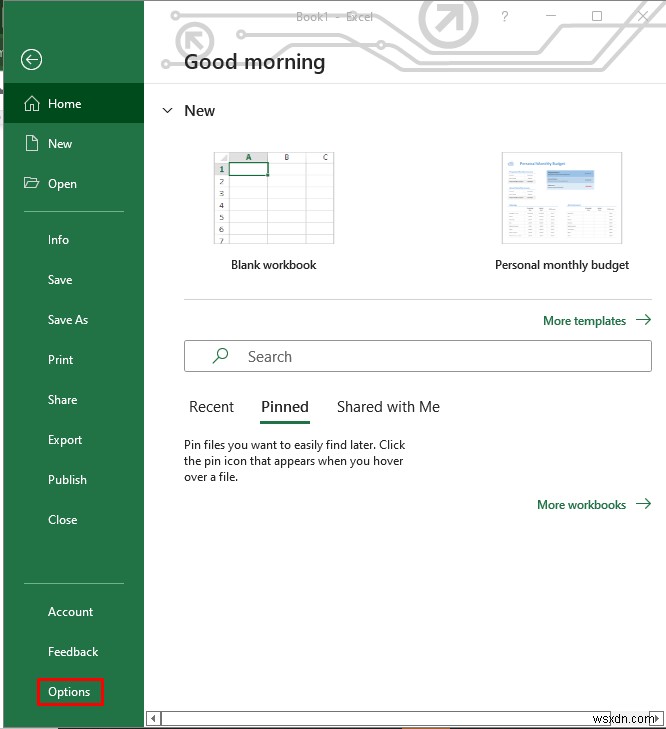
- তারপর, Add-ins-এ যান।
- এখানে, Manage ড্রপ-ডাউন মেনুতে Excel Add-ins সিলেক্ট করুন।
- এবং Go-এ ক্লিক করুন।
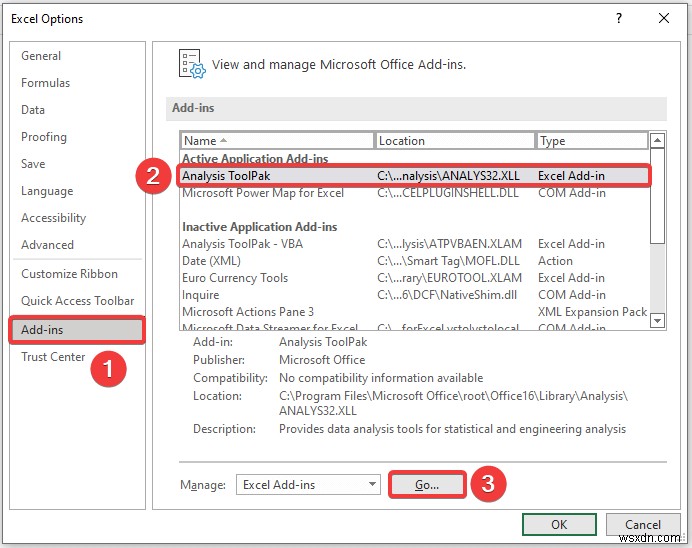
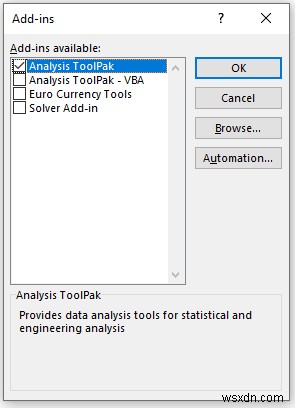
- তখন একটি নতুন উইন্ডো আসবে।
- এখানে, Analysis ToolPak অপশনটি চেক করুন। এবং OK-এ ক্লিক করুন। এভাবে আপনি এক্সেল ডেটা অ্যানালিসিস টুলপ্যাক সক্রিয় করতে পারবেন।
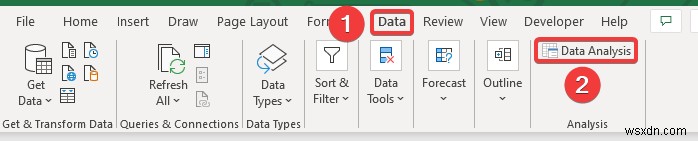
- এখন, Data ট্যাবের Analyze মেনুতে যান। এখানে আপনি Data Analysis অপশনটি পাবেন।
ডেটা অ্যানালিসিস টুলপ্যাকের ১৩টি অসাধারণ ফিচার যা আপনি এক্সেলে ব্যবহার করতে পারেন
আমরা এক্সেলে ডেটা অ্যানালিসিস টুলপ্যাক ব্যবহারের ১৩টি কার্যকর এবং ট্রিকি উপায় ব্যবহার করব। এখানে, আমরা এক্সেল ডেটা অ্যানালিসিস টুলপ্যাকের ১৩টি ফিচার প্রদর্শন করব। এই বিভাগটি ১৩টি পদ্ধতির বিস্তারিত বিবরণ দেয়। আপনি আপনার উদ্দেশ্যের জন্য যেকোনো একটি ব্যবহার করতে পারেন, কাস্টমাইজেশনের ক্ষেত্রে এগুলো ব্যাপক লচীলapan প্রদান করে। আপনাকে এই সব শিখে এবং প্রয়োগ করা উচিত, কারণ এগুলো আপনার চিন্তা ক্ষমতা এবং এক্সেল জ্ঞান বাড়ায়। আমরা এখানে Microsoft Office 365 ভার্সন ব্যবহার করেছি, কিন্তু আপনি আপনার পছন্দ অনুযায়ী অন্য কোনো ভার্সনও ব্যবহার করতে পারেন।
১. Anova অ্যানালিসিস
Anova একটি প্রদত্ত ডেটা সেটে কোন ফ্যাক্টরগুলো উল্লেখযোগ্য প্রভাব ফেলে তা নির্ধারণ করার প্রথম সুযোগ দেয়। অ্যানালিসিস সম্পন্ন হওয়ার পর, একজন অ্যানালিস্ট পদ্ধতিগত ফ্যাক্টর গুলোর উপর অতিরিক্ত অ্যানালিসিস করে যেগুলো ডেটা সেটের অসঙ্গতিপূর্ণ প্রকৃতিতে উল্লেখযোগ্য প্রভাব ফেলে। এবং সে Anova অ্যানালিসিসের ফলাফলগুলো f-test-এ ব্যবহার করে রিগ্রেশন অ্যানালিসিস-এর জন্য প্রাসঙ্গিক অতিরিক্ত ডেটা তৈরি করতে। ANOVA অ্যানালিসিস একসাথে অনেক ডেটা সেট তুলনা করে দেখে কোনো লিংক আছে কিনা। ANOVA হলো একটি পরিসংখ্যানিক পদ্ধতি যা একটি ডেটাসেটে পর্যবক্ষিত ভেরিয়েন্স বিশ্লেষণ করে সেটিকে দুটি বিভাগে ভাগ করে: ১) সিস্টেম্যাটিক ফ্যাক্টর এবং ২) র্যান্ডম ফ্যাক্টর।
Anova-এর ফর্মুলা:
F=MSE / MST
এখানে:
F = Anova কোইফিশিয়েন্ট
MST = চিকিৎসার কারণে মিন স্কোয়ারের যোগফল
MSE = ত্রুটির কারণে মিন স্কোয়ারের যোগফল
Anova দুটি প্রকারের: সিঙ্গেল ফ্যাক্টর এবং টু ফ্যাক্টর। পদ্ধতিটি ভেরিয়েন্স অ্যানালিসিস-এর সাথে সম্পর্কিত।
- টু ফ্যাক্টরে, একাধিক ডিপেন্ডেন্ট ভেরিয়েবল থাকে এবংワン ফ্যাক্টরে থাকবে একটի ডিপেন্ডেন্ট ভেরিয়েবল।
- সিঙ্গেল-ফ্যাক্টর Anova একটি একক ফ্যাক্টরের প্রভাব একটি একক ভেরিয়েবলে গণনা করে। এবং এটি চেক করে সব স্যাম্পল ডেটা সেটগুলো একই কিনা।
- সিঙ্গেল-ফ্যাক্টর Anova অনেক ভেরিয়েবলের গড় মিনের মধ্যে সাংখ্যিকভাবে উল্লেখযোগ্য পার্থক্য চিহ্নিত করে।
১.১ সিঙ্গেল ফ্যাক্টর Anova অ্যানালিসিস
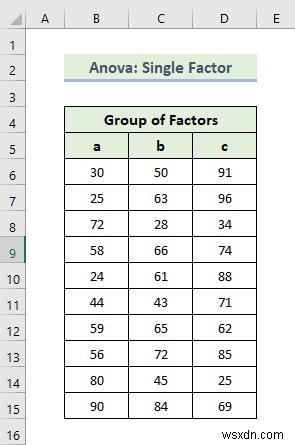
এখানে, আমরা সিঙ্গেল ফ্যাক্টর Anova অ্যানালিসিস করার পদ্ধতি দেখাব। প্রথমে আমাদের এক্সেল ডেটাসেটের সাথে আপনাকে পরিচয় করাই যাতে আপনি বুঝতে পারেন আমরা এই আর্টিকেলে কী পেতে চাই। আমাদের কাছে ফ্যাক্টর গোষ্ঠী দেখানো একটি ডেটাসেট আছে। চলে সিঙ্গেল ফ্যাক্টর Anova অ্যানালিসিস করার ধাপগুলো দেখি।
📌 ধাপসমূহ:
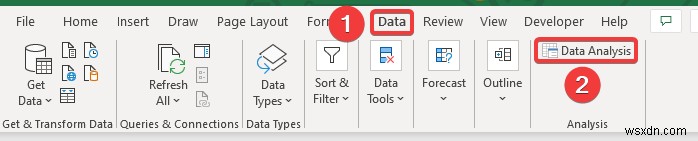
- প্রথমে, টপ রিবনে Data ট্যাবে যান।
- তারপর, Data Analysis টুলটি সিলেক্ট করুন।
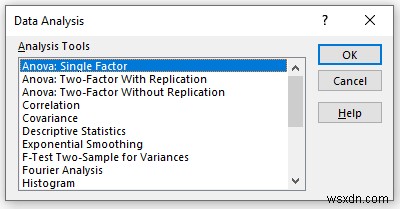
- Data Analysis উইন্ডো আসলে, Anova: Single Factor অপশনটি সিলেক্ট করুন।
- তারপর, OK-এ ক্লিক করুন।
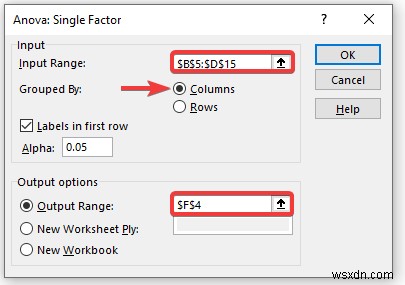
- এখন, Anova: Single Factor উইন্ডো খুলবে।
- Input Range বক্সে ডেটা দিন, যা আপনি Anova অ্যানালিসিস দ্বারা নির্ধারণ করতে চান কলাম বা সারি ড্র্যাগ করে।
- Labels in First Row নামক বক্সটি চেক করুন।
- Output Range বক্সে, আপনি আপনার ক্যালকুলেটেড ডেটা সংরক্ষণ করতে চান সেই ডেটা রেঞ্জ দিন কলাম বা সারি ড্র্যাগ করে। অথবা আপনি আউটপুট নতুন ওয়ার্কশিটে দেখাতে চাইলে New Worksheet Ply সিলেক্ট করুন এবং আপনি নতুন ওয়ার্কবুকে আউটপুট দেখতে চাইলে New Workbook সিলেক্ট করুন।
- এরপর, আপনাকে Labels in the first row চেক করতে হবে আপনি যদি লেবেলসহ ইনপুট ডেটা রেঞ্জ সিলেক্ট করেন।
- তারপর, OK-এ ক্লিক করুন।
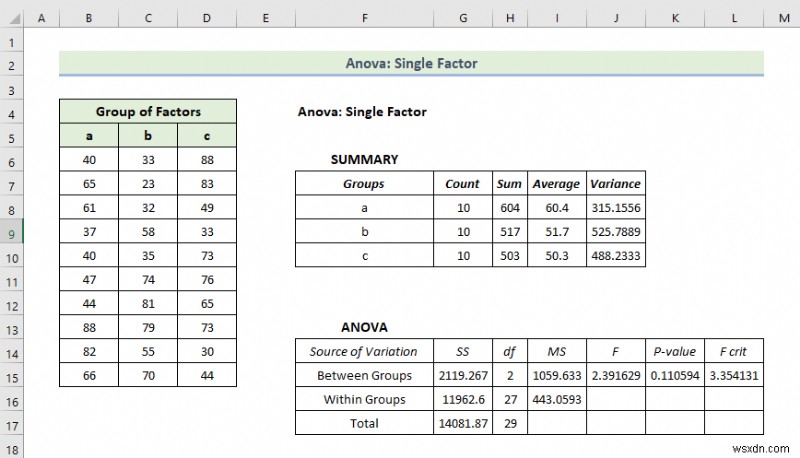
- ফলস্বরূপ, Anova ফলাফল নিচের মতো দেখাবে।
ফলাফলের ব্যাখ্যা:
- Summary টেবিলে, আপনি প্রতিটি গ্রুপের গড় এবং ভেরিয়েন্স পাবেন। এখানে আপনি দেখতে পাচ্ছেন গড় লেভেল ৬০.৪ Group a-র জন্য কিন্তু ভেরিয়েন্স ৩১৫.১৫ যা অন্য গ্রুপের চেয়ে খুব কম। অর্থাৎ, গ্রুপের সদস্যরা কম মূল্যবান।
- এখানে, Anova ফলাফলগুলো ততো উল্লেখযোগ্য নয় কারণ আপনি শুধু ভেরিয়েন্স ক্যালকুলেট করছেন।
- এখানে, P-মানগুলো কলামগুলোর সাথে সম্পর্ক ব্যাখ্যা করে এবং মানগুলো ০.০৫ থেকে বড় তাই এটি সাংখ্যিকভাবে উল্লেখযোগ্য নয়। এবং কলামগুলোর মধ্যে সম্পর্কও থাকা উচিত নয়।
১.২ Anova: Two Factor with Replication
এখানে, আমরা টু-ফ্যাক্টর উইথ রেপ্লিকেশন Anova অ্যানালিসিস প্রদর্শন করব। ধরা যাক আপনার কাছে একটি স্কুলের বিভিন্ন পরীক্ষার স্কোর সম্পর্কে ডেটা আছে। সেখানে দুটি শিফ্ট আছে। একটি হলো মর্নিং শিফ্ট অন্যটি হলো ডে শিফ্ট। আপনি রেডি ডেটার ডেটা অ্যানালিসিস করতে চান দুটি শিফ্টের ছাত্রদের নম্বরের মধ্যে সম্পর্ক খুঁজে বের করতে। চলে টু-ফ্যাক্টর Anova উইথ রেপ্লিকেশন অ্যানালিসিস করার ধাপগুলো দেখি।
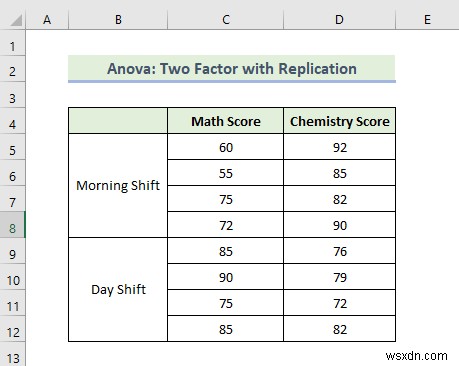
📌 ধাপসমূহ:
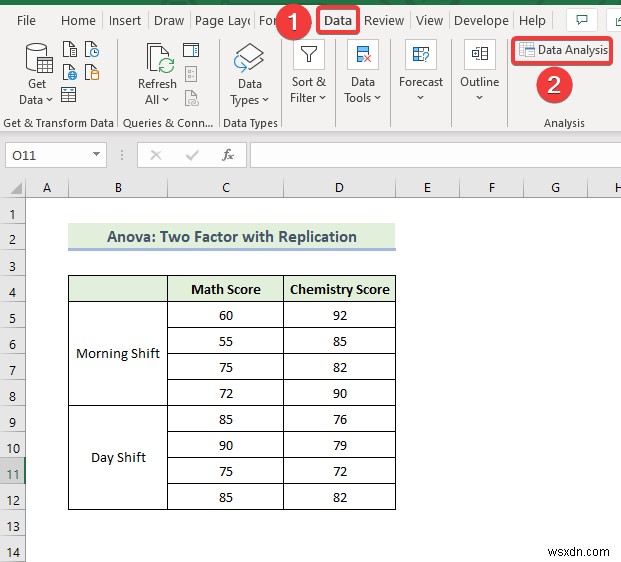
- প্রথমে, টপ রিবনে Data ট্যাবে যান।
- তারপর, Data Analysis টুলটি সিলেক্ট করুন।
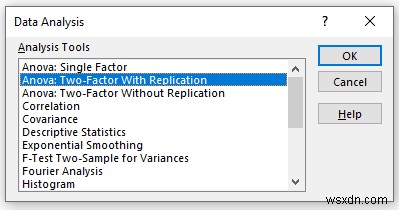
- Data Analysis উইন্ডো আসলে, Anova: Two-Factor With Replication অপশনটি সিলেক্ট করুন।
- তারপর, OK-এ ক্লিক করুন।
- এখন, একটি নতুন উইন্ডো আসবে।
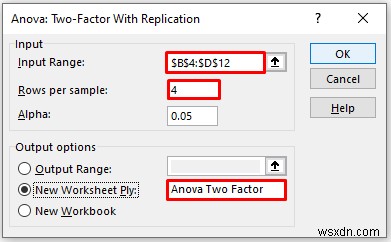
- Input Range বক্সে ডেটা দিন, যা আপনি Anova অ্যানালিসিস দ্বারা নির্ধারণ করতে চান কলাম বা সারি ড্র্যাগ করে।
- এরপর, Rows per sample বক্সে ৪ ইনপুট করুন কারণ আপনার প্রতি শিফ্টে ৪ টি সারি আছে।
- Output Range বক্সে, আপনি আপনার ক্যালকুলেটেড ডেটা সংরক্ষণ করতে চান সেই ডেটা রেঞ্জ দিন কলাম বা সারি ড্র্যাগ করে। অথবা আপনি আউটপুট নতুন ওয়ার্কশিটে দেখাতে চাইলে New Worksheet Ply সিলেক্ট করুন এবং আপনি নতুন ওয়ার্কবুকে আউটপুট দেখতে চাইলে New Workbook সিলেক্ট করুন।
- তারপর, OK-এ ক্লিক করুন।
- ফলস্বরূপ, আপনি একটি নতুন ওয়ার্কশিট তৈরি হওয়া দেখবেন।
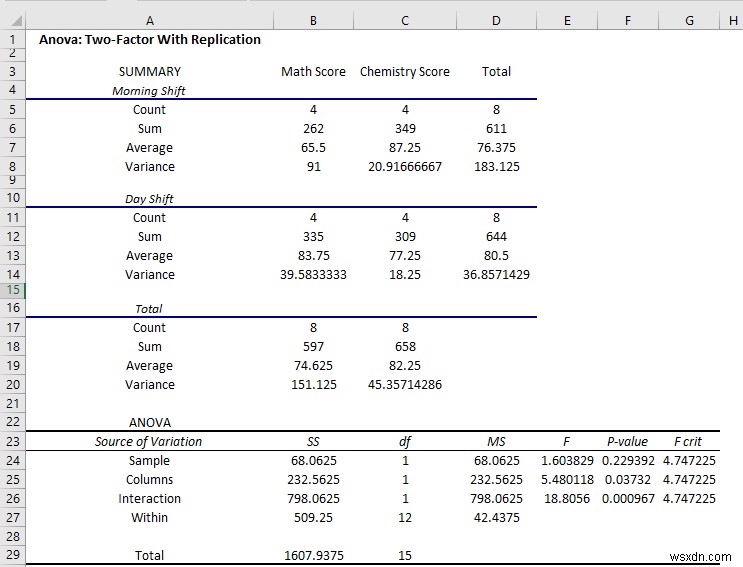
- এবং, two-way Anova ফলাফল এই ওয়ার্কশিটে দেখানো হয়েছে।
ফলাফলের ব্যাখ্যা:
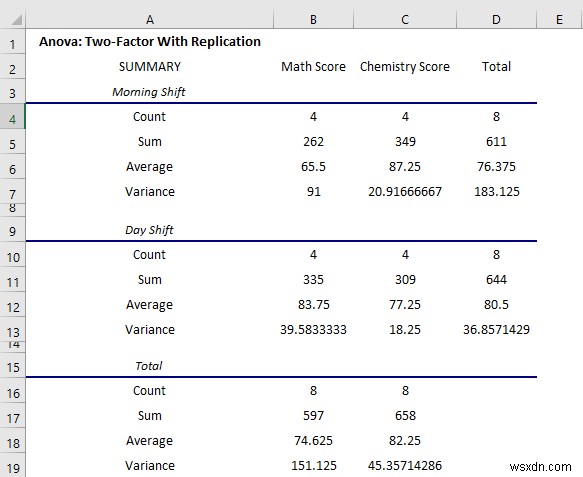
এখানে, প্রথম টেবিলগুলো শিফ্টের সামারি দেখাচ্ছে। সংক্ষেপে:
- Morning শিফ্টে ম্যাথ স্কোরে গড় ৬৫.৫ কিন্তু Day শিফ্টে ৮৩.৭৫
- কিন্তু কেমিস্ট্রি পরীক্ষায়, Morning শিফ্টে গড় স্কোর ৮৭.২৫, কিন্তু Day শিফ্টে ৭৭.২৫।
- ভেরিয়েন্স খুব বেশি ৯১ morning শিফ্টে ম্যাথ পরীক্ষায়।
- সামারি থেকে আপনি ডেটার সম্পূর্ণ ওভারভিউ পাবেন।
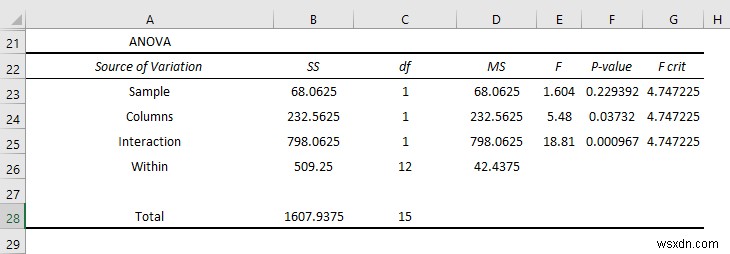
একইভাবে, আপনি ইন্টারঅ্যাকশন এবং স্বতন্ত্র প্রভাবগুলো Anova অংশে সারসংক্ষেপ করতে পারেন। সংক্ষেপে:
- Columns-এর P-value ০.০৩৭ যা সাংখ্যিকভাবে উল্লেখযোগ্য তাই আপনি বলতে পারেন যে শিফ্টের প্রভাব আছে ছাত্রদের পরীক্ষার পারফরম্যান্সে। কিন্তু মানটি ০.০৫ আলফা মানের কাছে থাকায় প্রভাবটি কম উল্লেখযোগ্য।
- কিন্তু ইন্টারঅ্যাকশন-এর P-value ০.০০০৯৬৭ যা আলফা মান থেকে অনেক কম তাই এটি খুব বেশি সাংখ্যিকভাবে উল্লেখযোগ্য এবং আপনি বলতে পারেন যে দুটি পরীক্ষায় শিফ্টের প্রভাব খুব বেশি।
১.৩ Anova: Two Factor without Replication
এখন, আমরা টু ফ্যাক্টর উইথআউট রেপ্লিকেশন Anova অ্যানালিসিসের পদ্ধতি অনুসরণ করে ভেরিয়েন্স অ্যানালিসিস করব। আমরা ধরা যাক আপনার কাছে একটি স্কুলের বিভিন্ন পরীক্ষার স্কোর সম্পর্কে ডেটা আছে। সেখানে দুটি শিফ্ট আছে। একটি হলো মর্নিং শিফ্ট অন্যটি হলো ডে শিফ্ট। আপনি রেডি ডেটার ডেটা অ্যানালিসিস করতে চান দুটি শিফ্টের ছাত্রদের নম্বরের মধ্যে সম্পর্ক খুঁজে বের করতে। চলে টু ফ্যাক্টর ANOVA উইথআউট রেপ্লিকেশন অ্যানালিসিস করার ধাপগুলো দেখি।
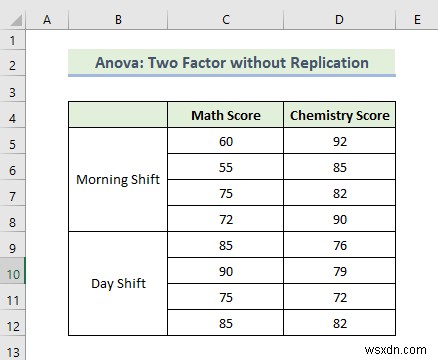
📌 ধাপসমূহ:
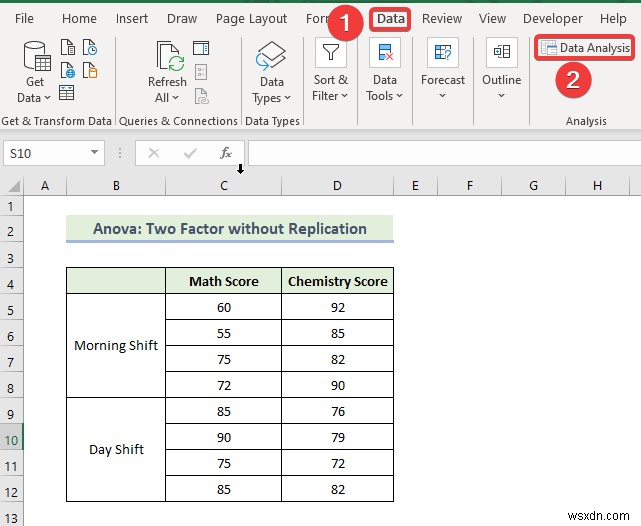
- প্রথমে, টপ রিবনে Data ট্যাবে যান।
- তারপর, Data Analysis টুলটি সিলেক্ট করুন।
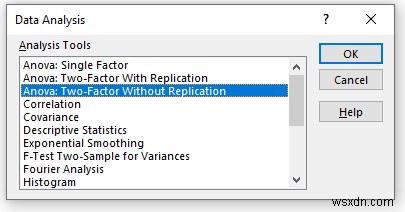
- Data Analysis উইন্ডো আসলে, "Anova: Two-Factor Without Replication" অপশনটি সিলেক্ট করুন।
- তারপর, OK-এ ক্লিক করুন।
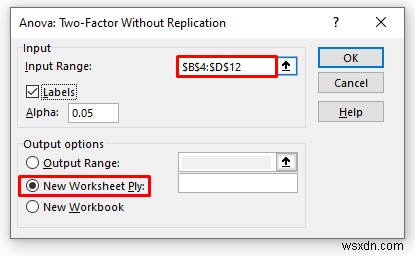
- এখন, একটি নতুন উইন্ডো আসবে।
- Input Range বক্সে ডেটা দিন, যা আপনি Anova অ্যানালিসিস দ্বারা নির্ধারণ করতে চান কলাম বা সারি ড্র্যাগ করে।
- Output Range বক্সে, আপনি আপনার ক্যালকুলেটেড ডেটা সংরক্ষণ করতে চান সেই ডেটা রেঞ্জ দিন কলাম বা সারি ড্র্যাগ করে। অথবা আপনি আউটপুট নতুন ওয়ার্কশিটে দেখাতে চাইলে New Worksheet Ply সিলেক্ট করুন এবং আপনি নতুন ওয়ার্কবুকে আউটপুট দেখতে চাইলে New Workbook সিলেক্ট করুন।
- এরপর, আপনাকে Labels চেক করতে হবে যদি ইনপুট ডেটা রেঞ্জ লেবেলসহ থাকে।
- তারপর, OK-এ ক্লিক করুন।
- ফলস্বরূপ, আপনি একটি নতুন ওয়ার্কশিট তৈরি হওয়া দেখবেন।
- ফলস্বরূপ, আপনি নিচের মতো টু-ওয়ে Anova ফলাফল পাবেন।
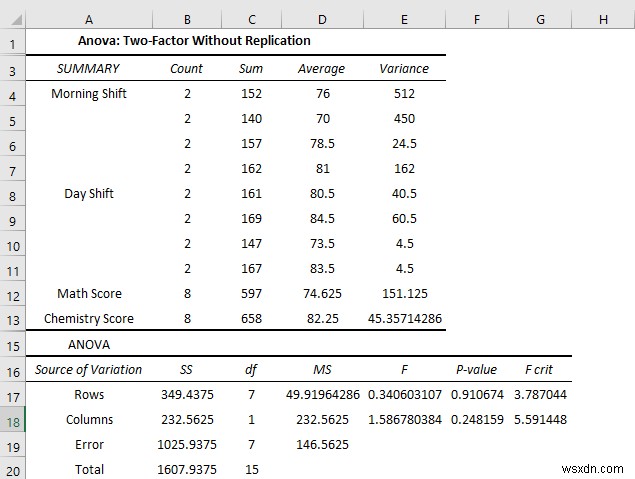
ফলাফলের ব্যাখ্যা:
- Morning শিফ্টে ম্যাথ স্কোরে গড় ৬৫.৫ কিন্তু Day শিফ্টে ৮৩.৭৫
- কিন্তু কেমিস্ট্রি পরীক্ষায়, Morning শিফ্টে গড় স্কোর ৮৭ কিন্তু Day শিফ্টে ৭৭.২৫।
- Columns-এর P-value ০.২৪ যা সাংখ্যিকভাবে উল্লেখযোগ্য তাই আপনি বলতে পারেন যে শিফ্টের প্রভাব আছে ছাত্রদের পরীক্ষার পারফরম্যান্সে। কিন্তু মানটি ০.০৫ আলফা মানের কাছে থাকায় প্রভাবটি কম উল্লেখযোগ্য।
আরও পড়ুন: এক্সেলে ডেটা অ্যানালিসিস যোগ করা (২ দ্রুত ধাপ সহ)
২. করিলেশন অ্যানালিসিস
এখন, আমরা করিলেশন ডেটা অ্যানালিসিস করব যা এক্সেল ডেটা অ্যানালিসিস টুলপ্যাকের একটি চমৎকার ফিচার। পরিসংখ্যানে, করিলেশন বা করিলেশন কোইফিশিয়েন্ট হলো একটি প্যারামিটার যা দুটি ভেরিয়েবলের মধ্যে সামঞ্জস্য দেখায় অন্যটির সতত পরিবর্তনশীল পরিমাণের প্রতিক্রিয়াস্বরূপ। এর মান -১ থেকে +১ পর্যন্ত। তাই এর তিনটি অবস্থা রয়েছে ভেরিয়েবল সম্পর্ক সংজ্ঞায়িত করার জন্য। সেগুলো হলো:
- -১ নির্দেশ করে নেগেটিভ করিলেশন অর্থাৎ ভেরিয়েবলগুলো বিপরীত দিকে পরিবর্তন হয়।
- +১ নির্দেশ করে পজিটিভ করিলেশন অর্থাৎ ভেরিয়েবলগুলো একই দিকে পরিবর্তন হয়।
- ০ নির্দেশ করে কোনো করিলেশন নেই অর্থাৎ অন্য ভেরিয়েবল পরিবর্তন করলে কোনো দিক নির্দেশ করছে না।
এখানে, আমাদের কাছে একটি ডেটাসেট আছে যাতে দুটি স্টক প্রাইস আছে বিভিন্ন সময়ে। চলে করিলেশন ডেটা অ্যানালিসিস করার ধাপগুলো দেখি।
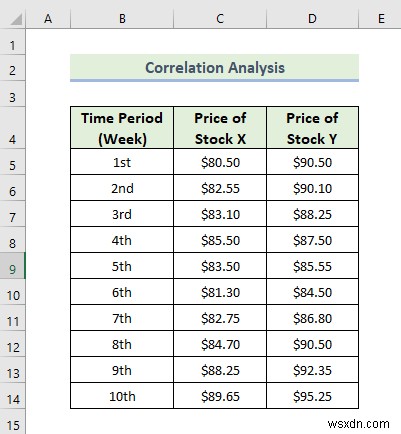
📌 ধাপসমূহ:
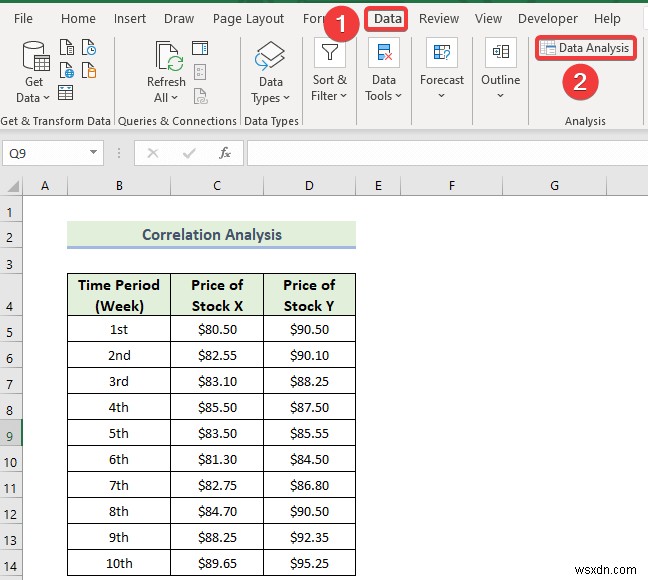
- প্রথমে, টপ রিবনে Data ট্যাবে যান।
- তারপর, Data Analysis টুলটি সিলেক্ট করুন।
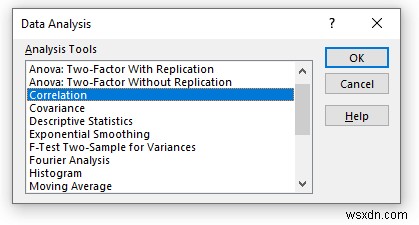
- Data Analysis উইন্ডো আসলে, Correlation অপশনটি সিলেক্ট করুন।
- এরপর, OK-এ ক্লিক করুন।
- এখন, একটি নতুন উইন্ডো আসবে।
- Input Range বক্সে ডেটা দিন, যা আপনি করিলেশন ক্যালকুলেট করতে চান কলাম বা সারি ড্র্যাগ করে।
- এখন, আপনাকে Columns অপশনটি চেক করতে হবে Grouped By অপশনে।
- Output Range বক্সে, আপনি আপনার ক্যালকুলেটেড ডেটা সংরক্ষণ করতে চান সেই ডেটা রেঞ্জ দিন কলাম বা সারি ড্র্যাগ করে। অথবা আপনি আউটপুট নতুন ওয়ার্কশিটে দেখাতে চাইলে New Worksheet Ply সিলেক্ট করুন এবং আপনি নতুন ওয়ার্কবুকে আউটপুট দেখতে চাইলে New Workbook সিলেক্ট করুন।
- এরপর, আপনাকে Labels in the first row চেক করতে হবে যদি ইনপুট ডেটা রেঞ্জ লেবেলসহ থাকে।
- তারপর, OK-এ ক্লিক করুন।
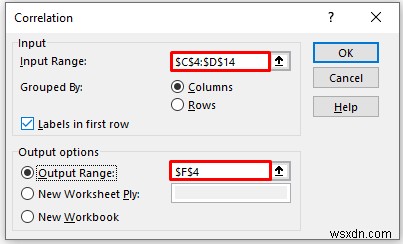
- ফলস্বরূপ, আপনি নিচের করিলেশন ফলাফল পাবেন।
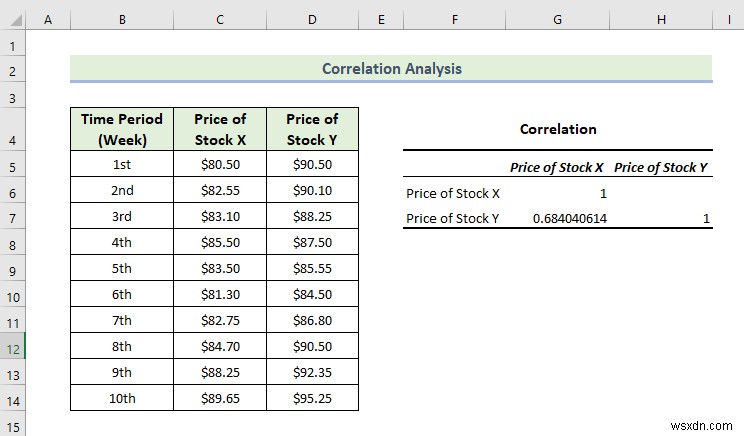
উপরোক্ত ক্যালকুলেশন থেকে, আমরা একটি পজিটিভ করিলেশন দেখতে পাচ্ছি অর্থাৎ ভেরিয়েবলগুলো একই দিকে পরিবর্তন হচ্ছে।
আরও পড়ুন: এক্সেলে টাইম সিরিজ ডেটা বিশ্লেষণ (সহজ ধাপ সহ)
৩. কোভেরিয়েন্স অ্যানালিসিস
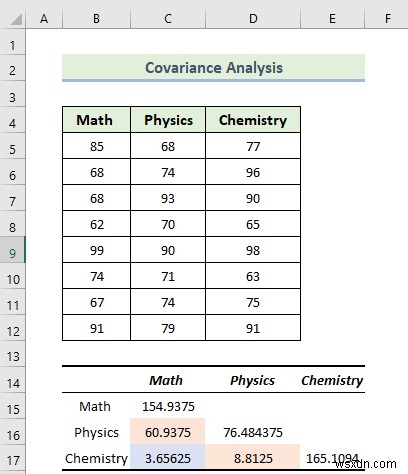
এখন, আমরা কোভেরিয়েন্স ডেটা অ্যানালিসিস করব যা এক্সেল ডেটা অ্যানালিসিস টুলপ্যাকের একটি চমৎকার ফিচার। দুটি ভেরিয়েবলের কোভেরিয়েন্স হলো একটি মাপ যে उनमें से একটি অন্যটিকে কতটুকু প্রভাবিত করে। স্পষ্টভাবে, এটি দুটি ভেরিয়েবলের মধ্যে বিচ্যুতির একটি প্রয়োজনীয় মূল্যায়ন। এর अलावा, ভেরিয়েবলগুলো একে অপরের ওপর নির্ভরশীল হতে হয় না। চলে কোভেরিয়েন্স ডেটা অ্যানালিসিস করার ধাপগুলো দেখি।
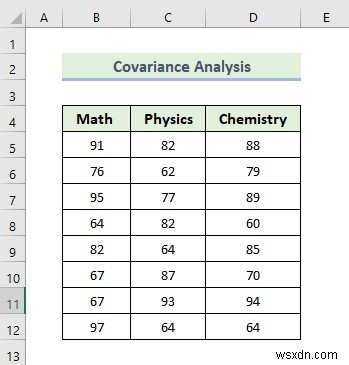
📌 ধাপসমূহ:
- প্রথমে, টপ রিবনে Data ট্যাবে যান।
- তারপর, Data Analysis টুলটি সিলেক্ট করুন।
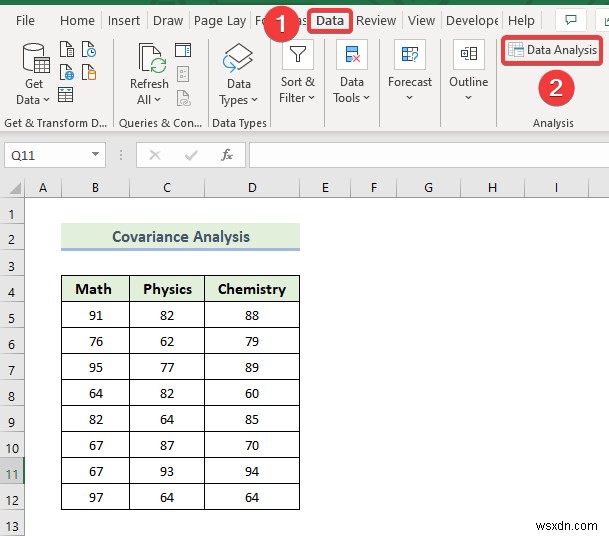
- Data Analysis উইন্ডো আসলে, Covariance অপশনটি সিলেক্ট করুন।
- তারপর, Enter চাপুন।
- তারপর, OK-এ ক্লিক করুন।
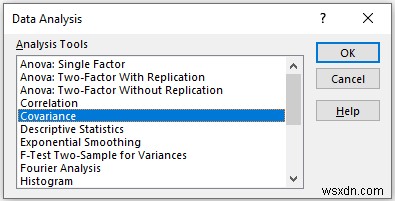
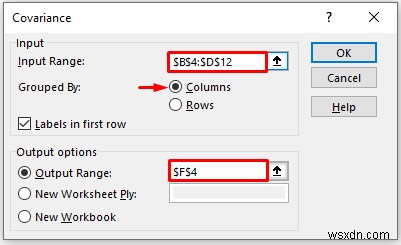
- এখন, একটি নতুন উইন্ডো আসবে।
- Input Range বক্সে ডেটা দিন, যা আপনি কোভেরিয়েন্স ক্যালকুলেট করতে চান কলাম বা সারি ড্র্যাগ করে।
- এখন, Grouped By সেকশনে Columns অপশনটি চেক করুন।
- Output Range বক্সে, আপনি আপনার ক্যালকুলেটেড ডেটা সংরক্ষণ করতে চান সেই ডেটা রেঞ্জ দিন কলাম বা সারি ড্র্যাগ করে। অথবা আপনি আউটপুট নতুন ওয়ার্কশিটে দেখাতে চাইলে New Worksheet Ply সিলেক্ট করুন এবং আপনি নতুন ওয়ার্কবুকে আউটপুট দেখতে চাইলে New Workbook সিলেক্ট করুন।
- এরপর, আপনাকে Labels in the first row চেক করতে হবে যদি ইনপুট ডেটা রেঞ্জ লেবেলসহ থাকে।
- তারপর, OK-এ ক্লিক করুন।
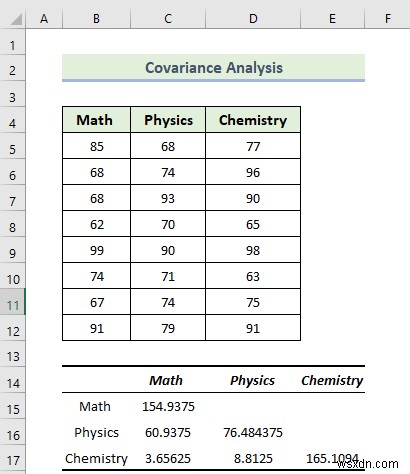
- ফলস্বরূপ, আপনি নিচের কোভেরিয়েন্স ফলাফল পাবেন।
ফলাফলের ব্যাখ্যা:
করিলেশন ম্যাট্রিক্স আমাদের একাধিক ভেরিয়েবল এবং একক ভেরিয়েবলের মধ্যে সম্পর্ক মূল্যায়ন করতে দেয়। নিচের ছবির হাইলাইটেড সেকশন প্রতিটি বিষয়ের ভেরিয়েন্স নির্দেশ করে।
- ম্যাথের ভেরিয়েন্স ১৫৪.৯৩৭৫ এবং ফিজিক্সের ভেরিয়েন্স ৭৬.৪৮৪৩৭৫। পরের, কেমিস্ট্রির ভেরিয়েন্স ১৫৪.৯৩৭৫।
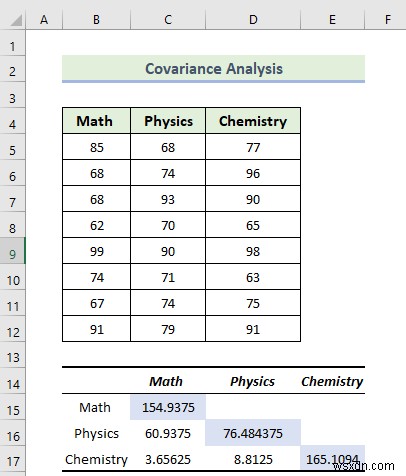
নিচের ছবির হাইলাইটেড সেকশন দুটি বিষয়ের মধ্যে ভেরিয়েন্সের মান নির্দেশ করে। ম্যাথ এবং ফিজিক্স, ম্যাথস এবং কেমিস্ট্রি, এবং ফিজিক্স এবং হিস্টরির ভেরিয়েন্স মান যথাক্রমে ৬০.৯৩৭৫, ৩.৬৫৬২৫, এবং ৮.৮১২৫। কোভেরিয়েন্স যখন পজিটিভ হয় এই কেসে, এটি নির্দেশ করে যে ভেরিয়েবলগুলো অনুপাতিক, অর্থাৎ যখন একটি বাড়ে, অন্যটি ও তার সাথে বাড়তে প্রবণ।
আরও পড়ুন: [সেট:] ডেটা অ্যানালিসিস এক্সেলে দেখাচ্ছে না (২ কার্যকর সমাধান)
৪. ডেসক্রিপ্টিভ স্ট্যাটিস্টিক্স অ্যানালিসিস
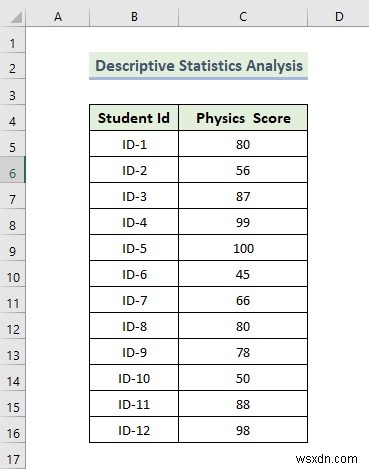
এখন, আমরা দেখাব কিভাবে ডেসক্রিপ্টিভ স্ট্যাটিস্টিক্স অ্যানালিসিস করা হয়। এক্সেল ডেটা অ্যানালিসিস টুলপ্যাক আমাদের একটি ডেটাসেট বিশ্লেষণ করে এর বৈশিষ্ট্য নির্ধারণ করার জন্য ডেসক্রিপ্টিভ স্ট্যাটিস্টিক্স অ্যানালিসিস করতে দেয়। এখানে, আমাদের কাছে একটি ডেটাসেট আছে যাতে প্রতিটি ছাত্রের ফিজিক্স স্কোর আছে। চলে করিলেশন ডেটা অ্যানালিসিস করার ধাপগুলো দেখি।
📌 ধাপসমূহ:
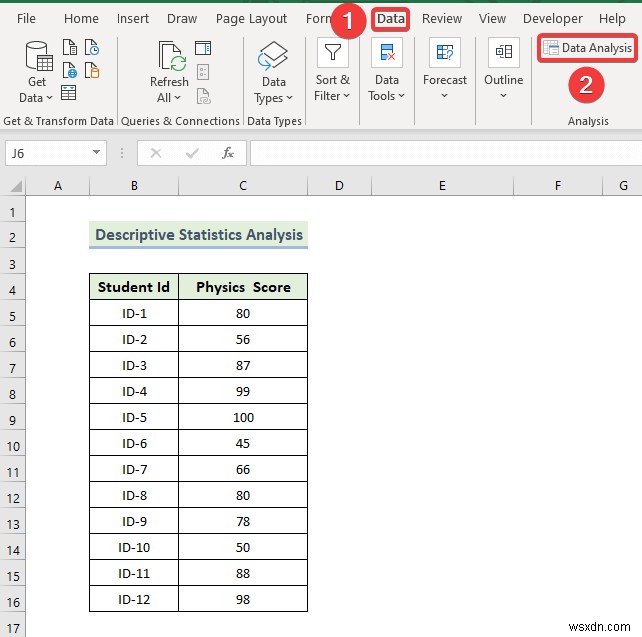
- প্রথমে, টপ রিবনে Data ট্যাবে যান।
- তারপর, Data Analysis টুলটি সিলেক্ট করুন।
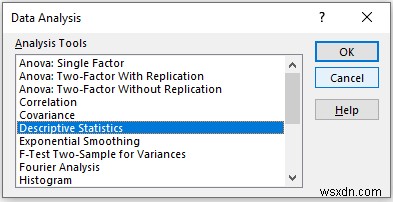
- Data Analysis উইন্ডো আসলে, Descriptive Statistics অপশনটি সিলেক্ট করুন।
- তারপর, OK-এ ক্লিক করুন।
- এখন, একটি নতুন উইন্ডো আসবে।
- Input Range বক্সে ডেটা দিন, যা আপনি ডেসক্রিপ্টিভ স্ট্যাটিস্টিক্স ক্যালকুলেট করতে চান কলাম বা সারি ড্র্যাগ করে।
- এখন, Grouped By সেকশনে Columns অপশনটি চেক করুন।
- Output Range বক্সে, আপনি আপনার ক্যালকুলেটেড ডেটা সংরক্ষণ করতে চান সেই ডেটা রেঞ্জ দিন কলাম বা সারি ড্র্যাগ করে। অথবা আপনি আউটপুট নতুন ওয়ার্কশিটে দেখাতে চাইলে New Worksheet Ply সিলেক্ট করুন এবং আপনি নতুন ওয়ার্কবুকে আউটপুট দেখতে চাইলে New Workbook সিলেক্ট করুন।
- তারপর, Summary statistics চেক করুন।
- তারপর, OK-এ ক্লিক করুন।
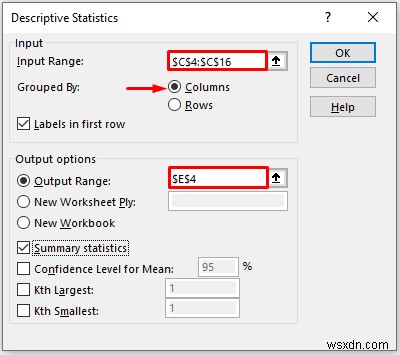
- ফলস্বরূপ, আপনি নিচের কোভেরিয়েন্স ফলাফল পাবেন।
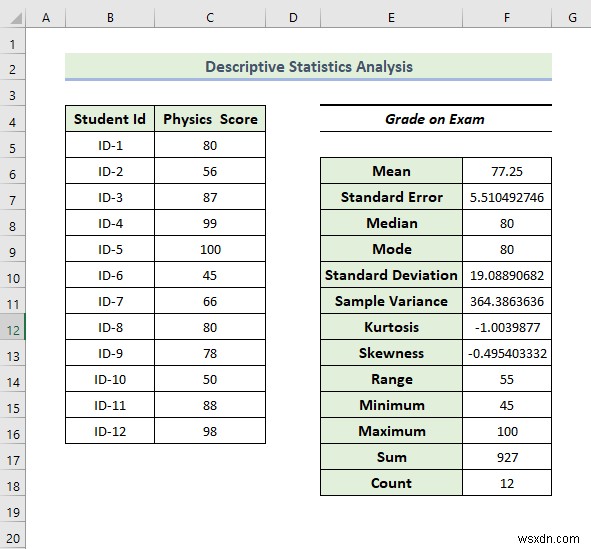
- উপরোক্ত ফলাফল আমাদের দুটি ভেরিয়েবলের বৈশিষ্ট্য দেয়, অর্থাৎ গড়, মিডিয়ান, স্ট্যান্ডার্ড ডেভিয়েশন, এবং ডেটাসেটের সর্বোচ্চ ও সর্বনিম্ন মান, যা যথাক্রমে ৭৭.২৫, ৮০, ১৯.০৮৮, ৪৫, এবং ১০০।
আরও পড়ুন: এক্সেলে অ্যানালাইজ ডেটা ব্যবহার করা (৫ সহজ পদ্ধতি)
৫. এক্সপোনেনশিয়াল SMOOTHING অ্যানালিসিস
এখন, আমরা দেখাব কিভাবে এক্সপোনেনশিয়াল SMOOTHING অ্যানালিসিস করা হয়। এক্সেল ডেটা অ্যানালিসিস টুলপ্যাক আমাদের ব্যবসায়িক পরিমাণ সম্পর্কে উপযুক্ত সিদ্ধান্ত নেওয়ার জন্য এক্সপোনেনশিয়াল SMOOTHING করতে দেয়। এখানে, আমাদের কাছে একটি ডেটাসেট আছে যাতে একটি ম্যানুফ্যাকচারিং কোম্পানির বিভিন্ন সপ্তাহে বিক্রি হওয়া আইটেমের সংখ্যা আছে। চলে এক্সপোনেনশিয়াল SMOOTHING ডেটা অ্যানালিসিস করার ধাপগুলো দেখি।
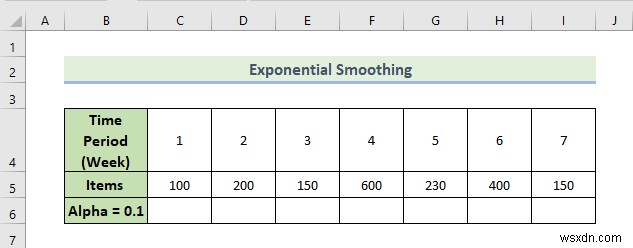
📌 ধাপসমূহ:
- প্রথমে, টপ রিবনে Data ট্যাবে যান।
- তারপর, Data Analysis টুলটি সিলেক্ট করুন।
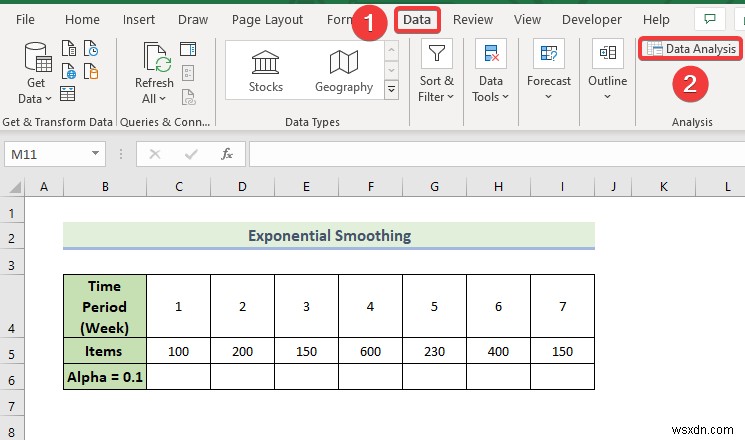
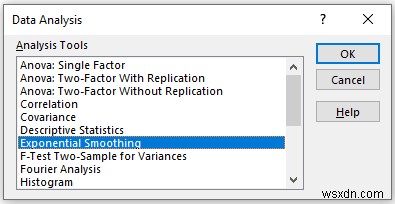
- Data Analysis উইন্ডো আসলে, Exponential Smoothing অপশনটি . সিলেক্ট করুন।
- তারপর, OK-এ ক্লিক করুন।
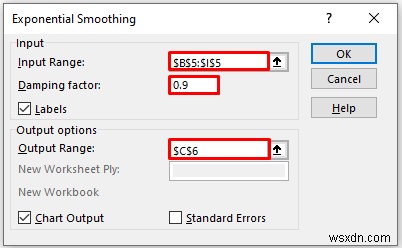
- এখন, একটি নতুন উইন্ডো আসবে।
- Input Range বক্সে ডেটা দিন, যা আপনি এক্সপোনেনশিয়াল SMOOTHING ক্যালকুলেট করতে চান কলাম বা সারি ড্র্যাগ করে।
- এখন, Damping factor বক্সে ০.৯ ইনপুট করুন। এখানে, আমরা ড্যাম্পিং 1-alpha করছি।
- Output Range বক্সে, আপনি আপনার ক্যালকুলেটেড ডেটা সংরক্ষণ করতে চান সেই ডেটা রেঞ্জ দিন কলাম বা সারি ড্র্যাগ করে। অথবা আপনি আউটপুট নতুন ওয়ার্কশিটে দেখাতে চাইলে New Worksheet Ply সিলেক্ট করুন এবং আপনি নতুন ওয়ার্কবুকে আউটপুট দেখতে চাইলে New Workbook সিলেক্ট করুন।
- এরপর, আপনাকে Labels চেক করতে হবে যদি ইনপুট ডেটা রেঞ্জ লেবেলসহ থাকে।
- তারপর, Chart Output চেক করুন।
- তারপর, OK-এ ক্লিক করুন।
- ফলস্বরূপ, আপনি ০.১ আলফার জন্য এক্সপোনেনশিয়াল SMOOTHING ফলাফল এবং চার্ট পাবেন।
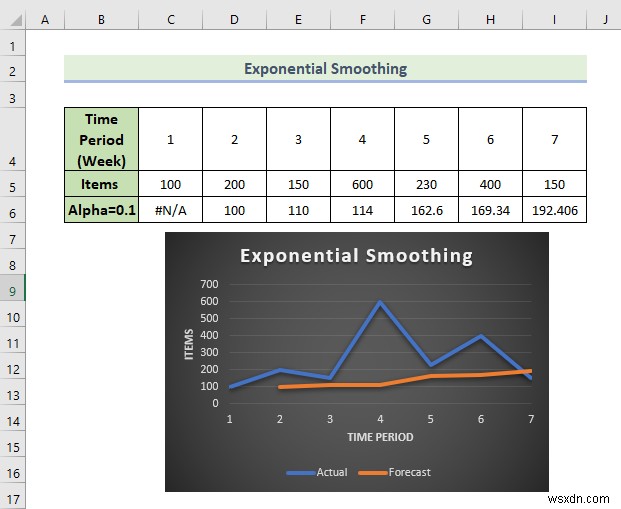
এখানে, উপরের ফলাফল থেকে, আমরা বলতে পারি যে এক্সেল এই মেথডে প্রথম মান জন্য ডেটা দিতে পারে না। আপনি যদি বড় ড্যাম্পিং ফ্যাক্টর ব্যবহার করেন, তবে আপনি আরও স্মুথ পিক এবং ভ্যালি পাবেন।
৬. F-Test Two-Sample for Variances অ্যানালিসিস
এখন, আমরা টু স্যাম্পল ভেরিয়েন্সের জন্য F-test করব। দুটি ভেরিয়েবলের ভেরিয়েন্স ব্যবহার করে, F-test এক্সেলে পরিসংখ্যানিক অ্যানালিসিস প্রদান করে। এখানে, আমাদের কাছে একটি ডেটাসেট আছে যাতে একটি ম্যানুফ্যাকচারিং কোম্পানির বিভিন্ন সপ্তাহে দুটি আইটেমের সেলস প্রাইস আছে। চলে টু স্যাম্পল ভেরিয়েন্সের জন্য f-test করার ধাপগুলো দেখি।
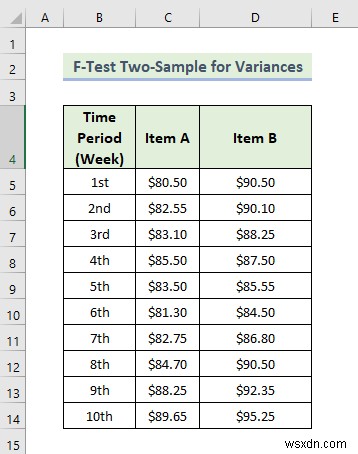
📌 ধাপসমূহ:
- প্রথমে, টপ রিবনে Data ট্যাবে যান।
- তারপর, Data Analysis টুলটি সিলেক্ট করুন।
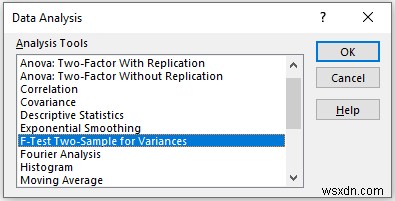
- Data Analysis উইন্ডো আসলে, F-Test Two-Sample for Variances অপশনটি সিলেক্ট করুন।
- তারপর, OK-এ ক্লিক করুন।
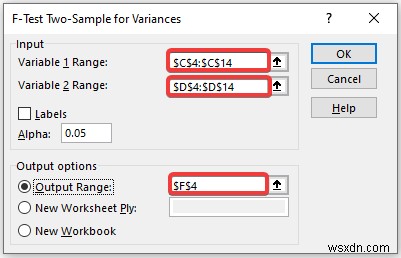
- এখন, একটি নতুন উইন্ডো আসবে।
- Input Range বক্সে ডেটা দিন, যা আপনি F-test ক্যালকুলেট করতে চান কলাম বা সারি ড্র্যাগ করে।
- Output Range বক্সে, আপনি আপনার ক্যালকুলেটেড ডেটা সংরক্ষণ করতে চান সেই ডেটা রেঞ্জ দিন কলাম বা সারি ড্র্যাগ করে। অথবা আপনি আউটপুট নতুন ওয়ার্কশিটে দেখাতে চাইলে New Worksheet Ply সিলেক্ট করুন এবং আপনি নতুন ওয়ার্কবুকে আউটপুট দেখতে চাইলে New Workbook সিলেক্ট করুন।
- এরপর, আপনাকে Labels চেক করতে হবে যদি ইনপুট ডেটা রেঞ্জ লেবেলসহ থাকে।
- তারপর, OK-এ ক্লিক করুন।
- ফলস্বরূপ, আপনি টু স্যাম্পল ভেরিয়েন্সের জন্য F-test এর নিচের ফলাফল পাবেন।
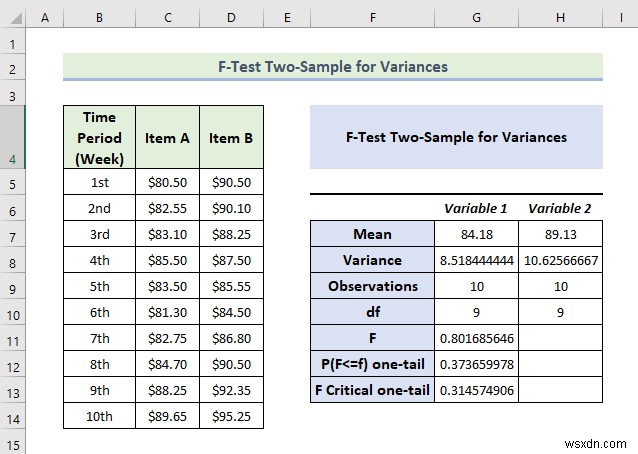
ফলাফলের ব্যাখ্যা:
- উপরোক্ত ডেটা থেকে, আমরা দেখতে পাচ্ছি যে ভেরিয়েবল ২-এর গড় মান ভেরিয়েবল ১-এর চেয়ে বেশি।
- আমরা ও জানি যে যদি F-এর মান F Critical one-tail মান থেকে বেশি হয়, এই কেসে আমরা বলতে পারি এটি নাল হাইপোথেসিস ফলো করে না। উপরের ডেটাতে, F-এর মান .8016 এবং F Critical one-tail-এর মান 0.3145 যা নির্দেশ করে F অনেক বেশি F critical one-tail। অন্য কথায়, দুটি ভেরিয়েবলের মধ্যে ভেরিয়েন্স মেলে না।
৭. মুভিং অ্যাভারেজ অ্যানালিসিস
এখন, আমরা মুভিং অ্যাভারেজ অ্যানালিসিস করব যা এক্সেল ডেটা অ্যানালিসিস টুলপ্যাকের সেরা ফিচারগুলোর একটি। মুভিং অ্যাভারেজ মানে গড়ের সময়কাল একই থাকে কিন্তু নতুন ডেটা যোগ হলে এটি চলতে থাকে। মুভিং অ্যাভারেজ ডেটা থেকে যেকোনো অনিয়মিততা (পিক এবং ভ্যালি) সমতল করে যাতে ট্রেন্ড সহজে চিনতে যায়। ইন্টারভাল পিরিয়ড যত বড় হবে মুভিং অ্যাভারেজ ক্যালকুলেট করার জন্য, তত বেশি ফ্লাকচুয়েশন স্মুথ হবে। কারণ প্রতিটি ক্যালকুলেটেড গড়ে বেশি ডেটা পয়েন্ট অন্তর্ভুক্ত থাকে। এখানে, আমাদের কাছে একটি ডেটাসেট আছে যাতে একটি ম্যানুফ্যাকচারিং কোম্পানির বিভিন্ন সপ্তাহে বিক্রি হওয়া আইটেমের সংখ্যা আছে। চলে মুভিং অ্যাভারেজ অ্যানালিসিস করার ধাপগুলো দেখি।
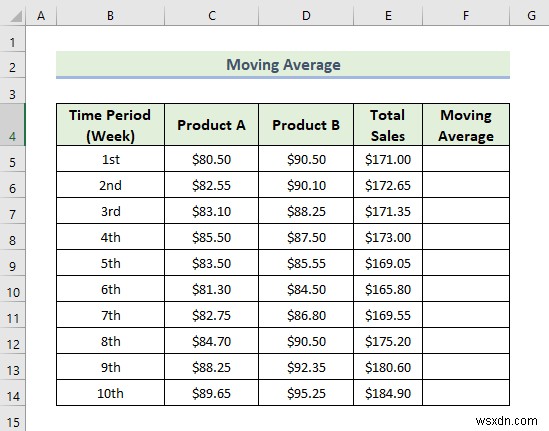
📌 ধাপসমূহ:
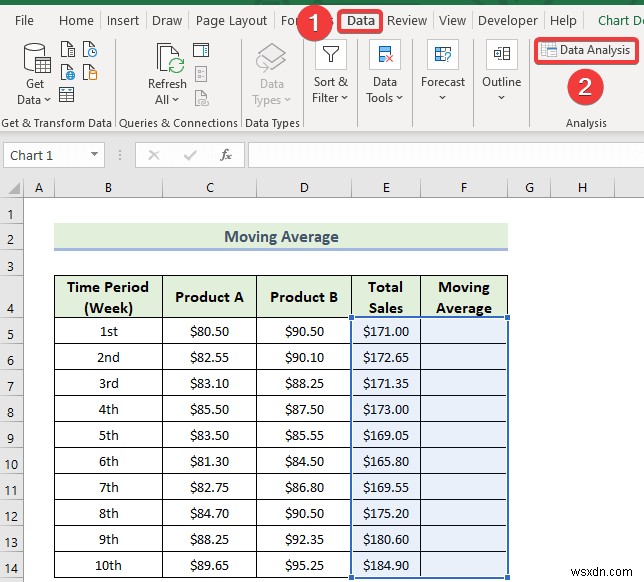
- প্রথমে, টপ রিবনে Data ট্যাবে যান।
- তারপর, Data Analysis টুলটি সিলেক্ট করুন।
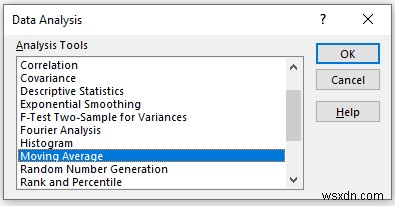
- Data Analysis উইন্ডো আসলে, Moving Average অপশনটি সিলেক্ট করুন।
- তারপর, OK-এ ক্লিক করুন।
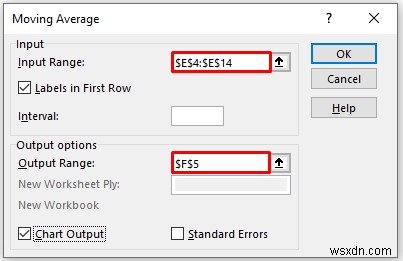
Moving Average পপ-আপ বক্সে,
- Input Range বক্সে ডেটা দিন, যা আপনি মুভিং অ্যাভারেজ ক্যালকুলেট করতে চান কলাম বা সারি ড্র্যাগ করে।
- Interval বক্সে ইন্টারভালের সংখ্যা লিখুন।
- Output Range বক্সে, আপনি আপনার ক্যালকুলেটेड ডেটা সংরক্ষণ করতে চান সেই ডেটা রেঞ্জ দিন কলাম বা সারি ড্র্যাগ করে। অথবা আপনি আউটপুট নতুন ওয়ার্কশিটে দেখাতে চাইলে New Worksheet Ply সিলেক্ট করুন এবং আপনি নতুন ওয়ার্কবুকে আউটপুট দেখতে চাইলে New Workbook সিলেক্ট করুন।
- আপনি যদি চান আপনার ডেটার ট্রেন্ডলাইন চার্ট সহ দেখতে, তবে Chart Output চেক করুন অন্যথায় রেখে দিন।
- এরপর, আপনাকে Labels in the first row চেক করতে হবে যদি ইনপুট ডেটা রেঞ্জ লেবেলসহ থাকে।
- তারপর, OK-এ ক্লিক করুন।
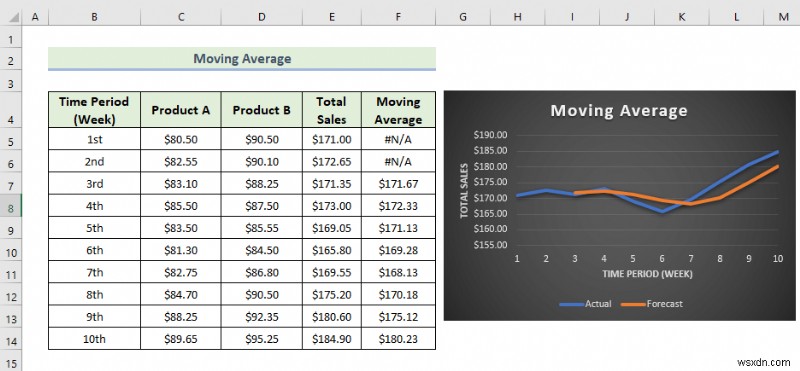
- ফলস্বরূপ, আপনি ডেটার মুভিং অ্যাভারেজ পাবেন একটি এক্সেল ট্রেন্ডলাইন সহ যা মূল ডেটা এবং স্মুথ ফ্লাকচুয়েশন সহ মুভিং অ্যাভারেজ মান উভয়ই দেখাবে।
সমান পঠনযোগ্য
- এক্সেলে পরিমাণগত ডেটা বিশ্লেষণ (সহজ ধাপ সহ)
- এক্সেলে বড় ডেটা সেট বিশ্লেষণ (৬ কার্যকর পদ্ধতি)
- এক্সেলে লিকার্ট স্কেল ডেটা বিশ্লেষণ (দ্রুত ধাপ সহ)
- প্রশ্নাবলি থেকে গুণগত ডেটা এক্সেলে বিশ্লেষণ
৮. র্যান্ডম নম্বর জেনারেশন
এখন, আমরা একটি র্যান্ডম নম্বর জেনারেট করব। এক্সেল ডেটা অ্যানালিসিস টুলপ্যাক আমাদের বিভিন্ন критеরিয়া সহ র্যান্ডম নম্বর জেনারেট করতে দেয়। চলে মুভিং অ্যাভারেজ অ্যানালিসিস করার ধাপগুলো দেখি।
📌 ধাপসমূহ:
- প্রথমে, টপ রিবনে Data ট্যাবে যান।
- তারপর, Data Analysis টুলটি সিলেক্ট করুন।
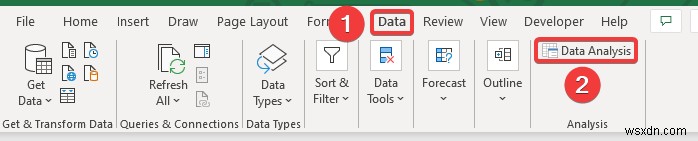
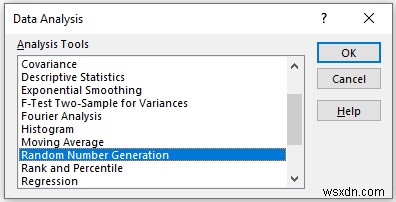
- Data Analysis উইন্ডো আসলে, Descriptive Statistics অপশনটি সিলেক্ট করুন।
- তারপর, OK-এ ক্লিক করুন।
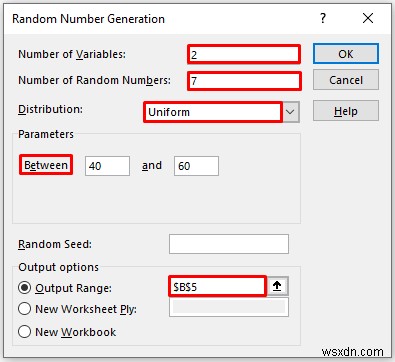
Random Number Generation পপ-আপ বক্সে,
- Number of Variables-এ ডেটা দিন যা আপনার ওয়ার্কশিটে কত কলাম র্যান্ডম নম্বর চান তা নির্দেশ করে। এখানে, আমরা ২ ইনপুট করেছি কারণ আমরা ২ কলাম চাই।
- এরপর, Number of Random Numbers-এ ডেটা দিন যা আপনার ওয়ার্কশিটে কত সারি চান তা নির্দেশ করে। এখানে, ৭ ইনপুট করুন যার মানে আমরা আমাদের ওয়ার্কশিটে ৭ সারি চাই।
- তারপর, Distribution-এ uniform সিলেক্ট করুন। এখানে, Distribution মানে আপনি কী ধরনের র্যান্ডম নম্বর ডিস্ট্রিবিউশন চান।
- এখানে, parameters আপনার ডিস্ট্রিবিউশনের সীমানা নির্দেশ করে। এই উদাহরণে, ৪০ থেকে ৬০।
- Output Range বক্সে, আপনি আপনার ক্যালকুলেটেড ডেটা সংরক্ষণ করতে চান সেই ডেটা রেঞ্জ দিন কলাম বা সারি ড্র্যাগ করে। অথবা আপনি আউটপুট নতুন ওয়ার্কশিটে দেখাতে চাইলে New Worksheet Ply সিলেক্ট করুন এবং আপনি নতুন ওয়ার্কবুকে আউটপুট দেখতে চাইলে New Workbook সিলেক্ট করুন।
- তারপর, OK-এ ক্লিক করুন।
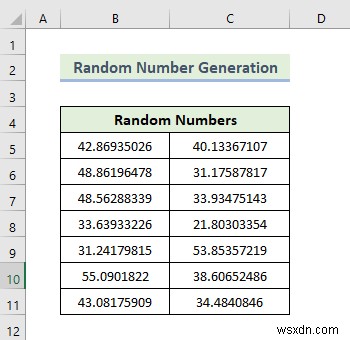
- ফলস্বরূপ, আপনি নির্দিষ্ট ক্রিটেরিয়ার সাথে র্যান্ডম নম্বর জেনারেট করতে পারবেন নিচের মতো।
৯. র্যাঙ্ক অ্যান্ড পার্সেন্টাইল অ্যানালিসিস
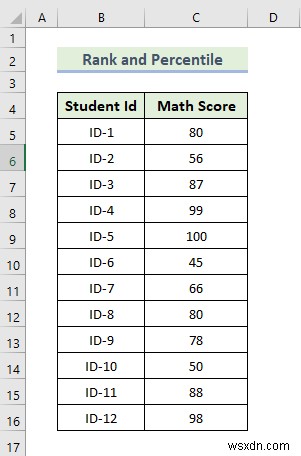
এখন, আমরা র্যাঙ্ক এবং পার্সেন্টাইল অ্যানালিসিস করব। এখানে, আমাদের কাছে একটি ডেটাসেট আছে যাতে ছাত্রদের ID এবং তাদের ম্যাথ পরীক্ষার স্কোর আছে। আমরা প্রতিটি ছাত্রের ম্যাথ পরীক্ষার স্কোরের র্যাঙ্ক এবং পার্সেন্টাইল ক্যালকুলেট করব। চলে র্যাঙ্ক এবং পার্সেন্টাইল অ্যানালিসিস করার ধাপগুলো দেখি।
📌 ধাপসমূহ:
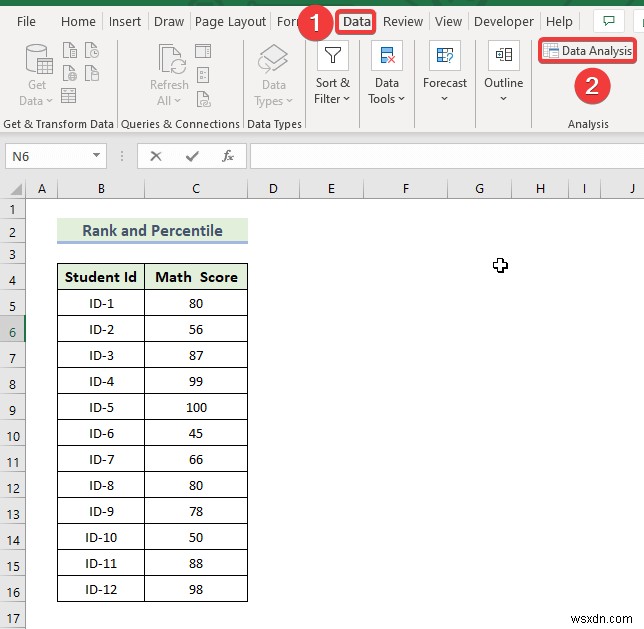
- প্রথমে, টপ রিবনে Data ট্যাবে যান।
- তারপর, Data Analysis টুলটি সিলেক্ট করুন।
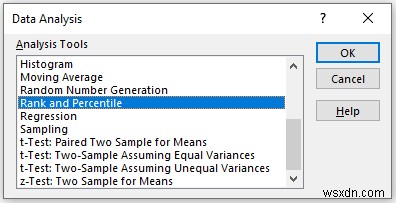
- Data Analysis উইন্ডো আসলে, Rank and Percentile অপশনটি সিলেক্ট করুন।
- তারপর, OK-এ ক্লিক করুন।
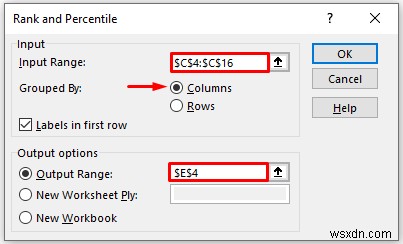
Rank and Percentile পপ-আপ বক্সে,
- Input Range বক্সে ডেটা দিন, যা আপনি মুভিং অ্যাভারেজ ক্যালকুলেট করতে চান কলাম বা সারি ড্র্যাগ করে।
- এখন, Grouped By সেকশনে Columns অপশনটি চেক করুন।
- Output Range বক্সে, আপনি আপনার ক্যালকুলেটেড ডেটা সংরক্ষণ করতে চান সেই ডেটা রেঞ্জ দিন কলাম বা সারি ড্র্যাগ করে। অথবা আপনি আউটপুট নতুন ওয়ার্কশিটে দেখাতে চাইলে New Worksheet Ply সিলেক্ট করুন এবং আপনি নতুন ওয়ার্কবুকে আউটপুট দেখতে চাইলে New Workbook সিলেক্ট করুন।
- এরপর, আপনাকে Labels in the first row চেক করতে হবে যদি ইনপুট ডেটা রেঞ্জ লেবেলসহ থাকে।
- তারপর, OK-এ ক্লিক করুন।
- ফলস্বরূপ, আপনি প্রতিটি ছাত্রের পরীক্ষার স্কোরের র্যাঙ্ক এবং পার্সেন্টাইল পাবেন নিচের মতো।
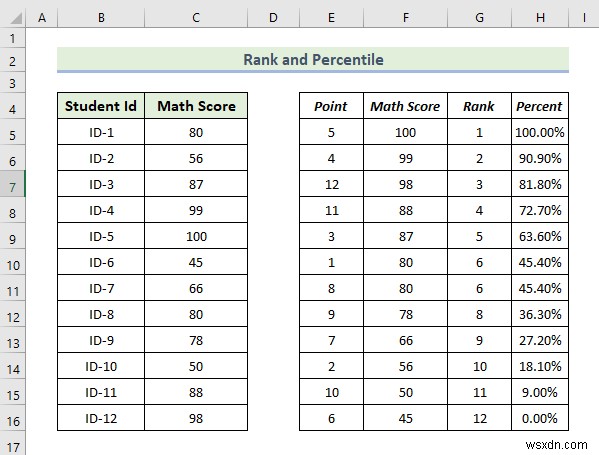
উপরোক্ত ফলাফল থেকে, আমরা দেখতে পাচ্ছি যে আমরা প্রতিটি ছাত্রের নম্বরের র্যাঙ্ক এবং পার্সেন্টাইল ক্যালকুলেট করতে পেরেছি। এখানে, র্যাঙ্ক ১ নম্বর ১০০ যা ID-5-এর ম্যাথ স্কোর, এবং লাস্ট র্যাঙ্ক নম্বর ৪৫ যা ID-6-এর ম্যাথ স্কোর।
১০. রিগ্রেশন অ্যানালিসিস
এখন, আমরা রিগ্রেশন অ্যানালিসিস করব। রিগ্রেশন অ্যানালিসিস পরিসংখ্যানের একটি অংশ যা দুটি বা অধিক ভেরিয়েবলের ওপর নির্ভর করে মান প্রেডিক্ট করতে সাহায্য করে। এখানে, আমাদের কাছে একটি ডেটাসেট আছে যাতে প্লেয়ারের নাম, প্রতিটি প্লেয়ারের খেলা ম্যাচের সংখ্যা, এবং প্রতিটি প্লেয়ারের দেওয়া গোলের সংখ্যা আছে। চলে রিগ্রেশন অ্যানালিসিস করার ধাপগুলো দেখি।
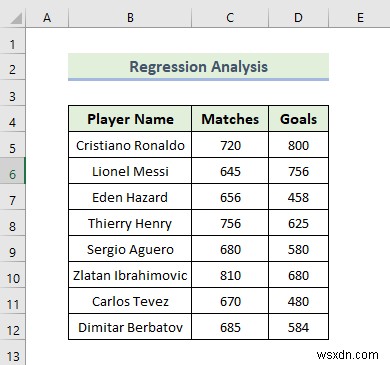
📌 ধাপসমূহ:
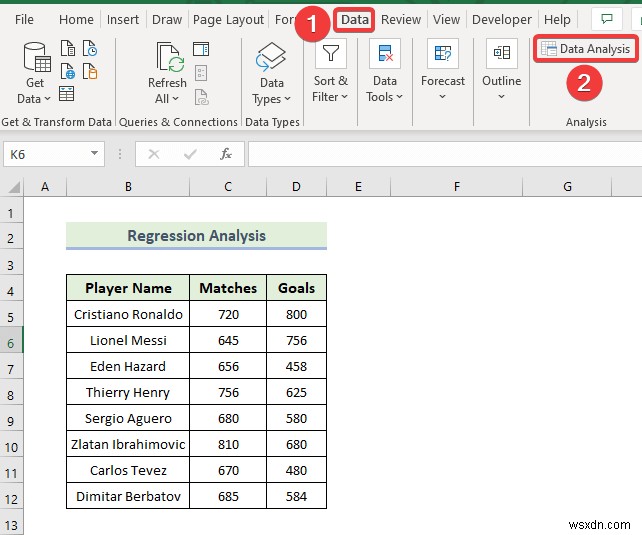
- প্রথমে, টপ রিবনে Data ট্যাবে যান।
- তারপর, Data Analysis টুলটি সিলেক্ট করুন।
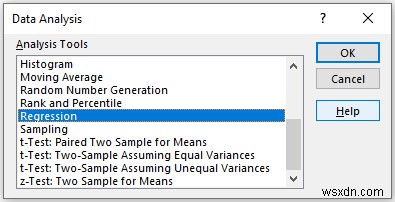
- Data Analysis উইন্ডো আসলে, Regression অপশনটি সিলেক্ট করুন।
- তারপর, OK-এ ক্লিক করুন।
Regression পপ-আপ বক্সে,
- Input Range বক্সে ডেটা দিন, এবং Input X Range এবং Input Y Range বক্সে ডেটা রেঞ্জ দিন।
- Output Range বক্সে, আপনি আপনার ক্যালকুলেটেড ডেটা সংরক্ষণ করতে চান সেই ডেটা রেঞ্জ দিন কলাম বা সারি ড্র্যাগ করে। অথবা আপনি আউটপুট নতুন ওয়ার্কশিটে দেখাতে চাইলে New Worksheet Ply সিলেক্ট করুন এবং আপনি নতুন ওয়ার্কবুকে আউটপুট দেখতে চাইলে New Workbook সিলেক্ট করুন।
- এরপর, আপনাকে Labels চেক করতে হবে যদি ইনপুট ডেটা রেঞ্জ লেবেলসহ থাকে।
- আপনাকে Residuals অপশনটিও চেক করতে হবে আউটপুট ভ্যালু পেতে।
- তারপর, OK-এ ক্লিক করুন।
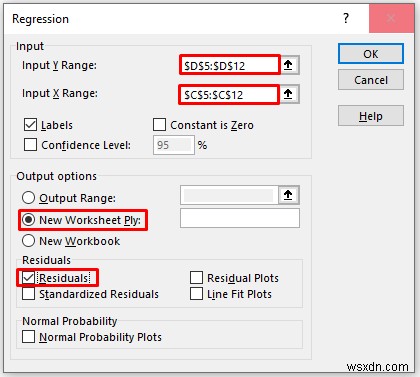
- ফলস্বরূপ, আপনি রিগ্রেশন অ্যানালিসিসের নিচের ফলাফল পাবেন।
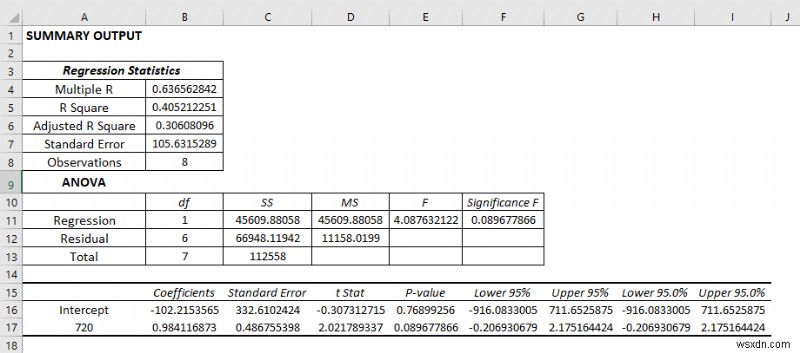
রিগ্রেশন অ্যানালিসিস ফলাফলের ব্যাখ্যা:
Regression Statistics:
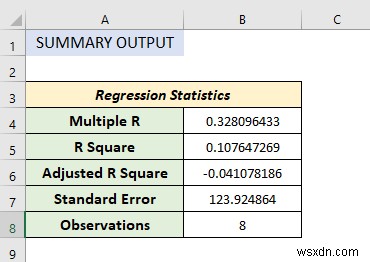
রিগ্রেশন স্ট্যাটিস্টিক্স বিভিন্ন প্যারামিটারের একটি অ্যারে যা বর্ণনা করে কত ভালো মাপা লিনিয়ার রিগ্রেশন।
- Multiple R হলো একটি করিলেশন কোইফিশিয়েন্ট প্যারামিটার যা ভেরিয়েবলগুলোর মধ্যে করিলেশন নির্দেশ করে। এর মান -১ থেকে +১ পর্যন্ত। মান যত বড়, করিলেশন সম্পর্ক তত শক্তিশালী।
- R Square কোইফিশিয়েন্ট অফ ডিটারমিনেশনকে প্রতীকায়িত করে। এটি নির্দেশ করে ডেটা মডেলটি কতটুকু রিগ্রেশন অ্যানালিসিস-এ ফিট হয়।
- Adjusted R square রিগ্রেশন অ্যানালিসিসে একাধিক ভেরিয়েবলে ব্যবহৃত হয়।
- Standard Error যেকোনো রিগ্রেশন অ্যানালিসিসের সুস্থ ফিট দেখানোর অন্য একটি প্যারামিটার। স্ট্যান্ডার্ড এরর যত ছোট, লিনিয়ার রিগ্রেশন ইকুয়েশন তত সঠিক। এটি লিনিয়ার ইকুয়েশন থেকে ডেটা পয়েন্টের গড় দূরত্ব দেখায়।
Anova:
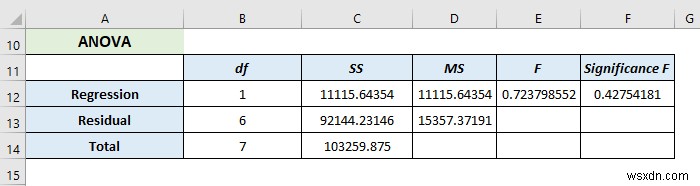
এটি ডেটা মডেলের ভেরিয়েন্স অ্যানালাইজ করে।
- এখানে, df ডিগ্রি অফ ফ্রিডমকে প্রতীকায়িত করে।
- SS( sum of squares) গুড-টু-ফিট প্যারামিটারকে প্রতীকায়িত করে।
- MS মানে মিন স্কোয়ার।
- F নাল হাইপোথেসিসকে নির্দেশ করে। এটি রিগ্রেশন মডেলের সামগ্রিক তাৎপর্য টেস্ট করে।
- Significance of F মানে F-এর P-value।
Co-efficient Outcome:
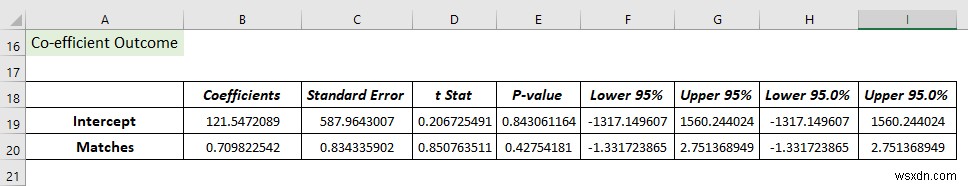
এটি Y মান সহজে নির্ধারণ করতে সাহায্য করে।
Residual Output:
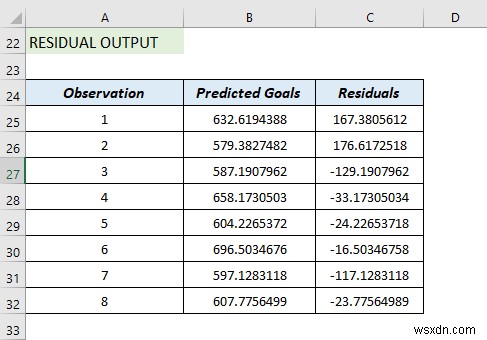
তাই, এটি প্রাক্কলিত মান এবং ক্যালকুলেটেড মান তুলনা করে।
১১. t-Test অ্যানালিসিস
এখন, আমরা ডেটাসেটের T-Test অ্যানালিসিস করব। T-Test তিন প্রকারের:
- পেয়ারড টু স্যাম্পলস ফর মিন্স
- টু স্যাম্পলস অ্যাসুমিং ইকুয়াল ভেরিয়েন্সেস
- টু- স্যাম্পলস ইউজিং আনইকুয়াল ভেরিয়েন্সেস
এই বিভাগটি T-Test অ্যানালিসিসের তিন প্রকারের বিস্তারিত বিবরণ দেয়। আপনি আপনার উদ্দেশ্যের জন্য যেকোনো একটি ব্যবহার করতে পারেন, কাস্টমাইজেশনের ক্ষেত্রে এগুলো ব্যাপক লচীলapan প্রদান করে।
১১.১ t-Test: Paired Two Sample for Means
এখন, আমরা t-Test: Paired Two Sample for Means করব। এখানে, আমাদের কাছে একটি ডেটাসেট আছে যাতে ছাত্রদের ID এবং প্রতিটি ছাত্রের ম্যাথ এবং ফিজিক্স স্কোর আছে। চলে t-Test: Paired Two Sample for Means অ্যানালিসিস করার ধাপগুলো দেখি।
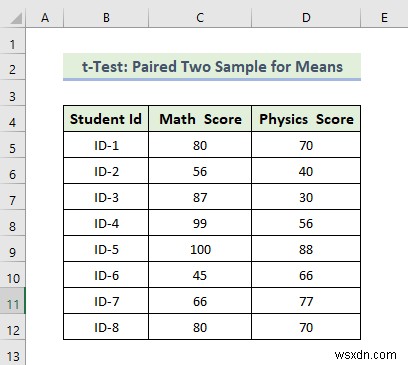
📌 ধাপসমূহ:
- প্রথমে, টপ রিবনে Data ট্যাবে যান।
- তারপর, Data Analysis টুলটি সিলেক্ট করুন।
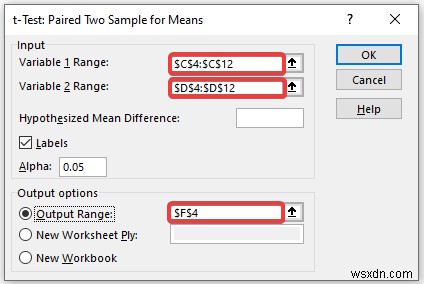
- Data Analysis উইন্ডো আসলে, t-Test: Paired Two Samples for Means অপশনটি সিলেক্ট করুন।
- তারপর, OK-এ ক্লিক করুন।
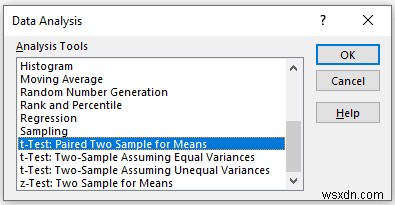
t-Test: Paired Two Sample for Means পপ-আপ বক্সে,
- Input বক্সে ডেটা দিন, এবং Variable 1 Range এবং Variable 2 Range বক্সে ডেটা রেঞ্জ দিন।
- Output Range বক্সে, আপনি আপনার ক্যালকুলেটেড ডেটা সংরক্ষণ করতে চান সেই ডেটা রেঞ্জ দিন কলাম বা সারি ড্র্যাগ করে। অথবা আপনি আউটপুট নতুন ওয়ার্কশিটে দেখাতে চাইলে New Worksheet Ply সিলেক্ট করুন এবং আপনি নতুন ওয়ার্কবুকে আউটপুট দেখতে চাইলে New Workbook সিলেক্ট করুন।
- এরপর, আপনাকে Labels চেক করতে হবে যদি ইনপুট ডেটা রেঞ্জ লেবেলসহ থাকে।
- তারপর, OK-এ ক্লিক করুন।
- ফলস্বরূপ, আপনি t-Test: Paired Two Sample for Means-এর নিচের ফলাফল পাবেন।
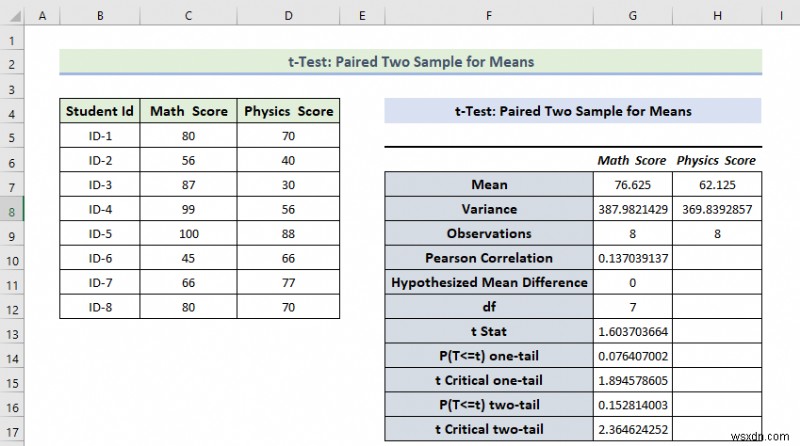
ফলাফলের ব্যাখ্যা:
- এখানে, আমরা দেখতে পাচ্ছি যে ম্যাথ স্কোরের গড় মান (Mean Value) ফিজিক্স স্কোরের গড় মানের চেয়ে বেশি।
- ম্যাথ স্কোরের ভেরিয়েন্সও ফিজিক্স স্কোরের ভেরিয়েন্সের চেয়ে বেশি।
- যদি t Stat t Critical two-tail থেকে বেশি হয়, এই কন্ডিশনে আমরা নাল হাইপোথেসিস বাতিল করতে পারি না। উপরের ক্যালকুলেশনে, আমরা দেখতে পাচ্ছি t Stat এবং t Critical two-tail মান যথাক্রমে 1.603 এবং 2.36464। অর্থাৎ 1.603< 2.36464, এটি নাল হাইপোথেসিস মেলে না। অন্য কথায়, দুটি ভেরিয়েবলের মধ্যে ভেরিয়েন্স মেলে না।
১১.২ t-Test Two-Sample Assuming Equal Variances
এখন, আমরা t-Test: Two-Sample Equal Variances করব। এখানে, আমাদের কাছে একটি ডেটাসেট আছে যাতে ছাত্রদের ID এবং প্রতিটি ছাত্রের ম্যাথ এবং ফিজিক্স স্কোর আছে। এখানে, ইকুয়াল ভেরিয়েন্স মানে আমরা আমাদের ডেটা নিয়মিত ডিস্ট্রিবিউশন পপুলেশন থেকে নেওয়া। চলে t-Test: Two-Sample Equal Variances অ্যানালিসিস করার ধাপগুলো দেখি।
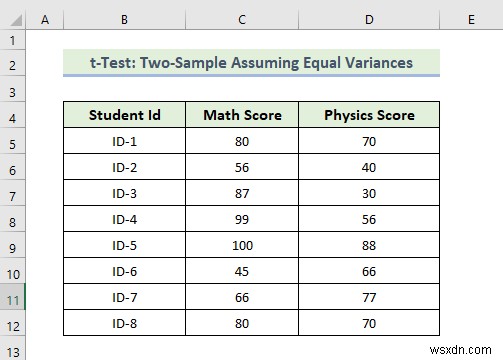
📌 ধাপসমূহ:
- প্রথমে, টপ রিবনে Data ট্যাবে যান।
- তারপর, Data Analysis টুলটি সিলেক্ট করুন।
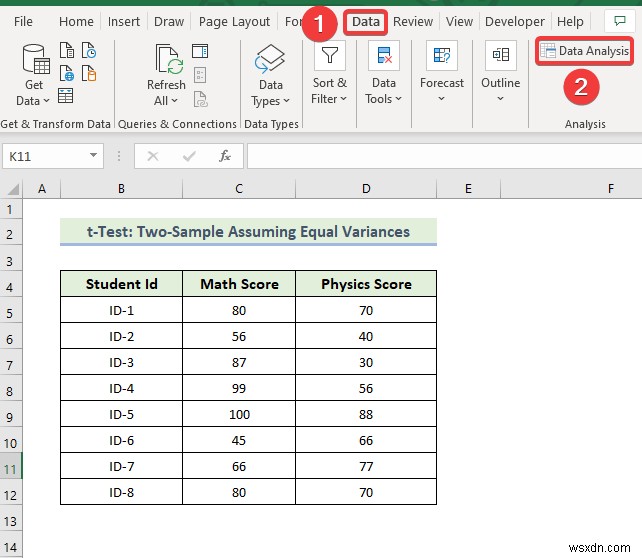
- Data Analysis উইন্ডো আসলে, t-Test: Two-Sample Equal Variances অপশনটি সিলেক্ট করুন।
- তারপর, OK-এ ক্লিক করুন।
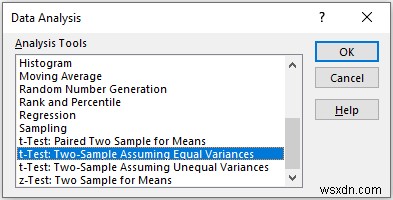
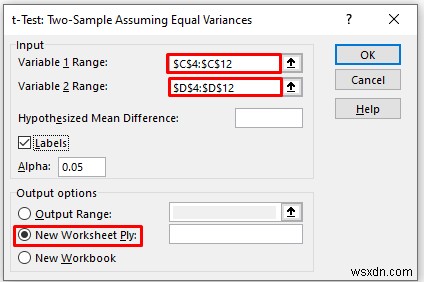
t-Test: Paired Two Sample Equal Variances পপ-আপ বক্সে,
- Input বক্সে ডেটা দিন, এবং Variable 1 Range এবং Variable 2 Range বক্সে ডেটা রেঞ্জ দিন।
- Output Range বক্সে, আপনি আপনার ক্যালকুলেটেড ডেটা সংরক্ষণ করতে চান সেই ডেটা রেঞ্জ দিন কলাম বা সারি ড্র্যাগ করে। অথবা আপনি আউটপুট নতুন ওয়ার্কশিটে দেখাতে চাইলে New Worksheet Ply সিলেক্ট করুন এবং আপনি নতুন ওয়ার্কবুকে আউটপুট দেখতে চাইলে New Workbook সিলেক্ট করুন।
- এরপর, আপনাকে Labels চেক করতে হবে যদি ইনপুট ডেটা রেঞ্জ লেবেলসহ থাকে।
- তারপর, OK-এ ক্লিক করুন।
- ফলস্বরূপ, আপনি t-Test: Two-Sample Equal Variances-এর নিচের ফলাফল পাবেন।
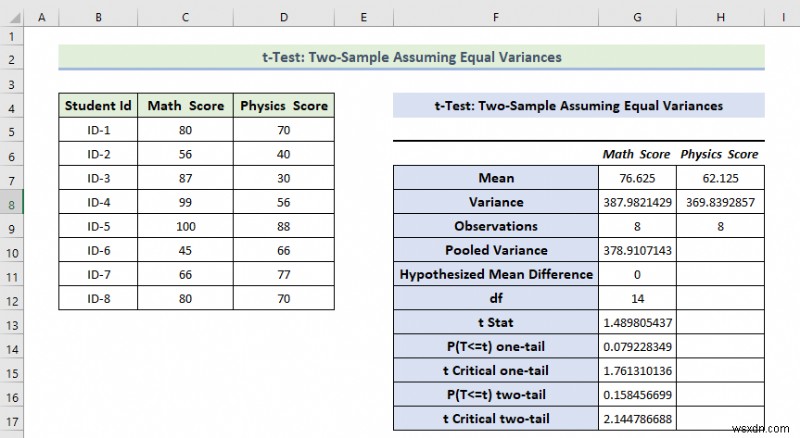
ফলাফলের ব্যাখ্যা:
- এখানে, আমরা দেখতে পাচ্ছি যে ম্যাথ স্কোরের গড় মান ফিজিক্স স্কোরের গড় মানের চেয়ে বেশি।
- ম্যাথ স্কোরের ভেরিয়েন্সও ফিজিক্স স্কোরের ভেরিয়েন্সের চেয়ে বেশি।
- যদি t Stat t Critical two-tail থেকে বেশি হয়, এই কন্ডিশনে আমরা নাল হাইপোথেসিস বাতিল করতে পারি না। উপরের ক্যালকুলেশনে, আমরা দেখতে পাচ্ছি t Stat এবং t Critical two-tail মান যথাক্রমে 1.48 এবং 2.144। অর্থাৎ 1.48< 2.144, এটি নাল হাইপোথেসিস মেলে না। অন্য কথায়, দুটি ভেরিয়েবলের মধ্যে ভেরিয়েন্স মেলে না।
১১.৩ t-Test: Two-Sample Assuming Unequal Variances
এখন, আমরা t-Test: Two-Sample Unequal Variances করব। এখানে, আমাদের কাছে একটি ডেটাসেট আছে যাতে ছাত্রদের ID এবং প্রতিটি ছাত্রের ম্যাথ এবং ফিজিক্স স্কোর আছে। এখানে, আনইকুয়াল ভেরিয়েন্স মানে আমরা আমাদের ডেটা অনিয়মিত ডিস্ট্রিবিউশন পপুলেশন থেকে নেওয়া। চলে t-Test: Two-Sample Unequal Variances অ্যানালিসিস করার ধাপগুলো দেখি।
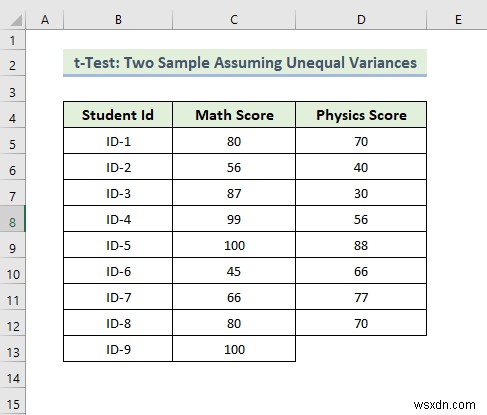
📌 ধাপসমূহ:
- প্রথমে, টপ রিবনে Data ট্যাবে যান।
- তারপর, Data Analysis টুলটি সিলেক্ট করুন।
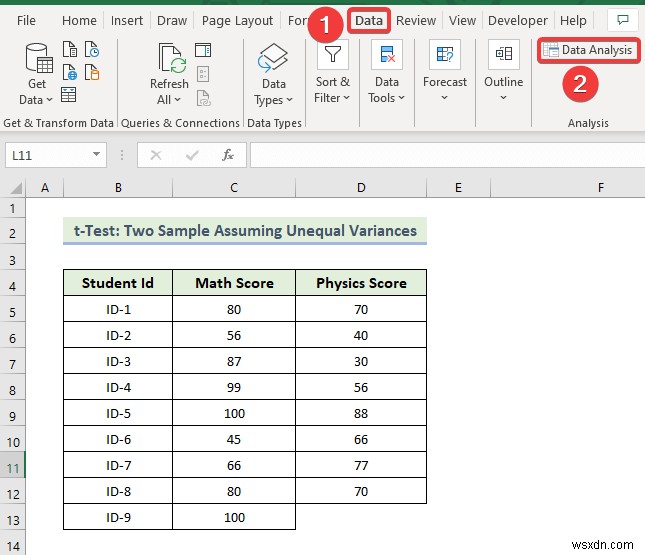
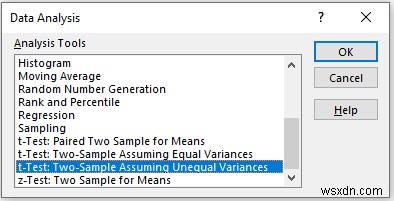
- Data Analysis উইন্ডো আসলে, t-Test: Two-Sample Unequal Variances অপশনটি সিলেক্ট করুন।
- তারপর, OK-এ ক্লিক করুন।
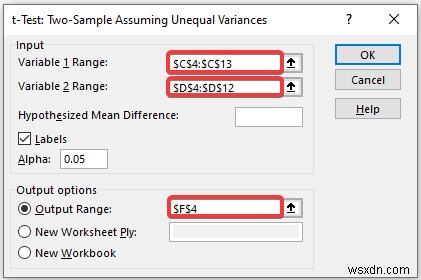
t-Test: Paired Two Sample Unequal Variances পপ-আপ বক্সে,
- Input বক্সে ডেটা দিন, এবং Variable 1 Range এবং Variable 2 Range বক্সে ডেটা রেঞ্জ দিন।
- Output Range বক্সে, আপনি আপনার ক্যালকুলেটেড ডেটা সংরক্ষণ করতে চান সেই ডেটা রেঞ্জ দিন কলাম বা সারি ড্র্যাগ করে। অথবা আপনি আউটপুট নতুন ওয়ার্কশিটে দেখাতে চাইলে New Worksheet Ply সিলেক্ট করুন এবং আপনি নতুন ওয়ার্কবুকে আউটপুট দেখতে চাইলে New Workbook সিলেক্ট করুন।
- এরপর, আপনাকে Labels চেক করতে হবে যদি ইনপুট ডেটা রেঞ্জ লেবেলসহ থাকে।
- তারপর, OK-এ ক্লিক করুন।
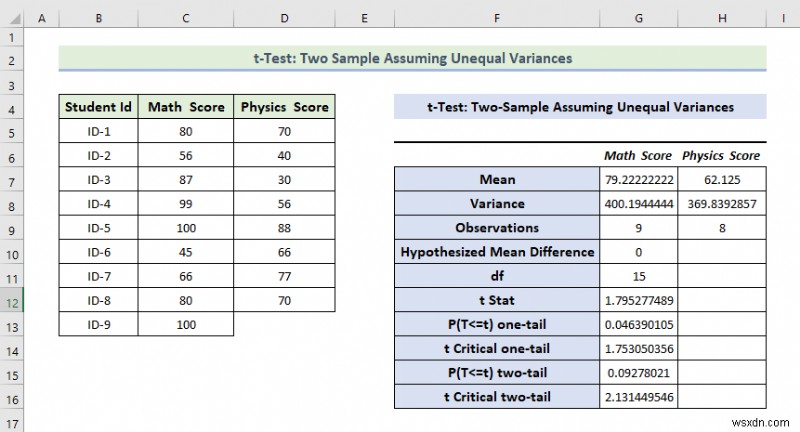
- ফলস্বরূপ, আপনি t-Test: Two-Sample Unequal Variances.-এর নিচের ফলাফল পাবেন।
ফলাফলের ব্যাখ্যা:
- এখানে, আমরা দেখতে পাচ্ছি যে ম্যাথ স্কোরের গড় মান ফিজিক্স স্কোরের গড় মানের চেয়ে বেশি।
- উপরোক্ত ফলাফল থেকে, আমরা দেখতে পাচ্ছি ম্যাথ স্কোরের ভেরিয়েন্সও ফিজিক্স স্কোরের ভেরিয়েন্সের চেয়ে বেশি।
- যদি t Stat t Critical two-tail থেকে বেশি হয়, এই কন্ডিশনে আমরা নাল হাইপোথেসিস বাতিল করতে পারি না। উপরের ক্যালকুলেশনে, আমরা দেখতে পাচ্ছি t Stat এবং t Critical two-tail মান যথাক্রমে 79 এবং 2.131। অর্থাৎ 1.79< 2.131, এটি নাল হাইপোথেসিস মেলে না। অন্য কথায়, দুটি ভেরিয়েবলের মধ্যে ভেরিয়েন্স মেলে না।
১২. z-Test: Two Sample for Means
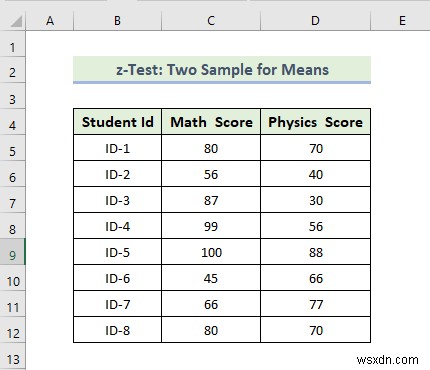
এখন, আমরা z-Test: Two-Sample Means করব। এখানে, আমাদের কাছে একটি ডেটাসেট আছে যাতে ছাত্রদের ID এবং প্রতিটি ছাত্রের ম্যাথ এবং ফিজিক্স স্কোর আছে। এখানে আমরা VAR.P ফাংশন ব্যবহার করব দুটি ভেরিয়েবলের ভেরিয়েন্স ক্যালকুলেট করার জন্য। চলে z-Test: Two-Sample Means অ্যানালিসিস করার ধাপগুলো দেখি।
📌 ধাপসমূহ:
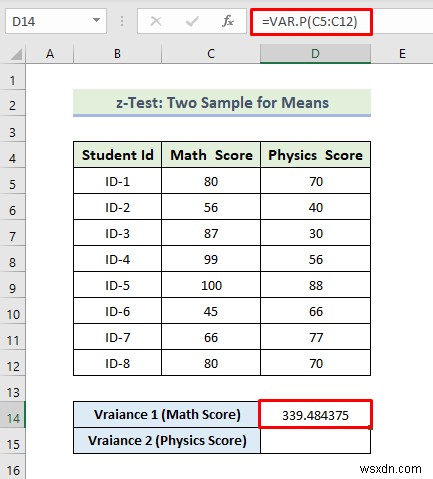
- প্রথমে, ম্যাথ স্কোরের ভেরিয়েন্স ক্যালকুলেট করতে, আমরা সেল D14-এ নিচের ফর্মুলা ব্যবহার করব:
=VAR.P(C5:C12)
- তারপর, Enter চাপুন।
- ফলস্বরূপ, আপনি ম্যাচ স্কোরের নিচের ভেরিয়েন্স পাবেন।
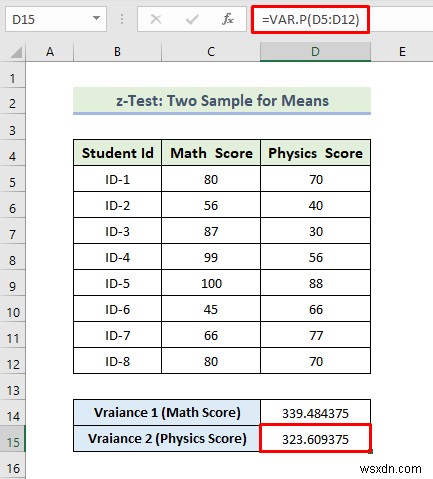
- এরপর, ফিজিক্স স্কোরের ভেরিয়েন্স ক্যালকুলেট করতে, আমরা সেল D15-এ নিচের ফর্মুলা ব্যবহার করব:
=VAR.P(D5:D12)
- তারপর, Enter চাপুন।
- ফলস্বরূপ, আপনি ফিজিক্স স্কোরের নিচের ভেরিয়েন্স পাবেন।
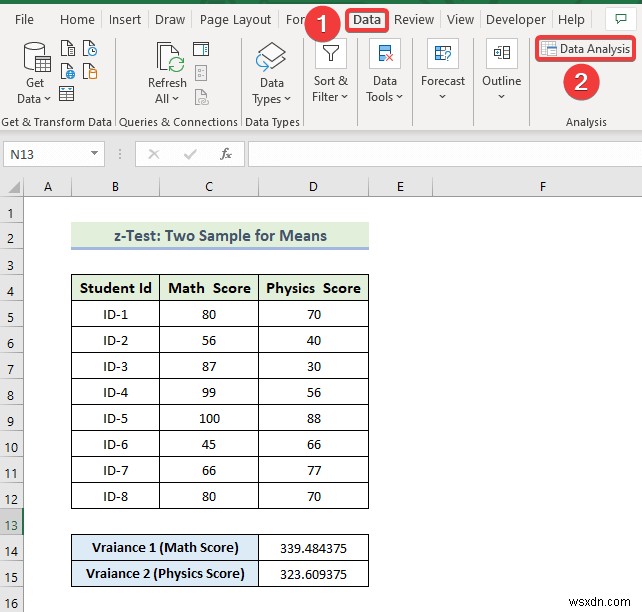
- প্রথমে, টপ রিবনে Data ট্যাবে যান।
- তারপর, Data Analysis টুলটি সিলেক্ট করুন।
- Data Analysis উইন্ডো আসলে, z-Test: Two-Sample Means অপশনটি সিলেক্ট করুন।
- তারপর, OK-এ ক্লিক করুন।
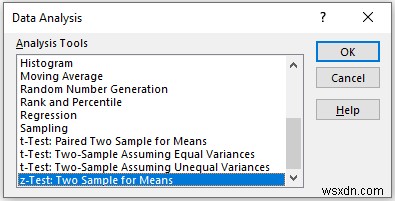
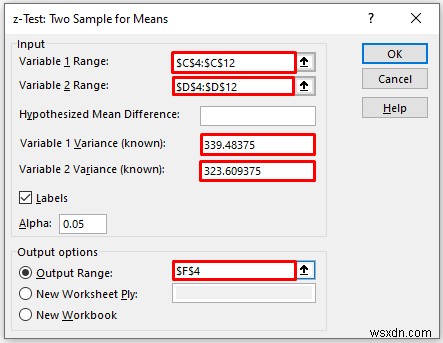
z-Test: Two-Sample Means পপ-আপ বক্সে,
- Input বক্সে ডেটা দিন, এবং Variable 1 Range এবং Variable 2 Range বক্সে ডেটা রেঞ্জ দিন।
- Output Range বক্সে, আপনি আপনার ক্যালকুলেটেড ডেটা সংরক্ষণ করতে চান সেই ডেটা রেঞ্জ দিন কলাম বা সারি ড্র্যাগ করে। অথবা আপনি আউটপুট নতুন ওয়ার্কশিটে দেখাতে চাইলে New Worksheet Ply সিলেক্ট করুন এবং আপনি নতুন ওয়ার্কবুকে আউটপুট দেখতে চাইলে New Workbook সিলেক্ট করুন।
- আপনাকে ম্যাথ এবং ফিজিক্স স্কোরের ভেরিয়েন্স মান যথাক্রমে Variable 1 Variance (known) এবং Variable 2 Variance (known)-এ ইনপুট করতে হবে।
- এরপর, আপনাকে Labels চেক করতে হবে যদি ইনপুট ডেটা রেঞ্জ লেবেলসহ থাকে।
- তারপর, OK-এ ক্লিক করুন।
- ফলস্বরূপ, আপনি z-Test: Two-Sample Means অপশনটির নিচের ফলাফল পাবেন।
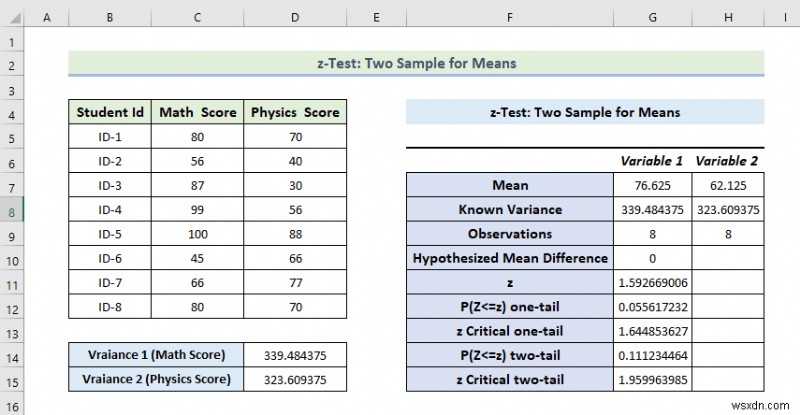
ফলাফলের ব্যাখ্যা:
- এখানে, আমরা দেখতে পাচ্ছি যে ম্যাথ স্কোরের গড় মান ফিজিক্স স্কোরের গড় মানের চেয়ে বেশি।
- উপরোক্ত ফলাফল থেকে, আমরা দেখতে পাচ্ছি ম্যাথ স্কোরের ভেরিয়েন্সও ফিজিক্স স্কোরের ভেরিয়েন্সের চেয়ে বেশি।
- যদি Z Z critical two-tall থেকে কম হয়, এই কন্ডিশনে আমরা নাল হাইপোথেসিস বাতিল করতে পারি না। উপরের ক্যালকুলেশনে, আমরা দেখতে পাচ্ছি z এবং z Critical two-tail মান যথাক্রমে 52 এবং 1.95। অর্থাৎ 1.52 < 1.95, যা নাল হাইপোথেসিস মেলে। অন্য কথায়, দুটি ভেরিয়েবলের মধ্যে ভেরিয়েন্স মেলে।
আরও পড়ুন: এক্সেল ডেটা অ্যানালিসিস ব্যবহার করে কেস স্টাডি সম্পাদন
১৩. স্যাম্পলিং অ্যানালিসিস
এখন, আমরা একটি স্যাম্পলিং অ্যানালিসিস করব যা এক্সেল ডেটা অ্যানালিসিস টুলপ্যাকের সেরা ফিচারগুলোর একটি। এখানে, আমাদের কাছে একটি ডেটাসেট আছে যাতে দুটি আইটেমের jednotlivে সেলস এবং বিভিন্ন সময়ের জন্য টোটাল সেলস ভ্যালু আছে। চলে স্যাম্পলিং অ্যানালিসিস করার ধাপগুলো দেখি।
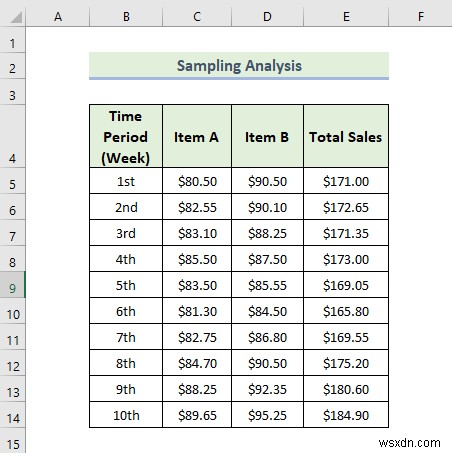
📌 ধাপসমূহ:
- প্রথমে, টপ রিবনে Data ট্যাবে যান।
- তারপর, Data Analysis টুলটি সিলেক্ট করুন।
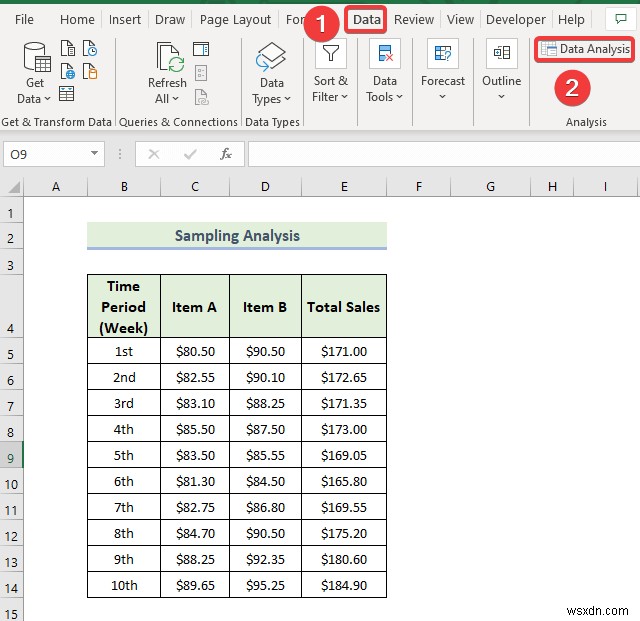
- Data Analysis উইন্ডো আসলে, Sampling অপশনটি সিলেক্ট করুন।
- তারপর, OK-এ ক্লিক করুন।
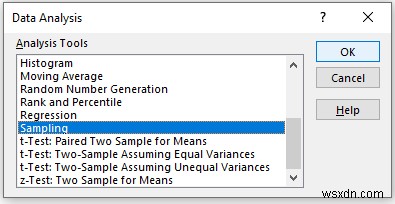
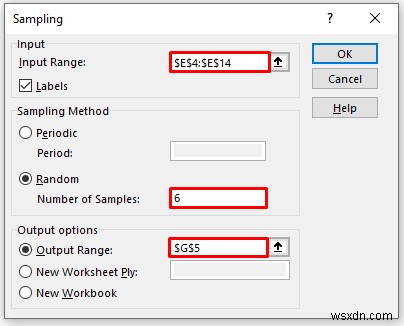
Sampling পপ-আপ বক্সে,
- Input Range বক্সে ডেটা দিন, যা আপনি মুভিং অ্যাভারেজ ক্যালকুলেট করতে চান কলাম বা সারি ড্র্যাগ করে।
- Output Range বক্সে, আপনি আপনার ক্যালকুলেটেড ডেটা সংরক্ষণ করতে চান সেই ডেটা রেঞ্জ দিন কলাম বা সারি ড্র্যাগ করে। অথবা আপনি আউটপুট নতুন ওয়ার্কশিটে দেখাতে চাইলে New Worksheet Ply সিলেক্ট করুন এবং আপনি নতুন ওয়ার্কবুকে আউটপুট দেখতে চাইলে New Workbook সিলেক্ট করুন।
- আপনাকে Number of Samples অপশনে ডেটা ইনপুট করতে হবে।
- এরপর, আপনাকে Labels চেক করতে হবে যদি ইনপুট ডেটা রেঞ্জ লেবেলসহ থাকে।
- তারপর, OK-এ ক্লিক করুন।
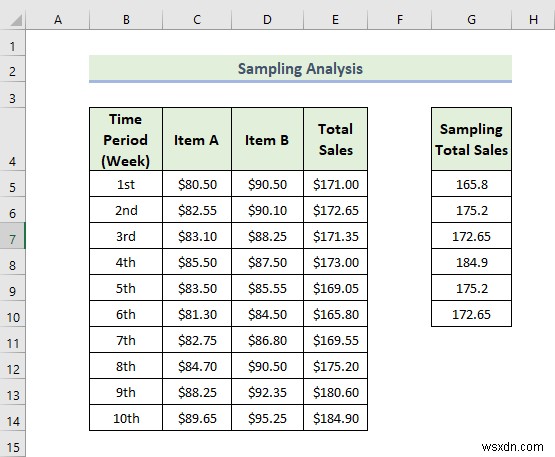
- ফলস্বরূপ, আপনি Sampling অ্যানালিসিসের নিচের ফলাফল পাবেন। নিচের ছবিতে, আমরা Total Sales কলাম থেকে ছয়টি স্যাম্পল পিক আপ করতে পেরেছি। আপনি যদি এই কলাম থেকে আরও স্যাম্পল ডেটা পিক আপ করতে চান, তবে Sampling উইন্ডো আসার সময় Number of Samples বক্সে আরও নম্বর ইনপুট করতে হবে।
আরও পড়ুন: এক্সেলে সেলস ডেটা বিশ্লেষণ (১০ সহজ উপায়)
উপসংহার
আজকের সেশনের এখানেই সমাপ্তি। এখানে, আমরা ডেটা অ্যানালিসিস টুলপ্যাক ব্যবহারের ১৩টি উপযুক্ত উদাহরণ দেখিয়েছি। আমি দৃঢ়ভাবে বিশ্বাস করি যে এখন থেকে, আপনি এক্সেলে ডেটা অ্যানালিসিস টুলপ্যাক ব্যবহার করতে পারবেন। আপনার যদি কোনো প্রশ্ন বা পরামর্শ থাকে, তবে কমেন্ট সেকশনে শেয়ার করুন।
আমাদের ওয়েবসাইট Exceldemy.com ভুলবেন না দেখতে এক্সেল-সম্পর্কিত বিভিন্ন সমস্যা এবং সমাধানের জন্য। নতুন পদ্ধতি শিখতে থাকুন এবং বৃদ্ধি পেতে থাকুন!
সম্পর্কিত আর্টিকেল
- পিভট টেবিল ব্যবহার করে এক্সেলে ডেটা বিশ্লেষণ (৯ উপযুক্ত উদাহরণ)
- এক্সেলে টাইম-স্কেলড ডেটা বিশ্লেষণ (সহজ ধাপ সহ)
- এক্সেলে গুণগত ডেটা বিশ্লেষণ (সহজ ধাপ সহ)
- এক্সেলে qPCR ডেটা বিশ্লেষণ (২ সহজ পদ্ধতি)
- এক্সেলে টেক্সট ডেটা বিশ্লেষণ (৫ উপযুক্ত উপায়)
