

এক্সেল বেসিক মেশিন লার্নিং কাজের জন্য আশ্চর্য পরিমাণে শক্তিশালী একটি টুল। যদিও এটি একটি এমএল প্ল্যাটফর্ম নয়, তবে বিল্ট-ইন ফাংশন এবং সলভার ব্যবহার করে লিনিয়ার এবং লজিস্টিক রিগ্রেশন এর মতো মৌলিক এমএল কনসেপ্ট демонস্ট্রেট করার জন্য এটি কার্যকরভাবে ব্যবহার করা যায়।
এই টিউটোরিয়ালে, আমরা দেখব কিভাবে এক্সেলে সলভার এবং ফর্মুলা ব্যবহার করে লাইটওয়েট মেশিন লার্নিং মডেল তৈরি করা যায়।
- লিনিয়ার রিগ্রেশন: সतত মান প্রেডিক্ট করুন (সেলস রেভ뉴, হাউস প্রাইস, টেস্ট স্কোর, ইত্যাদি)।
- লজিস্টিক রিগ্রেশন: হ্যাঁ/না আউটকাম প্রেডিক্ট করুন (কাস্টমার পারচেস, লোন ডিফল্ট, মেডিক্যাল ডায়গনোসিস, পাস/ফেইল, ইত্যাদি)।
পূর্বশর্ত:
- মাইক্রোসফট এক্সেল (২০১৬ বা তার পরে রিকমেন্ডেড)।
- সলভার অ্যাড-ইন ইনেবল করুন।
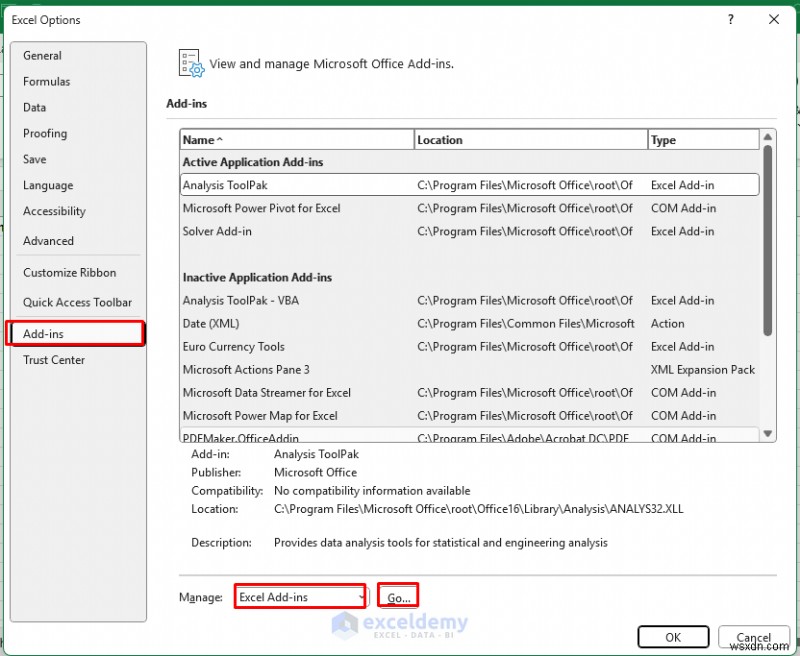
- ফাইল ট্যাবে যান >> অপশনস সিলেক্ট করুন >> অ্যাড-ইনস সিলেক্ট করুন >> এক্সেল অ্যাড-ইনস সিলেক্ট করুন।
- গো-এ ক্লিক করুন।
-
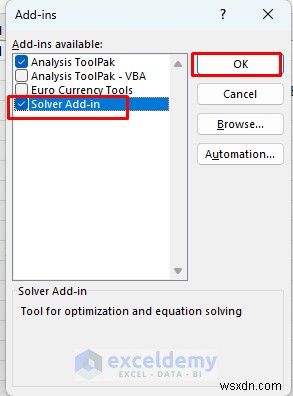
- সলভার অ্যাড-ইন সিলেক্ট করুন।
- OK-এ ক্লিক করুন।
- রিগ্রেশন কনসেপ্টের বেসিক বোঝাপড়া।
পার্ট ১: লিনিয়ার রিগ্রেশন মডেল
লিনিয়ার রিগ্রেশন ডেটা পয়েন্টের মাধ্যমে সেরা সোজা রেখা খুঁজে বের করে সতত সংখ্যাগত মান প্রেডিক্ট করে। আমরা একটি সহজ বিজনেস সিনেরিও মডেল করব যেখানে অ্যাডভারটাইজিং স্পেন্ড (X) সেলস রেভ뉴 (Y) প্রেডিক্ট করে। প্রতিটি ডেটা পয়েন্ট এক মাসের বিজনেস ডেটা উপস্থাপন করে।
স্টেপ ১: স্যাম্পল ডেটা সেটআপ
ইনপুট (হাজার টাকায় অ্যাডভারটাইজিং স্পেন্ড) এবং আউটপুট (হাজার টাকায় সেলস রেভ뉴) এর মধ্যে স্পষ্ট লিনিয়ার সম্পর্ক প্রদর্শন করে একটি বাস্তব ডেটাসেট তৈরি করুন।
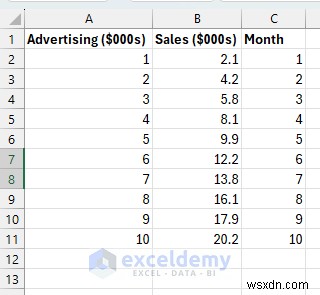
প্রতিটি সারি এক মাসের বিজনেস ডেটা উপস্থাপন করে। অ্যাডভারটাইজিং স্পেন্ড বাড়ার সাথে সাথে সেলস রেভিউও বাড়ে, কিন্তু পারফেক্টলি না (কিছু র্যান্ডমনেস আছে, যা বাস্তবসম্মত)।
স্টেপ ২: প্রেডিকশন ফর্মুলা তৈরি করুন
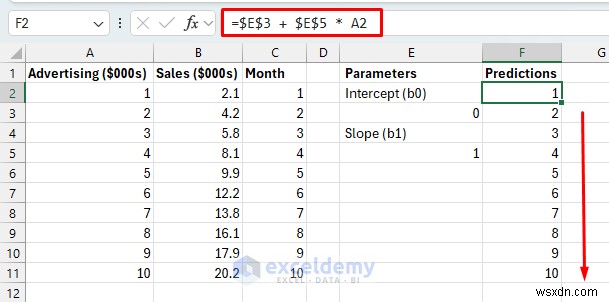
গাণিতিক "নব" সেটআপ করুন যা আমাদের মডেল অ্যাডজাস্ট করবে সেরা রেখা খুঁজে বের করার জন্য। লিনিয়ার রিগ্রেশনে, আমাদের দুটি প্যারামিটার দরকার:
- ইন্টারসেপ্ট (b0): রেখাটি Y-অক্ষকে কোথায় কাটে (০ ডলার অ্যাডভারটাইজিং-এ বেসলাইন সেলস)।
- স্লোপ (b1): প্রতি ১০০০ ডলার অ্যাডভারটাইজিং বৃদ্ধিতে সেলস কতটুকু বাড়ে।
মডেল প্যারামিটারগুলো আলাদা সেলে সেট আপ করুন:
মডেল প্যারামিটার:
Predicted Y = b0 + b1 * X
- ইন্টারসেপ্ট (b0)
- Initial value 0
- স্লোপ (b1)
- Initial value 1
আমরা এই লিনিয়ার ইকুয়েশন ব্যবহার করব অ্যাডভারটাইজিং স্পেন্ডের ভিত্তিতে সেলস প্রেডিক্ট করার জন্য। এটি মডেলের কোর, এবং এটি অ্যাডভারটাইজিং পরিমাণ নিয়ে সেলস কত হওয়া উচিত সেটা অনুমান করে।
গাণিতিক অর্থ:
- যদি b0 = 0.5 এবং b1 = 2 হয়, তবে ৩ হাজার ডলার অ্যাডভারটাইজিং খরচ করলে প্রেডিক্ট করে: 0.5 + 2*3 = ৬.৫ হাজার ডলার সেলস।
- মডেল ডেটা থেকে b0 এবং b1-এর সেরা মান শেখে।
প্রেডিকশন ফর্মুলা:
- একটি সেল সিলেক্ট করুন এবং নিচের ফর্মুলা ইনসার্ট করুন।
- এই ফর্মুলাটি F11 পর্যন্ত ড্র্যাগ ডাউন করুন।
স্টেপ ৪: রেজিডুয়াল এবং এরর ক্যালকুলেট করুন
আমাদের প্রেডিকশন কতটুকু ভুল সেটা পরিমাপ করুন। এটি অত্যন্ত গুরুত্বপূর্ণ কারণ মডেল এই এররগুলো মিনিমাইজ করার চেষ্টা করে শিখে।
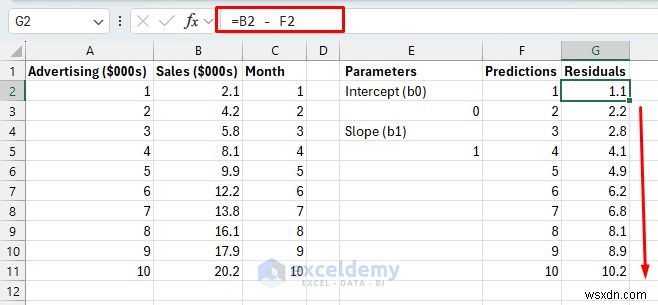
- রেজিডুয়ালস: প্রতিটি মাসের জন্য আসল সেলস এবং প্রেডিক্টেড সেলস এর পার্থক্য।
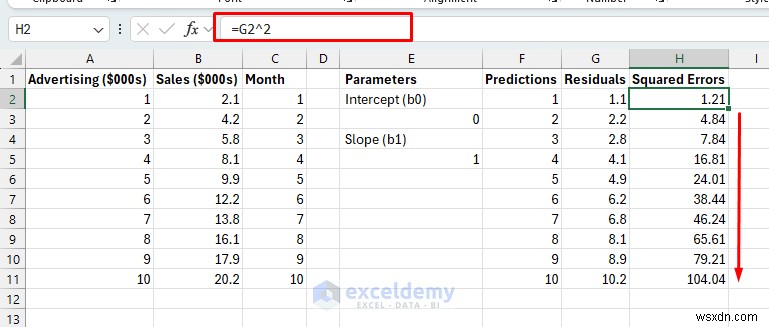
- স্কোয়ারড এরর: রেজিডুয়ালের বর্গ (সকল এরর পজিটিভ করার জন্য এবং বড় এররকে বেশি পেনালাইজ করার জন্য)।
রেজিডুয়ালস:
- G11 পর্যন্ত ফর্মুলা ড্র্যাগ ডাউন করুন।
স্কোয়ারড এরর:
- H11 পর্যন্ত ফর্মুলা ড্র্যাগ ডাউন করুন।
স্টেপ ৫: এরর মেট্রিক্স ক্যালকুলেট করুন
মডেল পারফরম্যান্সের বাইজনেস-অর্থবহ মেজারমেন্ট তৈরি করুন। এই মেট্রিক্স বোঝাতে সাহায্য করে যে মডেলটি রিয়েল-ওয়ার্ল্ড ব্যবহারের জন্য কতটুকু ভালো।
নির্দিষ্ট এলাকায় মূল মেট্রিক্স সেট আপ করুন:
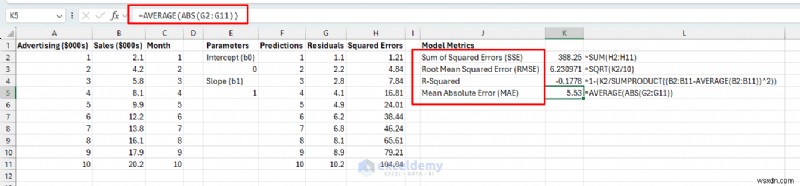
এরর মেট্রিক্স:
- Sum of Squared Errors (SSE): সকল প্রেডিকশনের মোট এরর - কমfaces ভালো।
- Root Mean Squared Error (RMSE): আসল ইউনিটে ($000s) গড় এরর - ইন্টারপ্রেট করা সহজ।
- R-Squared: অ্যাডভারটাইজিং দ্বারা ব্যাখ্যাযিত সেলস ভ্যারিয়েশনের শতাংশ (০-১০০%, বেশি ভালো)।
=1-(K2/SUMPRODUCT((B2:B11-AVERAGE(B2:B11))^2))
- Mean Absolute Error (MAE): গড় অ্যাবসোলিউট এরর - RMSE-এর চেয়ে আউটলায়ারের प्रति কম সংবেদনশীল।
স্টেপ ৬: সলভার ব্যবহার করে প্যারামিটার অপ্টিমাইজ করুন
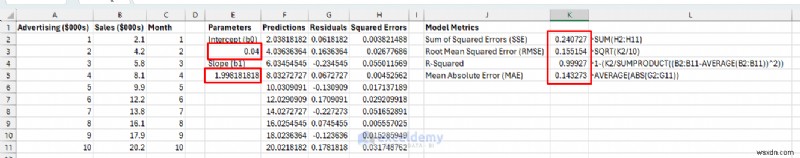
এক্সেলকে স্বয়ংক্রিয়ভাবে ইন্টারসেপ্ট এবং স্লোপের সেরা মান খুঁজে বের করতে দিন যা প্রেডিকশন এরর মিনিমাইজ করে।
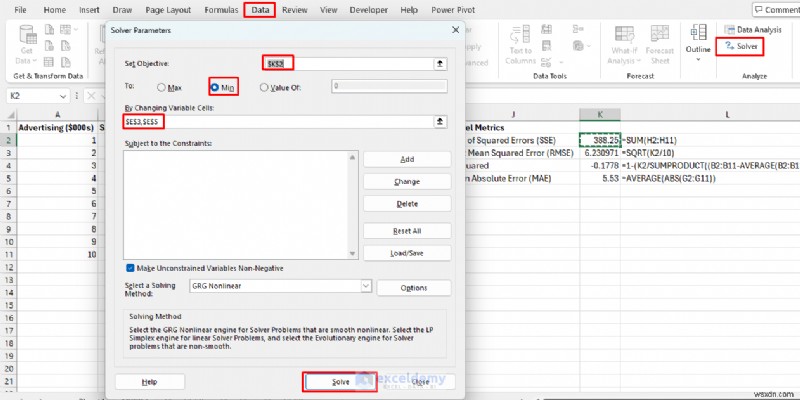
- ডেটা ট্যাবে যান >> সলভার সিলেক্ট করুন।
- Set Objective: K2 (SSE সেল)।
- To: Min।
- By Changing Variable Cells: E3,E5 (আপনার প্যারামিটার)।
- Solve-এ ক্লিক করুন।
- OK-এ ক্লিক করুন।
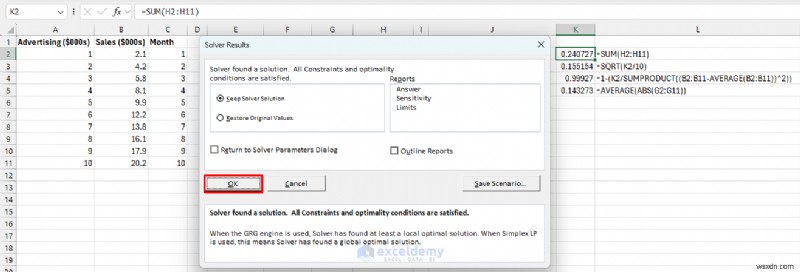
- এটি b0 এবং b1-এর মিলিয়ন মিলিয়ন ভিন্ন কম্বিনেশন চেষ্টা করে।
- প্রতিটি কম্বিনেশনের জন্য মোট এরর ক্যালকুলেট করে।
- সেরা কম্বিনেশন পাওয়া পর্যন্ত অ্যাডজাস্ট করতে থাকে।
- গেস করার চেয়ে এটি অনেক দ্রুত এবং সঠিক।
স্টেপ ৭: ভিজ্যুয়ালাইজেশন তৈরি করুন
মডেল ভিজ্যুয়ালি ভ্যালিডেট করা বুঝতেছি। চলুন দেখি প্রেডিকশন লাইনটি ডেটা পয়েন্টের কাছে কতটুকু পাস করে।
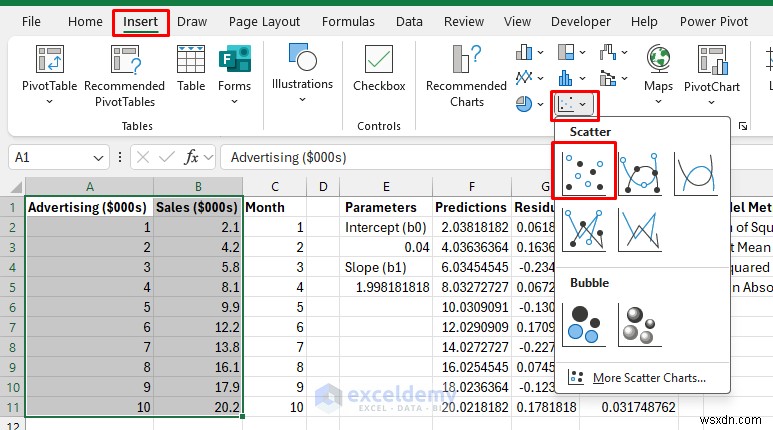
- Advertising এবং Sales কলাম সিলেক্ট করুন।
- ইনসার্ট ট্যাবে যান >> Charts থেকে Scatter Plot সিলেক্ট করুন।
- চার্টে রাইট-ক্লিক করুন >> Data সিলেক্ট করুন >> Add Series সিলেক্ট করুন।
- Series Name: F1 সেল সিলেক্ট করুন।
- Series X Values: X-ভ্যালু সিলেক্ট করুন (যেমন: B2:B11)
- Series Y Values: ক্লিক করে প্রেডিক্টেড ভ্যালু F2:F11 সিলেক্ট করুন।
- প্রেডিকশন সিরিজকে লাইন হিসেবে ফরম্যাট করুন।
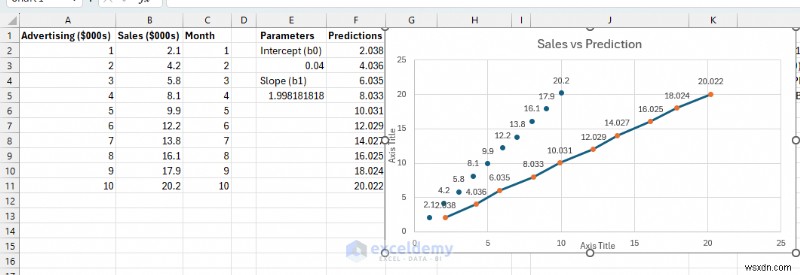
- প্রেডিকশন লাইন ডেটা পয়েন্টের সাধারণ ট্রেন্ড ফলো করে।
- পয়েন্টগুলো লাইনের চারপাশে ছড়ানো (সব উপরে বা নিচে না)।
- রেজিডুয়ালসে কোনো অভাসযোগ্য প্যাটার্ন নেই।
পার্ট ২: লজিস্টিক রিগ্রেশন মডেল
লজিস্টিক রিগ্রেশন হ্যাঁ/না সিদ্ধান্তের জন্য প্রোবাবিলিটি প্রেডিক্ট করে। লিনিয়ার রিগ্রেশন যেহেতু এক্স্যাক্ট নম্বর প্রেডিক্ট করে, লজিস্টিক রিগ্রেশন কিছু ঘটার সম্ভাবনা প্রেডিক্ট করে (০-১০০%)।
স্টেপ ১: বাইনারি ক্লাসিফিকেশন ডেটা প্রস্তুত করুন
চলুন কাস্টমার পারচেস বিহেভিওর মডেল করি। কাস্টমার ইনকাম লেভেল (X) এর ভিত্তিতে, আমরা প্রেডিক্ট করতে চাই তারা আমাদের প্রিমিয়াম প্রোডাক্ট কিনবে (১) কিনা (০)। এটি মার্কেটিং টার্গেটিং, মেডিক্যাল ডায়গনোসিস, বা যেকোনো বাইনারি সিদ্ধান্তের জন্য টিপিক্যাল।
লজিস্টিক রিগ্রেশনের জন্য ডেটা সেট আপ করুন:
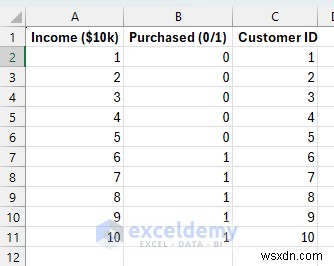
কাস্টমার ইনকাম লেভেল (১০ হাজার ডলার ইউনিটে) এবং পারচেস সিদ্ধান্ত। লক্ষ্য করুন কিভাবে কম ইনকাম वाले কাস্টমার (১-৫) কিনে না (০), আর বেশি ইনকাম والے কাস্টমার (৬-১০) কিনে (১)। এটি বাস্তব পারচেসিং প্যাটার্ন প্রতিফলিত করে।
স্টেপ ২: লজিস্টিক প্রেডিকশন ফর্মুলা তৈরি করুন
লজিস্টিক মডেল প্যারামিটার ইনিশিয়ালাইজ করুন:
লজিস্টিক ফাংশনের জন্য প্যারামিটার সেট আপ করুন। লিনিয়ার রিগ্রেশনের বিপরীতে, এই প্যারামিটারগুলো একটি আরও জটিল গাণিতিক ট্রান্সফরমেশন (সিগময়েড ফাংশন) দিয়ে কাজ করে।
- ইন্টারসেপ্ট (b0): থ্রেশহোল্ড বাম বা ডানে শিফট করে (যেখানে ৫০% প্রোবাবিলিটি হয়)।
- স্লোপ (b1): কতটুকু স্টিপ "অনলাইকлі" থেকে "লাইক্লি" ট্রানজিশন সেটা কন্ট্রোল করে।
- শুরু মান: আমরা যুক্তিসঙ্গত অনুমান দিয়ে শুরু করি; সলভার সেগুলো অপ্টিমাইজ করবে।
লজিস্টিক প্যারামিটার:
Probability = 1 / (1 + e^(-(b0 + b1×X)))
- ইন্টারসেপ্ট (b0)
- -2 (Initial value)
- স্লোপ (b1)
- 0.5 (Initial value)
লজিস্টিক প্রেডিকশন ফর্মুলা তৈরি করুন:
লিনিয়ার কম্বিনেশনকে সিগময়েড ফাংশন ব্যবহার করে প্রোবাবিলিটিতে রূপান্তর করুন। এটি वो গাণিতিক জাদু যা প্রেডিকশনকে ০ এবং ১-এর মধ্যে রাখে।
- লিনিয়ার কম্বিনেশন: b0 + b1*X (লিনিয়ার রিগ্রেশনের মতোই)।
- সিগময়েড ট্রান্সফরম: 1/(1+e^(-(লিনিয়ার কম্বিনেশন))) যেকোনো সংখ্যাকে ০-১ রেঞ্জে রূপান্তর করে।
- ফলাফল: একটি স্মুথ S-কার্ভ যা প্রোবাবিলিটি উপস্থাপন করে। যদি প্রোবাবিলিটি ০.৭ হয়, তবে ৭০% চান্স এই কাস্টমার কিনবে।
প্রোবাবিলিটি প্রেডিকশন:
- লিনিয়ার কম্বিনেশন:
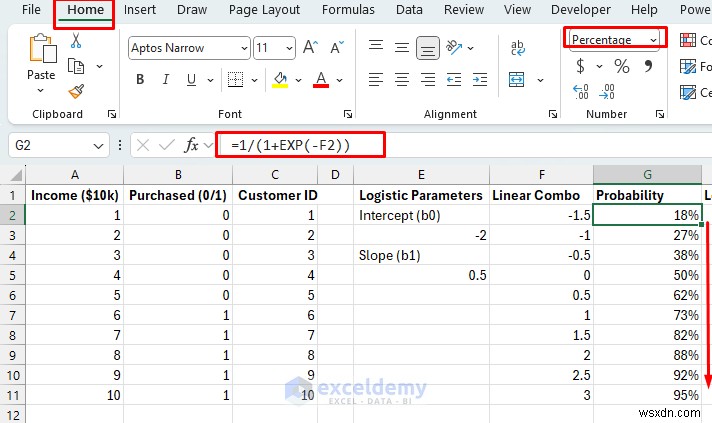
- প্রোবাবিলিটি প্রেডিকশন:
- সেলগুলোকে Percentage (%) হিসেবে ফরম্যাট করুন।
স্টেপ ৪: লগ-লাইকলিহуд ক্যালকুলেট করুন
আমাদের প্রোবাবিলিটি প্রেডিকশন কতটুকু আসল আউটকামের সাথে মেলে সেটা পরিমাপ করুন। এটি সিম্পল এরর চেয়ে জটিল কারণ আমরা প্রোবাবিলিটি নিয়ে কাজ করছি, এক্স্যাক্ট ভ্যালু নিয়ে না।
লগ-লাইকলিহуд কম্পোনেন্ট:
=IF(B2=1,LN(MAX(G2,0.0001)),LN(MAX(1-G2,0.0001)))
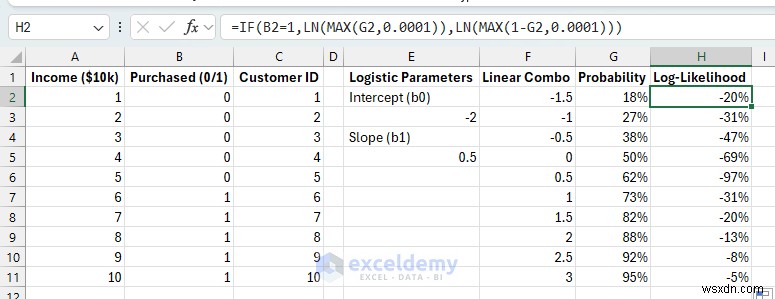
- বাইনারি আউটকামের জন্য, আমরা সিম্পল সাবট্র্যাকশন (actual - predicted) ব্যবহার করতে পারি না।
- বদলে, আমরা পরিমাপ করি আমরা আসল আউটকাম देखकर কতটুকু "আশ্চর্য" হয়েছি আমাদের প্রেডিকশন দিয়ে।
- যদি আমরা ৯০% পারচেস চান্স প্রেডিক্ট করি এবং কাস্টমার কিনে, আমরা আশ্চর্য হয়নি (ভালো মডেল)।
- যদি আমরা ১০% পারচেস চান্স প্রেডিক্ট করি এবং কাস্টমার কিনে, আমরা খুব আশ্চর্য হয়েছি (খারাপ মডেল)।
স্টেপ ৫: লজিস্টিক মডেল মেট্রিক্স সেট আপ করুন
ক্লাসিফিকেশন পারফরম্যান্সের বাইজনেস-রিলেভেন্ট মেজার তৈরি করুন। এই মেট্রিক্স হেল্প করে ডিসাইড করতে যে মডেলটি রিয়েল বাইজনেস সিদ্ধান্তের জন্য কতটুকু ভালো।
হাই প্রিসিশন মানে কম বর্জিত মার্কেটিং ডলার (Low false positives)। হাই রিকল মানে আমরা পোটেনশিয়াল কাস্টমার মিস করছি না (Low false negatives)।
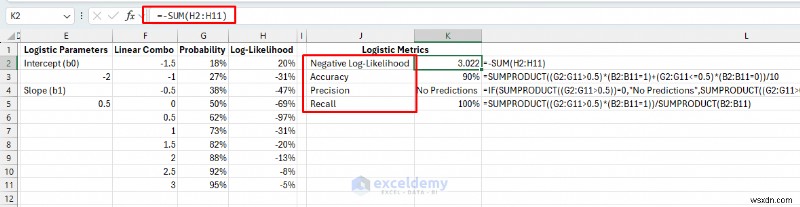
লজিস্টিক মেট্রিক্স:
- মডেল ফিট/নেগেটিভ লগ-লাইকলিহুড: কম মান মানে ভালো প্রোবাবিলিটি প্রেডিকশন।
- অ্যাকুরেসি: সঠিকভাবে ক্লাসিফাইড কাস্টমারের শতাংশ (যদি আমরা ৫০% কাট-অফ ব্যবহার করি)।
=SUMPRODUCT((G2:G11>0.5)*(B2:B11=1)+(G2:G11<=0.5)*(B2:B11=0))/10
- প্রিসিশন: আমরা যেসব কাস্টমার কিনবে বলে প্রেডিক্ট করেছি, 그중 কতটুকু আসলে কিনেছে?
=IF(SUMPRODUCT((G2:G11>0.5))=0,"No Predictions",SUMPRODUCT((G2:G11>0.5)*(B2:B11=1))/SUMPRODUCT((G2:G11>0.5)))
- রিকল: যেসব কাস্টমার কিনেছে, 그중 কতটুকু আমরা আইডেন্টিফাই করেছি?
=SUMPRODUCT((G2:G11>0.5)*(B2:B11=1))/SUMPRODUCT(B2:B11)
স্টেপ ৬: সলভার দিয়ে লজিস্টিক মডেল অপ্টিমাইজ করুন
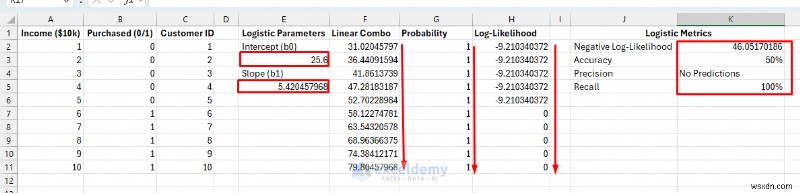
ডেটার প্রোবাবিলিটি প্যাটার্নে সেরা ফিট করার প্যারামিটার মান খুঁজে বের করুন। সলভার নেগেটিভ লগ-লাইকলিহুড মিনিমাইজ করে, যা আসল ডেটা পর্যবেক্ষণ করার প্রোবাবিলিটি ম্যাক্সিমাইজ করে।
- ডেটা ট্যাবে যান >> সলভার সিলেক্ট করুন।
- Set Objective: K2 (Negative Log-Likelihood)।
- To: Min।
- By Changing Variable Cells: E3,E5।
- Solve-এ ক্লিক করুন।
সাধারণ সমস্যা সমাধান
- সলভার কনভার্জ না করলে: ভিন্ন ইনিশিয়াল মান চেষ্টা করুন বা ইটেরেশন বাড়ান।
- নেগেটিভ R-স্কোয়ার্ড: ডেটা এন্ট্রি এরর বা মডেল স্পেসিফিকেশন চেক করুন।
- লজিস্টিকে পারফেক্ট সেপারেশন: ফিচার ভ্যালু কমান বা রেগুলারাইজেশন যোগ করুন।
উপসংহার
এই টিউটোরিয়ালটি এক্সেলে সরাসরি মেশিন লার্নিং মডেল বানানোর ধাপে ধাপে প্রক্রিয়া দেখায়। এক্সেলের সলভার এবং বেসিক ফর্মুলা ব্যবহার করে, আপনি দ্রুত এই লাইটওয়েট এমএল মডেল ইম্প্লিমেন্ট করতে পারেন, প্রেডিকশন ভিজ্যুয়ালাইজ করতে পারেন, এবং একটি সহজ কিন্তু গভীর পদ্ধতিতে মডেল একুরেসি বোঝা পারেন। এখানে দেখানো টেকনিকগুলো আরও জটিল সিনেরিওতে প্রসারিত করা যায় এবং রিগ্রেশন কনসেপ্ট শিখার জন্য শিক্ষামূলক টুল হিসেবে কাজ করতে পারে।
