

“সাদगी চরম সফিস্টিকেশন”—লিওনার্দো দা ভিন্সি
“অधিকাংশ তথ্য অপ্রাসঙ্গিক এবং অধিকাংশ প্রচেষ্টা বর্জিত, তবে শুধু বিশেষজ্ঞ জানে কী উপেক্ষা করব”—জেমস ক্লিয়ার, Atomic Habits
আপনার একটি ফ্যান্সি ডেটা পাইপলাইন আছে অনেক আলাদা সিস্টেমের সাথে। এটি বাইরে থেকে খুব সফিস্টিকেটেড লাগে, কিন্তু হুডের নিচে আসলে একটি কমপ্লেক্স মেস। এটিকে হতে পারে খুব সারা প্লাম্বিং কাজ লাগে বিভিন্ন পিস কানেক্ট করতে, হতে পারে কনস্ট্যান্ট মনিটরিং লাগে, হতে পারে একটি বড় টিম লাগে যুনিক এক্সপার্টাইজ সহ রান, ডিবাগ এবং ম্যানেজ করতে। না বললেই চলে, जितني বেশি সিস্টেম ব্যবহার করবেন, তত বেশি জায়গায় আপনি আপনার ডেটা ডুপ্লিকেট করবেন এবং তত বেশি সুযোগ থাকবে সেটি আউট-অফ-সিন্ক বা স্টেল হওয়ার। Bürde, যেহেতু এই সাবসিস্টেমগুলো আলাদা কোম্পানিগুলো দ্বারা স্বতন্ত্রভাবে ডেভেলপড হয়েছে, তাদের আপগ্রেড বা বাগ ফিক্স আপনার পাইপলাইন এবং ডেটা লেয়ার ভাঙতে পারে।
আপনি যদি সতর্ক না হন, তবে নিচের তিন মিনিটের ভিডিওতে চিত্রিত পরিস্থিতিতে পড়তে পারেন। আমি পরামর্শ দিই এগিয়ে যাওয়ার আগে এটি দেখুন।
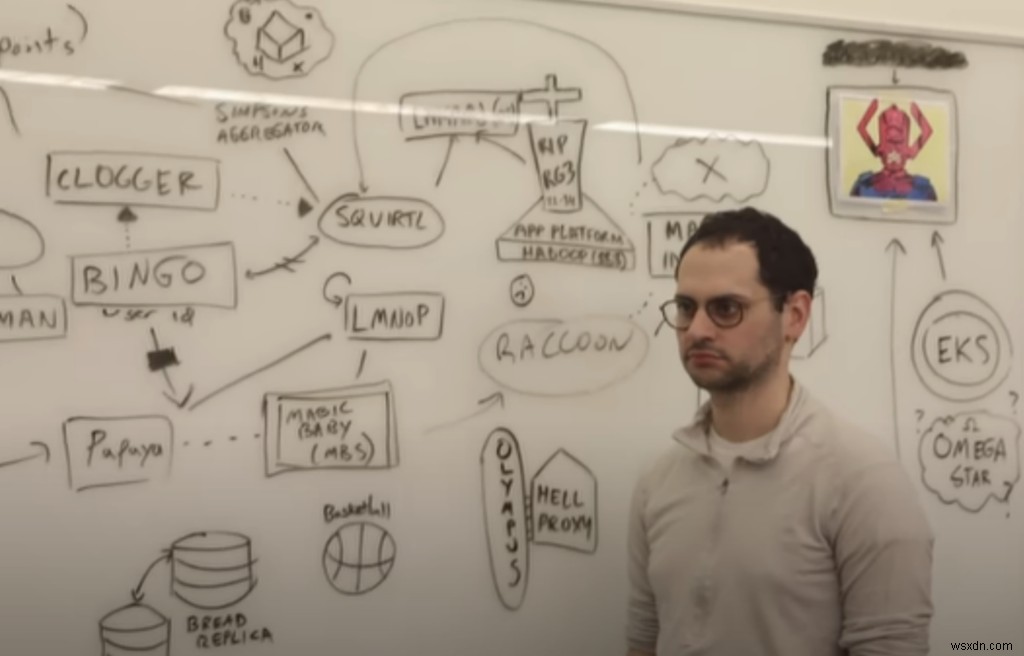
জটিলতা উদ্ভূত হয় কারণ যদিও প্রতিটি সিস্টেম বাইরে থেকে সিম্পল লাগতে পারে, তারা আসলে নিচের ভেরিয়েবলগুলো আপনার পাইপলাইনে আনে এবং এক টন জটিলতা যোগ করতে পারে:
- প্রোটোকল — সিস্টেম ডেটা কীভাবে ট্রান্সপোর্ট করে? (HTTP, TCP, REST, GraphQL, FTP, JDBC)
- ডেটা ফরম্যাট — সিস্টেম কোন ফরম্যাট সাপোর্ট করে? (বাইনারি, CSV, JSON, Avro)
- ডেটা স্কিমা এবং ইভোলিউশন — ডেটা কীভাবে স্টোর হয়? (টেবিল, স্ট্রিমস, গ্রাফ, ডকুমেন্ট)
- SDKs এবং APIs — সিস্টেম প্রয়োজনীয় SDKs এবং APIs প্রদান করে কিনা?
- ACID এবং BASE — এটি ACID বা BASE কনসিস্টেন্সি প্রদান করে কিনা?
- মাইগ্রেশন — সিস্টেম সকল ডেটা ইন বা আউট মাইগ্রেট করার সহজ পথ দেয় কিনা?
- ডিউরাবিলিটি — ডিউরাবিলিটির চারপাশে সিস্টেমের কী গ্যারান্টি রয়েছে?
- অভিলেবিলিটি — উপলব্ধতার চারপাশে সিস্টেমের কী গ্যারান্টি রয়েছে? (৯৯.৯%, ৯৯.৯৯৯%)
- স্কেলেবিলিটি — এটি কীভাবে স্কেল করে?
- নিরাপত্তা — সিস্টেম কতটা নিরাপদ?
- পারফরম্যান্স — ডেটা প্রসেসিং-এ সিস্টেম কত দ্রুত?
- হোস্টিং অপশন — হোস্টেড কিনা অথবা অন-প্রেমাইস ওনলি বা মিক্সড?
- ক্লাউডস — এটি আমার ক্লাউড, রিজন, ইত্যাদিতে কাজ করে কিনা?
- অতিরিক্ত সিস্টেম — এটি একটি অতিরিক্ত সিস্টেম দরকার কিনা? (যেমন Kafka-এর জন্য Zookeeper)
ডেটা ফরম্যাট, স্কিমা এবং প্রোটোকল এরকম ভেরিয়েবলগুলো যোগ হয় যা কে বলা হয় "ট্রান্সফরমেশনাল ওভারহেড।" অন্যান্য ভেরিয়েবল যেমন পারফরম্যান্স, ডিউরাবিলিটি এবং স্কেলেবিলিটি যোগ হয় "পাইপলাইন ওভারহেড"-এ। একসাথে, এই ক্লাসিফিকেশনগুলো অবদান রাখে যাকে "ইমপিড্যান্স মিসম্যাচ" বলা হয়। যদি আমরা সেটি মাপতে পারি, তবে আমরা কমপ্লেক্সিটি ক্যালকুলেট করতে পারি এবং সেটি ব্যবহার করে আমাদের সিস্টেম সিম্পলিফাই করতে পারি। আমরা সেটির ওপর আসব।
এখন, আপনি যুক্তি দিতে পারেন যে আপনার সিস্টেম, যদিও এটা কমপ্লেক্স লাগতে পারে, আসলে আপনার প্রয়োজনের জন্য সিম্পলেস্ট সিস্টেম। কিন্তু আপনি কীভাবে তা প্রুফ করবেন?
অন্য কথায়, আপনি কীভাবে বাস্তবে মাপতে পারেন এবং বলতে পারেন আপনার ডেটা লেয়ার সত্যিকারের সিম্পল নাকি কমপ্লেক্স? এবং দ্বিতীয়ত, আপনি কীভাবে অনুমান করতে পারেন আপনার সিস্টেম ভবিষ্যতে সিম্পল থাকবে কিনা যতক্ষণ আপনি আরও ফিচার যোগ করবেন? অর্থাৎ, আপনি আপনার রোডম্যাপে আরও ফিচার যোগ করলে, কি আপনাকে আরও সিস্টেম যোগ করতে হবে?
সেটাই হলো "ইমপিড্যান্স মিসম্যাচ টেস্ট,"। কিন্তু আগে দেখি ইমপিড্যান্স মিসম্যাচ আসলে কী এবং তারপর টেস্টটিতে যাব।
ইমপিড্যান্স মিসম্যাচ কী?
এই টার্মটি ইলেকট্রিক্যাল ইঞ্জিনিয়ারিং-এ উদ্ভূত হয়েছে ইলেকট্রিক্যাল ইমপিড্যান্সের মিসম্যাচ ব্যাখ্যা করতে, যা ফলাফলে এনার্জি লস হয় যখন এনার্জি পয়েন্ট A থেকে পয়েন্ট B-এ ট্রান্সফার হয়।
সহজ কথায়, এর মানে হলো আপনার যা আছে সেটি আপনার যা দরকার সেটির সাথে মেলে না। এটিকে ব্যবহার করতে, আপনি আপনার যা আছে সেটি নিন, আপনার যা দরকার সেটির মতো ট্রান্সফর্ম করুন, এবং তারপর ব্যবহার করুন। এতেই একটি মিসম্যাচ এবং মিসম্যাচ ফিক্স করার সাথে জড়িত একটি ওভারহেড রয়েছে।
আমাদের কেসে, আপনার ডেটা কোনো ফর্ম বা কোয়ান্টিটিতে আছে, এবং ব্যবহার করার আগে আপনাকে সেটি ট্রান্সফর্ম করতে হয়। ট্রান্সফরমেশনটি একাধিক বার হতে পারে এবং হয়তো মাঝপথে একাধিক সিস্টেম ব্যবহার করতে হয়।
ডেটাবেজের ওয়ার্ল্ডে, ইমপিড্যান্স মিসম্যাচ দুটি কারণে হয়:
- ট্রান্সফরমেশনাল ওভারহেড: সিস্টেম ডেটা প্রসেস বা স্টোর করার পদ্ধতি সেটি থেকে আলাদা যা ডেটা আসলে দেখতে পায়, বা আপনি সেটি কীভাবে ভাবেন। উদাহরণস্বরূপ: আপনার সার্ভারে, আপনার ডেটা অনেক ডেটা স্ট্রাকচারে স্টোর করার ফ্লেক্সিবিলিটি রয়েছে, যেমন কলেকশন, স্ট্রিমস, লিস্টস, সেটস, অ্যারে, ইত্যাদি। এটি আপনাকে আপনার ডেটা স্বাভাবিকভাবে মডেল করতে সাহায্য করে। তবে, আপনাকে সেটি RDBMS-এ টেবিল বা JSON ডকুমেন্ট স্টোরে ম্যাপ করতে হয় সেগুলো স্টোর করতে। তারপর রিড করার জন্য বিপরীত কাজ করতে হয়। নোট করুন যে অবজেক্ট-ওরিয়েন্টেড ল্যাঙ্গুয়েজ মডেল এবং রিলেশনাল টেবিল মডেলের মধ্যে নির্দিষ্ট মিসম্যাচটি পরিচিত, "Object-relational impedance mismatch."
- পাইপলাইন ওভারহেড: সার্ভারে আপনি যে পরিমাণ এবং ধরনের ডেটা প্রসেস করেন সেটি আপনার ডেটাবেজ যে পরিমাণ ডেটা হ্যান্ডেল করতে পারে সেটির থেকে আলাদা। উদাহরণস্বরূপ: যদি আপনি মোবাইল ডিভাইস থেকে আসা মিলিয়ন মিলিয়ন ইভেন্ট প্রসেস করেন, আপনার টিপিক্যাল RDBMS বা ডকুমেন্ট স্টোর সেটি স্টোর করতে পারেনা, বা সহজে অগ্রিগেট বা ক্যালকুলেট করার API দিতে পারেনা। তাই আপনাকে স্পেশাল স্ট্রিম-প্রসেসিং সিস্টেম দরকার, যেমন Kafka বা Redis Streams, সেটি প্রসেস করতে এবং হয়তো একটি ডেটা ওয়ারহাউস স্টোর করতে।
ইমপিড্যান্স মিসম্যাচ টেস্ট
টেস্টের লক্ষ্য হলো ওভারঅল প্ল্যাটফর্মের কমপ্লেক্সিটি মাপা এবং ভবিষ্যতে আরও ফিচার যোগ করলে কমপ্লেক্সিটি বড়বে কিনা সেটি নির্ধারণ করা।
টেস্টটি কীভাবে কাজ করে সেটি হলো সহজে "ট্রান্সফরমেশনাল ওভারহেড" এবং "পাইপলাইন ওভারহেড" ক্যালকুলেট করা একটি "ইমপিড্যান্স মিসম্যাচ স্কোর" (IMS) ব্যবহার করে। এটি আপনাকে বলবে আপনার সিস্টেম ইতিমধ্যে অন্যান্য সিস্টেমের সাপেক্ষে কমপ্লেক্স কিনা, এবং ওই কমপ্লেক্সিটি সময়ের সাথে সাথে বড়ছে কিনা যতক্ষণ আপনি আরও ফিচার যোগ করছেন।
IMS ক্যালকুলেট করার ফর্মুলা:

ফর্মুলাটি সহজে দুটি টাইপের ওভারহেড যোগ করে এবং তারপর ফিচারের সংখ্যা দিয়ে ভাগ করে। এইভাবে, আপনাকে মোট ওভারহেড/ফিচার পাওয়া যাবে (অর্থাৎ কমপ্লেক্সিটি স্কোর)।
এটিকে ভালোভাবে বুঝতে, চলুন চারটি ভিন্ন সিম্পল ডেটা পাইপলাইন তুলনা করি এবং তাদের স্কোর ক্যালকুলেট করি। এবং দ্বিতীয়ত, চলুন কল্পনা করি আমরা একটি সিম্পল অ্যাপ দুই ফেজে বিল্ড করছি, যাতে আমরা দেখতে পাই IMS স্কোর কীভাবে পরিবর্তন হয় যতক্ষণ আমরা আরও ফিচার যোগ করি।
ফেজ ১: একটি রিয়েল-টাইম ড্যাশবোর্ড বিল্ড করা
মান लीজিয়ে আপনি মোবাইল ডিভাইস থেকে মিলিয়ন মিলিয়ন বাটন-ক্লিক ইভেন্ট পাচ্ছেন এবং আপনাকে একটি এলার্ট দরকার যদি কোনো ড্রপ বা স্পাইক থাকে। অतरিক্তভাবে, আপনি এই পুরো জিনিসকে আপনার বড় অ্যাপ্লিকেশনের একটি ফিচার হিসেবে বিবেচনা করছেন।
কেস ১: মনে করুন আপনি শুধু একটি RDBMS ব্যবহার করলেন এই ইভেন্টগুলো স্টোর করতে, যদিও টেবিলগুলো ফিট নাও করতে পারে।
- ট্রান্সফরমেশনাল ওভারহেড = ১
- আপনাকে ইভেন্ট স্ট্রিমকে টেবিলে ট্রান্সফর্ম করতে হবে।
- পাইপলাইন ওভারহেড = ১
- আপনার পাইপলাইনে একটি সিঙ্গেল DB রয়েছে।
- ফিচারের সংখ্যা = ১
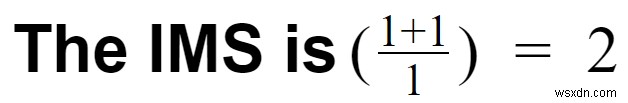
কেস ২: মনে করুন আপনি Kafka ব্যবহার করলেন এই ইভেন্টগুলো প্রসেস করতে এবং তারপর RDBMS-এ স্টোর করলেন।
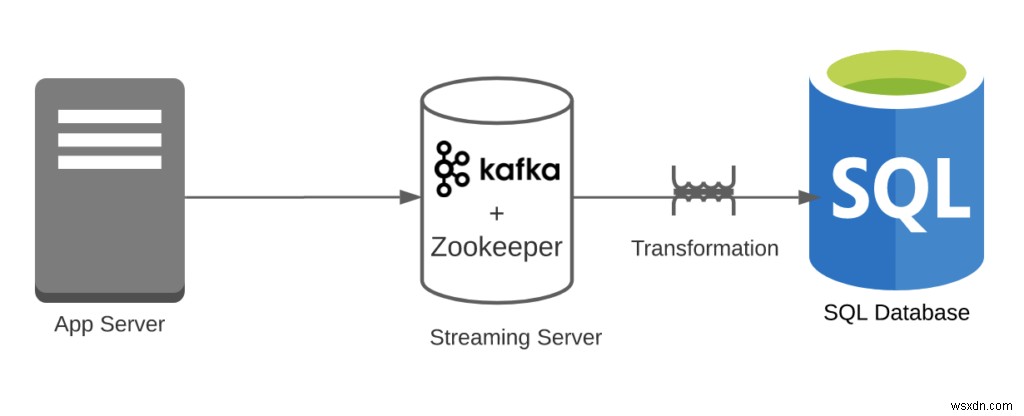
- ট্রান্সফরমেশনাল ওভারহেড = ১
- Kafka সহজে ক্লিক স্ট্রিম হ্যান্ডেল করতে পারে; যাঁহাৎ, Kafka থেকে RDBMS-এ একটি ওভারহেড রয়েছে।
- পাইপলাইন ওভারহেড = ২
- আপনার দুটি সিস্টেম রয়েছে (RDBMS এবং Kafka)। নোট করুন যে আমরা Zookeeper উপেক্ষা করছি।
- ফিচারের সংখ্যা = ১
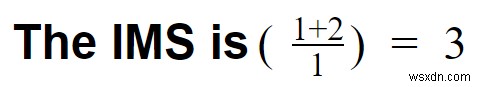
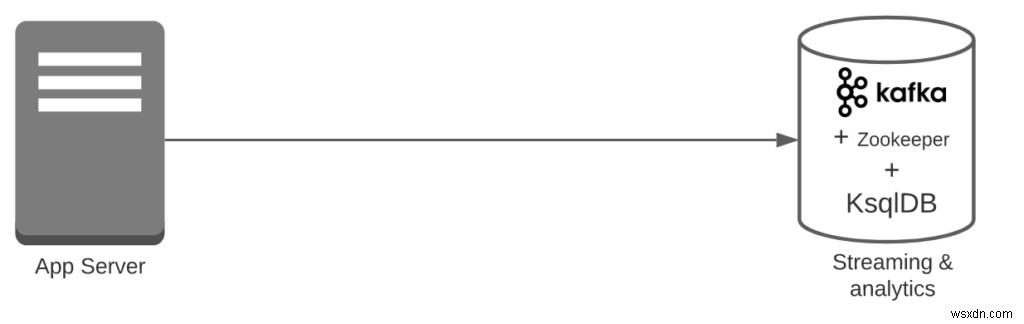
কেস ৩: মনে করুন আপনি Kafka ব্যবহার করলেন এই ইভেন্টগুলো প্রসেস করতে এবং তারপর KsqlDB-এ স্টোর করলেন।
- ট্রান্সফরমেশনাল ওভারহেড = ০
- Kafka সহজে ক্লিক স্ট্রিম হ্যান্ডেল করতে পারে
- পাইপলাইন ওভারহেড = ১
- আপনার শুধু একটি সিস্টেম রয়েছে (Kafka + KSqlDB)। নোট করুন যে আমরা Zookeeper উপেক্ষা করছি।
- ফিচারের সংখ্যা = ১
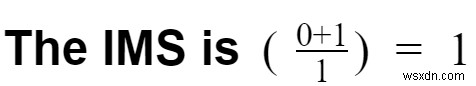
কেস ৪: মনে করুন আপনি Redis Streams ব্যবহার করলেন এই ইভেন্টগুলো প্রসেস করতে এবং তারপর RedisTimeSeries-এ স্টোর করলেন (দুটোই Redis-এর অংশ এবং Redis-র সাথে নেটিভলি কাজ করে)।
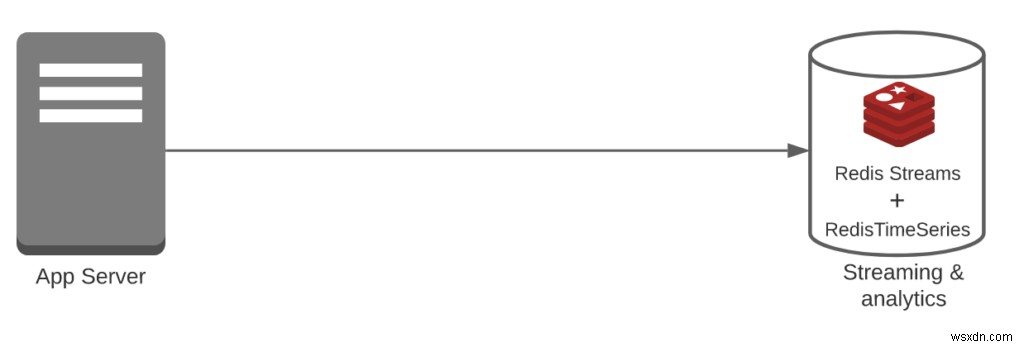
- ট্রান্সফরমেশনাল ওভারহেড = ০
- Redis Streams সহজে ক্লিক স্ট্রিম হ্যান্ডেল করতে পারে
- পাইপলাইন ওভারহেড = ১
- আপনার শুধু একটি সিস্টেম রয়েছে (Redis Streams + RedisTimeSeries)
- ফিচারের সংখ্যা = ১
ফেজ ১-এর পর নিষ্কর্ষ:
আমরা এই উদাহরণে চারটি সিস্টেম তুলনা করেছি এবং পেয়েছি যে "কেস ৩" বা "কেস ৪" সিম্পলেস্ট IMS ১-এ। এই পয়েন্টে, তারা দুটোই একই, কিন্তু কি তারা একই থাকবে যখন আমরা আরও ফিচার যোগ করব?
আমাদের সিস্টেমে আরও ফিচার যোগ করি এবং দেখি IMS কীভাবে টিকে থাকে।
ফেজ ২: IP-Whitelisting সহ একটি রিয়েল-টাইম ড্যাশবোর্ড বিল্ড করা
মান করুন আপনি একই অ্যাপ বিল্ড করছেন কিন্তু নিশ্চিত করতে চান সেগুলো শুধু হোয়াইট-লিস্টেড IP অ্যাড্রেস থেকে আসছে। এখন আপনি একটি নতুন ফিচার যোগ করছেন।
কেস ১: মনে করুন আপনি শুধু RDBMS ব্যবহার করলেন এই ইভেন্টগুলো স্টোর করতে, যদিও টেবিলগুলো ফিট নাও করতে পারে এবং IP-whitelisting-এর জন্য Redis বা MemCached ব্যবহার করলেন।
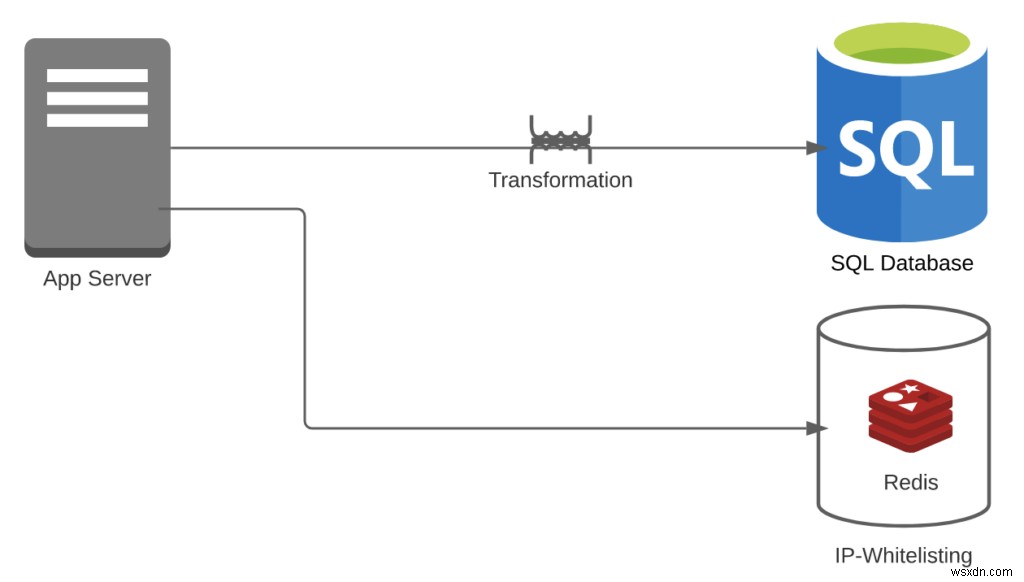
- ট্রান্সফরমেশনাল ওভারহেড = ১
- IP-whitelisting-এর জন্য, আপনাকে কোনো ট্রান্সফরমেশন দরকার নেই। যাঁহাৎ, আপনাকে ইভেন্ট স্ট্রিমকে টেবিলে ট্রান্সফর্ম করতে হবে
- পাইপলাইন ওভারহেড = ২
- আপনার Redis + RDBMS রয়েছে
- ফিচারের সংখ্যা = ২
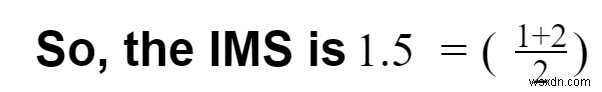
কেস ২: মনে করুন আপনি Redis + Kafka + RDBMS ব্যবহার করছেন।
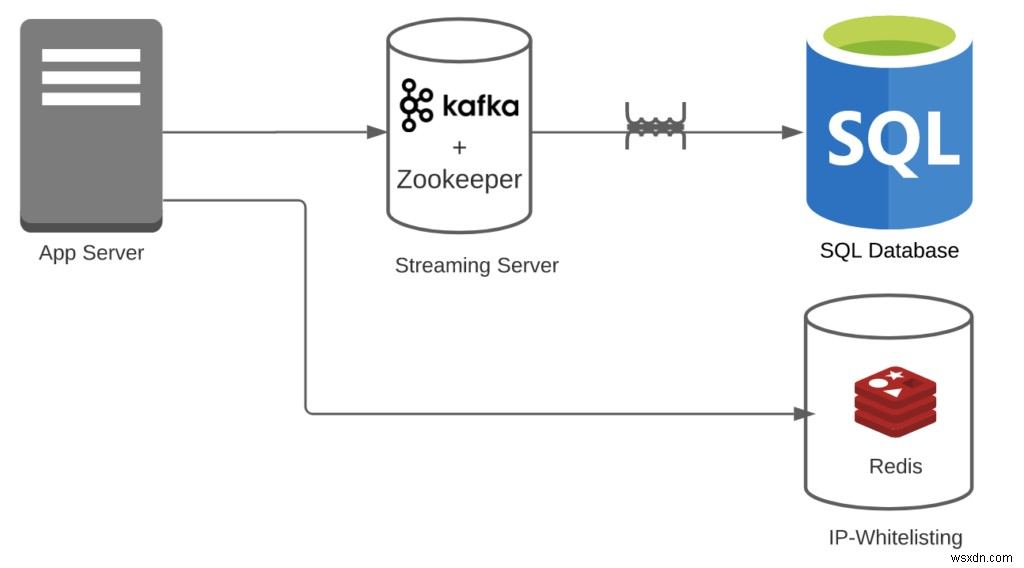
- ট্রান্সফরমেশনাল ওভারহেড = ১
- IP-whitelisting-এর জন্য, আপনাকে কোনো ট্রান্সফরমেশন দরকার নেই। আর Kafka সহজে স্ট্রিমস হ্যান্ডেল করতে পারে।
- পাইপলাইন ওভারহেড = ৩
- আপনার Redis + Kafka + RDBMS রয়েছে। নোট: আমরা উপেক্ষা করছি যে Kafka-রও Zookeeper দরকার। যদি সেটি যোগ করলে, নাম্বার আরও কম হবে।
- ফিচারের সংখ্যা = ২
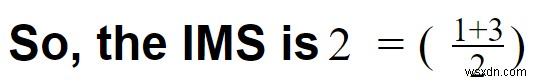
কেস ৩: মনে করুন আপনি Redis + Kafka + KsqlDB ব্যবহার করছেন।
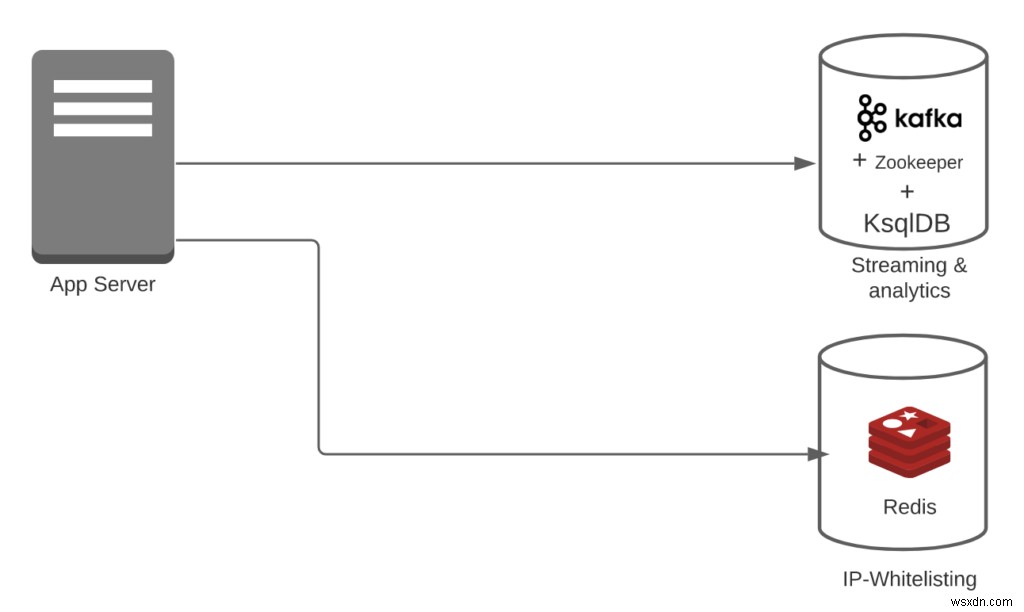
- ট্রান্সফরমেশনাল ওভারহেড = ০
- IP-whitelisting-এর জন্য, আপনাকে কোনো ট্রান্সফরমেশন দরকার নেই। আর Kafka এবং KsqlDB সহজে স্ট্রিমস হ্যান্ডেল করতে পারে।
- পাইপলাইন ওভারহেড = ২
- আপনার Redis + (Kafka + KsqlDB) রয়েছে। নোট: এই কেসে, আমরা Kafka + KsqlDB একই সিস্টেমের অংশ হিসেবে বিবেচনা করছি।
- ফিচারের সংখ্যা = ২
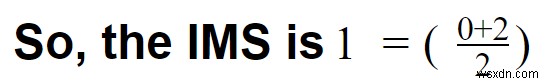
কেস ৪: মনে করুন আপনি Redis + Redis Streams + RedisTimeSeries ব্যবহার করছেন।
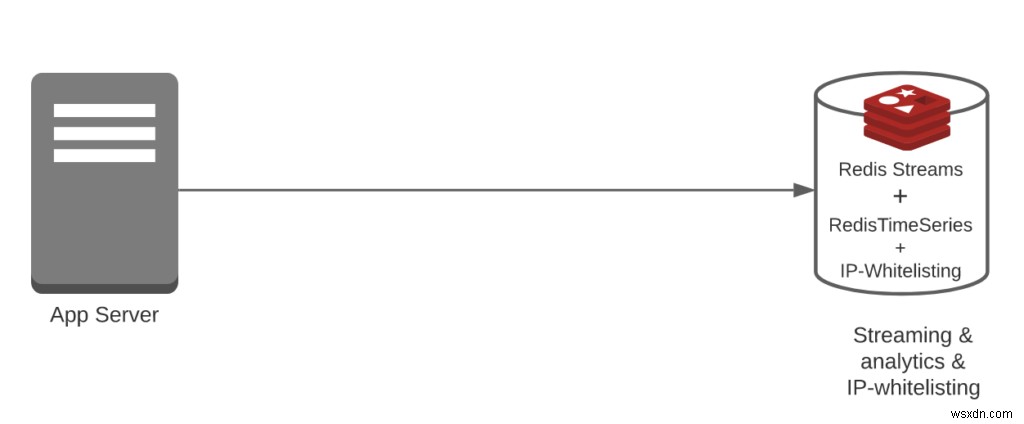
- ট্রান্সফরমেশনাল ওভারহেড = ০
- IP-whitelisting-এর জন্য, আপনাকে কোনো ট্রান্সফরমেশন দরকার নেই। আর Redis Streams এবং RedisTimeseries সহজে স্ট্রিমস এবং এলার্ট হ্যান্ডেল করতে পারে।
- পাইপলাইন ওভারহেড = ১
- আপনার Redis + Redis Streams + Redis TimeSeries রয়েছে। নোট: এই কেসে, তিনটিই একই সিস্টেমের অংশ।
- ফিচারের সংখ্যা = ২
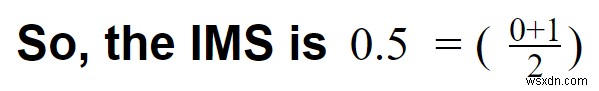
ফেজ ২-এর পর নিষ্কর্ষ:
যখন আমরা একটি অতিরিক্ত ফিচার যোগ করলাম,
- কেস ১ ফেজ-১-এ ২-এ ছিল এবং ১.৫-এ নেমে এলো।
- কেস ২ ফেজ-১-এ ৩-এ ছিল এবং ২-এ নেমে এলো
- কেস ৩ ফেজ-১-এ ১-এ ছিল এবং ১-এ থাকলো
- কেস ৪ ফেজ-১-এ ১-এ ছিল এবং ০.৫-এ নেমে এলো (সেরা)
সেটাই আমাদের উদাহরণে, কেস ৪, যেটির IMS স্কোর ১ ছিল (সর্বনিম্নের এক), সেটি আসলে আরও ভালো হয়ে গেলো আমরা নতুন ফিচার যোগ করার সাথে সাথেই এবং ০.৫-এ শেষ হয়েছে।
দয়া করে নোট করুন: আপনি যদি আরও বা ভিন্ন ফিচার যোগ করেন, কেস ৪ সবচেয়ে সিম্পল থাকতে পারে না। কিন্তু সেটাই IMS স্কোরের আইডিয়া। শুধু সকল ফিচার লিস্ট করুন, ভিন্ন আর্কিটেকচার তুলনা করুন, এবং দেখুন আপনার ইউজ কেসের জন্য কোনটি সেরা।
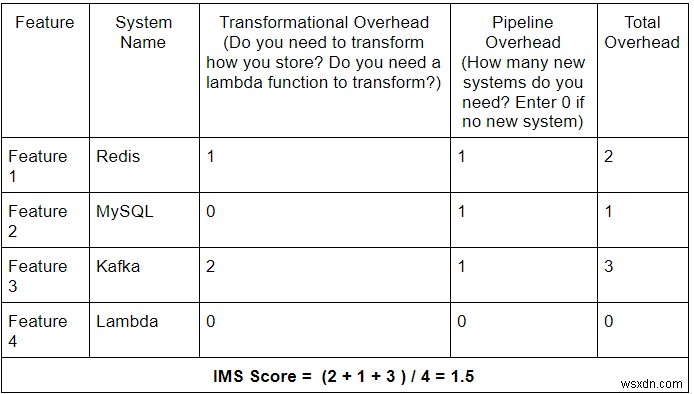
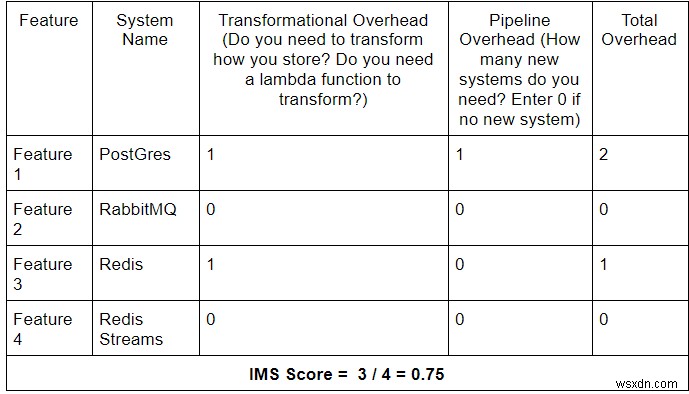
এটিকে আরও সহজ বানাতে, আমরা আপনাকে একটি ক্যালকুলেটর দিচ্ছি যা আপনি একটি সিম্পল স্প্রেডশীতে ইমপ্লিমেন্ট করে IMS স্কোর ক্যালকুলেট করতে পারবেন।
IMS ক্যালকুলেটর
এটি কীভাবে ব্যবহার করবেন:
- প্রতিটি ডেটা লেয়ার বা ডেটা পাইপলাইনের জন্য, শুধু লিস্ট আউট করুন:
- ফিচারগুলো যা আপনার বর্তমানে রয়েছে।
- ফিচারগুলো যা রোডম্যাপে রয়েছে। এটি গুরুত্বপূর্ণ, কারণ আপনি নিশ্চিত করতে চান আপনার ডেটা লেয়ার আপকামিং ফিচারগুলো কোনো অতিরিক্ত ওভারহেড ছাড়া সাপোর্ট করতে পারবে।
- তারপর প্রতিটি ফিচারের জন্য ট্রান্সফরমেশনাল ওভারহেড এবং পাইপলাইন ওভারহেড ম্যাপ করুন।
- এবং অবশেষে, সব ওভারহেডের যোগফল ফিচারের সংখ্যা দিয়ে ভাগ করুন।
- ধাপ ২ এবং ৩ রিপিট করুন ভিন্ন সিস্টেম সহ পাইপলাইনের জন্য তাদের তুলনা এবং কনট্রাস্ট করার জন্য।
Data Pipeline 1
Data Pipeline 2
সারাংশ
পরिणাম চিন্তা না করে কমপ্লেক্স ডেটা লেয়ার বিল্ড করতে খুব সহজে পেরোনো যায়। IMS স্কোর তৈরি করা হয়েছে আপনাকে আপনার সিদ্ধান্তের সচেতন করতে সাহায্য করতে।
আপনি IMS স্কোর ব্যবহার করে সহজে একাধিক সিস্টেম আপনার ইউজ কেসের জন্য তুলনা ও কনট্রাস্ট করতে পারেন এবং দেখতে পারেন কোনটি আপনার ফিচার সেটের জন্য সত্যিকারের সেরা। আপনি এছাড়া ভ্যালিডেট করতে পারেন আপনার সিস্টেম ফিচার এক্সপ্যানশন ধারণ করতে পারে কিনা এবং যতটা সম্ভব সিম্পল থাকতে পারে।
সবসময় মনে রাখবেন:
“সাদگی চরম সফিস্টিকেশন” — লিওনার্দো দা ভিন্সি
“অধিকাংশ তথ্য অপ্রাসঙ্গিক এবং অধিকাংশ প্রচেষ্টা বর্জিত, তবে শুধু বিশেষজ্ঞ জানে কী উপেক্ষা করব” — জেমস ক্লিয়ার, Atomic Habits
