

এক্সেল ডেটা ব্যবস্থাপনা এবং বিশ্লেষণের একটি শক্তিশালী টুল। এটি দ্রুত রিপোর্টিং এবং হিসাবের জন্য উপযুক্ত, কিন্তু কাজ যখন জটিল, পুনরাবৃত্তিমূলক বা অত্যধিক বড় হয়, তখন পাইথন সাহায্য করে। পাইথন অটোমেশন, উন্নত বিশ্লেষণ এবং ইন্টিগ্রেশনের সম্ভাবনা খুলে দেয় যা এক্সেলের বিল্ট-ইন বৈশিষ্ট্যগুলোর বাইরে। পাইথন লাইব্রেরিগুলো যেমন ডেটা ম্যানিপুলেশনের জন্য pandas এবং এক্সেল ফাইল সরাসরি হ্যান্ডল করার জন্য openpyxl এই কাজটিকে সহজ করে তোলে।
এই টিউটোরিয়ালে, আমরা এক্সেল + পাইথনের সাথে করা যাওয়া ৫টি কাজ দেখাব।
নমুনা বিক্রয় ডেটা বিবেচনা করে এক্সেল এবং পাইথনের সাথে করা যাওয়া ৫টি কাজটি অন্বেষণ করুন।
১. 지저분한 এক্সেল ডেটা পরিষ্কার এবং মানकीকরণ করুন (পুনরাবৃত্তি যোগ্য)
এক্সেলে গুলান ডেটা থাকা সাধারণ, কারণ বাস্তব বিশ্বের ডেটা শুধুমাত্র কখনো পরিষ্কার থাকে। প্রায়শই ডেটাতে অতিরিক্ত স্পেস, মিশ্র ক্যাপিটালাইজেশন, টেক্সট হিসেবে সংরক্ষিত সংখ্যা, অসঙ্গত ফরম্যাটিং, অনুপস্থিত মান, ডুপ্লিকেট এন্ট্রি বা বিশ্লেষণের আগে পুনর্গঠনের প্রয়োজনীয় ডেটা থাকে। এই সমস্যাটি ফর্মুলা এবং বিশ্লেষণকে ভেঙে দেয়।
পাইথন ডেটা-পরিষ্কারের কাজে দক্ষ। আপনি স্ক্রিপ্ট লিখতে পারেন যা বিভিন্ন ফাইল জুড়ে ডেটা ফরম্যাট মানকীকরণ করে, বুদ্ধিমানের পদ্ধতিতে অনুপস্থিত মান পূরণ করে, ডুপ্লিকেট সরিয়ে দেয়, প্যাটার্নের ভিত্তিতে কলাম বিভক্ত বা একত্রিত করে, এবং ব্যবসায়িক নিয়মের বিপরীতে ডেটা যাচাই করে। এই ধাপগুলো এক্সেলে ম্যানুয়াল ফাইন্ড-অ্যান্ড-রিপ্লেস অপারেশনে ঘন্টা সময় নিতে পারে। পাইথন ব্যবহার করে, আপনি একটি পুনরাবৃত্তি যোগ্য স্ক্রিপ্ট তৈরি করতে পারেন যা সেকেন্ডে হাজার হাজার সারি প্রক্রিয়া করে।
মনে করুন আপনি গুলান বিক্রয় ডেটা পেয়েছেন। আসুন একটি পাইথন স্ক্রিপ্ট ব্যবহার করি যা গুলান ডেটা পড়ে, কলামগুলো পরিষ্কার ও মানকীকরণ করে, এবং গণনা করা ফিল্ড যোগ করে।
- Revenue = Units * UnitPrice
- NetRevenue = Revenue * (1 – DiscountPct)
import pandas as pd
file_path = "SalesData.xlsx"
df = pd.read_excel(file_path, sheet_name="Sales Data")
# Clean types
df["Units"] = pd.to_numeric(df["Units"], errors="coerce").fillna(0).astype(int)
df["UnitPrice"] = pd.to_numeric(df["UnitPrice"], errors="coerce").fillna(0.0)
df["DiscountPct"] = pd.to_numeric(df["DiscountPct"], errors="coerce").fillna(0.0)
df["Returned"] = (
    df["Returned"].astype(str).str.strip().str.lower()
    .map({"yes": True, "no": False})
    .fillna(False)
)
# Add calculated fields
df["Revenue"] = df["Units"] * df["UnitPrice"]
df["NetRevenue"] = df["Revenue"] * (1 - df["DiscountPct"])
# Write back into the SAME file as a NEW sheet
with pd.ExcelWriter(file_path, engine="openpyxl", mode="a", if_sheet_exists="replace") as writer:
    df.to_excel(writer, sheet_name="CleanData", index=False)
print("Saved CleanData sheet inside:", file_path)
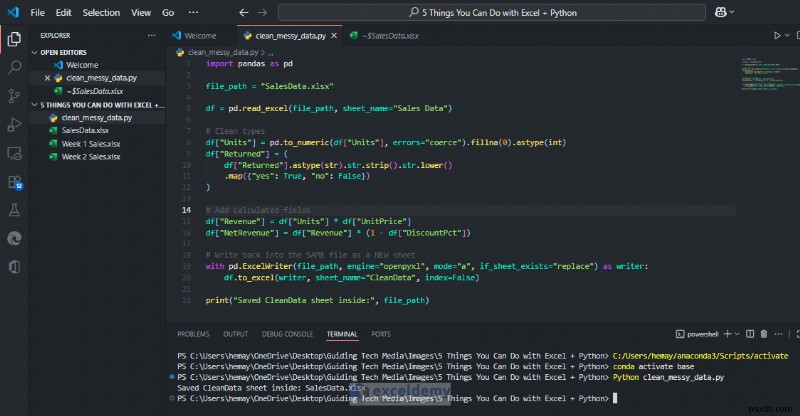
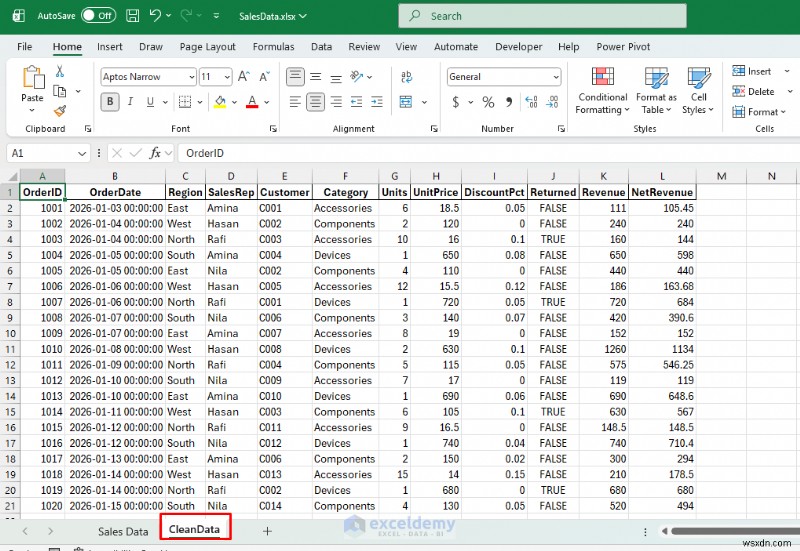
আপনি একই ফাইলের ভিতরে একটি নতুন শিট পাবেন যার ডেটা পরিষ্কার এবং পিভট, চার্ট বা লুকআপ ভাঙবে না। এক্সেলে, আপনি পরিষ্কার ডেটা থেকে পিভট/চার্ট ব্যবহার করতে পারেন, প্রতিবার সुसंगত থাকা জানায়।
২. সারাংশ স্বয়ংক্রিয়ভাবে তৈরি করুন (পুনরাবৃত্তি যোগ্য রিপোর্ট)
এক্সেলের সারি সীমা রয়েছে এবং জটিল গণনার সাথে ধীরে যেতে পারে। পাইথনের pandas লাইব্রেরি বড় ডেটাসেট দক্ষতার সাথে হ্যান্ডেল করে এবং গণনামূলকভাবে çok দ্রুত কাজ করে।
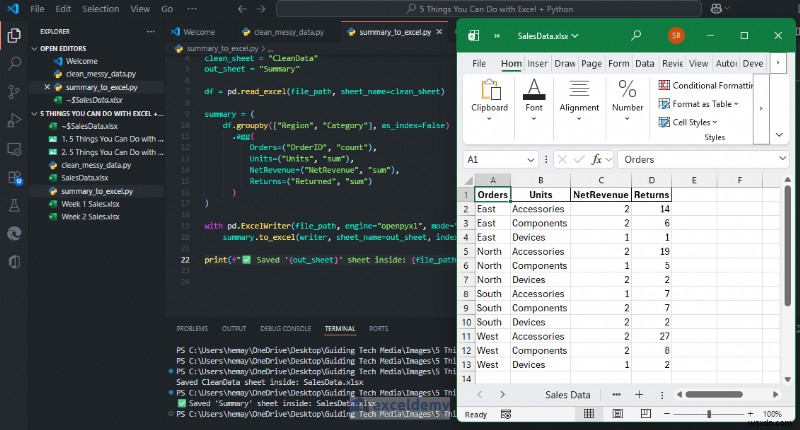
pandas দিয়ে, আপনি লক্ষ লক্ষ রেকর্ড ধারণকারী ডেটাসেটের সাথে কাজ করতে পারেন, জটিল গ্রুপিং এবং এগ্রিগেশন অপারেশন সম্পাদন করতে পারেন, এবং статистиক্যাল বিশ্লেষণ চালাতে পারেন যা এক্সেলে অপ্রচলিত হতে পারে। পাইথন পিভট-শৈলীর সারাংশ তৈরি করে এক্সেলে এক্সপোর্ট করতে পারে। ধরুন আপনি অঞ্চল এবং ক্যাটাগরিরypes দ্রুত একটি সারাংশ চান, কিন্তু আপনি প্রতিবার পিভট পুনর্নির্মাণ করতে চান না।
import pandas as pd
file_path = "SalesData.xlsx"
clean_sheet = "CleanData"
out_sheet = "Summary"
df = pd.read_excel(file_path, sheet_name=clean_sheet)
summary = (
    df.groupby(["Region", "Category"], as_index=False)
    .agg(
        Orders=("OrderID", "count"),
        Units=("Units", "sum"),
        NetRevenue=("NetRevenue", "sum"),
        Returns=("Returned", "sum")
    )
)
with pd.ExcelWriter(file_path, engine="openpyxl", mode="a", if_sheet_exists="replace") as writer:
    summary.to_excel(writer, sheet_name=out_sheet, index=False)
print(f"✅ Saved '{out_sheet}' sheet inside: {file_path}")
আপনি অঞ্চল অনুযায়ী রাজস্বের সারাংশ পাবেন—একটি পিভট-শৈলীর শিট যা স্ক্রিপ্ট পুনরায় চালালে আপডেট হয়।
৩. এক্সেল ডেটা থেকে চার্ট তৈরি করুন (ম্যানুয়াল ফরম্যাটিং ছাড়া)
চার্ট প্রায়শই রিপোর্টিংয়ের সবচেয়ে সময়সাপেক্ষ অংশ। এক্সেল стандарт চার্ট অফার করে, কিন্তু পাইথনের ভিজ্যুয়ালাইজেশন লাইব্রেরি যেমন Matplotlib, Seaborn, এবং Plotly আরও বেশি নমনীয়তা এবং সোফিস্টিকেশন প্রদান করে। আপনি কাস্টম ভিজ্যুয়ালাইজেশন তৈরি করতে পারেন যা আপনার ডেটা পরিবর্তন হলে স্বয়ংক্রিয়ভাবে আপডেট হয়, ইন্টারেক্টিভ ড্যাশবোর্ড তৈরি করতে পারেন যা ব্যবহারকারীরা অন্বেষণ করতে পারে, বা প্রিসিশন নিয়ন্ত্রণ সহ প্রকাশনা-গুণমানের গ্রাফিক্স তৈরি করতে পারেন।
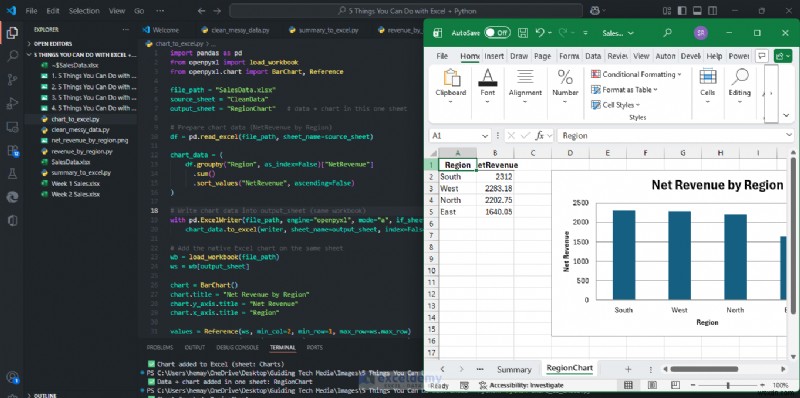
আসুন অঞ্চল অনুযায়ী পারফরম্যান্স ভিজ্যুয়ালাইজ করি (NetRevenue by Region)।
import pandas as pd
from openpyxl import load_workbook
from openpyxl.chart import BarChart, Reference
file_path = "SalesData.xlsx"
source_sheet = "CleanData"
output_sheet = "RegionChart"
# data + chart in this one sheet
# Prepare chart data (NetRevenue by Region)
df = pd.read_excel(file_path, sheet_name=source_sheet)
chart_data = (
    df.groupby("Region", as_index=False)["NetRevenue"]
    .sum()
    .sort_values("NetRevenue", ascending=False)
)
# Write chart data into output_sheet (same workbook)
with pd.ExcelWriter(file_path, engine="openpyxl", mode="a", if_sheet_exists="replace") as writer:
    chart_data.to_excel(writer, sheet_name=output_sheet, index=False)
# Add the native Excel chart on the same sheet
wb = load_workbook(file_path)
ws = wb[output_sheet]
chart = BarChart()
chart.title = "Net Revenue by Region"
chart.y_axis.title = "Net Revenue"
chart.x_axis.title = "Region"
values = Reference(ws, min_col=2, min_row=1, max_row=ws.max_row)
labels = Reference(ws, min_col=1, min_row=2, max_row=ws.max_row)
chart.add_data(values, titles_from_data=True)
chart.set_categories(labels)
ws.add_chart(chart, "D2") # place chart to the right of the data table
wb.save(file_path)
print(f"✅ Chart Created: {output_sheet}")
এখন আপনার पास অঞ্চল অনুযায়ী রাজস্বের সারাংশ এবং একটি বার চার্ট আছে।
৪. অনেক এক্সেল ফাইলকে একটি মাস্টার টেবিলে একত্রিত করুন
সাপ্তাহিক, মাসিক বা ত্রৈমাসিক ডেটা ভিন্ন সোর্স থেকে একত্রিত করা সাধারণ। ভিন্ন লোক বা টিম থেকে এক্সেল ফাইল একত্রিত করা ধীর এবং ত্রুটিপূর্ণ। পাইথন সেকেন্ডে সেগুলো একত্রিত করতে পারে এবং সোর্স ফাইল ট্র্যাক রাখতে পারে।
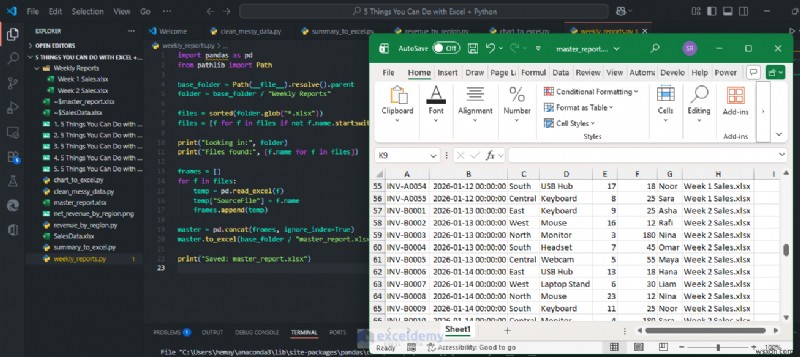
আসুন সাপ্তাহিক ফাইলগুলো Weekly Reports/ নামক ফোল্ডারে একত্রিত করি (সবের কলাম একই)।
import pandas as pd
from pathlib import Path
base_folder = Path(__file__).resolve().parent
folder = base_folder / "Weekly Reports"
files = sorted(folder.glob("*.xlsx"))
files = [f for f in files if not f.name.startswith("~$")] # ignore Excel lock files
print("Looking in:", folder)
print("Files found:", [f.name for f in files])
frames = []
for f in files:
    temp = pd.read_excel(f)
    temp["SourceFile"] = f.name
    frames.append(temp)
master = pd.concat(frames, ignore_index=True)
master.to_excel(base_folder / "master_report.xlsx", index=False)
print("Saved: master_report.xlsx")
আপনি একটি সম্মিলিত টেবিল পাবেন যার সাথে একটি SourceFile কলাম থাকবে অডিটের জন্য। প্রতি সপ্তাহে, আপনি শুধু স্ক্রিপ্টটি চালাতে হবে।
৫. এক্সেল যা সহজে করতে পারে না এমন কিছু পূর্বাভাস দিন (মেশিন লার্নিং উদাহরণ)
আপনি প্যাটার্ন ব্যবহার করে রিটার্ন রিস্ক অনুমান করতে পারেন (ডিসকাউন্ট, ক্যাটাগরি, ইউনিট, প্রাইস), তারপর এক্সেল ব্যবহারকারীদের ফিল্টার এবং সোর্ট করার জন্য সম্ভাবনাগুলো ফিরিয়ে দিতে পারেন। পাইথন такие মেশিন লার্নিং অপারেশন সহজে সম্পাদন করতে পারে।
আমাদের ডেটাসেট ছোট; তবুও, এটি ওয়ার্কফ্লো দেখায়।
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import OneHotEncoder
from sklearn.compose import ColumnTransformer
from sklearn.pipeline import Pipeline
from sklearn.linear_model import LogisticRegression
file_path = "SalesData.xlsx"
df = pd.read_excel(file_path, sheet_name="CleanData")
X = df[["Region", "SalesRep", "Category", "Units", "UnitPrice", "DiscountPct"]]
y = df["Returned"].astype(int)
cat_cols = ["Region", "SalesRep", "Category"]
num_cols = ["Units", "UnitPrice", "DiscountPct"]
preprocess = ColumnTransformer(
    transformers=[
        ("cat", OneHotEncoder(handle_unknown="ignore"), cat_cols),
        ("num", "passthrough", num_cols),
    ]
)
model = Pipeline(steps=[
    ("prep", preprocess),
    ("clf", LogisticRegression(max_iter=1000))
])
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
model.fit(X_train, y_train)
# Predict probability of return for all rows
df["ReturnProb"] = model.predict_proba(X)[:, 1]
with pd.ExcelWriter(file_path, engine="openpyxl", mode="a", if_sheet_exists="replace") as writer:
    df.to_excel(writer, sheet_name="WithReturnRisk", index=False)
এक्सেলে, WithReturnRisk এক্সপ্লোর করুন এবং ReturnProb কে উচ্চ থেকে নিম্নে ফিল্টার করুন যাতে দেখতে পান কোন অর্ডারগুলো রিস্কি দেখাচ্ছে।
এক্সেলে পাইথন (যদি আপনার এক্সেলে উপলব্ধ থাকে)
যদি আপনার কম্পিউটারের এক্সেলে পাইথন (প্রিভিউ) থাকে, আপনি সরাসরি একটি সেলে পাইথন চালাতে পারেন এবং ফলাফল শিটে ফেরত পাতে পারেন। (মাইক্রোসফটের পাইথন ইন এক্সেল ওভারভিউ দেখুন।) এখানে একটি সহজ উদাহরণ যা একটি ছোট রেঞ্জ পড়ে, টেক্সট পরিষ্কার করে, রাজস্ব গণনা করে, এবং একটি পরিষ্কার টেবিল ফেরত দেয়।
- এক্সেলে, আপনার ডেটাসেট লিখুন
- একটি খালি সেলে ক্লিক করুন
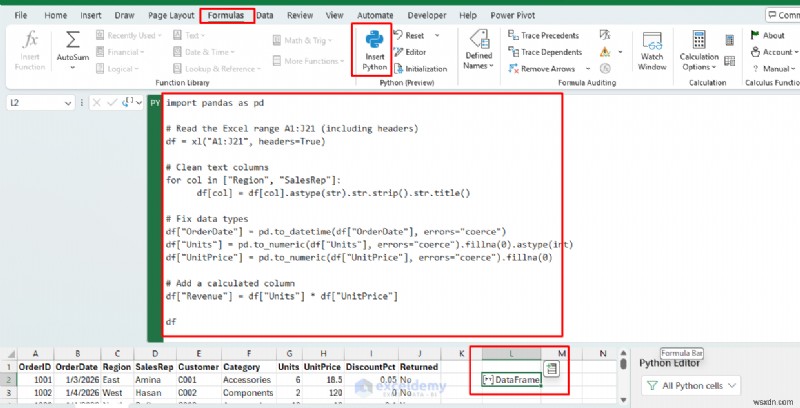
- Formulas ট্যাবে যান >> Insert Python সিলেক্ট করুন
- পাইথন স্ক্রিপ্ট পেস্ট করুন
import pandas as pd
# Read the Excel range A1:J21 (including headers)
df = xl("A1:J21", headers=True)
# Clean text columns
for col in ["Region", "SalesRep"]:
    df[col] = df[col].astype(str).str.strip().str.title()
# Fix data types
df["OrderDate"] = pd.to_datetime(df["OrderDate"], errors="coerce")
df["Units"] = pd.to_numeric(df["Units"], errors="coerce").fillna(0).astype(int)
df["UnitPrice"] = pd.to_numeric(df["UnitPrice"], errors="coerce").fillna(0.0)
# Add a calculated column
df["Revenue"] = df["Units"] * df["UnitPrice"]
df
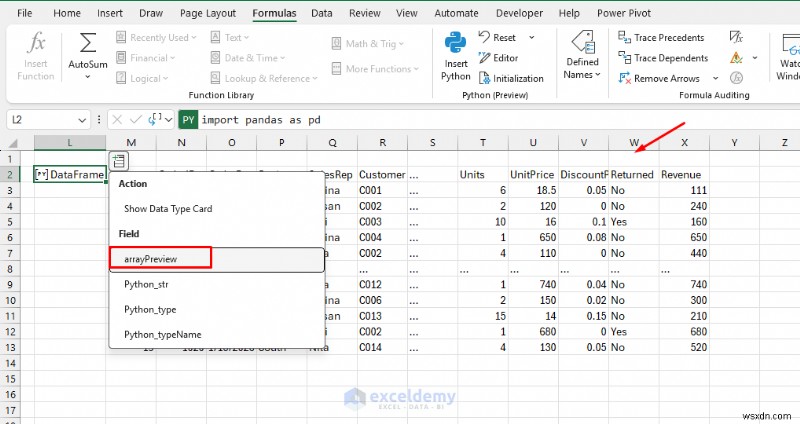
এটি DataFrame ফেরত দেবে, যা পাইথনের টেবিল অবজেক্ট। এক্সেল এটি টেবিল প্রিভিউ (এবং একটি কার্ড) হিসেবে দেখাবে।
এখন আউটপুটকে সেলে "স্পিল" করুন একটি পরিষ্কার টেবিল হিসেবে।
- Insert Data থেকে DataFrame >> Show DataType Card সিলেক্ট করুন টেবিল প্রিভিউ করতে
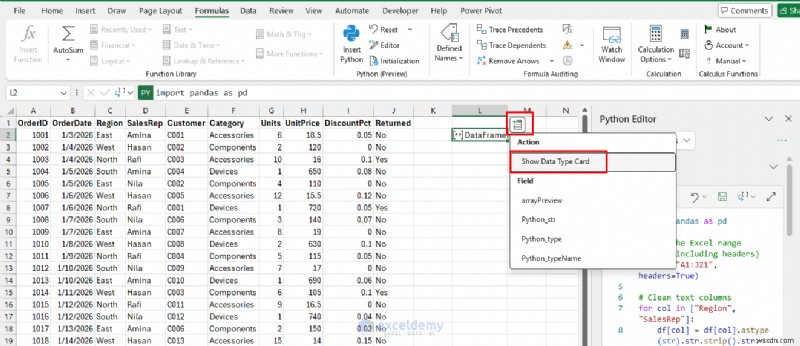
- arrayPreview সিলেক্ট করুন এক্সেলে টেবিল আনার জন্য
- এখন আপনার মানকীকৃত টেক্সট এবং একটি নতুন Revenue কলাম আছে
উপসংহার
এই আর্টিকেলটি এক্সেল + পাইথনের সাথে করা যাওয়া ৫টি কাজ দেখিয়েছে। পাইথনের সাথে এক্সেল আরও শক্তিশালী হয়; গুলান ডেটাসেট পরিষ্কার করা, পিভট-শৈলীর সারাংশ তৈরি করা, চার্ট অটোমেট করা, অনেক এক্সেল ফাইল একত্রিত করা, এবং সহজ মেশিন লার্নিং ইনসাইট যোগ করা সহজ হয়ে যায়। এক্সেল এবং পাইথন একত্রিত করলে ওয়ার্কফ্লো সুव्यবস্থিত হয়, ডেটা আমদানি/রপ্তানি থেকে অটোমেশন এবং ভিজ্যুয়ালাইজেশনে। ছোট স্ক্রিপ্ট দিয়ে শুরু করুন, এবং আরও লাইব্রেরি এক্সপেরিমেন্ট করুন।
Get FREE Advanced Excel Exercises with Solutions!
