

এক্সেল ডেটা বিশ্লেষণের জন্য সবচেয়ে শক্তিশালী টুলের একটি, কিন্তু এর সীমাবদ্ধতা রয়েছে। যখন ডেটাসেট মিলিয়ন সারির পরিমাণে বেড়ে যায়, যখন রিপোর্ট স্বয়ংক্রিয়ভাবে চালাতে হয়, বা যখন বিশ্লেষণে মেশিন লার্নিং প্রয়োজন হয়—তখন এক্সেল একলা পুরনো লাগতে শুরু করে। পাইথন এই খাঁজগুলো পূরণ করে। পাইথন ইন্টিগ্রেশন এক্সেলকে একটি ঐতিহ্যবাহী স্প্রেডশীট টুল থেকে একটি আরও শক্তিশালী ডেটা বিশ্লেষণ প্ল্যাটফর্মে রূপান্তরিত করেছে। এক্সেলের ভিতরেই পাইথন থাকায়, অ্যানালিস্টরা এখন উন্নত ক্যালকুলেশন, প্রেডিক্টিভ মডেল তৈরি, এবং জটিল ভিজ্যুয়ালাইজেশন তৈরি করতে পারেন—ওয়ার্কবুক ছাড়াই।
এই টিউটোরিয়ালে, আমরা পাঁচটি পাইথন লাইব্রেরি দেখাব যা উন্নত এক্সেল ডেটা বিশ্লেষণের জন্য প্রতিটি প্রো ব্যবহার করা উচিত। এই লাইব্রেরিগুলো আপনাকে এক্সেলের ভিতরেই উন্নত ডেটা ম্যানিপুলেশন, ভিজ্যুয়ালাইজেশন এবং মেশিন লার্নিং করতে দেয়।
১. প্যান্ডাস (Pandas) – ডেটা ম্যানিপুলেশন এবং বিশ্লেষণের মূল
আপনি যদি এক্সেল বিশ্লেষণের জন্য শুধু একটি পাইথন লাইব্রেরি শিখতে চান, তবে প্যান্ডাস প্রথমে শিখুন। প্যান্ডাস এক্সেল-সম্পর্কিত প্রায় সব উন্নত কাজের ফাউন্ডেশন। এটি এক্সেল ডেটাকে শক্তিশালী ডেটাফ্রেম-এ রূপান্তরিত করে যাতে বড় ডেটাসেট দক্ষতার সাথে ক্লিন, ট্রান্সফর্ম, ফিল্টার, গ্রুপ, মার্জ, এগরিগেট এবং এক্সপ্লোর করা যায়।
এক্সেল প্রোদের জন্য মূল শক্তি:
- pd.read_excel() এবং df.to_excel() দিয়ে এক্সেল ফাইল নেটিভলি পড়ুন এবং লিখুন
- গোমা ডেটা হ্যান্ডল করুন: ডুপ্লিকেট সরান, মিসিং ভ্যালু ফিল করুন, এবং ফরম্যাট стандарডাইজ করুন
- পিভট টেবিলের বাইরে লজিক দিয়ে উন্নত গ্রুপিং এবং এগরিগেশন করুন
- একাধিক শীট বা ফাইল মার্জ বা জয়েন করুন
- df.describe() দিয়ে পরিসংখ্যানিক সারammans তৈরি করুন
- কয়েক লাইন কোড চালিয়ে একই ফলাফল বারবার পান
উদাহরণ: গোমা ডেটা ক্লিন করা
এক্সেলে সাধারণ সমস্যা হলো মিক্সড টাইপ, মিসিং ভ্যালু এবং ইনকনসিস্টেন্ট ফরম্যাটের ডেটা পাওয়া। প্যান্ডাস দিয়ে আপনি সব কিছু একটি রিপিটেবল স্ক্রিপ্টে ঠিক করতে পারেন।
এক্সেলে পাইথন:
import pandas as pd df = xl("A1:J10000", headers=True) # ক্লিন: স্পেস সরান, টাইপ কনভার্ট করুন, মিসিং ফিল করুন df['Category'] = df['Category'].str.strip() df['Revenue'] = df['Units'] * df['UnitPrice'].fillna(0) # উন্নত সারমারি: অঞ্চল এবং ক্যাটাগরি অনুযোগী গ্রুপ করুন summary = df.groupby(['Region', 'Category']).agg({ 'Revenue': 'sum', 'Units': 'sum' }).reset_index() summary 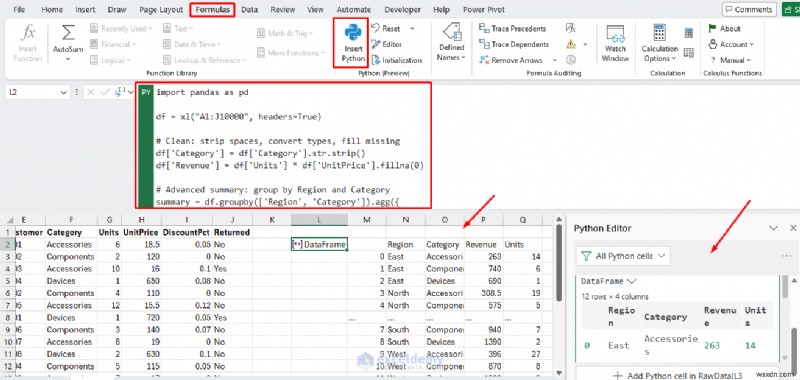
ভিএস কোডে পাইথন:
import pandas as pd file_path = 'SalesData.xlsx' df = pd.read_excel(file_path, sheet_name='RawData') # কলাম টাইপ ঠিক করুন — টেক্সট হিসেবে সংরক্ষিত সংখ্যা হ্যান্ডল করে df['Units'] = pd.to_numeric(df['Units'], errors='coerce').fillna(0).astype(int) df['UnitPrice'] = pd.to_numeric(df['UnitPrice'], errors='coerce').fillna(0.0) df['DiscountPct'] = pd.to_numeric(df['DiscountPct'], errors='coerce').fillna(0.0) # বুলিয়ান-লাইক টেক্সট কলাম стандарডাইজ করুন df['Returned'] = df['Returned'].astype(str).str.strip().str.lower() \ .map({'yes': True, 'no': False}).fillna(False) # ক্যালকুলেটেড কলাম যোগ করুন df['Revenue'] = df['Units'] * df['UnitPrice'] df['NetRevenue'] = df['Revenue'] * (1 - df['DiscountPct']) # নতুন শীট হিসেবে রাইট ব্যাক করুন — মূল ডেটা অক্ষত থাকে with pd.ExcelWriter(file_path, engine='openpyxl', mode='a', if_sheet_exists='replace') as writer: df.to_excel(writer, sheet_name='CleanData', index=False) print('CleanData sheet created in', file_path) 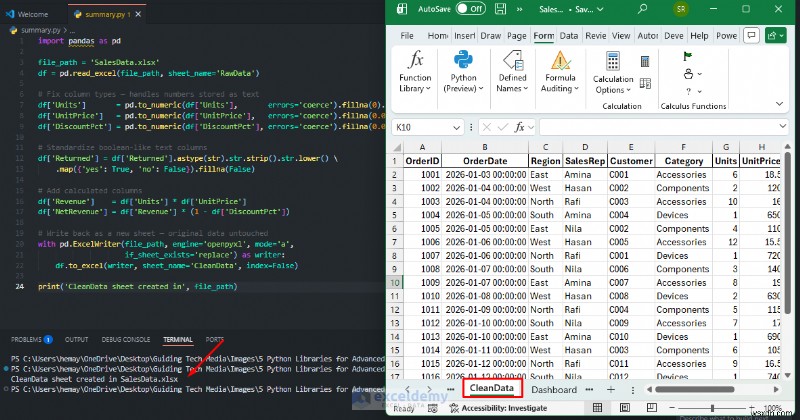
সারাংশ রিপোর্ট অটোমেট করা
ম্যানুয়াল পিভট টেবিলকে প্যান্ডাস groupby ওয়ার্কফ্লো দিয়ে রিপ্লেস করুন যা সেকেন্ডসে চলে এবং আপনার ডেটা আপডেট হলে প্রতিবার একটি রেডি-টু-শেয়ার শীট এক্সপোর্ট করে:
summary = ( df.groupby(['Region', 'Category'], as_index=False) .agg( Orders = ('OrderID', 'count'), Units = ('Units', 'sum'), NetRevenue = ('NetRevenue', 'sum'), Returns = ('Returned', 'sum') ) ) with pd.ExcelWriter(file_path, engine='openpyxl', mode='a', if_sheet_exists='replace') as writer: summary.to_excel(writer, sheet_name='Summary', index=False) 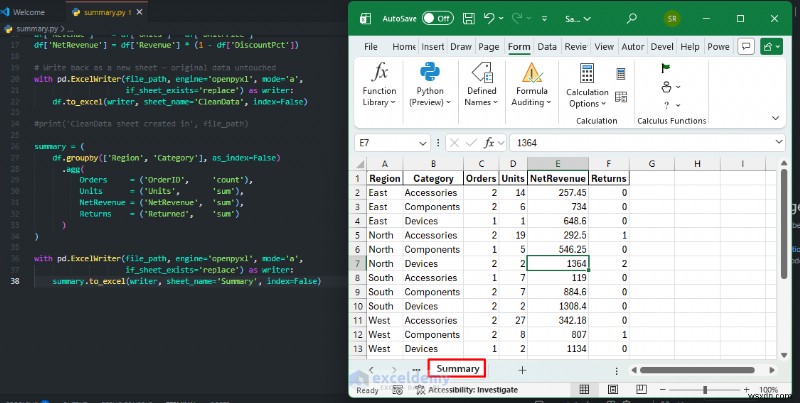
কখন ব্যবহার করবেন: আপনি পিভট টেবিল-স্টাইল আউটপুট পান, কিন্তু ক্লিনআপ এবং লজিক একই ওয়ার্কফ্লোতে ঘটে। এর মানে কম ব্রোকেন রিপোর্ট এবং কম ম্যানুয়াল হস্তক্ষেপ। পাওয়ার ইউজাররা প্যান্ডাসের ওপর নির্ভর করেন যেনে ডেটাসেট যা হাজার সারির চেয়ে বড় হলে বা খুব জটিল হলে, বা ক্লিনিং বা সারামারাইজেশন ধাপটি বারবার दुहरাতে হলে, অথবা একাধিক সোর্স থেকে ডেটা স্বয়ংক্রিয়ভাবে মার্জ করতে হলে।
২. ওপেনপাইএক্সএল (OpenPyXL) – উন্নত এক্সেল ফাইল ম্যানিপুলেশন এবং নেটিভ ফরম্যাটিং
প্যান্ডাস ডেটা হ্যান্ডেল করলে, ওপেনপাইএক্সএল .xlsx ফাইলের ওপর ফাইন-গ্রেইন কন্ট্রোল দিতে দক্ষ: সেল ফরম্যাটিং, চার্ট, টেবিল, স্টাইল, ফর্মুলা এবং ইমেজ যোগ করা—এক্সেল-নেটিভ ফিচার হারিয়ে না। এটি আপনাকে সরাসরি .xlsx ফাইলের সাথে কাজ করতে দেয়, তাই আপনার পাইথন ওয়ার্কফ্লো কাঁচা বিশ্লেষণের বদলে এক্সেল-রেডি আউটপুট তৈরি করতে পারে।
এক্সেল প্রোদের জন্য মূল শক্তি:
- প্রোগ্রাম্যাটিক্যালি ওয়ার্কবুক তৈরি এবং মডিফাই করুন
- ক্লিন টেবিল নতুন শীতে এক্সপোর্ট করুন
- স্বয়ংক্রিয়ভাবে আপডেট হওয়া প্রফেশনাল চার্ট সরাসরি এক্সেল ফরম্যাটে যোগ করুন
- পুরনো রিপোর্ট ট্যাব স্বয়ংক্রিয়ভাবে রিপ্লেস করুন
- নির্দিষ্ট সেলে কন্ডিশনাল ফরম্যাটিং, বর্ডার, ফন্ট এবং স্টাইল প্রয়োগ করুন
- =SUM() বা =VLOOKUP() এর মতো এক্সেল ফর্মুলা সেলে ইনজেক্ট করুন
- প্রোগ্রাম্যাটিক্যালি শীট প্রোটেক্ট করুন, প্যান ফ্রিজ করুন এবং কলাম ওইডথ সেট করুন
- নন-পাইথন ব্যবহারকারীদের জন্য ওয়ার্কবুক-ভিত্তিক ডেলিভারেবল তৈরি করুন
উদাহরণ: আপনার ওয়ার্কবুকে একটি নেটিভ চার্ট যোগ করা
প্যান্ডাস দিয়ে ক্লিন ডেটা জেনারেট করার পর, এক্সেল ম্যানুয়ালি খুলবেন না এমন একটি প্রফেশনাল বার চার্ট যোগ করতে ওপেনপাইএক্সএল ব্যবহার করুন।
from openpyxl import load_workbook from openpyxl.chart import BarChart, Reference import pandas as pd file_path = 'SalesData.xlsx' df = pd.read_excel(file_path, sheet_name='CleanData') chart_data = df.groupby('Region', as_index=False)['NetRevenue'] \ .sum().sort_values('NetRevenue', ascending=False) with pd.ExcelWriter(file_path, engine='openpyxl', mode='a', if_sheet_exists='replace') as writer: chart_data.to_excel(writer, sheet_name='RegionChart', index=False) wb = load_workbook(file_path) ws = wb['RegionChart'] chart = BarChart() chart.title = 'Net Revenue by Region' chart.y_axis.title = 'Net Revenue ($)' chart.x_axis.title = 'Region' values = Reference(ws, min_col=2, min_row=1, max_row=ws.max_row) labels = Reference(ws, min_col=1, min_row=2, max_row=ws.max_row) chart.add_data(values, titles_from_data=True) chart.set_categories(labels) ws.add_chart(chart, 'D2') wb.save(file_path) 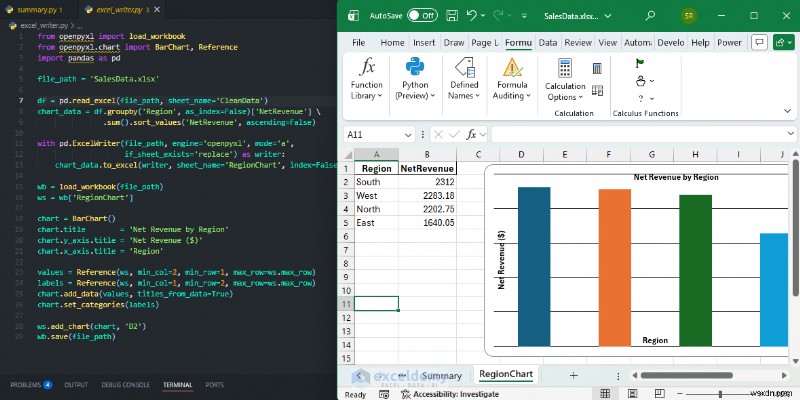
কখন ব্যবহার করবেন: প্যান্ডাস আপনাকে ডেটা বিশ্লেষণ করতে সাহায্য করে। ওপেনপাইএক্সএল আপনাকে ডেলিভার করতে সাহায্য করে। ওপেনপাইএক্সএল ব্যবহার করুন যখন আপনাকে পিক্সেল-পারফেক্ট এক্সেল আউটপুট দরকার হয়—যেমন রিপোর্ট এবং ড্যাশবোর্ড যা হাতের তৈরি মনে হয়, এবং যখন ফলাফলকে নেটিভ এক্সেল চার্ট এবং ফরম্যাটিংসহ একটি .xlsx ফাইলে থাকতে হবে যাতে সহকর্মীরা এডিট করতে পারেন।
৩. ম্যাটপ্লটলিব (Matplotlib) – এক্সেল চার্টের বাইরে শক্তিশালী ভিজ্যুয়ালাইজেশন
এক্সেল চার্ট সুবিধাজনক, কিন্তু ম্যাটপ্লটলিব অ্যানালিস্টদের আরও বেশি কন্ট্রোল দেয়। ম্যাটপ্লটলিব স্ট্যাটিক, পাবলিকেশন-কোয়ালিটি প্লট তৈরির জন্য গো-টু লাইব্রেরি। এটি অত্যন্ত কাস্টমাইজযোগ্য এবং প্যান্ডাসের সাথে দ্রুত এক্সপ্লোরেটরি অ্যানালিসিসের জন্য ভালো ইন্টিগ্রেটেড।
এক্সেল প্রোদের জন্য মূল শক্তি:
- হিটম্যাপ, ট্রেন্ডলাইনসহ স্ক্যাটার প্লট, বক্স প্লট, হিস্টোগ্রাম, এবং ৩ডি চার্টের মতো উন্নত প্লট তৈরি করুন
- ফন্ট, কালার, গ্রিডলাইন, টিক মার্ক এবং লেজেন্ডের ওপর বেশি কন্ট্রোল পান
- মাল্টি-প্যানেল সাবপ্লট লেআউট তৈরি করুন যা একসাথে flera চার্ট দেখায়
- ইমেজ, পিডিএফ, বা এসভিজিতে এক্সপোর্ট করুন, বা ওপেনপাইএক্সএল দিয়ে এক্সেলে ভিজ্যুয়াল এম্বেড করুন
- কাস্টম লেবেল এবং অ্যারো দিয়ে ডেটা পয়েন্ট এনোটেট করুন
উদাহরণ: একটি মাল্টি-প্যানেল সেলস ড্যাশবোর্ড তৈরি করা
চলুন একটি টু-প্যানেল চার্ট তৈরি করি: বামে মাসিক রেভিনিউ ট্রেন্ড এবং ডানে ক্যাটাগরি ব্রেকডাউন। তারপর এটিকে হাই-রেজোলিউশন ইমেজ হিসেবে সংরক্ষণ করি, যেকোনো রিপোর্টের জন্য রেডি।
import pandas as pd import matplotlib.pyplot as plt import matplotlib.ticker as mticker df = pd.read_excel('SalesData.xlsx', sheet_name='CleanData') df['Month'] = pd.to_datetime(df['OrderDate']).dt.to_period('M') monthly = df.groupby('Month')['NetRevenue'].sum() cat_rev = df.groupby('Category')['NetRevenue'].sum().sort_values(ascending=True) fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(14, 6)) fig.suptitle('Sales Performance Dashboard', fontsize=16, fontweight='bold') # বাম প্যানেল — মাসিক রেভিনিউ লাইন চার্ট ax1.plot(list(monthly.index.astype(str)), monthly.values, marker='o', color='#1E5FAD', linewidth=2) ax1.set_title('Monthly Net Revenue') ax1.set_xlabel('Month') ax1.set_ylabel('Revenue ($)') ax1.yaxis.set_major_formatter(mticker.FuncFormatter(lambda x, _: f'${x:,.0f}')) ax1.tick_params(axis='x', rotation=45) ax1.grid(axis='y', linestyle='--', alpha=0.5) # ডান প্যানেল — ক্যাটাগরি অনুযায়ী রেভিনিউ হরিজেন্টাল বার চার্ট ax2.barh(cat_rev.index, cat_rev.values, color='#217346') ax2.set_title('Revenue by Category') ax2.set_xlabel('Revenue ($)') ax2.xaxis.set_major_formatter(mticker.FuncFormatter(lambda x, _: f'${x:,.0f}')) plt.tight_layout() plt.savefig('sales_dashboard.png', dpi=150, bbox_inches='tight') print('Dashboard saved as sales_dashboard.png') 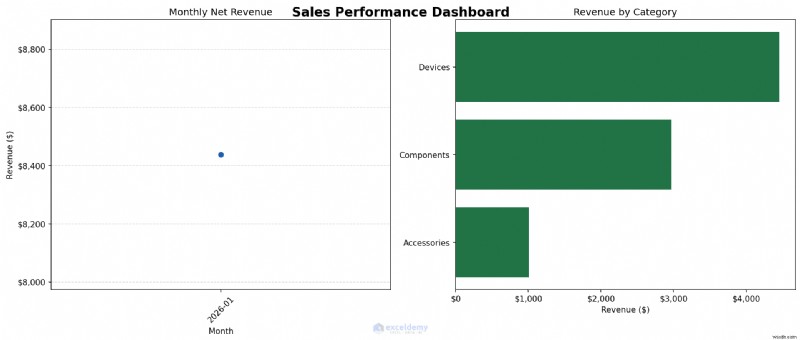
কখন ব্যবহার করবেন: পাইথন দিয়ে প্রথমে অ্যানালিসিস চার্ট তৈরি করুন। তারপর সিদ্ধান্ত নিন যে চার্টটি পাইথন আউটপুট হিসেবে থাকবে কিনা বা সারাংশ ডেটা এক্সেলে ফেরত পাঠানো হবে ফাইনাল ড্যাশবোর্ড ফরম্যাটিং-এর জন্য। ম্যাটপ্লটলিব ব্যবহার করুন যখন আপনাকে রিপোর্ট বা প্রেজেন্টেশনের জন্য চার্ট দরকার, বা কনসিস্টেন্ট স্টাইলিং-এর সাথে আপডেট হওয়া ডেটা থেকে একই চার্ট বারবার প্রডিউস করতে হলে।
৪. সিবর্ন (Seaborn) – পরিসংখ্যানিক ডেটা ভিজ্যুয়ালাইজেশন
সিবর্ন ম্যাটপ্লটলিবের ওপর তৈরি এবং পরিসংখ্যানিক ভিজ্যুয়ালাইজেশনে ফোকাস করে। এটি ভিজুয়ালি আকর্ষণীয় চার্ট তৈরি করা সহজ করে দেয় যা প্যাটার্ন এবং কোরিলেশন হাইলাইট করে। যেখানে ম্যাটপ্লটলিবে একটি পলিশড চার্টের জন্য ডজন দজন লাইন লাগতে পারে, সিবর্ন প্রায় এক বা দুটি লাইনে আকর্ষণীয় ডিফল্ট স্টাইলিং-এর সাথে একই ফলাফল দিতে পারে। এটি আপনার ডেটায় লুকানো ডিস্ট্রিবিউশন, কোরিলেশন এবং প্যাটার্ন প্রকাশ করতে দক্ষ।
এক্সেল প্রোদের জন্য মূল শক্তি:
- দ্রুত পরিসংখ্যানিক চার্ট তৈরি করুন
- এক্সপ্লোরেটরি ডেটা অ্যানালিসিসের জন্য ভালো কাজ করে
- কোরিলেশন হিটম্যাপ তৈরি করুন যাতে বুঝতে পারেন কলামগুলো একে অপরের সাথে কীভাবে রিলেটেড
- বিল্ট-ইন ডেনসিটি কার্ভসহ ডিস্ট্রিবিউশন প্লট তৈরি করুন
- বক্স প্লট এবং ভায়োলিন প্লট দিয়ে গ্রুপগুলো ভিজুয়ালি তুলনা করুন
- পেয়ার প্লট তৈরি করুন যা 넘েরিক কলাম জুড়ে অটোম্যাটিক্যালি স্ক্যাটারপ্লট ম্যাট্রিক্স তৈরি করে
- কনফিডেন্স ইন্টারভ্যালসহ রিগ্রেশন প্লট এক লাইনে জেনারেট করুন
উদাহরণ: একটি কোরিলেশন হিটম্যাপ তৈরি করা
আপনার এক্সেল ডেটায় লুকানো প্যাটার্ন খুঁজুন: কোন ভ্যারিয়েবলগুলো একসাথে মুভ করে? একটি হিটম্যাপ দ্রুত এই প্রশ্নের উত্তর দিতে পারে এবং এক্সেলের বিল্ট-ইন টুলের চেয়ে অনেক বেশি দূর যেতে পারে।
import pandas as pd import seaborn as sns import matplotlib.pyplot as plt df = pd.read_excel('SalesData.xlsx', sheet_name='CleanData') correlation = df.select_dtypes(include='number').corr() plt.figure(figsize=(10, 8)) sns.heatmap( correlation, annot=True, # প্রতিটি সেলে কোরিলেশন ভ্যালু দেখান fmt='.2f', cmap='coolwarm', # লাল = পজিটিভ, নীল = নেগেটিভ center=0, square=True, linewidths=0.5 ) plt.title('Correlation Matrix — Sales Variables', fontsize=14, fontweight='bold') plt.tight_layout() plt.savefig('correlation_heatmap.png', dpi=150) print('Heatmap saved!') 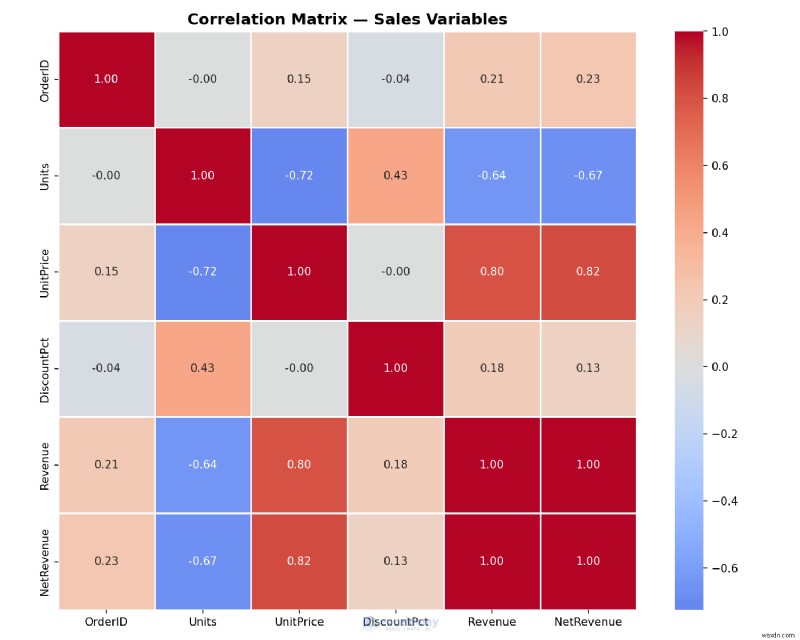
উদাহরণ: এক লাইনে বক্স প্লট তৈরি করা
আউটলিয়ার দ্রুত স্পট করতে অঞ্চল জুড়ে রেভিনিউ ডিস্ট্রিবিউশন তুলনা করুন।
plt.figure(figsize=(10, 6)) sns.boxplot(data=df, x='Region', y='NetRevenue', hue='Region', palette='Set2', legend=False) plt.title('Revenue Distribution by Region') plt.ylabel('Net Revenue ($)') plt.tight_layout() plt.savefig('region_boxplot.png', dpi=150) 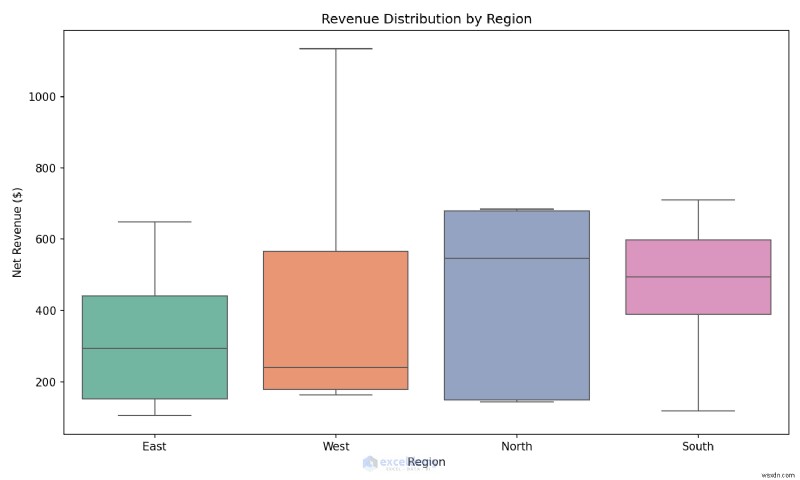
কখন ব্যবহার করবেন: এক্সপ্লোরেটরি অ্যানালিসিসের সময় সিবর্ন ব্যবহার করুন যখন আপনি ফর্মাল রিপোর্ট তৈরি করার আগে ডিস্ট্রিবিউশন, আউটলিয়ার এবং রিলেশনশিপ দ্রুত বুঝতে চান।
৫. সাইকিট-লার্ন (Scikit-learn) – এক্সেল ডেটার ওপর সরাসরি মেশিন লার্নিং
এই লাইব্রেরি আপনাকে রিপোর্টিং থেকে ডিসিশন সাপোর্টে নিয়ে যায়। সাইকিট-লার্ন আপনার এক্সেল ওয়ার্কফ্লোতে প্রফেশনাল মেশিন লার্নিং নিয়ে আসে। এটি এক্সেল ব্যবহারকারীদের জন্য প্রেডিক্টিভ অ্যানালিটিক্স সক্ষম করে, যার মধ্যে রয়েছে রিগ্রেশন, ক্লাসিফিকেশন, ক্লাস্টারিং এবং ফোরকাস্টিং যা নেটিভ এক্সেল সহজে হ্যান্ডেল করতে পারে না। এটি শুধু আপনার ডেটায় কী ঘটেছে তা বর্ণনা করার বদলে, এটি আপনাকে প্রেডিক্ট করতে সাহায্য করে কী ঘটতে পারে—সেলস ফোরকাস্টিং থেকে কাস্টমার ক্লাসিফাই করা পর্যন্ত এবং অ্যাআমালি ডিটেক্ট করা পর্যন্ত।
এক্সেল প্রোদের জন্য মূল শক্তি:
- লিনিয়ার এবং লজিস্টিক রিগ্রেশন নмериক আউটকাম বা ক্যাটাগরি প্রেডিক্ট করতে (যেমন চর্ন রিস্ক বা সেলস ফোরকাস্ট)
- ডিসিশন ট্রি এবং র্যান্ডম ফরেস্ট ইন্টারপ্রেটেবল প্রেডিকশনের জন্য
- কে-মিন্স ক্লাস্টারিং স্বয়ংক্রিয়ভাবে একই ধরনের রেকর্ড গ্রুপ করতে
- ট্রেন-টেস্ট স্প্লিটিং এবং ক্রস-ভ্যালিডেশন মডেল অ্যাকুরেসি মাপতে
- ফিচার স্কেলিং, এনকোডিং এবং প্রিপ্রসেসিং পাইপলাইন
- প্রেডিকশন এক্সেলে ফেরত দিন ফিল্টারিং এবং সোর্টিং-এর জন্য
উদাহরণ: নেট রেভিনিউ প্রেডিক্ট করা
আপনার ঐতিহাসিক সেলস ডেটার ওপর একটি মডেল ট্রেন করুন, তারপর নতুন অর্ডারের জন্য রেভিনিউ প্রেডিক্ট করতে ব্যবহার করুন—যা এক্সেল নেটিভলি পারফর্ম করতে পারে না।
import pandas as pd from sklearn.model_selection import train_test_split from sklearn.ensemble import RandomForestRegressor from sklearn.metrics import mean_absolute_error, r2_score from sklearn.preprocessing import LabelEncoder df = pd.read_excel('SalesData.xlsx', sheet_name='CleanData') # ক্যাটাগরিক্যাল কলামকে নম্বর হিসেবে এনকোড করুন for col in ['Region', 'Category', 'SalesRep']: if col in df.columns: df[col] = LabelEncoder().fit_transform(df[col].astype(str)) X = df[['Units', 'UnitPrice', 'DiscountPct', 'Region', 'Category']] y = df['NetRevenue'] # স্প্লিট: ৮০% ট্রেন, ২০% টেস্ট X_train, X_test, y_train, y_test = train_test_split( X, y, test_size=0.2, random_state=42 ) # র্যান্ডম ফরেস্ট মডেল ট্রেন করুন model = RandomForestRegressor(n_estimators=100, random_state=42) model.fit(X_train, y_train) # অ্যাকুরেসি ইভ্যালুয়েট করুন predictions = model.predict(X_test) print(f'Mean Absolute Error: ${mean_absolute_error(y_test, predictions):,.2f}') print(f'R² Score: {r2_score(y_test, predictions):.4f}') # প্রেডিকশন এক্সেলে এক্সপোর্ট করুন results = X_test.copy() results['Actual'] = y_test.values results['Predicted'] = predictions results.to_excel('predictions.xlsx', index=False) print('Predictions exported to predictions.xlsx') 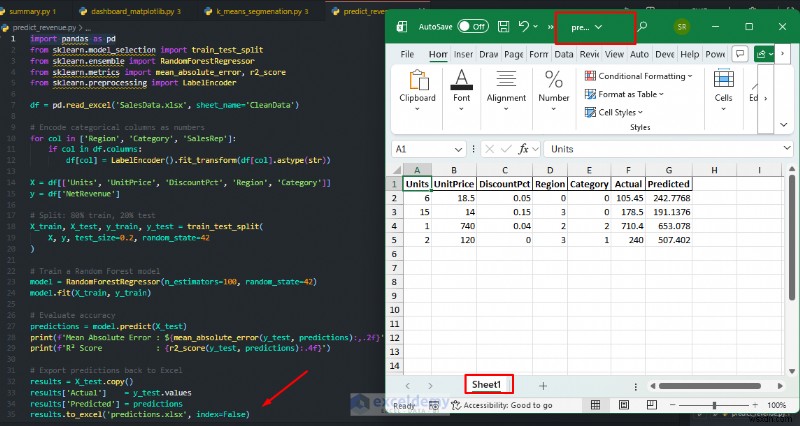
কে-মিন্স কাস্টমার সেগমেন্টেশন:
ক্রয় আচরণের ওপর ভিত্তি করে স্বয়ংক্রিয়ভাবে কাস্টমারকে গ্রুপে সেগমেন্ট করুন, কোনো ম্যানুয়াল ক্রাইটেরিয়া ছাড়া।
import pandas as pd from sklearn.cluster import KMeans from sklearn.preprocessing import StandardScaler df = pd.read_excel('SalesData.xlsx', sheet_name='CleanData') customer = df.groupby('Customer').agg( TotalOrders = ('OrderID', 'count'), TotalRevenue = ('NetRevenue', 'sum'), AvgDiscount = ('DiscountPct', 'mean') ).reset_index() X_scaled = StandardScaler().fit_transform( customer[['TotalOrders', 'TotalRevenue', 'AvgDiscount']] ) customer['Segment'] = KMeans(n_clusters=3, random_state=42, n_init=10) \ .fit_predict(X_scaled) customer.to_excel('customer_segments.xlsx', index=False) print('Segmentation complete! See customer_segments.xlsx') 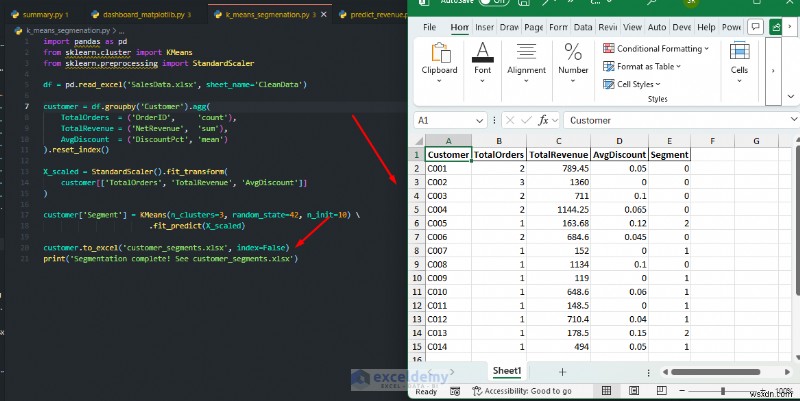
কখন ব্যবহার করবেন: আপনি প্রেডিকশনকে একটি ওয়ার্কশীতে রাইট ব্যাক করতে পারেন, তারপর এক্সেল ব্যবহারকারী ফিল্টার, সোর্ট, চার্ট, বা ফর্মুলা এবং কন্ডিশনাল ফরম্যাটিংয়ের সাথে ফলাফল কম্বাইন করতে পারেন। এটি প্রফেশনালদের স্প্রেডশীটে সরাসরি মেশিন লার্নিং ইনসাইট যোগ করতে দেয়। সাইকিট-লার্ন ব্যবহার করুন যখন আপনাকে ভবিষ্যৎ ভ্যালু ফোরকাস্ট করতে হবে, রেকর্ড ক্লাসিফাই করতে হবে, বা প্রাকৃতিক গ্রুপিং আবিষ্কার করতে হবে যা পিভট টেবিল প্রকাশ করতে পারে না।
বোনাস: এক্সেলউইংস (Xlwings) – দ্বিমুখী অটোমেশন এবং লাইভ এক্সেল ইন্টিগ্রেশন
xlwings লাইব্রেরি রিয়েল টাইমে একটি এক্সেল ইনস্ট্যান্স চালায়। এটি পাইথন এবং এক্সেলের ব্রিজ করে, সত্যিকারের অটোমেশন সক্ষম করে। যেখানে ওপেনপাইএক্সএল স্ট্যাটিক ফাইল পড়ে এবং লিখে, xlwings এক্সেল খুলতে পারে, সেটি লাইভ ম্যানিপুলেট করতে পারে, ভ্যালু পাইথনে ফেরত পাঠাতে পারে, এক্সেল বাটন থেকে পাইথন ফাংশন ট্রিগার করতে পারে, এবং পূর্ণ ইউডিএফ (ইউজার-ডিফাইনড ফাংশন) তৈরি করতে পারে যা সেলে দেখায়। এটি অনেক ভিবিএ-ভিত্তিক ওয়ার্কফ্লোর একটি আধুনিক বিকল্প।
এক্সেল প্রোদের জন্য মূল শক্তি:
- একটি লাইভ এক্সেল সেশন কন্ট্রোল করুন: প্রোগ্রাম্যাটিক্যালি ওয়ার্কবুক খুলুন, পড়ুন, লিখুন এবং বন্ধ করুন
- পাইথন ফাংশন লিখুন যা সরাসরি এক্সেল সেল থেকে ইউডিএফ হিসেবে কলযোগ্য
- রিপিটেটিভ টাস্ক অটোমেট করুন যেমন ডেটা রিফ্রেশ করা এবং রিপোর্ট জেনারেট করা
- প্যান্ডাস ডেটাফ্রেম এবং ম্যাটপ্লটলিব চার্ট সরাসরি নেমড রেঞ্জে পুশ করুন
- এক্সেল বাটন দ্বারা ট্রিগার হওয়া পাইথন স্ক্রিপ্ট চালান
- উইন্ডোজ এবং macOS উভয়েই কাজ করে
- পাইথন ইন এক্সেলের জন্য ডেস্কটপ ওয়ার্কফ্লোতে একটি শক্তিশালী বিকল্প বা সম্পূরক হিসেবে কাজ করে
xlwings ব্যবহার করুন যখন আপনাকে এক্সেলের সাথে লাইভ, টু-ওয়ে ইন্টারঅ্যাকশন দরকার, ভিবিএ ম্যাক্রো রিপ্লেস করতে হলে, ইন্টারঅ্যাক্টিভ ড্যাশবোর্ড বিল্ড করতে হলে, বা নন-টেকনিক্যাল সহকর্মীদের বাটন ক্লিক করে পাইথন অ্যানালিসিস ট্রিগার করতে দিতে হলে।
বিভিন্ন এক্সেল প্রোদের জন্য সেরা লাইব্রেরি স্ট্যাক বেছে নেওয়া
প্রতিটি অ্যানালিস্টকে একসাথে পাঁচটি লাইব্রেরি দরকার নয়। এদের গ্রহণ করার একটি প্র্যাক্টিক্যাল উপায় হলো ভূমিকা অনুযায়ী।
- রিপোর্টিং অ্যানালিস্টদের জন্য: এই কম্বিনেশন আপনাকে ডেটা ক্লিন করতে, সারামারি তৈরি করতে, চার্ট জেনারেট করতে এবং পলিশড ওয়ার্কবুক আউটপুট এক্সপোর্ট করতে দেয়।
- প্যান্ডাস
- ম্যাটপ্লটলিব
- ওপেনপাইএক্সএল
- ফাইন্যান্স এবং অপারেশন অ্যানালিস্টদের জন্য: এই স্ট্যাক মডেলিং, কেপিআই ক্যালকুলেশন, অ্যালোকেশন এবং রিপিটেবল মাসিক রিপোর্টিং-এর জন্য ভালো কাজ করে।
- প্যান্ডাস
- সিবর্ন
- ওপেনপাইএক্সএল
- উন্নত অ্যানালিটিক্স টিমের জন্য: এই কম্বিনেশন আপনাকে ডেটা প্রিপারেশন থেকে প্রেডিক্টিভ স্কোরিং পর্যন্ত পূর্ণ পাইপলাইন দেয়।
- প্যান্ডাস
- ম্যাটপ্লটলিব
- সাইকিট-লার্ন
- ওপেনপাইএক্সএল
- সিবর্ন
শেষ কথা
এই পাঁচটি পাইথন লাইব্রেরি উন্নত এক্সেল ডেটা বিশ্লেষণের জন্য প্রতিটি প্রো ব্যবহার করা উচিত। এই টুলগুলো মাস্টার করলে, আপনি এক্সেলকে একটি সাধারণ স্প্রেডশীট অ্যাপ্লিকেশন থেকে একটি আরও সক্ষম অ্যানালিটিক্স প্ল্যাটফর্মে রূপান্তরিত করতে পারেন। একটি যুক্তিসঙ্গত লার্নিং পাথ হলো প্যান্ডাস দিয়ে শুরু করা, তারপর ওপেনপাইএক্সএল যোগ করা, তারপর ম্যাটপ্লটলিব এবং সিবর্ন একসাথে শিখা, এবং সাইকিট-লার্নে যাওয়া। প্রতিটি লাইব্রেরি একই .xlsx ফাইলগুলোর সাথে কাজ করে যা আপনি ইতিমধ্যে ব্যবহার করছেন। এদের এক্সপ্লোর করা শুরু করুন আরও সক্ষম ডেটা অ্যানালিস্ট হতে।
নি:শুল্ক উন্নত এক্সেল এক্সারসাইজ সমাধানসহ পান!
