

মাইক্রোসফট ৩৬৫-এর পাইথন ইন এক্সেল একটি শক্তিশালী ফিচার যা আপনাকে এক্সেল সেলের ভিতরেই পাইথন কোড লিখতে এবং চালাতে দেয়। এটি পাইথন অ্যানালিটিক্সের শক্তি এক্সেলে নিয়ে আসে। আপনি সরাসরি একটি সেলে পাইথন টাইপ করেন, পাইথন ক্যালকুলেশন মাইক্রোসফট ক্লাউডে চলে, এবং ফলাফল ওয়ার্কশীতে ফেরত আসে। আপনি এক্সেলের পরিচিত ইন্টারফেস এবং রিক্যালকুলেশনকে পাইথনের সমৃদ্ধ ইকোসিস্টেমের সাথে জোড়া দিতে পারেন—ডেটা বিশ্লেষণ, ক্লিনিং, পরিসংখ্যান এবং ভিজ্যুয়ালাইজেশনের জন্য—স্প্রেডশীট ছাড়াই বা লোকালি কিছুই ইনস্টল না করেই।
এই টিউটোরিয়ালে আমরা দেখব কিভাবে এক্সেলে পাইথন ব্যবহার করবেন এবং এটি কখন এবং কীভাবে উপকারী। জুপিটার বা ভিএস কোডের মতো অন্যান্য টুলে স্যুইচ করার পরিবর্তে, আপনি এক্সেলের ভিতরেই সরাসরি পাইথন ব্যবহার করতে পারেন।
প্রয়োজনীয়তা এবং উপলব্ধতা
- মাইক্রোসফট ৩৬৫ সাবস্ক্রিপশন: অনেক পেইড প্ল্যানে উপলব্ধ (কনজিউমার ফ্যামিলি/পারসোনাল, কমার্শিয়াল, এডুকেশন, এন্টারপ্রাইজ)। কিছু ফিচার বা উচ্চতর কম্পিউটের জন্য অ্যাড-অন দরকার হতে পারে।
- প্ল্যাটফর্ম: প্রাথমিকভাবে উইন্ডোজ ডেস্কটপ এক্সেলে উপলব্ধ; ওয়েব, ম্যাক এবং মোবাইলের জন্য সমর্থন ভিন্ন। এক্সেল ফর আইপ্যাড, আইফোন বা অ্যান্ড্রয়েডে উপলব্ধ নয়।
- লোকাল পাইথন দরকার নেই: সবকিছু প্রি-ইনস্টল্ড লাইব্রেরির সাথে ক্লাউডে চলে। এক্সেলে পাইথন ব্যবহার করার জন্য আপনার কম্পিউটারে পাইথনের লোকাল ভার্সন থাকতে হবে না। আপনার লোকাল পাইথন ইনস্টলেশনে আপনি যে কাস্টমাইজেশন করেছেন সেগুলো পাইথন ইন এক্সেল ক্যালকুলেশনে প্রতিফলিত হবে না।
গুরুত্বপূর্ণ: এক্সেলে পাইথন ব্যবহার করতে ইন্টারনেট অ্যাক্সেস দরকার। কারণ পাইথন ইন এক্সেল ক্যালকুলেশন মাইক্রোসফট ক্লাউডে পাইথন ল্যাঙ্গুয়েজের একটি স্ট্যান্ডার্ড ভার্সন ব্যবহার করে চলে।
এক্সেলে পাইথন দিয়ে শুরু করা
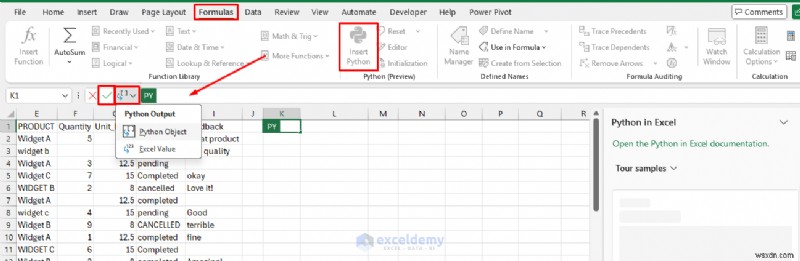
একটি সেলে পাইথন সক্ষম করুন:
- একটি সেল সিলেক্ট করুন
- ফর্মুলাস ট্যাবে যান >> ইনসার্ট পাইথন সিলেক্ট করুন
- বা একটি সেলে =PY টাইপ করে Tab চাপুন
- ফর্মুলা বার সবুজ হয়ে যাবে, যা পাইথন মোড ইঙ্গিত করে
xl() ফাংশন: এক্সেল এবং পাইথনকে ব্রিজ করা
এক্সেলে পাইথন ব্যবহার করার চাবিকাঠি হল xl() ফাংশন, যা আপনার পাইথন কোডকে আপনার স্প্রেডশীট থেকে সরাসরি ডেটা পড়তে দেয়:
- এডিট মোডে থাকাকালীন, একটি সেল বা রেঞ্জ সিলেক্ট করতে ক্লিক করে ড্র্যাগ করুন (যেমন A1:D100)
- এক্সেল xl(“A1:D100”) বা অনুরূপ একটি রেফারেন্স ইনসার্ট করে
# একটি রেঞ্জকে প্যান্ডাস ডেটাফ্রেম হিসেবে রেফারেন্স করুন
df = xl(“A1:D100”, headers=True)
# একটি সিঙ্গেল সেলের ভ্যালু রেফারেন্স করুন
target = xl(“F1”)
এইভাবে পাইথন আপনার স্প্রেডশীট ডেটা "দেখে"। আপনি এটি একটি =PY() সেলের ভিতরেই লিখেন এবং ফলাফলকে একটি সাধারণ পাইথন অবজেক্ট হিসেবে নিয়ে কাজ করেন।
আউটপুট অপশন:
- ফর্মুলা বারের ড্রপডাউন ব্যবহার করে এক্সেল ভ্যালু (নেটিভ এক্সেল সেল/টেবিলে কনভার্ট করে) রিটার্ন করুন বা পাইথন অবজেক্ট (অন্য পাইথন সেলে চেইনিং-এর জন্য) হিসেবে রাখুন
- Ctrl + Alt + Shift + M চাপে আউটপুট টাইপ টগল করুন
- ডিবাগিং বা কিছু কেসে আউটপুটের জন্য print() ব্যবহার করুন
রিক্যালকুলেশন: পাইথন সেলগুলি স্বয়ংক্রিয়ভাবে রিক্যালকুলেট হয়, অন্যান্য ফর্মুলার মতো, যখন ইনপুট পরিবর্তন হয় (অটোম্যাটিক মোডে)।
টিপ: ছোট থেকে শুরু করুন। আপনার ডেটা সিলেক্ট করুন, পাইথন ইনসার্ট করুন, এটিকে একটি ডেটাফ্রেমে কনভার্ট করুন, তারপর .head(), .describe(), বা সাধারণ অপারেশন দিয়ে এক্সপ্লোর করুন।
এক্সেলে পাইথন কখন উপকারী
১. উন্নত ডেটা ক্লিনিং এবং ট্রান্সফরমেশন
পাইথন सहজে 엉망 ডেটি ঠিক করতে পারে, টেক্সট стандарডাইজ করতে পারে (ক্যাপিটালাইজেশন, স্পেসিং), নাল এবং ডুপ্লিকেট হ্যান্ডল করতে পারে, ওয়াইড ডেটাকে লং ফরম্যাটে আনপিভট করতে পারে, এবং ইনকনসিস্টেন্ট ফরম্যাট বা মিসিং ভ্যালু ম্যানেজ করতে পারে। প্যান্ডাস এই কাজগুলো সংক্ষিপ্ত এবং পুনরাবৃত্তি-যোগ্য করে তোলে।
পাইথন:
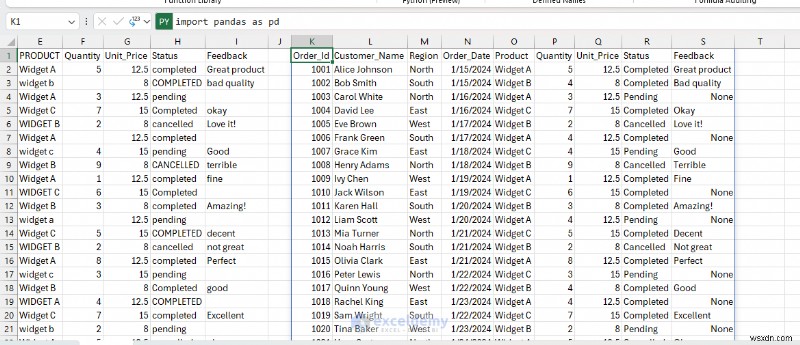
import pandas as pd df = xl("A1:I56", headers=True) df.columns = df.columns.str.strip().str.title() # নাম ঠিক করুন: টাইটেল কেস df["Customer_Name"] = df["Customer_Name"].str.strip().str.title() # অঞ্চল ঠিক করুন: টাইটেল কেস df["Region"] = df["Region"].str.strip().str.title() # পণ্য стандарডাইজ করুন: টাইটেল কেস df["Product"] = df["Product"].str.strip().str.title() # স্ট্যাটাস এবং ফিডব্যাক стандарডাইজ করুন df["Status"] = df["Status"].str.strip().str.capitalize() df["Feedback"] = df["Feedback"].str.strip().str.capitalize() # সব 엉망 ডেট ফরম্যাটকে একটি ফরম্যাটে পার্স করুন df["Order_Date"] = pd.to_datetime(df["Order_Date"], dayfirst=True, errors="coerce") # মিসিং কোয়ান্টিটি মেডিয়ান দিয়ে ফিল করুন df["Quantity"] = pd.to_numeric(df["Quantity"], errors="coerce") df["Quantity"] = df["Quantity"].fillna(df["Quantity"].median()) df - টিক মার্ক ক্লিক করুন বা Ctrl+Enter চাপুন কোড চালানোর জন্য
- আউটপুট সেলের কার্ড আইকনে ক্লিক করুন >> arrayPreview সিলেক্ট করুন
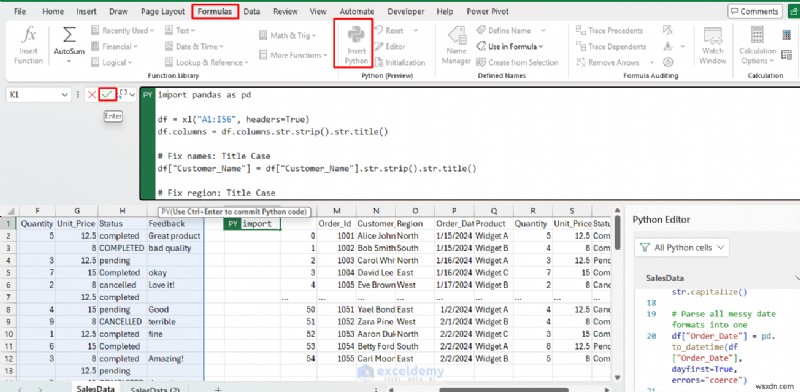
ক্লিন করা ডেটাফ্রেম স্বয়ংক্রিয়ভাবে শীটে ফিরে পড়ে। ফলাফলকে এক্সেল ভ্যালু হিসেবে রিটার্ন করুন যাতে ক্লিন ডেটা ব্যবহার করে আপনি আরও বিশ্লেষণ এবং ক্যালকুলেশন করতে পারেন।
- ফর্মুলা বার থেকে ড্রপডাউন এক্সপ্যান্ড করুন >> এক্সেল ভ্যালু সিলেক্ট করুন
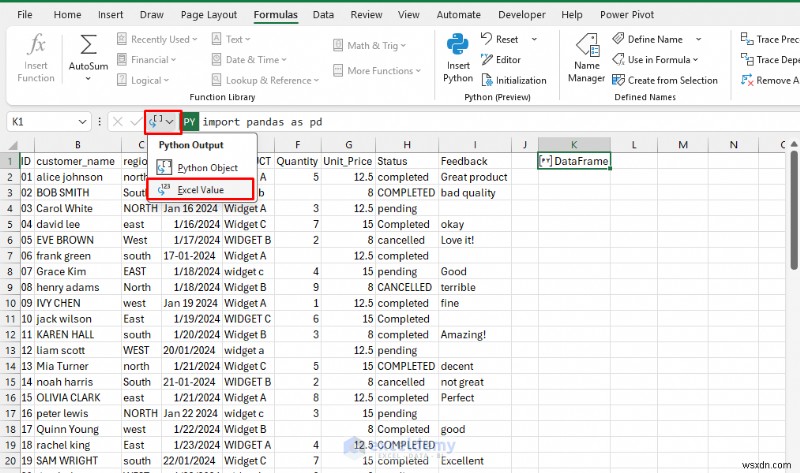
- এখন অন্যান্য উদাহরণগুলিতে নতুন, ক্লিন ডেটা ব্যবহার করুন
২. জটিল ডেটা বিশ্লেষণ এবং পরিসংখ্যান
পাইথন এক্সেলের বিল্ট-ইন ফাংশনের বাইরে অপারেশন সক্ষম করে, যার মধ্যে রয়েছে জটিল গ্রুপিং, মাল্টি-স্টেপ ট্রান্সফরমেশন, এবং পরিসংখ্যানিক সারাংশ। এটি টাইম-সিরিজ বিশ্লেষণ, রিগ্রেশন, ক্লাস্টারিং, আউটলিয়ার ডিটেকশন, টেক্সটে সেনটিমেন্ট বিশ্লেষণ এবং মন্টে কার্লো সিমুলেশনও সমর্থন করে।
পাইথন:
import pandas as pd # SalesData শীট থেকে ডেটা লোড করুন df = xl("SalesData!K1:S156", headers=True) df["Revenue"] = df["Quantity"] * df["Unit_Price"] # রেভিনিউ সারমারি + আউটলিয়ার ফ্ল্যাগ (> ২ স্ট্যান্ডার্ড ডেভিয়েশন) summary = df.groupby("Region")["Revenue"].agg(["sum", "mean", "std"]) summary["outlier_threshold"] = summary["mean"] + 2 * summary["std"] summary.round(2) ফলাফল সরাসরি আপনার শীটে একটি টেবিল হিসেবে ফিরে পড়ে। আপনি পুরো ডেটাফ্রেমের জন্য সারাংশ পরিসংখ্যান দেখাতে df.describe()ও ব্যবহার করতে পারেন।
পাইথন:
import pandas as pd # SalesData শীট থেকে ডেটা লোড করুন df = xl("SalesData!K1:S156", headers=True) df["Revenue"] = df["Quantity"] * df["Unit_Price"] df.describe() 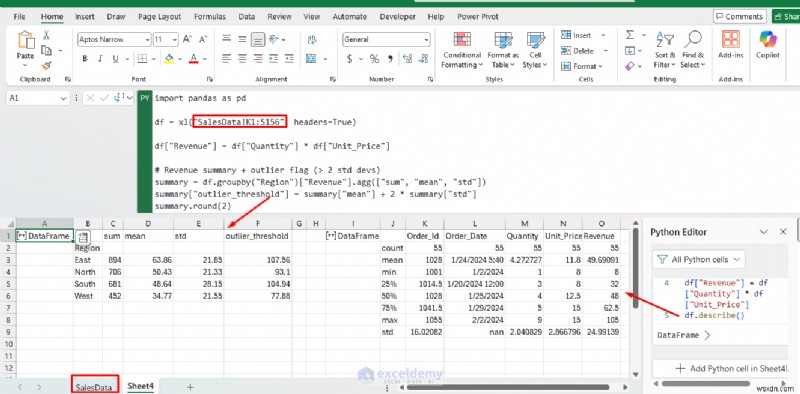
৩. উন্নত চার্ট এবং ভিজ্যুয়ালাইজেশন
ম্যাটপ্লটলিব, সিবর্ন, বা প্লটনাইন ব্যবহার করে ডেনসিটি প্লট, সোয়ার্ম প্লট, ওয়ার্ড ক্লাউড, বা স্মল মাল্টিপলসের মতো প্রফেশনাল প্লোট তৈরি করা সহজ। এগুলি এক্সেল চার্টের চেয়ে कहीं বেশি ফ্লেক্সিবল। ম্যাটপ্লটলিব এবং সিবর্ন দিয়ে এক্সেলের নেটিভ চার্টের বাইরে যান:
পাইথন:
import pandas as pd import matplotlib.pyplot as plt import seaborn as sns # SalesData শীট থেকে ডেটা লোড করুন df = xl("SalesData!K1:S156", headers=True) df["Revenue"] = df["Quantity"] * df["Unit_Price"] fig, ax = plt.subplots(figsize=(8, 4)) sns.boxplot(data=df, x="Region", y="Revenue", palette="Set2", ax=ax) ax.set_title("Revenue Distribution by Region") ax.set_xlabel("Region") ax.set_ylabel("Revenue ($)") fig 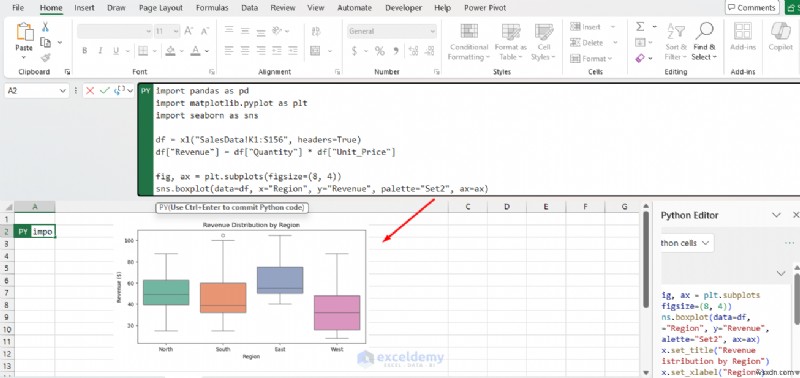
চার্টটি একটি ইমেজ অবজেক্ট হিসেবে ওয়ার্কশীতে রেন্ডার হয়, যেটি যেকোনো এক্সেল চার্টের মতো রিসাইজ এবং রিপজিশন করা যায়।
৪. আপনার স্প্রেডশীট ডেটায় মেশিন লার্নিং
পাইথন প্রেডিক্টিভ মডেলিং এবং ফোরকাস্টিং সক্ষম করে। আপনি স্ট্যাটসমডেলস বা সাইকিট-লার্ন ব্যবহার করে সরাসরি আপনার এক্সেল ডেটার ওপর আরও সঠিক ফোরকাস্ট বা সাধারণ মেশিন লার্নিং মডেল তৈরি করতে পারেন।
এক্সেল ছাড়াই প্রেডিক্টিভ মডেল চালান:
পাইথন:
import pandas as pd from sklearn.linear_model import LinearRegression # SalesData শীট থেকে ডেটা লোড করুন df = xl("SalesData!K1:S156", headers=True) # न्यumeric কনভার্ট করুন এবং মিসিং ভ্যালু মেডিয়ান দিয়ে ফিল করুন df["Quantity"] = pd.to_numeric(df["Quantity"], errors="coerce") df["Unit_Price"] = pd.to_numeric(df["Unit_Price"], errors="coerce") df["Quantity"] = df["Quantity"].fillna(df["Quantity"].median()) df["Unit_Price"] = df["Unit_Price"].fillna(df["Unit_Price"].median()) # রেভিনিউ ক্যালকুলেট করুন df["Revenue"] = df["Quantity"] * df["Unit_Price"] # পণ্য ওয়ান-হট এনকোড করুন X = pd.get_dummies(df[["Product", "Unit_Price"]], drop_first=True) y = df["Revenue"] # লিনিয়ার রিগ্রেশন মডেল ফিট করুন model = LinearRegression().fit(X, y) # প্রেডিকশন যোগ করুন df["Predicted_Revenue"] = model.predict(X).round(2) # উপযোগী কলাম সহ ফাইনাল রেজাল্ট তৈরি করুন result = df[["Order_Id", "Product", "Revenue", "Predicted_Revenue"]].copy() result["Difference"] = (result["Revenue"] - result["Predicted_Revenue"]).round(2) # ঐচ্ছিক: মডেল পারফরম্যান্স দেখান print("Model R² Score:", round(model.score(X, y), 4)) result 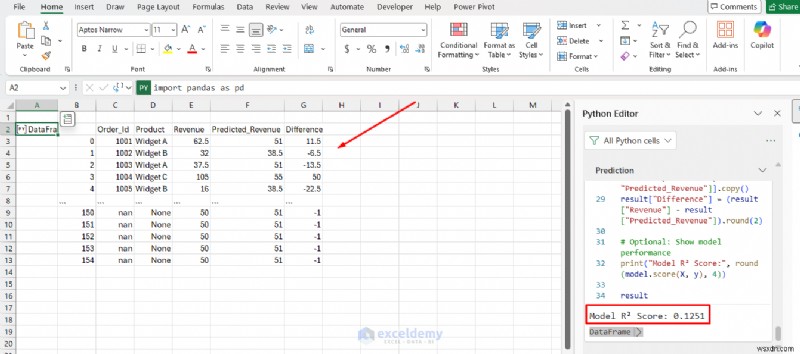
বিজনেস অ্যানালিস্টরা আলাদা এনভায়রনমেন্টে স্যুইচ না করে তাদের বিদ্যমান ডেটায় মেশিন লার্নিং মডেল প্রয়োগ করতে পারেন।
৫. রোলিং ক্যালকুলেশন এবং টাইম সিরিজ
শুধু এক্সেল ফর্মুলা ব্যবহার করে মুভিং এভারেজ, কমিউলেটিভ সাম, বা ল্যাগ ফিচার ক্যালকুলেট করা কঠিন। পাইথন এই কাজগুলো সহজ করে দেয়।
পাইথন:
import pandas as pd # আপনার পূর্ণ সেলস ডেটা লোড করুন df = xl("SalesData!K1:S156", headers=True) # ডেইলি রেভিনিউ ক্যালকুলেট করুন df["Revenue"] = df["Quantity"] * df["Unit_Price"] # রোলিং ক্যালকুলেশন (টাইম সিরিজ) # প্রথমে ডেট অনুযায়ী সোর্ট করুন (টাইম সিরিজের জন্য গুরুত্বপূর্ণ) df = df.sort_values("Order_Date").reset_index(drop=True) # রেভিনিউর ওপর ৭-দিনের রোলিং মেট্রিকস (সাপ্তাহিক ট্রেন্ড) df["Revenue_7d_Mean"] = df["Revenue"].rolling(window=7, min_periods=1).mean().round(2) df["Revenue_7d_Sum"] = df["Revenue"].rolling(window=7, min_periods=1).sum().round(2) df["Revenue_7d_Max"] = df["Revenue"].rolling(window=7, min_periods=1).max().round(2) df["Revenue_7d_Std"] = df["Revenue"].rolling(window=7, min_periods=1).std().round(2) # ৩০-দিনের রোলিং মিন (মাসিক ট্রেন্ড) df["Revenue_30d_Mean"] = df["Revenue"].rolling(window=30, min_periods=1).mean().round(2) # কমিউলেটিভ রেভিনিউ (রানিং টোটাল) df["Cumulative_Revenue"] = df["Revenue"].cumsum().round(2) # প্রদর্শনের জন্য কলাম সিলেক্ট করুন result = df[["Order_Id", "Order_Date", "Product", "Revenue", "Revenue_7d_Mean", "Revenue_7d_Sum", "Revenue_30d_Mean", "Cumulative_Revenue"]] result এই পদ্ধতি সেলস ট্রেন্ড বিশ্লেষণ, ডেইলি বা সাপ্তাহিক ফ্লাকচুয়েশন স্মুথ করা, অ্যাআমালি ডিটেক্ট করা এবং মোমেন্টাম ফোরকাস্ট করার জন্য উপযোগী।
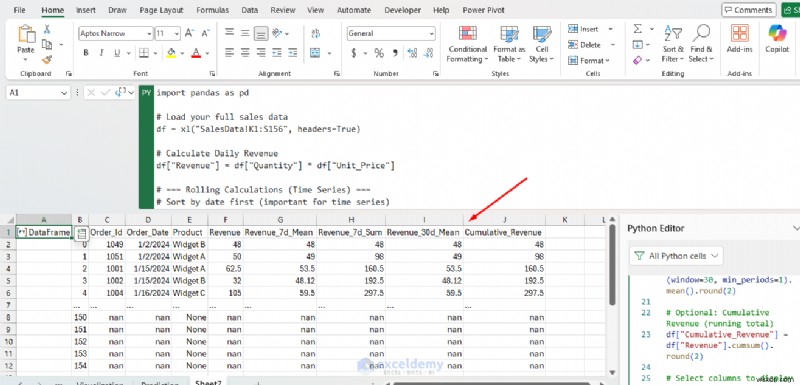
- Revenue_7d_Mean: ৭-দিনের মুভিং এভারেজ (সাপ্তাহিক সেলস ট্রেন্ড স্মুথ করে)
- Revenue_7d_Sum: গত ৭ দিনের মোট রেভিনিউ
- Revenue_30d_Mean: ৩০-দিনের মুভিং এভারেজ (দীর্ঘমেয়াদী ট্রেন্ড)
- Cumulative_Revenue: ঐ ডেট পর্যন্ত সমস্ত রেভিনিউর রানিং টোটাল
টিপস এবং সেরা অনুশীলন
- সেল চেইন করুন: পূর্ববর্তী পাইথন অবজেক্টকে রেফারেন্স করুন (তারা ভ্যারিয়েবল হিসেবে দেখায়) যাতে একক সেল গুলো না করে মাল্টি-স্টেপ ওয়ার্কফ্লো তৈরি করতে পারেন
- পারফরম্যান্স: ভারী কম্পিউটেশনের জন্য, ক্লাউড কোটার প্রতি সচেতন रहুন। বড় কাজগুলো ধাপে ভাগ করুন বা প্রিমিয়াম কম্পিউট ব্যবহার করুন
- নিরাপত্তা: কোড আইসোলেটেড ক্লাউড কন্টেইনারে চলে। সংবেদনশীল অপারেশন এড়িয়ান; মাইক্রোসফট গোপনীয়তা ম্যানেজ করে
- ডিবাগিং: print() ব্যবহার করুন বা ধাপে ধাপে ডেটাফ্রেম আউটপুট করুন। এরর সেলে দেখাবে
- এক্সেলের সাথে কম্বাইন করুন: ভারী লিফটিং-এর জন্য পাইথন এবং ফরম্যাটিং, পিভট, বা ড্যাশবোর্ডের জন্য এক্সেল ব্যবহার করুন
- লার্নিং কার্ভ: আপনি যদি পাইথনে নতুন হন, তবে প্রথমে প্যান্ডাসের ওপর ফোকাস করুন। অনেক ফ্রি টিউটোরিয়াল এবং স্যাম্পল ফাইল উপলব্ধ
- শেয়ারিং: কম্প্যাটিবল মাইক্রোসফট ৩৬৫ পান filem সম্মুখীন ব্যক্তি ফলাফল দেখতে বা রিফ্রেশ করতে পারেন; অন্যদের জন্য ফলাফল স্ট্যাটিক ভ্যালুতে কনভার্ট হয়
জেনা উচিত সীমাবদ্ধতা
- শুধু ক্লাউড-ভিত্তিক এক্সিকিউশন; ইন্টারনেট সংযোগ আবশ্যক
- স্ট্যান্ডার্ড প্ল্যানে কম্পিউট কোটা
- পাইথন এনভায়রনমেন্ট আনাকন্ডা-ম্যানেজড; আপনি নিজের প্যাকেজ ইনস্টল করতে পারবেন না বা লোকাল কাস্টমাইজেশন ব্যবহার করতে পারবেন না
- মোবাইল এবং ওয়েব সাপোর্ট ডেস্কটপের তুলনায় সীমিত
- খুব বড় ডেটাসেট বা দীর্ঘ সময় চলা কোড টাইমআউটের শিকার হতে পারে
উপসংহার
পাইথন ইন এক্সেল সবচেয়ে বেশি উপকারী হয় যখন আপনার কাজ মৌলিকভাবে স্প্রেডশীট-ভিত্তিক থাকে, কিন্তু বিশ্লেষণটি আরও উন্নত হয়ে যাচ্ছে। এটি ডেটা ক্লিনিং, ডেটাফ্রেম-স্টাইল বিশ্লেষণ, উন্নত পরিসংখ্যান এবং ভিজ্যুয়ালাইজেশনে দক্ষ। এটি দৈনন্দিন স্প্রেডশীট কাজের জন্য কম উপযোগী, যা এক্সেলই ভালোভাবে হ্যান্ডেল করে। পাইথন ইন এক্সেল স্প্রেডশীট ব্যবহারকারী এবং ডেটা সায়েন্টিস্টের মধ্যে ব্যবধান পূরণ করে, পরিচিত ওয়ার্কফ্লো বিঘ্নিত না করে উন্নত অ্যানালিটিক্সকে সুলভ করে তোলে। এক্সেলকে পাইথন দিয়ে রিপ্লেস করার বদলে, সিলেক্টিভলি পাইথন ব্যবহার করুন যখন বিশ্লেষণ ফর্মুলার জন্য খুব জটিল হয়ে যায়।
নি:শুল্ক উন্নত এক্সেল এক্সারসাইজ সমাধানসহ পান!
