

লিনিয়ার রিগ্রেশন সম্পর্কে
সিম্পল লিনিয়ার রিগ্রেশনের মূলভূমিকা
দুই চলক (continuous variable) এর মধ্যে সম্পর্ক বোঝার সুযোগ দেয়।
উদাহরণ:
x = স্বাধীন ভেরিয়েবল (যেমন: ওজন)
y = আশ্রিত ভেরিয়েবল (যেমন: উচ্চতা)
সূত্র: y = αx + β
একটি প্রোগ্রামের মাধ্যমে সিম্পল লিনিয়ার রিগ্রেশন বুঝি:
# Simple linear regression
import numpy as np
import matplotlib.pyplot as plt
np.random.seed(1)
n = 70
x = np.random.randn(n)
y = x * np.random.randn(n)
colors = np.random.rand(n)
plt.plot(np.unique(x), np.poly1d(np.polyfit(x, y, 1))(np.unique(x)))
plt.scatter(x, y, c=colors, alpha=0.5)
plt.show()
আউটপুট
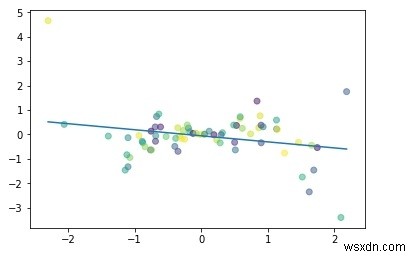
লিনিয়ার রিগ্রেশনের উদ্দেশ্য:
পয়েন্টগুলো এবং রেখা (y = αx + β) এর মধ্যে দূরত্ব ন্যূনতম করা।
সমন্বয় করা:
গুণক (Coefficient): α
ইন্টারসেপ্ট/বায়াস (Intercept/Bias): β
PyTorch দিয়ে লিনিয়ার রিগ্রেশন মডেল তৈরি
মান লেইয়া যাক, আমাদের গুণক (α) হলো ২ এবং ইন্টারসেপ্ট (β) হলো ১। তাহলে সমীকরণটি হবে:
y = 2x + 1 # লিনিয়ার মডেল
ডেটাসেট তৈরি
x_values = [i for i in range(11)]
x_values
আউটপুট
[0, 1, 2, 3, 4, 5, 6, 7, 8, 9, 10]
# নামপাই (numpy) এ কনভার্ট
x_train = np.array(x_values, dtype=np.float32)
x_train.shape
আউটপুট
(11,)
# গুরুত্বপূর্ণ: ২D অ্যারে প্রয়োজন
x_train = x_train.reshape(-1, 1)
x_train.shape
আউটপুট
(11, 1)
y_values = [2*i + 1 for i in x_values]
y_values
আউটপুট
[1, 3, 5, 7, 9, 11, 13, 15, 17, 19, 21]
# লিস্ট ইটারেশন
y_values = []
for i in x_values:
    result = 2*i + 1
    y_values.append(result)
y_values
আউটপুট
[1, 3, 5, 7, 9, 11, 13, 15, 17, 19, 21]
y_train = np.array(y_values, dtype=np.float32)
y_train.shape
আউটপুট
(11,)
# ২D প্রয়োজন
y_train = y_train.reshape(-1, 1)
y_train.shape
আউটপুট
(11, 1)
মডেল তৈরি
# লাইব্রেরি ইম্পোর্ট
import torch
import torch.nn as nn
from torch.autograd import Variable

# মডেল ক্লাস তৈরি
class LinearRegModel(nn.Module):
    def __init__(self, input_size, output_size):
        super(LinearRegModel, self).__init__()
        self.linear = nn.Linear(input_size, output_size)
    def forward(self, x):
        out = self.linear(x)
        return out

input_dim = 1
output_dim = 1
model = LinearRegModel(input_dim, output_dim)
criterion = nn.MSELoss()
learning_rate = 0.01
optimizer = torch.optim.SGD(model.parameters(), lr=learning_rate)
epochs = 100

for epoch in range(epochs):
    epoch += 1
    # নামপাই অ্যারে থেকে টর্চ ভেরিয়েবলে কনভার্ট
    inputs = Variable(torch.from_numpy(x_train))
    labels = Variable(torch.from_numpy(y_train))
    # গ্রেডিয়েন্ট ক্লিয়ার
    optimizer.zero_grad()
    # ফরওয়ার্ড পাস
    outputs = model.forward(inputs)
    # লস ক্যালকুলেট
    loss = criterion(outputs, labels)
    # ব্যাকওয়ার্ড পাস
    loss.backward()
    # প্যারামিটার আপডেট
    optimizer.step()
    print('epoch {}, loss {}'.format(epoch, loss.item()))
আউটপুট
epoch 1, loss 276.7417907714844
epoch 2, loss 22.601360321044922
epoch 3, loss 1.8716105222702026
epoch 4, loss 0.18043726682662964
epoch 5, loss 0.04218350350856781
epoch 6, loss 0.03060017339885235
epoch 7, loss 0.02935197949409485
epoch 8, loss 0.02895027957856655
epoch 9, loss 0.028620922937989235
epoch 10, loss 0.02830091118812561
......
epoch 94, loss 0.011018744669854641
epoch 95, loss 0.010895680636167526
epoch 96, loss 0.010774039663374424
epoch 97, loss 0.010653747245669365
epoch 98, loss 0.010534750297665596
epoch 99, loss 0.010417098179459572
epoch 100, loss 0.010300817899405956
দেখা যাচ্ছে, লস (loss) ইপক ১ থেকে ১০০ পর্যন্ত উল্লেখযোগ্যভাবে কমেছে।
গ্রাফ প্লট করা
# বিশুদ্ধ ইনফারেন্স
predicted = model(Variable(torch.from_numpy(x_train))).data.numpy()

# ফিগার ক্লিয়ার
plt.clf()
# প্রিডিকশন পাওয়া
predicted = model(Variable(torch.from_numpy(x_train))).data.numpy()
# সত্য ডেটা প্লট
plt.plot(x_train, y_train, 'go', label='True data', alpha=0.5)
# প্রিডিকশন প্লট
plt.plot(x_train, predicted, '--', label='Predictions', alpha=0.5)
# লেজেন্ড ও প্লট
plt.legend(loc='best')
plt.show()
আউটপুট
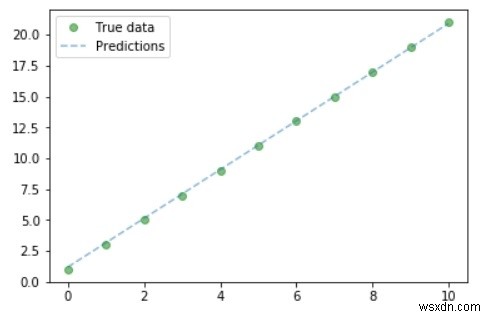
গ্রাফ থেকে দেখা যাচ্ছে যে আমাদের সত্য এবং প্রিডিক্ট করা মান почти মিলতুল্য।
