

আমরা যে অনেক সিদ্ধান্ত নেই সেগুলো সংখ্যাসূচক সম্পর্কের চারপাশে ঘোরে।
- আমরা কিছু নির্দিষ্ট খাবার খাই কারণ বিজ্ঞান বলে সেগুলো কোলেস্টরল কমাতে সাহায্য করে
- আমরা শিক্ষা এগিয়ে নেই কারণ আমাদের বেশি স্যালারি পাওয়ার সম্ভাবনা বেশি
- আমরা সেটা নোবরহুডে বাসা কিনি যেটার ভ্যালু সবচেয়ে বেশি বেড়বে বলে মনে করি
আমরা এই নিষ্কর্ষগুলো কীভাবে পাই? সবচেয়ে সম্ভবত কেউ বড় পরিমাণ ডেটা সংগ্রহ করে সেটা থেকে নিষ্কর্ষ টানা। একটি সাধারণ টেকনিক হলো লিনিয়ার রিগ্রেশন (linear regression), যা সুপারভাইজড লার্নিং (supervised learning) এর একটি রূপ। সুপারভাইজড লার্নিং সম্পর্কে আরো জানতে এবং এর ব্যবহারের উদাহরণের জন্য, এই সিরিজের পার্ট ১ দেখুন।
লিনিয়ার সম্পর্ক (Linear Relationships)
দুটি মান—কলে সেগুলো x এবং y—যদি লিনিয়ার সম্পর্কে থাকে, তাহলে x-কে ১ দিয়ে পরিবর্তন করলে y সবসময় একটি নির্দিষ্ট পরিমাণে পরিবর্তন হবে। উদাহরণ দিলে সহজ হবে:
- ১০টি পিজা ১টি পিজার দামের ১০ গুণ কেনে।
- ১০ ফুটের দেওয়াল ৫ ফুটের দেওয়ালের চেয়ে দ্বিগুণ রং লাগে।
গাণিতিকভাবে, এই ধরণের সম্পর্ককে একটি লাইন সমীকরণ দিয়ে বর্ণনা করা হয়:
y = mx + b গণিত ভয়ঙ্কর গুল্লামেলে যেতে পারে, কিন্তু অনেক সময় এটা যাদু মনে হয় আমার কাছে। যখন আমি প্রথম লাইনের সমীকরণ শিখলাম, তখন মনে করেছিলাম কত সুন্দর—শুধু একটি ফর্মুলা দিয়ে দূরত্ব, ঢাল (slope), এবং লাইনের অন্যান্য পয়েন্ট ক্যালকুলেট করা যায়।
তবে আপনি এই ফর্মুলা কীভাবে পাবেন, যদি আপনার पास শুধু ডেটা পয়েন্ট থাকে? উত্তর হলো লিনিয়ার রিগ্রেশন—একটি খুব জনপ্রিয় মেশিন লার্নিং টুল।
লিনিয়ার রিগ্রেশন উদাহরণ
এই পোস্টে, আমরা এক্সপ্লোর করব একটি গানের বিটস পার মিনিট (BPM) কি স্পটিফাই-এ তার জনপ্রিয়তা প্রিডিক্ট করতে পারে।
লিনিয়ার রিগ্রেশন দুটি ভেরিয়েবলের মধ্যে সম্পর্ক মডেল করে। একটিকে "এক্সপ্লানেটরি ভেরিয়েবল" (explanatory variable) এবং অন্যটিকে "ডিপেন্ডেন্ট ভেরিয়েবল" (dependent variable) বলা হয়।
আমাদের উদাহরণে, আমরা চাই BPM "ব্যাখ্যা" করে জনপ্রিয়তাকে। তাই BPM হবে আমাদের এক্সপ্লানেটরি ভেরিয়েবল। এটাই জনপ্রিয়তাকে ডিপেন্ডেন্ট ভেরিয়েবল বানিয়ে দেয়।
মডেলটি লিস্ট স্কোয়ার রিগ্রেশন (least-squares regression) ব্যবহার করে সেরা ফিটিং লাইন খুঁজে বের করবে, যার ফর্ম আপনি حدস করেছেন, y = mx + b।
যদিও একাধিক এক্সপ্লানেটরি ভেরিয়েবল থাকতে পারে, এই উদাহরণে আমরা সিম্পল লিনিয়ার রিগ্রেশন করব যেখানে শুধু একটি আছে।
লিস্ট স্কোয়ার (Least-Squares) কী?
লিনিয়ার রিগ্রেশন করার অনেক উপায় আছে। 그중 একটি হলো "লিস্ট-স্কোয়ার"। এটা সেরা ফিটিং লাইন খুঁজে বের করে প্রতিটি ডেটা পয়েন্ট থেকে লাইন পর্যন্ত লম্ব দূরত্বের বর্গের যোগফল ন্যূনতম করে।
এটা শুনতে গুল্লামেলে যেতে পারে, কিন্তু বাসিক্যালি এটা শুধু বলে, "আমার জন্য একটি লাইন বানাও যেটা ডেটা পয়েন্টগুলোর সাথে লাইনের মাঝপথের দূরত্ব ন্যূনতম করবে।"
বর্গ করা এবং যোগ করার কারণ হলো পজিটিভ এবং নেগেটিভ মান একে অপর ক্যেন্সেল করে না দেয়া।
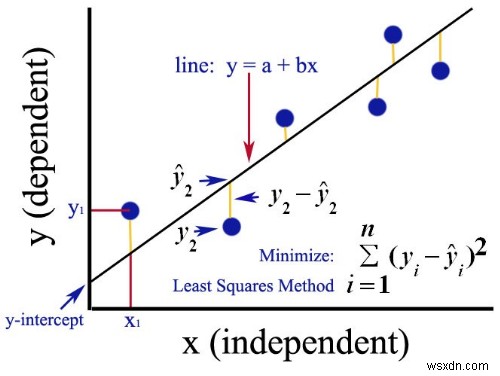
এখানে কোরা (Quora)-তে পাওয়া একটি ছবি আছে যা এটা খুব ভালোভাবে এক্সপ্লেইন করে।
ডেটাসেট (The Dataset)
আমরা ক্যাগল (Kaggle)-এর এই ডেটাসেট ব্যবহার করব: https://www.kaggle.com/leonardopena/top50spotify2019 আপনি এটা CSV হিসেবে ডাউনলোড করতে পারেন।
ডেটাসেটে ১৬টি কলাম আছে; তবে আমাদের কেবল তিনটি খেয়াল—"ট্র্যাক নেম" (Track Name), "বিটস পার মিনিট" (Beats Per Minute), এবং "জনপ্রিয়তা" (Popularity)। মেশিন লার্নিং-এ সবচেয়ে গুরুত্বপূর্ণ ধাপের একটি হলো ডেটা সঠিকভাবে ফরম্যাট করা, যাকে প্রায়শই "মাংজিং" (munging) বলা হয়। আপনি উপরের তিনটি কলাম ছাড়া বাকি সব ডেটা ডিলিট করতে পারেন।
আপনার CSV এর মোটামুটি এমন দেখাবে: 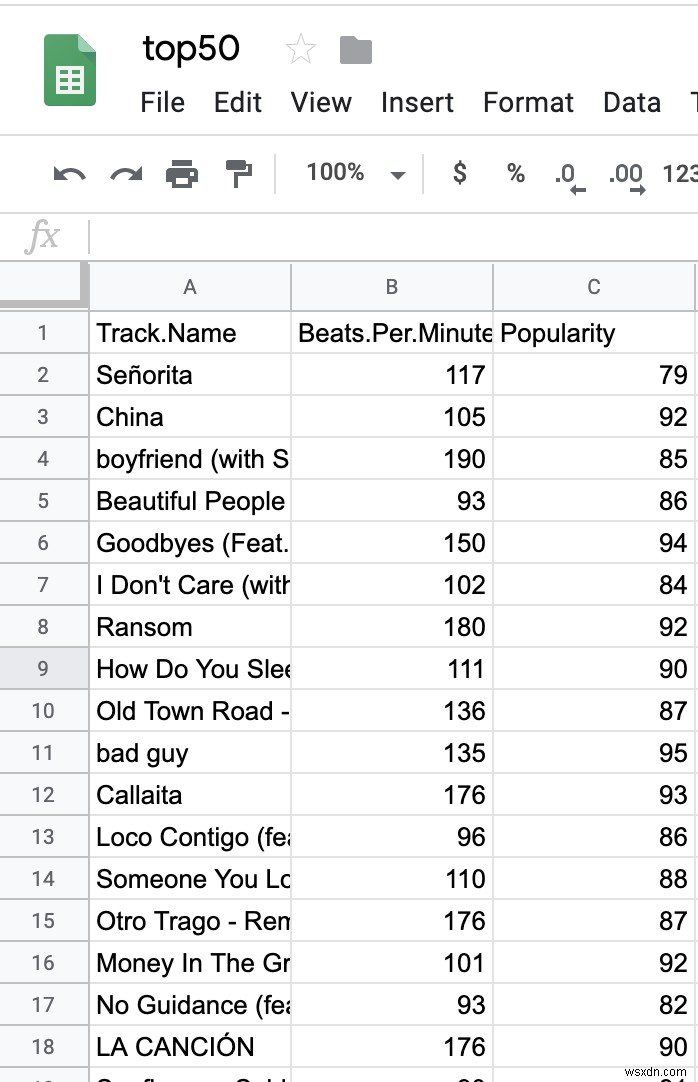
রুবি দিয়ে রিগ্রেশন করা
এই উদাহরণে, আমরা ruby_linear_regression জেম ব্যবহার করব। ইনস্টল করতে রান করুন:
gem install ruby_linear_regression ওকে, আমরা কোডিং শুরু করতে পারি! একটি নতুন রুবি ফাইল তৈরি করুন এবং এই রিকোয়ার যোগ করুন:
require "ruby_linear_regression" require "csv" পরবর্তী, আমরা আমাদের CSV ডেটা পড়ব এবং #shift কল করব, হেডার রো ডিসকার্ড করার জন্য। অথবা, আপনি শুধু CSV ফাইল থেকে প্রথম রো ডিলিট করতে পারেন।
csv = CSV.read("top50.csv") csv.shift আমাদের x-ডেটা পয়েন্ট এবং y-ডেটা পয়েন্ট রাখার জন্য দুটি খালি অ্যারে তৈরি করি।
x_data = [] y_data = [] ...এবং আমরা .each মেথড দিয়ে ইটারেট করব Beats Per Minute ডেটা আমাদের x অ্যারেতে এবং Popularity ডেটা y অ্যারেতে যোগ করার জন্য।
আপনি যদি কৌতূহলী হন আসলে এখানে কী হচ্ছে, আপনি আপনার
rowলগ করে দেখতে পারেনputsবাpদিয়ে। উদাহরণ:puts row
csv.each do |row| x_data.push( [row[1].to_i] ) y_data.push( row[2].to_i ) end এখন ruby_linear_regression জেম ব্যবহার করার পালা। আমরা আমাদের রিগ্রেশন মডেলের একটি নতুন ইনস্ট্যান্স তৈরি করব, ডেটা লোড করব, এবং মডেল ট্রেন করব:
linear_regression = RubyLinearRegression.new linear_regression.load_training_data(x_data, y_data) linear_regression.train_normal_equation পরবর্তী, আমরা মিন স্কোয়ার এরর (MSE) প্রিন্ট করব—যেটা অবজার্ভড মান এবং প্রিডিক্টেড মানের মধ্যে পার্থক্যের মাপ। পার্থক্যটা বর্গ করা হয় যাতে নেগেটিভ এবং পজিটিভ মান একে অপর ক্যেন্সেল করে না দেয়। আমরা MSE ন্যূনতম রাখতে চাই কারণ আমরা চাই না আমাদের প্রিডিক্টেড এবং একচুত মানগুলির মধ্যে দূরত্ব বড় হোক।
puts "Trained model with the following cost fit #{linear_regression.compute_cost}" শেষে, কম্পিউটারকে আমাদের মডেল ব্যবহার করে প্রিডিকশন করতে বলব। নির্দিষ্টভাবে, ২৫০ BPM বিশিষ্ট একটি গানের জনপ্রিয়তা কত? prediction_data অ্যারেতে আপনার ইচ্ছামতো ভ্যালু দিয়ে পরীক্ষা করতে পারেন।
prediction_data = [250] predicted_popularity = linear_regression.predict(prediction_data) puts "Predicted popularity: #{predicted_popularity.round}" ফলাফল (Results)
চলুন প্রোগ্রামটি কনসোলে রান করি এবং দেখি কী পাই!
➜ ~ ruby spotify_regression.rb Trained model with the following cost fit 9.504882197447587 Predicted popularity: 91 বাড়িয়ে! এখন "২৫০" কে "৫০" করে দেই এবং দেখি আমাদের মডেল কী প্রিডিক্ট করে।
➜ ~ ruby spotify_regression.rb Trained model with the following cost fit 9.504882197447587 Predicted popularity: 86 দেখাচ্ছে বেশি বিটস পার মিনিট বিশিষ্ট গানগুলো বেশি জনপ্রিয়।
সম্পূর্ণ প্রোগ্রাম (Entire Program)
আমার পুরো ফাইলটি এরকম দেখাচ্ছে:
require 'csv' require 'ruby_linear_regression' x_data = [] y_data = [] csv = CSV.read("top50.csv") csv.shift # Load data from CSV file into two arrays -- one for independent variables X (x_data) and one for the dependent variable y (y_data) # Row[0] = title # Row[1] = BPM # Row[2] = Popularity csv.each do |row| x_data.push( [row[1].to_i] ) y_data.push( row[2].to_i ) end # Create regression model linear_regression = RubyLinearRegression.new # Load training data linear_regression.load_training_data(x_data, y_data) # Train the model using the normal equation linear_regression.train_normal_equation # Output the cost puts "Trained model with the following cost fit #{linear_regression.compute_cost}" # Predict the popularity of a song with 250 BPM prediction_data = [250] predicted_popularity = linear_regression.predict(prediction_data) puts "Predicted popularity: #{predicted_popularity.round}" পরবর্তী ধাপ (Next Steps)
এটা একটি খুব সহজ উদাহরণ, কিন্তু তবুও, আপনি ঠিকই আপনার প্রথম লিনিয়ার রিগ্রেশন রান করেছেন, যা মেশিন লার্নিং-এ একটি কী টেকনিক। আপনি যদি আরও জানতে চান, তবে এখানে কিছু ক şey করতে পারেন: - আমরা যে রুবি জেমটি ব্যবহার করলাম তার সোর্স কোড চেক করুন যাতে মাথার নিচে কী ম্যাথ হচ্ছে সেটা দেখতে পান - মূল ডেটাসেটে ফিরে যান এবং মডেলে অতিরিক্ত ভেরিয়েবল যোগ করে মাল্টি-ভেরিয়েবল লিনিয়ার রিগ্রেশন রান করুন দেখতে আমাদের MSE কমে কিনা। উদাহরণস্বরূপ, হয়তো "ভ্যালেন্স" (valence - গানটি কতটুকু পজিটিভ) জনপ্রিয়তায় ভূমিকা রাখে। - গ্রেডিয়েন্ট ডিসেন্ট (gradient descent) মডেল ট্রাই করুন, যা ruby_linear_regression জেম দিয়েও রান করা যায়।
