

ওয়েব স্ক্র্যাপিং শুধু ডেটা সায়েন্স প্রেমীদের আকর্ষণ করে না, বরং যারা ওয়েবসাইটের গভীরে গিয়ে ডেটা বের করতে চান তাদের জন্যও এটি আকর্ষণীয়। পাইথনে অনেক ওয়েব স্ক্র্যাপিং লাইব্রেরি রয়েছে, যেনঃ
Scrapy
Urllib
BeautifulSoup
Selenium
Python Requests
LXML
এখানে আমরা পাইথনের lxml লাইব্রেরি নিয়ে আলোচনা করব, যা libxml2 XML পার্সিং লাইব্রেরির (C-তে লিখিত) উপরে নির্মিত। এটি বিউটিফুল সূপ (BeautifulSoup) চেয়ে দ্রুত, কিন্তু কিছু কম্পিউটারে (বিশেষ করে উইন্ডোজে) ইনস্টল করা কিছুটা কঠিন।
lxml ইনস্টল ও ইম্পোর্ট করা
কমান্ড লাইন থেকে pip দিয়ে lxml ইনস্টল করা যায়:
pip install lxml
অথবা কন্ডা (conda) ব্যবহার করে:
conda install -c anaconda lxml
ইনস্টলেশন সম্পন্ন হলে, lxml-এ থেকে html মডিউল ইম্পোর্ট করুন, যা HTML পার্স করে:
>>> from lxml import html
আপনি যে পেজটি স্ক্র্যাপ করতে চান তার সোর্স কোড রিট্রিভ করতে হবে। এখানে দুটি বিকল্প রয়েছে: পাইথন requests লাইব্রেরি বা urllib ব্যবহার করে পুরো পেজের HTML ধারণকারী একটি lxml HTML এলিমেন্ট অবজেক্ট তৈরি করা। আমরা requests লাইব্রেরি ব্যবহার করে পেজের HTML কন্টেন্ট ডাউনলোড করব।
পাইথন requests ইনস্টল করতে টার্মিনালে নিচের কমান্ড চালান:
$ pipenv install requests
Yahoo Finance থেকে ডেটা স্ক্র্যাপ করা
মান লেইয়া যাক, আমরা https://finance.yahoo.com/quote/msft থেকে মাইক্রোসফট কর্পোরেশনের স্টক/ইকুইটি ডেটা স্ক্র্যাপ করতে চাই। নিচে Yahoo Finance-এর স্ক্রিনশট দেওয়া হলো:
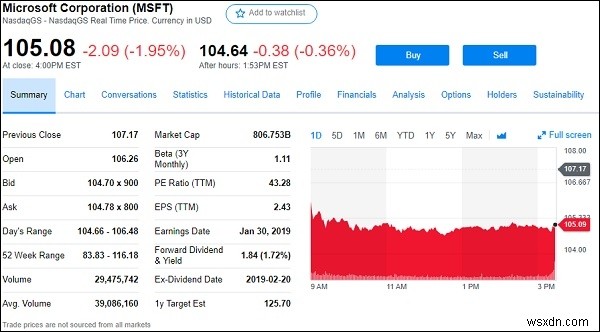
উপরের পেজ থেকে আমরা স্টকের সব видиম ফিল্ড এক্সট্র্যাক্ট করব, যেনঃ
Previous Close, Open, Bid, Ask, Day's range, 52-week range, Volume এবং আরও অনেক কিছু।
নিচে পাইথন lxml মডিউল ব্যবহার করে এই কাজটি করার কোড দেওয়া হলো:
lxml_scrape3.py
from lxml import html
import requests
from time import sleep
import json
import argparse
from collections import OrderedDict
def parse(ticker):
url = "https://finance.yahoo.com/quote/%s?p=%s" % (ticker, ticker)
response = requests.get(url, verify=False)
print("Parsing %s" % (url))
sleep(4)
parser = html.fromstring(response.text)
summary_table = parser.xpath('//div[contains(@data-test,"summary-table")]//tr')
summary_data = OrderedDict()
other_details_json_link = "https://query2.finance.yahoo.com/v10/finance/quoteSummary/{0}?formatted=true&lang=en-US®ion=US&modules=summaryProfile%2CfinancialData%2CrecommendationTrend%2CupgradeDowngradeHistory%2Cearnings%2CdefaultKeyStatistics%2CcalendarEvents&corsDomain=finance.yahoo.com".format(ticker)
summary_json_response = requests.get(other_details_json_link)
try:
json_loaded_summary = json.loads(summary_json_response.text)
y_Target_Est = json_loaded_summary["quoteSummary"]["result"][0]["financialData"]["targetMeanPrice"]['raw']
earnings_list = json_loaded_summary["quoteSummary"]["result"][0]["calendarEvents"]['earnings']
eps = json_loaded_summary["quoteSummary"]["result"][0]["defaultKeyStatistics"]["trailingEps"]['raw']
datelist = []
for i in earnings_list['earningsDate']:
datelist.append(i['fmt'])
earnings_date = ' to '.join(datelist)
for table_data in summary_table:
raw_table_key = table_data.xpath('.//td[contains(@class,"C(black)")]//text()')
raw_table_value = table_data.xpath('.//td[contains(@class,"Ta(end)")]//text()')
table_key = ''.join(raw_table_key).strip()
table_value = ''.join(raw_table_value).strip()
summary_data.update({table_key: table_value})
summary_data.update({'1y Target Est': y_Target_Est, 'EPS (TTM)': eps, 'Earnings Date': earnings_date, 'ticker': ticker, 'url': url})
return summary_data
except:
print("Failed to parse json response")
return {"error": "Failed to parse json response"}
if __name__ == "__main__":
argparser = argparse.ArgumentParser()
argparser.add_argument('ticker', help='')
args = argparser.parse_args()
ticker = args.ticker
print("Fetching data for %s" % (ticker))
scraped_data = parse(ticker)
print("Writing data to output file")
with open('%s-summary.json' % (ticker), 'w') as fp:
json.dump(scraped_data, fp, indent=4)
উপরের কোড চালাতে কমান্ড টার্মিনালে নিচের কমান্ডটি টাইপ করুন:
c:\Python\Python361>python lxml_scrape3.py MSFT
lxml_scrap3.py চালালে, আপনার বর্তমান ওয়ার্কিং ডিরেক্টরিতে `
নিচে আউটপুটের স্ক্রিনশট দেওয়া হলো:
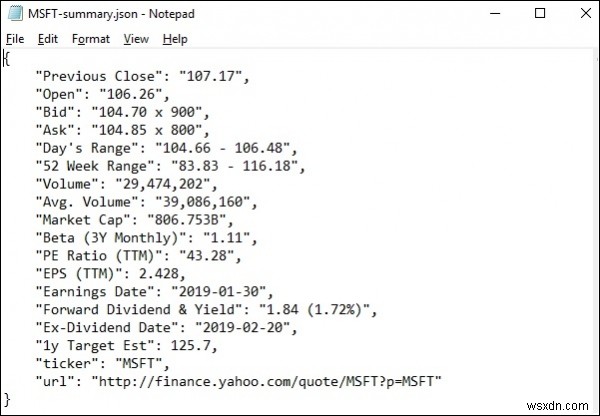
সফলভাবে Yahoo Finance থেকে মাইক্রোসফটের প্রয়োজনীয় সব ডেটা lxml এবং requests দিয়ে স্ক্র্যাপ করা হয়েছে এবং পরে স্টক প্রাইস মুভমেন্ট বিশ্লেষণ বা শেয়ার করার জন্য ফাইলে সেভ করা হয়েছে।
