

এখানে আমরা PyTorch ব্যবহার করে MNIST ডেটাসেট দিয়ে হস্তলিখিত অঙ্ক ক্লাসিফায়ার ট্রেন করব।
MNIST হলো হস্তলিখিত ক্লাসিফিকেশনের জন্য ব্যাপকভাবে ব্যবহৃত একটি ডেটাসেট যাতে ৭০ হাজারের বেশি লেবেলযুক্ত ২৮x২৮ পিক্সেলের গ্রে-স্কেল ছবি থাকে। এতে প্রায় ৬০ হাজার ট্রেনিং এবং ১০ হাজার টেস্ট ইমেজ আছে। আমাদের কাজ ৬০ হাজার ট্রেনিং ইমেজ দিয়ে মডেল ট্রেন করে ১০ হাজার টেস্ট ইমেজে ক্লাসিফিকেশন একুরেসি যাচাই করা।
ইনস্টলেশন
প্রথমে MXNet লেটেস্ট ভার্সন ইন্সটল করুন:
$pip install mxnet
দूसरे, torch এবং torchvision লাইব্রেরি প্রয়োজন। না থাকলে পিপ দিয়ে ইন্সটল করুন।
লাইব্রেরি ইম্পোর্ট
import torch
import torchvision
MNIST ডেটাসেট লোড করুন
প্রোগ্রাম শুরু করার আগে MNIST ডেটাসেট লোড করি এবং হাইপারপ্যারামিটার ডিফাইন করি।
# n_epochs = পুরো ট্রেনিং ডেটাসেটের ওপর কতবার লুপ হবে
n_epochs = 3
batch_size_train = 64
batch_size_test = 1000

# অপটিমাইজারের জন্য লার্নিং রেট ও মোমেন্টাম
learning_rate = 0.01
momentum = 0.5
log_interval = 10
random_seed = 1

torch.backends.cudnn.enabled = False
torch.manual_seed(random_seed)
এখন TorchVision দিয়ে MNIST ডেটাসেট লোড করি। ট্রেনিংয়ের জন্য ব্যাচ সাইজ ৬৪ এবং টেস্টের জন্য ১০০০। নরমালাইজেশনের জন্য MNIST-এর মিন ০.১৩০৭ এবং স্ট্যান্ডার্ড ডевиয়েশন ০.৩০৮১ ব্যবহার করব।
train_loader = torch.utils.data.DataLoader(
    torchvision.datasets.MNIST('/files/', train=True, download=True,
        transform=torchvision.transforms.Compose([
            torchvision.transforms.ToTensor(),
            torchvision.transforms.Normalize((0.1307,), (0.3081,))
        ])
    ),
    batch_size=batch_size_train, shuffle=True)

test_loader = torch.utils.data.DataLoader(
    torchvision.datasets.MNIST('/files/', train=False, download=True,
        transform=torchvision.transforms.Compose([
            torchvision.transforms.ToTensor(),
            torchvision.transforms.Normalize((0.1307,), (0.3081,))
        ])
    ),
    batch_size=batch_size_test, shuffle=True)
আউটপুট
Downloading https://yann.lecun.com/exdb/mnist/train-images-idx3-ubyte.gz
Downloading https://yann.lecun.com/exdb/mnist/train-labels-idx1-ubyte.gz
Downloading https://yann.lecun.com/exdb/mnist/t10k-images-idx3-ubyte.gz
Downloading https://yann.lecun.com/exdb/mnist/t10k-labels-idx1-ubyte.gz
Processing... Done!
টেস্ট ডেটা লোড করতে test_loader ব্যবহার করুন:
examples = enumerate(test_loader)
batch_idx, (example_data, example_targets) = next(examples)
example_data.shape
আউটপুট
torch.Size([1000, 1, 28, 28])
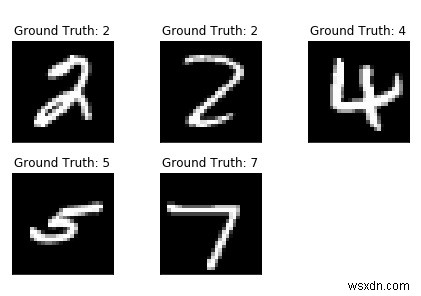
আউটপুট থেকে দেখা যাচ্ছে একটি টেস্ট ব্যাচ হলো [১০০০, ১, ২৮, ২৮] আকারের টেনসর—অর্থাৎ ১০০০টি উদাহরণ, ২৮x২৮ পিক্সেল, গ্রে-স্কেল।
Matplotlib দিয়ে কিছু ডেটা প্লট করুন:
import matplotlib.pyplot as plt
fig = plt.figure()
for i in range(5):
    plt.subplot(2, 3, i+1)
    plt.tight_layout()
    plt.imshow(example_data[i][0], cmap='gray', interpolation='none')
    plt.title("Ground Truth: {}".format(example_targets[i]))
    plt.xticks([])
    plt.yticks([])
print(fig)
আউটপুট
নেটওয়ার্ক তৈরি
২-ডি কনভোলিউশনাল লেয়ার এবং দুটি ফুলি-কানেক্টেড লেয়ার দিয়ে নেটওয়ার্ক বানাব।
import torch.nn as nn
import torch.nn.functional as F
import torch.optim as optim

class Net(nn.Module):
    def __init__(self):
        super(Net, self).__init__()
        self.conv1 = nn.Conv2d(1, 10, kernel_size=5)
        self.conv2 = nn.Conv2d(10, 20, kernel_size=5)
        self.conv2_drop = nn.Dropout2d()
        self.fc1 = nn.Linear(320, 50)
        self.fc2 = nn.Linear(50, 10)

    def forward(self, x):
        x = F.relu(F.max_pool2d(self.conv1(x), 2))
        x = F.relu(F.max_pool2d(self.conv2_drop(self.conv2(x)), 2))
        x = x.view(-1, 320)
        x = F.relu(self.fc1(x))
        x = F.dropout(x, training=self.training)
        x = self.fc2(x)
        return F.log_softmax(x)

# নেটওয়ার্ক ও অপটিমাইজার ইনিশিয়ালাইজ
network = Net()
optimizer = optim.SGD(network.parameters(), lr=learning_rate, momentum=momentum)
মডেল ট্রেনিং
train_losses = []
train_counter = []
test_losses = []
test_counter = [i*len(train_loader.dataset) for i in range(n_epochs + 1)]

def train(epoch):
    network.train()
    for batch_idx, (data, target) in enumerate(train_loader):
        optimizer.zero_grad()
        output = network(data)
        loss = F.nll_loss(output, target)
        loss.backward()
        optimizer.step()
        if batch_idx % log_interval == 0:
            print('Train Epoch: {} [{}/{} ({:.0f}%)]\tLoss: {:.6f}'.format(
                epoch, batch_idx * len(data), len(train_loader.dataset),
                100. * batch_idx / len(train_loader), loss.item()))
            train_losses.append(loss.item())
            train_counter.append((batch_idx*64) + ((epoch-1)*len(train_loader.dataset)))
            torch.save(network.state_dict(), '/results/model.pth')
            torch.save(optimizer.state_dict(), '/results/optimizer.pth')

def test():
    network.eval()
    test_loss = 0
    correct = 0
    with torch.no_grad():
        for data, target in test_loader:
            output = network(data)
            test_loss += F.nll_loss(output, target, size_average=False).item()
            pred = output.data.max(1, keepdim=True)[1]
            correct += pred.eq(target.data.view_as(pred)).sum()
    test_loss /= len(test_loader.dataset)
    test_losses.append(test_loss)
    print('\nTest set: Avg. loss: {:.4f}, Accuracy: {}/{} ({:.0f}%)\n'.format(
        test_loss, correct, len(test_loader.dataset),
        100. * correct / len(test_loader.dataset)))

# ট্রেনিং চালান
test()
for epoch in range(1, n_epochs + 1):
    train(epoch)
    test()
আউটপুট
Test set: Avg. loss: 2.3048, Accuracy: 1063/10000 (10%)
Train Epoch: 1 [0/60000 (0%)] Loss: 2.294911
...
Train Epoch: 3 [59520/60000 (99%)] Loss: 0.318569
Test set: Avg. loss: 0.0912, Accuracy: 9716/10000 (97%)
মডেল পারফরম্যান্স মূল্যায়ন
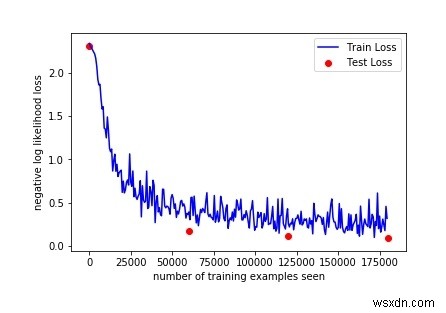
শুধু ৩ ইপকের ট্রেনিংয়ে টেস্ট সেটে ৯৭% একুরেসি পেয়েছি। র্যান্ডম ইনিশিয়ালাইজেশন থেকে ১০% একুরেসি থেকে শুরু করে ট্রেনিংয়ের পর ৯৭% এ পৌঁছেছে।
ট্রেনিং কার্ভ প্লট করুন:
fig = plt.figure()
plt.plot(train_counter, train_losses, color='blue')
plt.scatter(test_counter, test_losses, color='red')
plt.legend(['Train Loss', 'Test Loss'], loc='upper right')
plt.xlabel('number of training examples seen')
plt.ylabel('negative log likelihood loss')
fig
আউটপুট
কुछ আরো উদাহরণ চালিয়ে মডেলের প্রেডিকশন চেক করুন:
with torch.no_grad():
    output = network(example_data)
fig = plt.figure()
for i in range(6):
    plt.subplot(2, 3, i+1)
    plt.tight_layout()
    plt.imshow(example_data[i][0], cmap='gray', interpolation='none')
    plt.title("Prediction: {}".format(output.data.max(1, keepdim=True)[1][i].item()))
    plt.xticks([])
    plt.yticks([])
fig
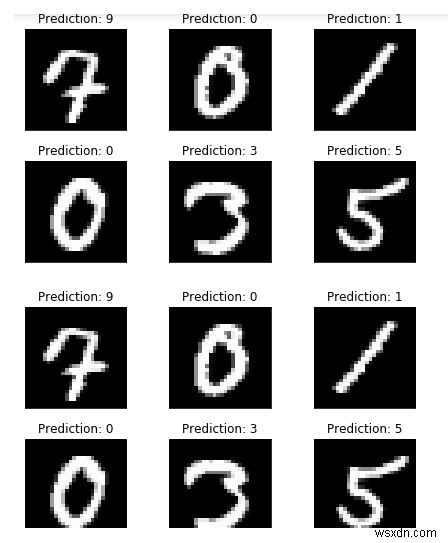
মডেলের প্রেডিকশন খুবই সঠিক দেখাচ্ছে।
