পাইথনে ডেটা অ্যানালাইসিস ও ভিজ্যুয়ালাইজেশনের জন্য অনেক লাইব্রেরি রয়েছে—মূলত numpy, pandas, matplotlib, seaborn ইত্যাদি। এই সেকশনে pandas লাইব্রেরি দিয়ে ডেটা অ্যানালাইসিস ও ভিজ্যুয়ালাইজেশন আলোচনা করব, যা numpy-এর ওপর তৈরি একটি ওপেন সোর্স লাইব্রেরি।
এটি দ্রুত অ্যানালাইসিস, ডেটা ক্লিনিং ও প্রিপারেশন করতে দেয়। Pandas-এর বিল্ট-ইন ভিজ্যুয়ালাইজেশন ফিচারও আছে যা নিচে দেখানো হলো।
ইনস্টলেশন
Pandas ইনস্টল করতে টার্মিনালে চালান:
pip install pandas
Anaconda থাকলে:
conda install pandas
Pandas — DataFrames
Pandas-এ কাজ করার মুখ্য টুল হলো DataFrame।
কোড
import numpy as np
import pandas as pd
from numpy.random import randn
np.random.seed(50)
df = pd.DataFrame(randn(6,4), ['a','b','c','d','e','f'], ['w','x','y','z'])
df
আউটপুট
| w | x | y | z | |
|---|---|---|---|---|
| a | -1.560352 | -0.030978 | -0.620928 | -1.464580 |
| b | 1.411946 | -0.476732 | -0.780469 | 1.070268 |
| c | -1.282293 | -1.327479 | 0.126338 | 0.862194 |
| d | 0.696737 | -0.334565 | -0.997526 | 1.598908 |
| e | 3.314075 | 0.987770 | 0.123866 | 0.742785 |
| f | -0.393956 | 0.148116 | -0.412234 | -0.160715 |
Pandas — মিসিং ডেটা হ্যান্ডলিং
Pandas-এ মিসিং ডেটা (NaN) হ্যান্ডল করার সুবিধাজনক পদ্ধতিগুলো:
import numpy as np
import pandas as pd
from numpy.random import randn

d = {'A': [1,2,np.nan], 'B': [9, np.nan, np.nan], 'C': [1,4,9]}
df = pd.DataFrame(d)
df
আউটপুট
| A | B | C | |
|---|---|---|---|
| 0 | 1.0 | 9.0 | 1 |
| 1 | 2.0 | NaN | 4 |
| 2 | NaN | NaN | 9 |
উপরে ৩টি মিসিং ভ্যালু আছে।
df.dropna()মিসিং ভ্যালুযুক্ত সারি ড্রপ করলেও শুধু প্রথম সারি থাকে।
df.dropna(axis=1)মিসিং ভ্যালুযুক্ত কলাম ড্রপ করলে শুধু কলাম C থাকে।
df.dropna(thresh=2)কমপক্ষে ২টি নন-নাল ভ্যালু থাকা সারি রাখা হয়।
df.fillna(value=df.mean())মিসিং ভ্যালু গড় দিয়ে পূরণ করা হয়।
Pandas — ডেটা ইম্পোর্ট (CSV পড়া)
লোকাল মেশিন বা ওয়েব থেকে CSV ফাইল পড়া যায়।
import pandas as pd
df = pd.read_csv("SYB61_T03_Population Growth Rates in Urban areas and Capital cities.csv", encoding="ISO-8859-1")
df.head()
আউটপুট
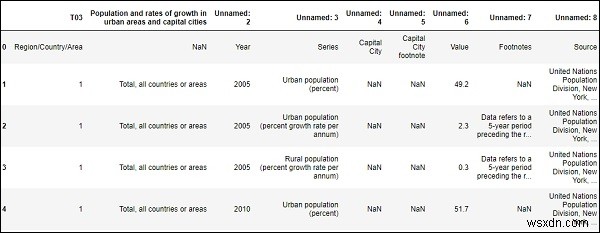
ডেটাফ্রেমের সারি ও কলাম সংখ্যা জানতে:
df.shape
আউটপুট
(4166, 9)
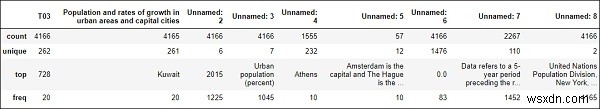
Pandas — DataFrame ম্যাথ (স্ট্যাটিস্টিক্স)
df.describe()
আউটপুট
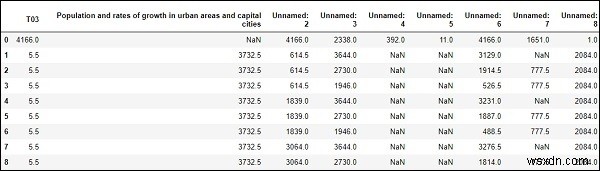
df.rank()
আউটপুট
Pandas — গ্রাফ প্লট
import matplotlib.pyplot as plt
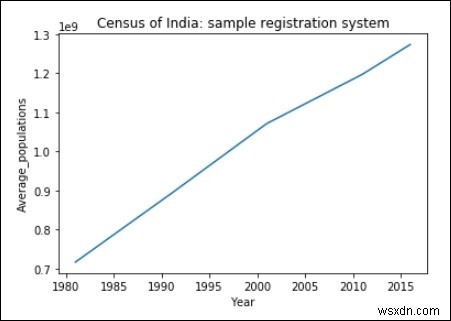
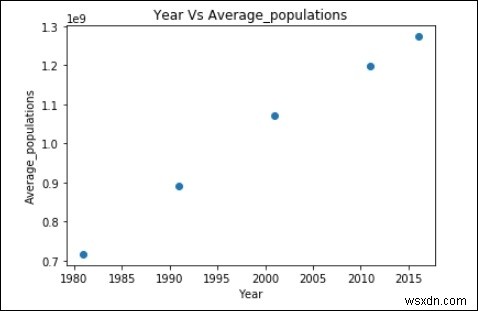
years = [1981, 1991, 2001, 2011, 2016]
Average_populations = [716493000, 891910000, 1071374000, 1197658000, 1273986000]
plt.plot(years, Average_populations)
plt.title("Census of India: sample registration system")
plt.xlabel("Year")
plt.ylabel("Average_populations")
plt.show()
আউটপুট
স্ক্যাটার প্লট
plt.scatter(years, Average_populations)
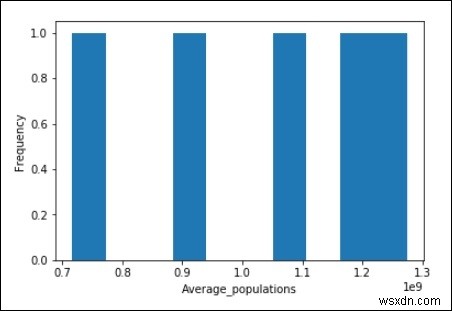
হিস্টোগ্রাম
import matplotlib.pyplot as plt
Average_populations = [716493000, 891910000, 1071374000, 1197658000, 1273986000]
plt.hist(Average_populations, bins=10)
plt.xlabel("Average_populations")
plt.ylabel("Frequency")
plt.show()