Pandas ডেটা সায়েন্স ও অ্যানালিটিক্সের জন্য পাইথনের সবচেয়ে জনপ্রিয় লাইব্রেরির একটি। Pandas লাইব্রেরি ডেটা ম্যানিপুলেশন, অ্যানালিসিস ও ক্লিনিংয়ের জন্য ব্যবহৃত হয়। এটি নিম্ন-স্তরের NumPy-এর ওপর একটি হাই-লেভেল অ্যাবস্ট্রাকশন যা পুরো C-তে লেখা। এই সেকশনে আমরা ডেটা অ্যানালিস্ট বা ডেটা সায়েন্টিস্ট হিসেবে জানা দরকার সবচেয়ে গুরুত্বপূর্ণ (সবচেয়ে বেশি ব্যবহৃত) বিষয়গুলো আলোচনা করব।
লাইব্রেরি ইনস্টলেশন
প্রয়োজনীয় লাইব্রেরি pip ব্যবহার করে ইনস্টল করা যায়, কমান্ড টার্মিনালে নিচের কমান্ড চালান:
pip install pandas
DataFrame এবং Series
পহলে প্যান্ডাসের দুটি মূল বেসিক ডেটা স্ট্রাকচার বুঝতে হবে: DataFrame এবং Series। প্যান্ডাসে মাস্টারি পাওয়ার জন্য এই দুটি ডেটা স্ট্রাকচার বুঝতে হয়।
Series
Series একটি অবজেক্ট যা পাইথনের বিল্ট-ইন লিস্টের মতো কিন্তু প্রতিটি এলিমেন্ট বা ইনডেক্সের সাথে সংশ্লিষ্ট লেবেল থাকায় আলাদা।
>>> import pandas as pd
>>> my_series = pd.Series([12, 24, 36, 48, 60, 72, 84])
>>> my_series
0    12
1    24
2    36
3    48
4    60
5    72
6    84
dtype: int64
উপরের আউটপুটে বাম পাশে 'index' এবং ডান পাশে 'value'। প্রতিটি Series অবজেক্টের ডেটা টাইপ (dtype) থাকে, এখানে int64।
ইনডেক্স নম্বর দিয়ে এলিমেন্ট রিট্রিভ করা যায়:
>>> my_series[6]
84
স্পষ্টভাবে ইনডেক্স (লেবেল) দিতে হলে:
>>> my_series = pd.Series([12, 24, 36, 48, 60, 72, 84], index=['ind0', 'ind1', 'ind2', 'ind3', 'ind4', 'ind5', 'ind6'])
>>> my_series
ind0    12
ind1    24
ind2    36
ind3    48
ind4    60
ind5    72
ind6    84
dtype: int64
একসাথে কয়েকটি এলিমেন্ট তাদের ইনডেক্স দিয়ে রিট্রিভ বা গ্রুপ অ্যাসাইন করা খুব সহজ:
>>> my_series[['ind0', 'ind3', 'ind6']]
ind0    12
ind3    48
ind6    84
dtype: int64
>>> my_series[['ind0', 'ind3', 'ind6']] = 36
>>> my_series
ind0    36
ind1    24
ind2    36
ind3    36
ind4    60
ind5    72
ind6    36
dtype: int64
ফিল্টারিং ও ম্যাথ অপারেশনও সহজ:
>>> my_series[my_series > 24]
ind0    36
ind2    36
ind3    36
ind4    60
ind5    72
ind6    36
dtype: int64
>>> my_series[my_series < 24] * 2
Series([], dtype: int64)
>>> my_series
ind0    36
ind1    24
ind2    36
ind3    36
ind4    60
ind5    72
ind6    36
dtype: int64
Series-এ অন্যান্য সাধারণ অপারেশন:
>>> # ডিকশনারির মতো কাজ করে
>>> my_series1 = pd.Series({'a': 9, 'b': 18, 'c': 27, 'd': 36})
>>> my_series1
a     9
b    18
c    27
d    36
dtype: int64
>>> # লেবেল অ্যাট্রিবিউট
>>> my_series1.name = 'Numbers'
>>> my_series1.index.name = 'letters'
>>> my_series1
letters
a     9
b    18
c    27
d    36
Name: Numbers, dtype: int64
>>> # ইনডেক্স পরিবর্তন
>>> my_series1.index = ['w', 'x', 'y', 'z']
>>> my_series1
w     9
x    18
y    27
z    36
Name: Numbers, dtype: int64
DataFrame
DataFrame একটি টেবিলের মতো আচরণ করে কারণ এতে সারি ও কলাম থাকে। DataFrame-এর প্রতিটি কলাম একটি Series অবজেক্ট এবং সারিগুলো Series-এ থাকা এলিমেন্টগুলোতে গঠিত।
DataFrame পাইথনের বিল্ট-ইন ডিকশনারি দিয়ে কনস্ট্রাক্ট করা যায়:
>>> df = pd.DataFrame({
    'Country': ['China', 'India', 'Indonesia', 'Pakistan'],
    'Population': [1420062022, 1368737513, 269536482, 204596442],
    'Area': [9388211, 2973190, 1811570, 770880]
})
>>> df
        Area       Country   Population
0  9388211        China  1420062022
1  2973190        India  1368737513
2  1811570    Indonesia   269536482
3   770880      Pakistan   204596442
>>> df['Country']
0      China
1      India
2  Indonesia
3   Pakistan
Name: Country, dtype: object
>>> df.columns
Index(['Area', 'Country', 'Population'], dtype='object')
>>> df.index
RangeIndex(start=0, stop=4, step=1)
এলিমেন্ট অ্যাক্সেস
সারি ইনডেক্স স্পষ্টভাবে দেয়ার অনেক উপায় রয়েছে।
>>> df = pd.DataFrame({
    'Country': ['China', 'India', 'Indonesia', 'Pakistan'],
    'Population': [1420062022, 1368737513, 269536482, 204596442],
    'Landarea': [9388211, 2973190, 1811570, 770880]
}, index=['CHA', 'IND', 'IDO', 'PAK'])
>>> df
       Country  Landarea  Population
CHA    China   9388211  1420062022
IND    India   2973190  1368737513
IDO  Indonesia  1811570   269536482
PAK  Pakistan   770880   204596442
>>> df.index = ['CHI', 'IND', 'IDO', 'PAK']
>>> df.index.name = 'Country Code'
>>> df
       Country  Landarea  Population
Country Code
CHI      China   9388211  1420062022
IND      India   2973190  1368737513
IDO    Indonesia  1811570   269536482
PAK    Pakistan   770880   204596442
>>> df['Country']
Country Code
CHI      China
IND      India
IDO    Indonesia
PAK    Pakistan
Name: Country, dtype: object
ইনডেক্স ব্যবহার করে সারি অ্যাক্সেস করার বিভিন্ন পদ্ধতি:
.locব্যবহার করে ইনডেক্স লেবেল দিয়ে.ilocব্যবহার করে ইনডেক্স নম্বর দিয়ে
>>> df.loc['IND']
Country      India
Landarea   2973190
Population 1368737513
Name: IND, dtype: object
>>> df.iloc[1]
Country      India
Landarea   2973190
Population 1368737513
Name: IND, dtype: object
>>> df.loc[['CHI', 'IND'], 'Population']
Country Code
CHI    1420062022
IND    1368737513
Name: Population, dtype: int64
ফাইল পড়া ও লেখা
Pandas CSV, XML, HTML, Excel, SQL, JSON সহ অনেক জনপ্রিয় ফাইল ফরম্যাট সমর্থন করে। সবচেয়ে সাধারণ CSV ফাইল ফরম্যাট।
CSV ফাইল পড়তে:
>>> df = pd.read_csv('GDP.csv', sep=',')
নেমড আর্গুমেন্ট sep CSV ফাইলের সেপারেটর ক্যারেক্টার নির্দেশ করে (এখানে GDP.csv)।
এগ리게েশন ও গ্রুপিং (Aggregating and Grouping)
Pandas-এ ডেটা গ্রুপ করতে .groupby মেথড ব্যবহার করা হয়। এগ리게েশন ও গ্রুপিং প্রদর্শনের জন্য Titanic ডেটাসেট ব্যবহার করা হয়েছে, নিচের লিংক থেকে পাওয়া যাবে:
https://yadi.sk/d/TfhJdE2k3EyALt
>>> titanic_df = pd.read_csv('titanic.csv')
>>> print(titanic_df.head())
PassengerID   Name  PClass Age Sex Survived SexCode
0  1  Allen, Miss Elisabeth Walton  1st  29.00 female  1  1
1  2  Allison, Miss Helen Loraine  1st  2.00  female  0  1
2  3  Allison, Mr Hudson Joshua Creighton  1st  30.00 male  0  0
3  4  Allison, Mrs Hudson JC (Bessie Waldo Daniels)  1st  25.00 female  0  1
4  5  Allison, Master Hudson Trevor  1st  0.92  male  1  0
কতজন যাত্রী (নারী ও পুরুষ) বাঁচেছে এবং কতজন বাঁচেনি, .groupby ব্যবহার করে বের করি:
>>> print(titanic_df.groupby(['Sex', 'Survived'])['PassengerID'].count())
Sex     Survived
female  0           154
        1           308
male    0           709
        1           142
Name: PassengerID, dtype: int64
কেবিন ক্লাস অনুযায়ী ডেটা:
>>> print(titanic_df.groupby(['PClass', 'Survived'])['PassengerID'].count())
PClass  Survived
*       0             1
1st     0           129
        1           193
2nd     0           160
        1           119
3rd     0           573
        1           138
Name: PassengerID, dtype: int64
টাইম সিরিজ অ্যানালিসিস (Time Series Analysis) প্যান্ডাস দিয়ে
Pandas মূলত টাইম সিরিজ ডেটা অ্যানালাইজ করার জন্য তৈরি। উদাহরণস্বরূপ Amazon ৫ বছরের স্টক প্রাইস ব্যবহার করা হয়েছে। নিচের লিংক থেকে ডাউনলোড করা যাবে:
https://finance.yahoo.com/quote/AMZN/history?period1=1397413800&period2=1555180200&interval=1mo&filter=history&frequency=1mo
>>> import pandas as pd
>>> amzn_df = pd.read_csv('AMZN.csv', index_col='Date', parse_dates=True)
>>> amzn_df = amzn_df.sort_index()
>>> print(amzn_df.info())

DatetimeIndex: 62 entries, 2014-04-01 to 2019-04-12
Data columns (total 6 columns):
Open       62 non-null object
High       62 non-null object
Low        62 non-null object
Close      62 non-null object
Adj Close  62 non-null object
Volume     62 non-null object
dtypes: object(6)
memory usage: 1.9+ KB
None
উপরে Date কলাম দিয়ে DatetimeIndex-সহ DataFrame তৈরি করা হয়েছে এবং সেটি সোর্ট করা হয়েছে।
গড় ক্লোজিং প্রাইস:
>>> amzn_df.loc['2015-04', 'Close'].mean()
421.779999
ভিজুয়ালাইজেশন (Visualization)
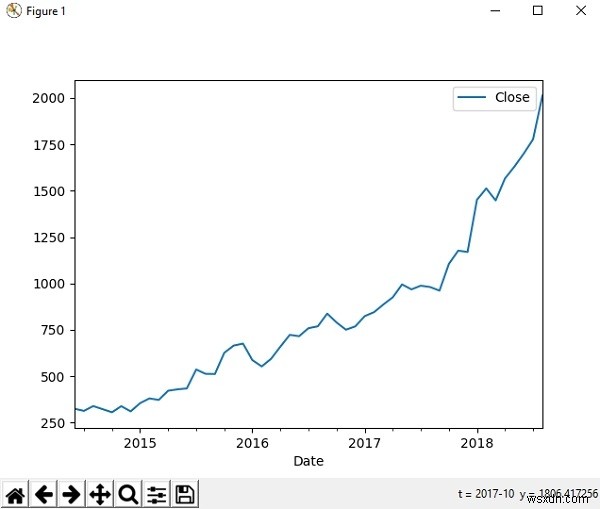
Pandas ভিজুয়ালাইজ করতে matplotlib লাইব্রেরি ব্যবহার করা যায়। Amazon স্টক হিস্টリカল ডেটাসেট নিলে নির্দিষ্ট টাইম পিরিয়ডের প্রাইস মুভমেন্ট গ্রাফে দেখা যাবে।
>>> import matplotlib.pyplot as plt
>>> df = pd.read_csv('AMZN.csv', index_col='Date', parse_dates=True)
>>> new_df = df.loc['2014-06':'2018-08', ['Close']]
>>> new_df = new_df.astype(float)
>>> new_df.plot()
<matplotlib.axes._subplots.AxesSubplot object at 0x0B9B8930>
>>> plt.show()