

ডেটা অ্যানালিসিসের জন্য, এক্সপ্লোরেটরি ডেটা অ্যানালিসিস (EDA) আপনার প্রথম ধাপ হতে হবে। এক্সপ্লোরেটরি ডেটা অ্যানালিসিস আমাদের সাহায্য করে:
একটি ডেটা সেটে ইনসাইট দিতে।
অন্ডারলাইং স্ট্রাকচার বুঝতে।
গুরুত্বপূর্ণ প্যারামিটার এবং সেগুলোর মধ্যে সম্পর্ক বের করতে।
অন্ডারলাইং অ্যাসাম্পশন টেস্ট করতে।
স্যাম্পল ডেটা সেট ব্যবহার করে EDA বোঝা
পাইথন ব্যবহার করে EDA বোঝার জন্য, আমরা স্যাম্পল ডেটা যেকোনো ওয়েবসাইট থেকে সরাসরি বা লোকাল ডিস্ক থেকে নিতে পারি। আমি UCI Machine Learning Repository থেকে একটি রেড ওয়াইন কোয়ালিটি ডেটা সেট নিচ্ছি যা পাবলিকলি উপলব্ধ এবং EDA ব্যবহার করে ডেটা সেটে গভীর ইনসাইট পাওয়ার চেষ্টা করছি।
import pandas as pd
df = pd.read_csv("https://archive.ics.uci.edu/ml/machine-learning-databases/wine-quality/winequality-red.csv")
df.head()
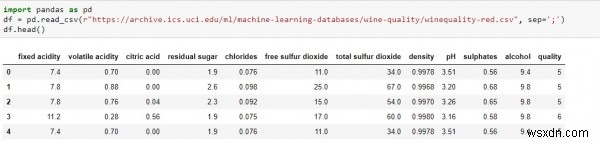
উপরোক্ত স্ক্রিপ্ট জুপিটার নোটবুকে রান করলে নিচের মত আউটপুট আসবে:
শুরুতে,
প্রথমে, প্রয়োজনীয় লাইব্রেরি ইম্পোর্ট করুন, এখানে pandas।
pandas লাইব্রেরির read_csv() ফাংশন ব্যবহার করে csv ফাইল পড়ুন এবং প্রতিটি ডেটা দেওয়া ডেটা সেটে ";" ডিলিমিটার দ্বারা পৃথক।
pandas লাইব্রেরির ".head" ফাংশন সাহায্যে ডেটা সেট থেকে প্রথম পাঁচটি অবজারভেশন রিটার্ন করুন। আমরা ".tail()" ফাংশন দিয়ে একইভাবে শেষ পাঁচটি অবজারভেশন পেতে পারি।
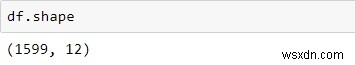
ডেটা সেট থেকে মোট সারি এবং কলামের সংখ্যা ".shape" ব্যবহার করে পেতে পারি:
df.shape
এতে কী কী কলাম আছে, সেগুলোর টাইপ কী এবং কি সেগুলো কোনো মান ধারণ করে বা না, info() ফাংশন দিয়ে জানতে পারি।
df.info()
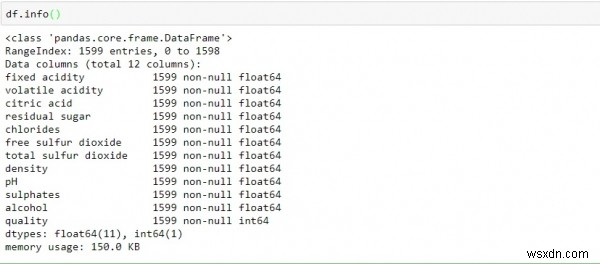
উপরের ডেটা পর্যবেক্ষণ করলে আমরা উপসংহার করতে পারি:
ডেটা শুধু ফ্লোট এবং ইন্টিজার মান ধারণ করে।
সকল কলাম ভেরিয়েবল নন-নাল (খালি বা মিসিং মান নেই)।
pandas দ্বারা প্রদত্ত আরেকটি উপকারী ফাংশন হলো describe() যা ডেটার কাউন্ট, মিন, স্ট্যান্ডার্ড ডেভিয়েশন, মিনিমাম এবং ম্যাক্সিমাম মান এবং কোয়ান্টাইল প্রদান করে।
df.describe()
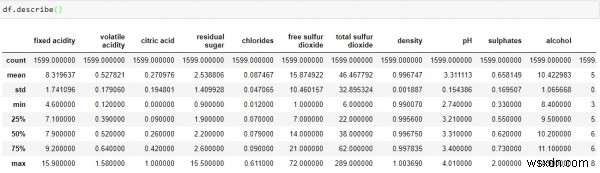
উপরের ডেটা থেকে, আমরা উপসংহার করতে পারি যে প্রতিটি কলামের মিন মান ইন্ডেক্স কলামে মিডিয়ান মান (৫০%)-এর চেয়ে কম।
"residual sugar", "free sulfur dioxide" এবং "total sulfur dioxide" প্রিডিক্টরদের ৭৫% এবং ম্যাক্স ভ্যালুর মধ্যে বিশাল পার্থক্য রয়েছে।
উপরের দুটি পর্যবেক্ষণ, আমাদের ডেটা সেটে এক্সট്രീম ভ্যালু - ডেভিয়েশন রয়েছে বলে ইঙ্গিত দেয়।
ডিপেন্ডেন্ট ভেরিয়েবল থেকে কিছু কী ইনসাইট নিচে দেওয়া হলো:
df.quality.unique()
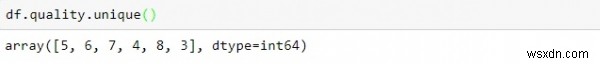
"quality" স্কোর স্কেলে, ১ নিচে থাকে অর্থাৎ 푸র এবং ১০ শীর্ষে থাকে অর্থাৎ বেস্ট।
উপরে থেকে আমরা উপসংহার করতে পারি, কোনো অবজারভেশন ১ (poor), ২ এবং ৯, ১০ (best) স্কোর পায়নি। সব স্কোর ৩ থেকে ৮-এর মাঝপথে।
df.quality.value_counts()
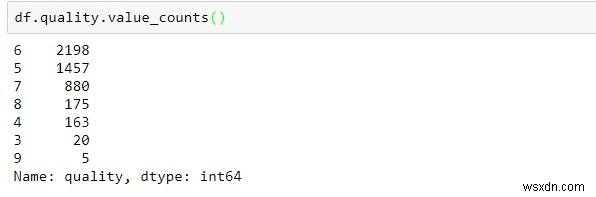
উপর প্রসেস করা ডেটা প্রতিটি কোয়ালিটি স্কোরের ভোট কাউন্ট ডেসেন্ডিং অর্ডারে দেয়।
আমওভাগ কোয়ালিটি ৫-৭ রেঞ্জে।
সর্বনিম্ন অবজারভেশন ৩ এবং ৬ ক্যাটাগরিতে দেখা গেছে।
ডেটা ভিজ্যুয়ালাইজেশন
মিসিং ভ্যালু চেক করা -
seaborn লাইব্রেরি সাহায্যে আমাদের হোয়াইট-উইস্কি csv ডেটা সেটে মিসিং ভ্যালু চেক করতে পারি। সেটি পূরণ করার কোড নিচে:
import pandas as pd
import numpy as np
import seaborn as sns
import matplotlib.pyplot as plt
%matplotlib inline
sns.set()
df = pd.read_csv("https://archive.ics.uci.edu/ml/machine-learning-databases/wine-quality/winequality-white.csv", sep=";")
sns.heatmap(df.isnull(), cbar=False, yticklabels=False, cmap='viridis')
আউটপুট
উপরে থেকে আমরা দেখতে পাচ্ছি ডেটা সেটে কোনো মিসিং ভ্যালু নেই। যদি কোনো থাকে, তবে আমরা পার্পল ব্যাকগ্রাউন্ডে ভিন্ন রং শেডে ফিগার দেখতে পাইতাম।
মিসিং ভ্যালু থাকা অন্য ডেটা সেটের সাথে আপনি পার্থক্য লক্ষ্য করবেন।
কোরিলেশন চেক করা
ডেটা সেটের বিভিন্ন ভ্যালুর মধ্যে কোরিলেশন চেক করতে, আমাদের এক্সিস্টিং ডেটা সেটে নিচের কোড যোগ করুন:
plt.figure(figsize=(8,4))
sns.heatmap(df.corr(), cmap='Greens', annot=False)
আউটপুট
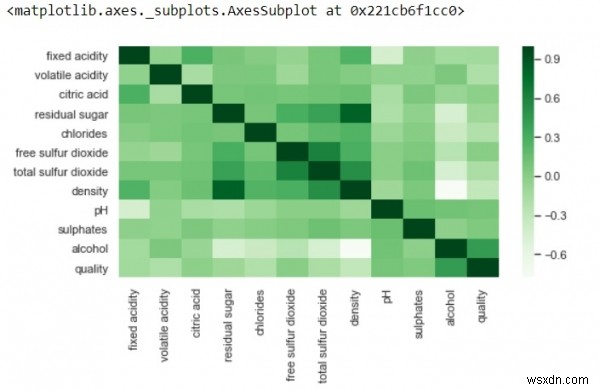
উপরে, পজিটিভ কোরিলেশন গাঢ় রঙে এবং নেগেটিভ কোরিলেশন হালকা রঙে দেখানো হয়েছে।
annot=True করে দিলে, আউটপুটে গ্রিড সেলে দেখাবে কোন ফিচার কতটুকু কোরিলেটেড।
আমরা annot=True দিয়ে আরেকটি কোরিলেশন ম্যাট্রিক্স জেনারেট করতে পারি। আপনার কোড মডিফাই করে নিচের লাইনগুলো যোগ করুন এক্সিস্টিং কোডে:
k = 12
cols = df.corr().nlargest(k, 'quality')['quality'].index
cm = df[cols].corr()
plt.figure(figsize=(8,6))
sns.heatmap(cm, annot=True, cmap='viridis')
আউটপুট
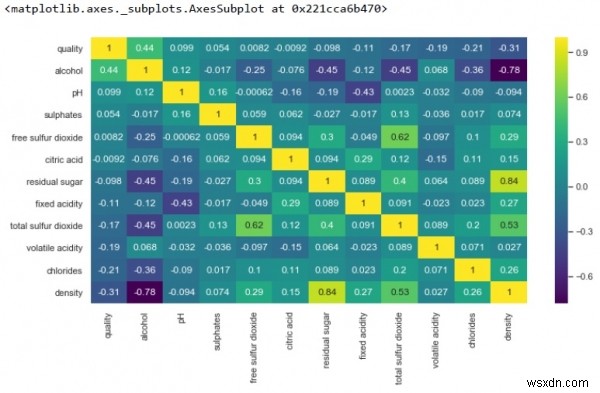
উপরে থেকে আমরা দেখতে পাচ্ছি, density-এর residual sugar-এর সাথে শক্তিশালী পজিটিভ কোরিলেশন রয়েছে। যাইহোক, density এবং alcohol-এর শক্তিশালী নেগেটিভ কোরিলেশন।
এছাড়া, free sulphur dioxide এবং quality-এর মধ্যে কোনো কোরিলেশন নেই।
