

Scrapy স্পাইডার
Scrapy স্পাইডার হলো একটি ক্লাস যা ওয়েবসাইটের লিঙ্ক ফলো করে ওয়েবপেজ থেকে তথ্য এক্সট্রাক্ট করার সুবিধা দেয়। এটি মূল ক্লাস जिससे অন্যান্য স্পাইডার ইনহেরিট করতে হবে।
Scrapinghub
Scrapinghub হলো একটি ওপেন সোর্স অ্যাপ্লিকেশন যেখানে Scrapy স্পাইডার চালানো যায়। Scrapinghub ওয়েব কন্টেন্টকে উপযোগী ডেটা/তথ্যে রূপান্তর করে। এটি জটিল ওয়েবপেজ থেকে ডেটা এক্সট্রাক্ট করতে দেয়।
আমরা Scrapinghub ব্যবহার করে Scrapy স্পাইডার ক্লাউডে ডিপ্লয় ও এক্সিকিউট করব।
ধাপ ১ — Scrapy প্রজেক্ট তৈরি
Scrapy ইন্সটল করার পর টার্মিনালে চালান:
$scrapy startproject
নতুন প্রজেক্টের ডিরেক্টরিতে যান।
ধাপ ২ — Scrapy স্পাইডার লিখুন
টার্গেট ওয়েবসাইটের জন্য একটি স্পাইডার লিখুন, উদাহরণস্বরূপ "quotes.toscrape.com"।
নিচে একটি সিম্পল স্পাইডার:
# scrapy লাইব্রেরি ইম্পোর্ট
import scrapy

class AllSpider(scrapy.Spider):
    crawled = set()
    # স্পাইডার নাম
    name = 'all'
    # শুরুর URL
    start_urls = ['https://www.tutorialspoint.com/']

    def __init__(self):
        self.links = []

    def parse(self, response):
        self.links.append(response.url)
        for href in response.css('a::attr(href)'):
            yield response.follow(href, self.parse)
ধাপ ৩ — স্পাইডার চালিয়ে আউটপুট সংরক্ষণ
উপরের কোড এক্সিকিউট করলে সকল লিঙ্ক স্ক্রেপ হয়ে links.json ফাইলে সংরক্ষিত হবে। এটি সতত (২৪/৭) চালানোর জন্য ক্লাউডে ডিপ্লয় করতে হবে।
ধাপ ৪ — Scrapinghub-এ একাউন্ট তৈরি
ScrapingHub লগইন পেজে Gmail বা GitHub দিয়ে লগইন করুন। ড্যাশবোর্ডে রিডাইরেক্ট হবে।
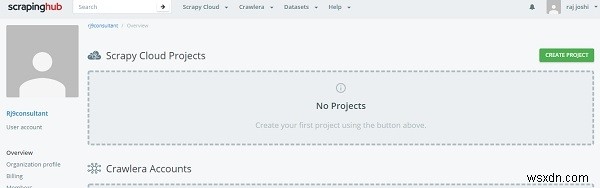
Create project-এ ক্লিক করে প্রজেক্টের নাম দিন। কোড ক্লাউডে অ্যাড করুন CLI বা GitHub দিয়ে। এখানে shub CLI দিয়ে ডিপ্লয় করব। প্রথমে shub ইন্সটল করুন:
$pip install shub
shub ইনস্টল হলে API কী দিয়ে লগইন করুন (API কী পাবেন https://app.scrapinghub.com/account/apikey থেকে):
$shub login
API কী ঠিক থাকলে লগইন হয়ে যাবে। এখন ডিপ্লয় আইডি দিয়ে ডিপ্লয় করুন (কমান্ড লাইন সেকশনে ৬ ডিজিটের নম্বর দেখতে পাবেন):
$ shub deploy deploy_id
কমান্ড লাইন থেকে হয়ে গেল। এখন Spiders ড্যাশবোর্ডে যেতে রেডি স্পাইডার দেখবেন। স্পাইডার নামে ক্লিক করে Run বাটন চাপুন। এখন ড্যাশবোর্ডে আপনার স্পাইডার দেখতে পাবেন:
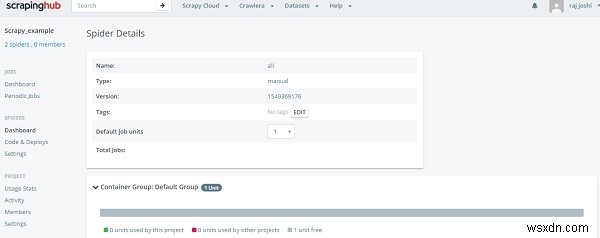
এক ক্লিকে রানিং প্রগ্রেস দেখবেন, লোকাল মেশিন ২৪/৭ চালাতে হবে না।
