

সফটওয়্যার ডেভেলপমেন্ট চ্যালেঞ্জিং, কিন্তু এটি মেইনটেইন করা আরও চ্যালেঞ্জিং। মেইনটেনেন্সে সফটওয়্যার প্যাচ এবং সার্ভার মেইনটেনেন্স অন্তর্ভুক্ত। এই পোস্টে, আমরা সার্ভার ম্যানেজমেন্ট এবং মেইনটেনেন্সে ফোকাস করব।
ঐতিহাসিকভাবে, সার্ভারগুলো অন-প্রিমিস (on-premises) হতো, অর্থাৎ ফিজিক্যাল হার্ডওয়্যার কিনে এবং মেইনটেইন করা। ক্লাউড কম্পিউটিংয়ের সাথে, এই সার্ভারগুলো আর ফিজিক্যালি আওন্ড (owned) থাকতে হয় না। ২০০৬ সালে, যখন Amazon AWS শুরু করল এবং EC2 সার্ভিস চালু করল, আধুনিক ক্লাউড কম্পিউটিংয়ের যুগ শুরু হয়। এই ধরনের সার্ভিসের সাথে, আমাদের আর ফিজিক্যাল সার্ভার মেইনটেইন বা ফিজিক্যাল হার্ডওয়্যার আপগ্রেড করতে হয় না। এটা অনেক সমস্যা সমাধান করল, কিন্তু সার্ভার মেইনটেনেন্স এবং রিসোর্স ম্যানেজমেন্ট এখনো আমাদের হাতেই। এই ডেভেলপমেন্টকে পরবর্তী লেভেলে নেওয়া হয়েছে সার্ভারলেস টেকনোলজি দিয়ে।
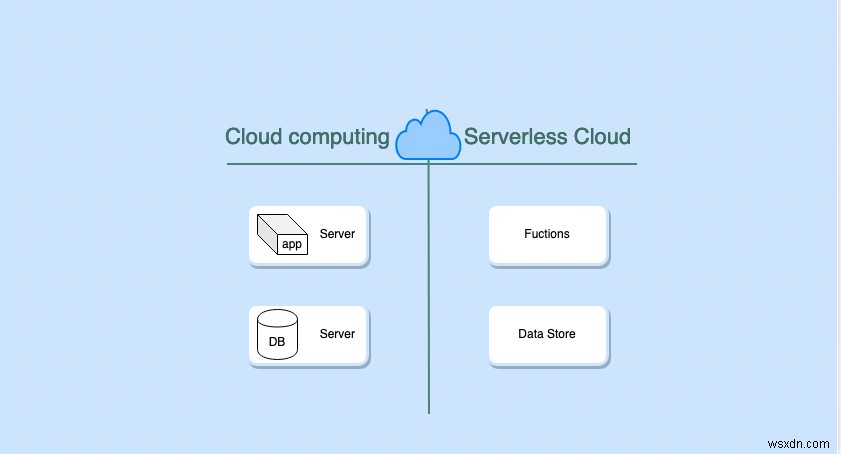
সার্ভারলেস টেকনোলজি কী?
সার্ভারলেস টেকনোলজি সার্ভার ম্যানেজ এবং প্রোভিশন করার কাজ ক্লাউড প্রোভাইডারের ऊपर আفلোড (offload) করে। এই পোস্টে, আমরা AWS নিয়ে আলোচনা করব।
"সার্ভারলেস" শব্দটির মানে নয় যে সার্ভারই নেই। সার্ভার আছে, কিন্তু এটি সম্পূর্ণরূপে ক্লাউড প্রোভাইডার দ্বারা ম্যানেজড। একটি সেন্সে, সার্ভারলেস টেকনোলজির ব্যবহারকারীদের জন্য কোনো видиবল সার্ভার নেই। সার্ভারগুলো সরাসরি আমাদের কাছে দৃশ্যমান নয়, এবং সেগুলো ম্যানেজ করার কাজ ক্লাউড প্রোভাইডার দ্বারা অটোমেটেড। এখানে কিছু বৈশিষ্ট্য যা এটাকে সার্ভারলেস করে তোলে:
- নো অপারেশনাল ম্যানেজমেন্ট - সার্ভার প্যাচ বা হাই অভেইলেবিলিটির জন্য ম্যানেজ করার দরকার নেই;
- প্রয়োজন অনুযায়ী স্কেল - কয়েক ইউজার থেকে মিলিয়ন মিলিয়ন ইউজার সার্ভ করা;
- পে-অ্যাজ-ইউ-গো (Pay as you go) - খরচ ব্যবহার অনুযায়ী ম্যানেজ হয়।
সার্ভারলেস টেকনোলজি নিচের মতো ক্যাটাগরাইজ করা যায়:
- Compute (যেমন, Lambda এবং Fargate)
- Storage (যেমন, S3)
- Data Store (যেমন, DynamoDB এবং Aurora)
- Integration (যেমন, API Gateway, SNS, এবং SQS)
- Analytics (যেমন, Kinesis এবং Athena)
কেন সার্ভারলেস টেকনোলজি ব্যবহার করব
খরচ
পে-অ্যাজ-ইউ-গো সার্ভারলেস টেকনোলজি ব্যবহার করার প্রধান সুবিধাগুলোর একটি। যখন ট্রাফিক ভলিউমে অনপ্রেডিক্টেবল পরিবর্তন হয়, সার্ভার স্কেল আপ বা ডাউন করতে হয় ইউজেজ প্যাটার্ন অনুযায়ী, কিন্তু সেলফ-ম্যানেজড অটোস্কেলিং সাথে স্কেলিং কঠিন এবং অদক্ষ। সার্ভারলেস কম্পিউটিং, যেমন AWS Lambda, খরচ বাঁচাতে সহজে সাহায্য করতে পারে কারণ আইডেল টাইমে পে করা লাগে না।
ডেভেলপার প্রোডাক্টিভিটি
যেহেতু সার্ভারলেস কম্পিউটিং মানে ক্লাউড প্রোভাইডার দ্বারা প্রদত্ত ফুলি ম্যানেজড সার্ভিস, ডেভেলপারদের সার্ভার প্রোভিশন বা সার্ভার অ্যাপ্লিকেশন ডেভেলপ করার দরকার নেই। ডেভেলপাররা সার্ভার ম্যানেজ না করেই কোডিং শুরু করতে পারেন। এই পদ্ধতিটি সার্ভার প্যাচ বা অটোস্কেলিং ম্যানেজ করার দরকারও সরিয়ে দেয়। এই সব সময় বাঁচানো ডেভেলপারদের প্রোডাক্টিভিটি বাড়ায়।
ইলাস্টিসিটি
সার্ভারলেস কম্পিউটিং হাইইলাস্টিক এবং ব্যবহার অনুযায়ী স্কেল আপ বা ডাউন করতে পারে। ইউজারের হঠাৎ বেড়ে যাওয়া সহজে হ্যান্ডেল করা যায়। এটি একটি বড় সুবিধা এবং ডেভেলপারদের অনেক সময় বাঁচায়।
হাই অভেইলেবিলিটি
যখন কম্পিউটিং সার্ভারলেস এবং ক্লাউড প্রোভাইডার দ্বারা ম্যানেজড এবং সার্ভারগুলো হাই আপটাইম रखে, ফেইলওভার (failover) অটোমেটিক্যালি হ্যান্ডেল হয়। এই ধরনের ইস্যু ম্যানেজ করতে স্পেশালাইজড স্কিল লাগে। সার্ভারলেস অ্যাপ্রোচে, অপস (ops) এবং ডেভেলপারদের কাজ একজনের দ্বারা করা যায়।
রুবিতে সার্ভারলেস ফাংশনালিটি কীভাবে ইমপ্লিমেন্ট করব
AWS অনুযায়ী, রুবি AWS-এ সবচেয়ে широко ব্যবহৃত ল্যাঙ্গুয়েজগুলোর একটি। Lambda নভেম্বর ২০১৮-এ রুবি সাপোর্ট শুরু করল। আমরা শুধু AWS-এর প্রদত্ত সার্ভারলেস টেকনোলজি ব্যবহার করে রুবিতে একটি ওয়েব API বানাব।
AWS-এ সার্ভারলেস ইনফ্রা তৈরি করতে, আমরা সিম্পলি AWS কনসোলে লগইন করে সেগুলো তৈরি করতে পারি। কিন্তু, আমরা কিছু এমন কিছু ডেভেলপ করতে চাই যা সহজে টেস্টযোগ্য এবং ডিজাস্টার রিকভারি সহজ করে দেয়। আমরা সার্ভারলেস ফিচারটি কোড হিসেবে লিখব। AWS সার্ভারলেস অ্যাপ্লিকেশন মডেল (SAM) প্রদান করে এই জন্য। SAM AWS-এ সার্ভারলেস অ্যাপ্লিকেশন বিল্ড করার একটি ফ্রেমওয়ার্ক। এটি Lambda, ডাটাবেস, এবং API ডিজাইন করার জন্য YAML-ভিত্তিক সিনট্যাক্স প্রদান করে। AWS SAM অ্যাপ্লিকেশন AWS SAM-CLI দিয়ে বিল্ড করা যায়, যেটি এই লিংক থেকে ডাউনলোড করা যায়।
AWS SAM CLI AWS CloudFormation-র ওপর তৈরি। আপনি যদি CloudFormation-এ IaC লিখতে পরিচিত হন, তবে এটি খুব সিম্পল হবে। অথবা, আপনি serverless frameworkও ব্যবহার করতে পারেন। এই পোস্টে, আমি AWS SAM ব্যবহার করব।
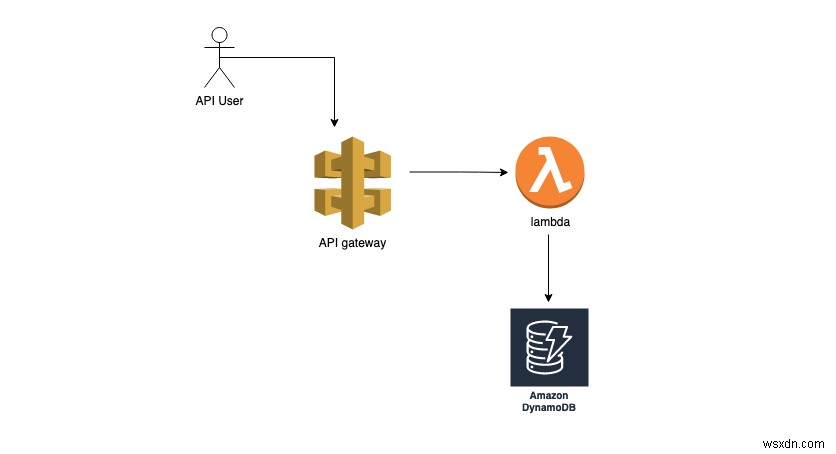
SAM CLI ব্যবহার করার আগে, নিশ্চিত করুন আপনার কাছে নিচের জিনিসগুলো আছে:
- AWS প্রোফাইল সেটআপ
- Docker ইনস্টলড
- SAM CLI ইনস্টলড
আমরা একটি সার্ভারলেস অ্যাপ্লিকেশন ডেভেলপ করব। আমরা আমাদের অ্যাপ্লিকেশনে কয়েকটি সার্ভারলেস ইনফ্রা, যেমন DynamoDB এবং Lambda, তৈরি করব দিয়ে শুরু করব। ডাটাবেস দিয়ে শুরু করা যাক:
DynamoDB
DynamoDB একটি সার্ভারলেস AWS-ম্যানেজড ডাটাবেস সার্ভিস। যেহেতু এটি সার্ভারলেস, এটি খুব দ্রুত এবং সহজে সেটআপ করা যায়। DynamoDB তৈরি করতে, আমরা SAM টেমপ্লেট এইভাবে ডিফাইন করব:
AWSTemplateFormatVersion: '2010-09-09'
Transform: AWS::Serverless-2016-10-31
Resources:
  UsersTable:
    Type: AWS::Serverless::SimpleTable
    Properties:
      PrimaryKey:
        Name: id
        Type: String
      TableName: users
SAM CLI এবং উপরের টেমপ্লেট দিয়ে, আমরা একটি বেসিক DynamoDB টেবিল তৈরি করতে পারি। প্রথমে, আমাদের সার্ভারলেস অ্যাপের জন্য একটি প্যাকেজ বিল্ড করতে হবে। এর জন্য, নিচের কমান্ড চালান। এটি প্যাকেজ বিল্ড করে S3-এ পুশ করবে। কমান্ড চালানোর আগে নিশ্চিত করুন আপনি serverless-users-bucket নামে S3 বাকেট তৈরি করেছেন:
$ sam package --template-file sam.yaml \
  --output-template-file out.yaml \
  --s3-bucket serverless-users-bucket
S3 এখন আমাদের সার্ভারলেস অ্যাপের টেমপ্লেট এবং কোডের সোর্স হবে, যা আমরা Lambda ফাংশন তৈরি করার সময় আলোচনা করব।
এখন এই টেমপ্লেট ডিপ্লয় করুন DynamoDB তৈরি করতে:
$ sam deploy --template-file out.yaml \
  --stack-name serverless-users-app \
  --capabilities CAPABILITY_IAM
এতে, DynamoDB সেটআপ সম্পন্ন। এখন, একটি Lambda তৈরি করব যেখানে এই টেবিলটি ব্যবহার করা হবে।
Lambda
Lambda AWS দ্বারা প্রদত্ত একটি সার্ভারলেস কম্পিউটিং সার্ভিস। এটি কোড এক্সিকিউট করতে ব্যবহৃত হয় প্রয়োজন অনুযায়ী বিনা আসল সার্ভার ম্যানেজমেন্টের, যেখানে কোড এক্সিকিউট হয়। Lambda Async প্রসেস, REST API, বা যেকোনো শিডিউলড জব রান করতে ব্যবহৃত হয়। আমাদের শুধু একটি হ্যান্ডলার ফাংশন লিখতে হবে এবং ফাংশনটি AWS Lambda-এ পুশ করতে হবে। Lambda ইভেন্টের ভিত্তিতে টাস্ক এক্সিকিউট করার দায়িত্ব নেয়। একটি ইভেন্ট বিভিন্ন সোর্স দ্বারা ট্রিগার হতে পারে, যেমন API Gateway, SQS, বা S3; এটি অন্য কোডবেস দ্বারা ও ট্রিগার হতে পারে। আমরা ম্যানুয়ালি বা প্রোগ্রাম্যাটিক্যালি Lambda ফাংশন ট্রিগার করতে পারি এই ইভেন্টগুলো পাস করে। একটি হ্যান্ডলার দুটি আর্গুমেন্ট নেয়:
Event - ইভেন্টগুলো সাধারণত একটি key-value হ্যাশ যা ট্রিগার সোর্স থেকে পাস হয়। এই ভ্যালুগুলো অটোমেটিক্যালি পাস হয় যখন সেগুলো SQS, Kinesis, বা API Gateway-এর মত বিভিন্ন সোর্স দ্বারা ট্রিগার হয়। ম্যানুয়ালি ট্রিগার করলে, আমরা ইভেন্টগুলো এখানে পাস করতে পারি। ইভেন্টে Lambda ফাংশন হ্যান্ডলারের জন্য ইনপুট ডেটা থাকে। উদাহরণস্বরূপ, API Gateway-এ, রিকোয়েস্ট বডি এই ইভেন্টের ভিতরে থাকে।
Context - কনটেক্সট হ্যান্ডলার ফাংশনে দ্বিতীয় আর্গুমেন্ট। এতে স্পেসifik ডিটেইল থাকে, যার মধ্যে ট্রিগার সোর্স, Lambda ফাংশন নাম, ভার্সন, রিকোয়েস্ট-আইডি, এবং আরও অনেক কিছু।
হ্যান্ডলারের আউটপুট ট্রিগার করার সার্ভিসে ফেরত পাঠানো হয়। Lambda ফাংশনের আউটপুট হলো হ্যান্ডলার ফাংশনের রিটার্ন ভ্যালু।
AWS Lambda সাতটি ভিন্ন ল্যাঙ্গুয়েজ সাপোর্ট করে যেগুলোতে আপনি কোড লিখতে পারেন, রুবি সহ। এখানে, আমরা AWS Ruby SDK ব্যবহার করব DynamoDB-এ কানেক্ট করার জন্য।
কোড লিখার আগে, Lambda-এর জন্য ইনফ্রা তৈরি করি SAM টেমপ্লেট দিয়ে:
AWSTemplateFormatVersion: "2010-09-09"
Transform: AWS::Serverless-2016-10-31
Description: "Serverless users app"
Resources:
  CreateUserFunction:
    Type: AWS::Serverless::Function
    Properties:
      Handler: users.create
      Runtime: ruby2.7
      Policies:
        - DynamoDBWritePolicy:
            TableName: !Ref UsersTable
      Environment:
        Variables:
          USERS_TABLE: !Ref UsersTable
হ্যান্ডলারে, এক্সিকিউট হওয়া ফাংশনের রেফারেন্স লিখি Handler: <filename>.<method_name> হিসেবে।
সার্ভারলেস পলিসি টেমপ্লেট রেফার করুন এমন একটি পলিসির জন্য যা আপনি Lambda-এ আট্যাচ করতে পারেন রিসোর্সের ওপর ভিত্তি করে। যেহেতু আমাদের Lambda ফাংশন DynamoDB-এ লিখে, আমরা DynamoDBWritePolicy ব্যবহার করেছি policies সেকশনে।
আমরা এনভায়রনমেন্ট ভেরিয়েবল USERS_TABLEও প্রদান করছি Lambda ফাংশনে যাতে সেটি নির্দিষ্ট ডাটাবেসে রিকোয়েস্ট পাঠাতে পারে।
Lambda ইনফ্রার জন্য এটাই দরকার। এখন, DynamoDB-এ ইউজার তৈরি করার কোড লিখি যা Lambda ফাংশন এক্সিকিউট করবে।
Gemfile-এ aws-record যোগ করুন:
# Gemfile
source 'https://rubygems.org' do
  gem 'aws-record', '~> 2'
end
ইনপুট DynamoDB-এ লিখার কোড যোগ করুন:
# users.rb
require 'aws-record'

class UsersTable
  include Aws::Record
  set_table_name ENV['USERS_TABLE']
  string_attr :id, hash_key: true
  string_attr :body
end

def create(event:, context:)
  body = event["body"]
  id = SecureRandom.uuid
  user = UsersTable.new(id: id, body: body)
  user.save!
  user.to_h
end
খুব দ্রুত এবং সহজ। AWS aws-record জেম প্রদান করে DynamoDB এক্সেস করার জন্য, যা রেইলসের activerecord-এর খুব সিমিলার।
এরপর, নিচের কমান্ডগুলো চালান ডিপেন্ডেন্সি ইনস্টল করার জন্য:
নোট: নিশ্চিত করুন আপনার রুবি ভার্সন Lambda-এ ডিফাইন করা ভার্সনের সাথে মিলে। এই উদাহরণে, আপনার মেশিনে Ruby2.7 ইনস্টলড থাকতে হবে।
# ডিপেন্ডেন্সি ইনস্টল
$ bundle install
$ bundle install --deployment
পরিবর্তনগুলো প্যাকেজ করুন:
$ sam package --template-file sam.yaml \
  --output-template-file out.yaml \
  --s3-bucket serverless-users-bucket
ডিপ্লয়:
sam deploy --template-file out.yaml \
  --stack-name serverless-users-app \
  --capabilities CAPABILITY_IAM
এই কোডের সাথে, এখন আমাদের Lambda রান করছে, যা ইনপুট ডাটাবেসে লিখতে পারে। আমরা Lambda-এর সামনে একটি API Gateway যোগ করতে পারি যাতে HTTP কল দিয়ে অ্যাক্সেস করা যায়। API Gateway অনেক API ম্যানেজমেন্ট ফাংশনালিটি দেয়, যেমন রেট লিমিটিং এবং অথেন্টিকেশন। তবে, ব্যবহার অনুযায়ী এটি ব্যয়বহুল হতে পারে। শুধু HTTP API ব্যবহার করার একটি সস্তা অপশনও আছে API ম্যানেজমেন্ট ছাড়া। ইউজ কেস অনুযায়ী, আপনি সবচেয়ে উপযুক্তটি বেছে নিতে পারেন।
AWS Lambda-র কিছু লিমিট আছে। उनमें से কিছু মডিফাই করা যায়, কিন্তু অন্যগুলো ফিক্সড:
- মেমরি - ডিফল্টভাবে, এক্সিকিউশন টাইমে একটি Lambda-র ১২৮ MB মেমরি থাকে। এটি ৩,০০৮ MB পর্যন্ত ৬৪ MB ইনক্রিমেন্টে বাড়ানো যায়।
- টাইমআউট - Lambda ফাংশনের কোড এক্সিকিউশনের জন্য একটি টাইম লিমিট। ডিফল্ট লিমিট ৩ সেকেন্ড। এটি ৯০০ সেকেন্ড পর্যন্ত বাড়ানো যায়।
- স্টোরেজ - Lambda একটি
/tmpডিরেক্টরি প্রদান করে স্টোরেজের জন্য। এই স্টোরেজের লিমিট ৫১২ MB। - রিকোয়েস্ট এবং রেসপন্স সাইজ - সিনক্রোনাস ট্রিগারের জন্য ৬ MB পর্যন্ত এবং অ্যাসিনক্রোনাস ট্রিগারের জন্য ২৫৬ MB পর্যন্ত।
- এনভায়রনমেন্ট ভেরিয়েবল - ৪ KB পর্যন্ত।
যেহেতু Lambda-র এই লিমিটগুলো আছে, এই লিমিটের ভিতরে ফিট হওয়া কোড লিখতে ভালো। যদি না ফিট হয়, তবে কোড স্প্লিট করা যাতে একটি Lambda অন্যটি ট্রিগার করে। AWS-এর একটি Step Functionsও আছে, যেটি একাধিক Lambda ফাংশন সিকোয়েন্স করতে ব্যবহার করা যায়।
সার্ভারলেস অ্যাপ্লিকেশন লোকালি কীভাবে টেস্ট করব
সার্ভারলেস অ্যাপ্লিকেশনের জন্য, আমাদের একটি ভেন্ডর দরকার যা ম্যানেজড সার্ভারলেস সার্ভিস দেয়। আমরা AWS-র ওপর ডিপেন্ডেন্ট অ্যাপ্লিকেশন টেস্ট করার জন্য। অ্যাপ্লিকেশন টেস্ট করার জন্য, AWS দ্বারা প্রদত্ত কিছু লোকাল অপশন আছে। কিছু ওপেন-সোর্স টুলও আছে যা AWS সার্ভারলেস টেকনোলজির সাথে কম্প্যাটিবল এবং লোকালি অ্যাপ্লিকেশন টেস্ট করতে ব্যবহার করা যায়।
আমাদের Lambda ফাংশন এবং DynamoDB টেস্ট করি। এর জন্য, আমাদের এগুলো লোকালি রান করতে হবে।
প্রথমে, একটি ডকার নেটওয়ার্ক তৈরি করুন। নেটওয়ার্কটি Lambda ফাংশন এবং DynamoDB-এর মধ্যে কমিউনিকেশন হেল্প করবে।
$ docker network create lambda-local --docker-network lambda-local
DynamoDB Local হলো AWS দ্বারা প্রদত্ত DynamoDB-এর একটি লোকাল ভার্সন, যেটি আমরা লোকালি টেস্ট করতে ব্যবহার করতে পারি। নিচের ডকার ইমেজ রান করে DynamoDB Local চালু করুন:
$ docker run -p 8000:8000 --network lambda-local --name dynamodb amazon/dynamodb-local
user.rb ফাইলে নিচের লাইনটি যোগ করুন। এটি Lambda-কে লোকাল DynamoDB-এ কানেক্ট করবে:
local_client = Aws::DynamoDB::Client.new(
  region: "local",
  endpoint: 'https://dynamodb:8000'
)
UsersTable.configure_client(client: local_client)
একটি input.json ফাইল যোগ করুন, যেটি Lambda-এর জন্য ইনপুট ধারণ করে:
{
  "name": "Milap Neupane",
  "location": "Global"
}
Lambda এক্সিকিউট করার আগে, লোকাল DynamoDB-এ টেবিল যোগ করতে হবে। এর জন্য, aws-migrate দ্বারা প্রদত্ত মাইগ্রেশন ফাংশনালিটি ব্যবহার করব। একটি migrate.rb ফাইল তৈরি করুন এবং নিচের মাইগ্রেশন যোগ করুন:
require 'aws-record'
require './users.rb'
local_client = Aws::DynamoDB::Client.new(
  region: "local",
  endpoint: 'https://localhost:8000'
)
migration = Aws::Record::TableMigration.new(UsersTable, client: local_client)
migration.create!(
  provisioned_throughput: {
    read_capacity_units: 5,
    write_capacity_units: 5
  }
)
migration.wait_until_available
শেষে, Lambda-কে লোকালি এক্সিকিউট করুন নিচের কমান্ড দিয়ে:
$ sam local invoke "CreateUserFunction" -t sam.yaml \
  -e input.json \
  --docker-network lambda-local
এটি DynamoDB টেবিলে ইউজারের ডেটা তৈরি করবে।
Localstack-এর মত অপশনও আছে AWS স্ট্যাক লোকালি রান করার জন্য।
কখন সার্ভারলেস কম্পিউটিং ব্যবহার করব
সার্ভারলেস কম্পিউটিং ব্যবহার করব কিনা ডिसাইড করার সময়, আমাদের এর সুবিধা এবং খামি দুটোই জানতে হবে। নিচের বৈশিষ্ট্যগুলোর ভিত্তিতে, সার্ভারলেস অ্যাপ্রোচ কখন ব্যবহার করব সেটি ডিসাইড করতে পারি:
খরচ
- যখন অ্যাপ্লিকেশনে আইডেল টাইম এবং অনকনসিস্টেন্ট ট্রাফিক থাকে, Lambda ভালো কারণ এটি খরচ কমাতে সাহায্য করে।
- যখন অ্যাপ্লিকেশনে কনসিস্টেন্ট ট্রাফিক ভলিউম থাকে, AWS Lambda ব্যবহার করা ব্যয়বহুল হতে পারে।
পারফরম্যান্স
- যখন অ্যাপ্লিকেশন পারফরম্যান্স-সেনসিটিভ নয়, AWS Lambda ব্যবহার করা ভালো চয়েস।
- Lambda-র একটি কোল্ড বুট টাইম (cold boot time) থাকে, যা কোল্ড বুটের সময় স্লো রেসপন্স টাইম করে দেয়।
ব্যাকগ্রাউন্ড প্রসেসিং
- Lambda ব্যাকগ্রাউন্ড প্রসেসিং-এর জন্য ভালো চয়েস। কিছু ওপেন-সোর্স টুল, যেমন Sidekiq, সার্ভার স্কেলিং এবং মেইনটেনেন্স ওভারহেড ধারণ করে। আমরা AWS Lambda এবং AWS SQS কিউ কম্বাইন করে ব্যাকগ্রাউন্ড জব প্রসেস করতে পারি সার্ভার মেইনটেনেন্সের ঝামেলা ছাড়া।
কনকারেন্ট প্রসেসিং
- যেমন আমরা জানি, রুবিতে কনকারেন্সি সহজে করা যায় না। Lambda-র সাথে, প্রোগ্রামিং ল্যাঙ্গুয়েজ সাপোর্ট ছাড়াই কনকারেন্সি অর্জন করা যায়। Lambda কনকারেন্টলি এক্সিকিউট হতে পারে এবং পারফরম্যান্স উন্নত করে।
পিরিয়ডিক বা এক-বারের স্ক্রিপ্ট রান করা
- রুবি কোড এক্সিকিউট করার জন্য আমরা ক্রন জব (cron jobs) ব্যবহার করি, কিন্তু বড় স্কেল অ্যাপ্লিকেশনের জন্য ক্রন জবের সার্ভার মেইনটেনেন্স কঠিন। ইভেন্ট-ভিত্তিক Lambda অ্যাপ্লিকেশন স্কেলিং-এ সাহায্য করে।
এই গুলো Lambda ফাংশনের কিছু ইউজ কেস সার্ভারলেস অ্যাপ্লিকেশনে। আমাদের সব কিছু সার্ভারলেস বানাতে হয় না; উপরে স্পেসিফাই করা ইউজ কেসগুলোর জন্য হাইব্রিড মডেল বানাতে পারি। এটি অ্যাপ্লিকেশন স্কেলিং-এ সাহায্য করে এবং ডেভেলপার প্রোডাক্টিভিটি বাড়ায়। সার্ভারলেস টেকনোলজি এভোল্ভ (evolve) হচ্ছে এবং ভালো হচ্ছে। অন্যান্য সার্ভারলেস টেকনোলজিও আছে, যেমন AWS Fargate এবং Google CloudRun, যেগুলো AWS Lambda-এর লিমিটেশন নেই।
