

ক্রলার ডেভেলপ করার জন্য সেরা ফ্রেমওয়ার্কের একটি হলো Scrapy। Scrapy হলো একটি জনপ্রিয় ওয়েব স্ক্রেপিং ও ক্রলিং ফ্রেমওয়ার্ক যা হাই-লেভেল ফাংশন্যালিটি দিয়ে ওয়েবসাইট স্ক্রেপিং সহজ করে দেয়।
ইনস্টলেশন
উইন্ডোজে Scrapy ইনস্টল করা সহজ: pip বা conda (Anaconda থাকলে) ব্যবহার করুন। Scrapy পাইথন ২ ও ৩ উভয়েই চলে।
pip install Scrapy
অথবা
conda install -c conda-forge scrapy
সঠিকভাবে ইনস্টল হলে টার্মিনালে scrapy কমান্ড উপলব্ধ থাকবে:
C:\Users\rajesh>scrapy
Scrapy 1.6.0 - no active project
Usage: scrapy  [options] [args]
Available commands:
bench       Run quick benchmark test
fetch       Fetch a URL using the Scrapy downloader
genspider   Generate new spider using pre-defined templates
runspider   Run a self-contained spider (without creating a project)
settings    Get settings values
shell       Interactive scraping console
startproject Create new project
version     Print Scrapy version
view        Open URL in browser, as seen by Scrapy
[ more ] More commands available when run from project directory
Use "scrapy  -h" to see more info about a command.
প্রজেক্ট শুরু
Scrapy ইনস্টল হলে startproject কমান্ড দিয়ে ডিফল্ট স্ট্রাকচার জেনারেট করুন।
টার্মিনালে নেভিগেট করে যেখানে প্রজেক্ট রাখবেন, সেখানে scrapy startproject scrapy_example প্রজেক্ট নাম ব্যবহার করা হয়েছে:
C:\Users\rajesh>scrapy startproject scrapy_example
New Scrapy project 'scrapy_example', using template directory 'c:\python\python361\lib\site-packages\scrapy\templates\project', created in: C:\Users\rajesh\scrapy_example
You can start your first spider with:
cd scrapy_example
scrapy genspider example example.com
ফোল্ডার স্ট্রাকচার:
C:\Users\rajesh\scrapy_example>tree /F
Folder PATH listing
Volume serial number is 8CD6-8D39
C:.
│ scrapy.cfg
│
└───scrapy_example
    │ items.py
    │ middlewares.py
    │ pipelines.py
    │ settings.py
    │ __init__.py
    │
    ├───spiders
    │   │ __init__.py
    │   │
    │   └───__pycache__
    └───__pycache__
অন্যথায় scrapy shell চালিয়ে ওয়েব স্ক্রেপিং করা যায়:
In [18]: fetch("https://www.wsj.com/india")
2019-02-04 22:38:53 [scrapy.core.engine] DEBUG: Crawled (200)
ক্রলার একটি "response" অবজেক্ট রিটার্ন করে যাতে ডাউনলোডকৃত তথ্য থাকে। দেখে নেওয়া যাক:
In [19]: view(response)
Out[19]: True
ডিফল্ট ব্রাউজারে ওয়েব লিঙ্ক খুলবে:
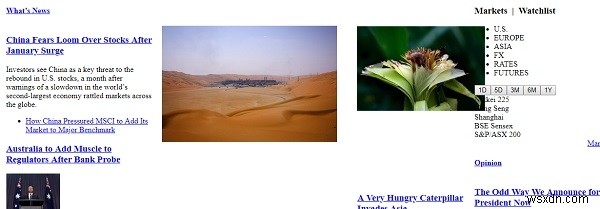
ক্রলারের কন্টেন্ট চেক করুন:
In [22]: print(response.text)


    The Wall Street Journal & Breaking News, Business, Financial and Economic News, World News and Video


    ... & so much more
ওয়েবপেজ থেকে গুরুত্বপূর্ণ তথ্য এক্সট্র্যাক্ট
ওয়েবপেজের টাইটেল এক্সট্র্যাক্ট
Scrapy CSS সিলেক্টর (class, id ইত্যাদি) দিয়ে HTML থেকে তথ্য এক্সট্র্যাক্ট করে। টাইটেলের CSS সিলেক্টর খুঁজতে রাইট-ক্লিক করে Inspect করুন:
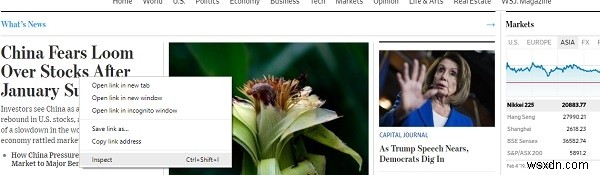
ডেভেলপার টুলস খুলবে:
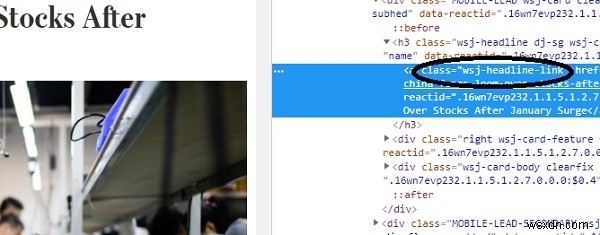
CSS class "wsj-headline-link" সব অ্যাঙ্কর () ট্যাগে लागু আছে যাদের টাইটেল আছে। এই তথ্য দিয়ে রেসপন্স অবজেক্ট থেকে সব টাইটেল বের করুন:
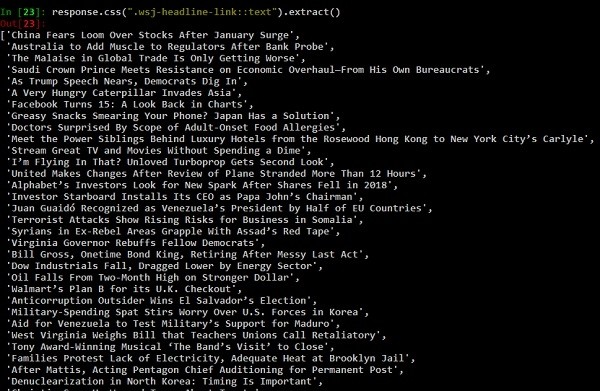
response.css() ফাংশন CSS সিলেক্টর অনুযায়ী কন্টেন্ট এক্সট্র্যাক্ট করে। আরও উদাহরণ:
In [24]: response.css(".wsj-headline-link::text").extract_first()
Out[24]: 'China Fears Loom Over Stocks After January Surge'

In [25]: response.css(".wsj-headline-link").extract_first()
Out[25]: 'China Fears Loom Over Stocks After January Surge'
ওয়েবপেজ থেকে সব লিঙ্ক বের করতে:
links = response.css('a::attr(href)').extract()
আউটপুট
['https://www.google.com/intl/en_us/chrome/browser/desktop/index.html', 'https://support.apple.com/downloads/', 'https://www.mozilla.org/en-US/firefox/new/', 'https://windows.microsoft.com/en-us/internet-explorer/download-ie', 'https://www.barrons.com', 'https://bigcharts.marketwatch.com', 'https://www.wsj.com/public/page/wsj-x-marketing.html', 'https://www.dowjones.com/', 'https://global.factiva.com/factivalogin/login.asp?productname=global', 'https://www.fnlondon.com/', 'https://www.mansionglobal.com/', 'https://www.marketwatch.com', 'https://newsplus.wsj.com', 'https://privatemarkets.dowjones.com', 'https://djlogin.dowjones.com/login.asp?productname=rnc', 'https://www.wsj.com/conferences', 'https://www.wsj.com/pro/centralbanking', 'https://www.wsj.com/video/', 'https://www.wsj.com', 'https://www.bigdecisions.com/', 'https://www.businessspectator.com.au/', 'https://www.checkout51.com/?utm_source=wsj&utm_medium=digitalhousead&utm_campaign=wsjspotlight', 'https://www.harpercollins.com/', 'https://housing.com/', 'https://www.makaan.com/', 'https://nypost.com/', 'https://www.newsamerica.com/', 'https://www.proptiger.com', 'https://www.rea-group.com/', ...]
WSJ ওয়েবপেজ থেকে কমেন্ট কাউন্ট বের করতে:
In [38]: response.css(".wsj-comment-count::text").extract()
Out[38]: ['71', '59']
এটি শুধু Scrapy দিয়ে ওয়েব স্ক্রেপিংয়ের পরিচিতি, Scrapy দিয়ে আরও অনেক কিছু করা যায়।
