

RDBMS কী?
সম্পর্কিক ডাটাবেস ডিজাইন (RDD) তথ্য ও ডেটাকে সারি ও কলাম বিশিষ্ট টেবিল সেটে মডেল করে। প্রতিটি সারি একটি রেকর্ড প্রতিনিধিত্ব করে এবং প্রতিটি কলাম ডেটার একটি অ্যাট্রিবিউট। SQL (Structured Query Language) সম্পর্কিক ডাটাবেস ম্যানিপুলেশনের জন্য ব্যবহৃত হয়। সম্পর্কিক ডাটাবেস ডিজাইন চারটি ধাপে গঠিত: রিলেশন/অ্যাট্রিবিউট ডিফাইন, প্রাইমারি কী ডিফাইন, রিলেশনশিপ ডিফাইন, নরমালাইজেশন।
RDBMS-এ ডেটা টেবিলে সংগঠিত থাকে এবং সব ডেটা অ্যাক্সেস কন্ট্রোল্ড ট্রানজ্যাকশন দ্বারা হয়। এটি ACID (atomicity, consistency, integrity, durability) বৈশিষ্ট্য পূরণ করে। ডেটা ম্যানেজমেন্ট সমস্যা সমাধানের জন্য ডাটাবেস সার্ভার ব্যবহার বাধ্যতামূলক।
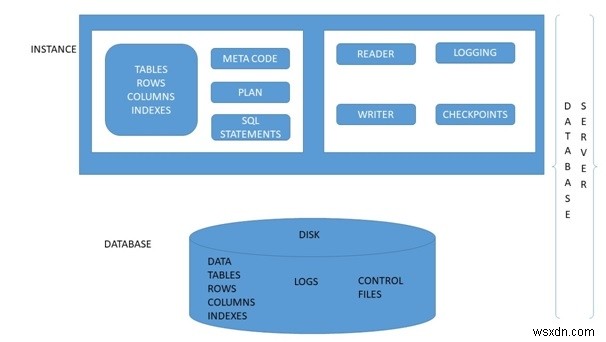
সম্পর্কিক ডাটাবেস ডিজাইন প্রক্রিয়া
ডাটাবেস ডিজাইন বিজ্ঞানের চেয়ে কালা বেশি, কারণ অনেক সিদ্ধান্ত নিতে হয়। প্রতিটি অ্যাপ্লিকেশনের জন্য কাস্টমাইজ করা হয়। গাইডলাইন আছে (প্রায়শই কী করবেন না সেটি), কিন্তু চূড়ান্ত সিদ্ধান্ত ডিজাইনারের হাতেই।
ধাপ ১: ডাটাবেসের উদ্দেশ্য নির্ধারণ (Requirement Analysis)
- প্রয়োজনীয়তা সংগ্রহ করুন এবং ডাটাবেসের উদ্দেশ্য নির্ধারণ করুন।
- স্যাম্পল ইনপুট ফর্ম, কোয়েরি এবং রিপোর্ট ড্রাফ্ট করুন।
ধাপ ২: ডেটা সংগ্রহ, টেবিলে সংগঠন এবং প্রাইমারি কী নির্দিষ্ট করা
- ডাটাবেসের উদ্দেশ্য ঠিক হলে, সংরক্ষণযোগ্য ডেটা সংগ্রহ করুন। বিষয়-ভিত্তিক টেবিলে ভাগ করুন।
- একটি কলাম (বা কয়েকটি) প্রাইমারি কী হিসেবে বেছে নিন, যা প্রতিটি সারি অনন্যভাবে শনাক্ত করে।
ধাপ ৩: টেবিলগুলোর মধ্যে সম্পর্ক তৈরি করা
স্বতন্ত্র এবং অসম্পর্কিত টেবিলের ডাটাবেস কম কাজের। সম্পর্কিক ডাটাবেসের ক্ষমতা টেবিলগুলোর মধ্যে সম্পর্ক নির্ধারণে নিহিত। সবচেয়ে গুরুত্বপূর্ণ দিক হলো টেবিলগুলোর মধ্যে সম্পর্ক চিহ্নিত করা। সম্পর্কের ধরন:
- One-to-Many
- Many-to-Many
- One-to-One
One-to-Many
একটি শিক্ষক শূন্য বা একাধিক ক্লাস পড়াতে পারে, কিন্তু একটি ক্লাস একটি শিক্ষক দ্বারা পড়ানো হয়। Company ডাটাবেসে একটি ম্যানেজার শূন্য বা একাধিক কর্মী ম্যানেজ করতে পারে, কিন্তু একটি কর্মী একটি ম্যানেজারের অধীন থাকে। এই সম্পর্ক One-to-Many।
একটি টেবিলে One-to-Many রিপ্রেজেন্ট করা যায় না। দুটি টেবিল ডিজাইন করতে হয়: Classes (classID প্রাইমারি কী) এবং Teachers (teacherID প্রাইমারি কী)। Teacher টেবিলের teacherID Classes টেবিলে ফরেন কী হিসেবে রাখা হয়।
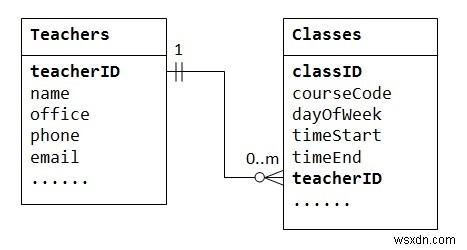
Classes টেবিলের teacherID কলামটি ফরেন কী। চাইল্ড টেবিলের ফরেন কী পেরেন্ট টেবিলের প্রাইমারি কী, যা পেরেন্ট টেবিল রেফারেন্স করতে ব্যবহৃত হয়।
Many-to-Many
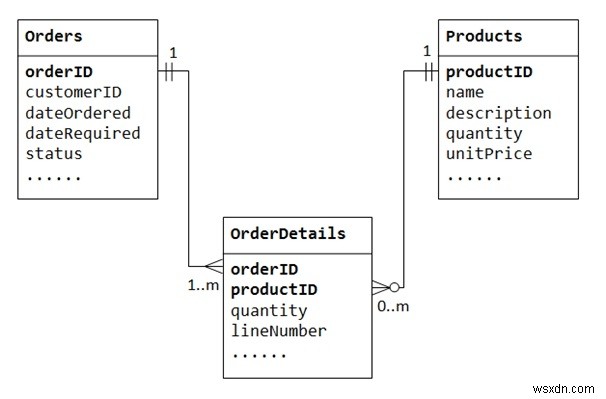
একটি কাস্টমারের অর্ডারে একাধিক প্রোডাক্ট থাকতে পারে এবং একটি প্রোডাক্ট অনেক অর্ডারে থাকতে পারে। বুকস্টোরে একটি বই একাধিক লেখক লিখতে পারে এবং একজন লেখক শূন্য বা একাধিক বই লিখতে পারে। এটি Many-to-Many।
ট্রানজ্যাকশন সমর্থনের জন্য একটি জংশন টেবিল (OrderDetails) তৈরি করতে হয় যার প্রাইমারি কী orderID এবং productID। এগুলো Orders এবং Products টেবিলের ফরেন কীও হয়। Many-to-Many বাস্তবে দুটি One-to-Many রিলেশনশিপ জংশন টেবিল দিয়ে ইমপ্লিমেন্ট করা হয়।
One-to-One
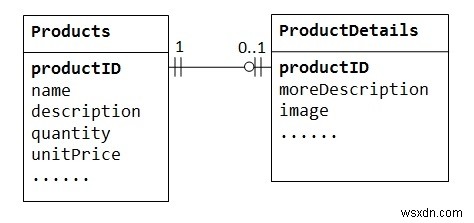
প্রোডাক্টের অপশনাল সাপ্লিমেন্টারি ইনফো (ইমেজ, বিস্তারিত বর্ণনা) রাখার জন্য আলাদা টেবিল (ProductDetails) তৈরি করা হয়। প্রতিটি পেরেন্ট সারির জন্য চাইল্ড টেবিলে সর্বোচ্চ একটি সারি থাকে। একই productID দুই টেবিলের প্রাইমারি কী। সংবেদনশীল ডেটা নিরাপদে রাখার জন্যও One-to-One ব্যবহার হয়।
কলাম ডেটা টাইপ
প্রতিটি কলামের জন্য উপযুক্ত ডেটা টাইপ বেছে নিন: ইন্টিজার, ফ্লোটিং-পয়েন্ট, স্ট্রিং, ডেট/টাইম, বাইনারি, কালেকশন (এনুমারেশন, সেট) ইত্যাদি।
ধাপ ৪: ডিজাইন রিফাইন ও নরমালাইজ করা
- আরো কলাম যোগ করা,
- One-to-One দিয়ে অপশনাল ডেটার জন্য নতুন টেবিল,
- বড় টেবিল ছোট দুটি টেবিলে ভাগ করা,
- অন্যান্য পদ্ধতি।
নরমালাইজেশন (Normalization)
নরমালাইজেশন রুল প্রয়োগ করে ডাটাবেস কি স্ট্রাকচারালি সঠিক ও অপ্টিমাল তা যাচাই করুন।
- First Normal Form (1NF): প্রতিটি সেলে একক ভ্যালু থাকবে, লিস্ট নয়। রিপিটিং গ্রুপ কলাম (item1, item2...) নিষিদ্ধ। One-to-Many দিয়ে আলাদা টেবিল বানান।
- Second Normal Form (2NF): 1NF + প্রতিটি নন-কী কলাম প্রাইমারি কীর ওপর পুরোপুরি নির্ভরশীল। কমপোজিট প্রাইমারি কী হলে নন-কী কলাম পুরো কী সেটের ওপর নির্ভর করবে, অংশতঃ নয়।
- Third Normal Form (3NF): 2NF + নন-কী কলামগুলি পরস্পর স্বাধীন। অর্থাৎ শুধু প্রাইমারি কীর ওপর নির্ভরশীল, অন্য কোথাও নয়।
- Higher Normal Forms: 3NF-এর অপর্যাপ্ততা দূর করতে BCNF, 4NF, 5NF ব্যবহার করা হয় (এই টিউটোরিয়ালের বাইরে)।
কখনো কখনো পারফরম্যান্স বা ইউজার চাহিদায় নরমালাইজেশন রুল ভাঙা দরকার। সেটি ডকুমেন্ট করে রাখুন এবং প্রোগ্রামিং লজিক দিয়ে হ্যান্ডেল করুন।
ইন্টিগ্রিটি রুল (Integrity Rules)
- Entity Integrity Rule: প্রাইমারি কী NULL হয়তে পারবে না। কমপোজিট কীর কোনো কলাম NULL হয়তে পারবে না। অধিকাংশ RDBMS এটি এনফোর্স করে।
- Referential Integrity Rule: প্রতিটি ফরেন কী ভ্যালু পেরেন্ট টেবিলের প্রাইমারি কী ভ্যালুর সাথে মেলতে হবে। চাইল্ড টেবিলে ফরেন কী ইনসার্ট করার আগে পেরেন্টে ভ্যালু থাকতে হবে। পেরেন্টে কী পরিবর্তন হলে চাইল্ড টেবিলে ক্যাসকেড, NULL সেট বা ডিসঅ্যালো করা যায়।
- Business Logic Integrity: বিজনেস লজিক অনুযায়ী ভ্যালিডেশন (যেমন: জিপ কোড ৫ ডিজিট, ডেলিভারি টাইম বিজনেস আওয়ারসে, অর্ডার কোয়ান্টিটি স্টকের চেয়ে কম বা সমান)।
কলাম ইন্ডেক্সিং (Column Indexing)
সিলেক্টেড কলামে ইন্ডেক্স তৈরি করে ডেটা সার্চ ও রিট্রিভাল দ্রুত করা যায়। BTREE স্ট্রাকচার ইন্ডেক্স রেকর্ড দ্রুত খুঁজে পায়। তবে INSERT, UPDATE, DELETE ধীর হয় কারণ রেকর্ড পরিবর্তন হলে ইন্ডেক্স রিবিল্ড করতে হয়। একক কলাম, কনক্যাটেনেটেড বা পার্শিয়াল ইন্ডেক্স তৈরি করা যায়। প্রাইমারি কীতে স্বয়ংক্রিয় ইন্ডেক্স তৈরি হয়।
