

এই পোস্টটি আমার মতে দুনিয়ার দুটি সবচেয়ে আকর্ষণীয় বিষয়ের নিয়ে: প্রোবাবিলিস্টিক ডেটা স্ট্রাকচার এবং Redis মডিউল। আপনি যদি এই দুটির যেকোনো একটিও শোনে থাকেন, তবে আমার উদ্বেগের সাথে আপনি নিশ্চয়ই নিজেকে সম্পর্কিত পাবেন, কিন্তু যদি আপনি পৃথিবীর সবচেয়ে কুল বিষয়গুলো নিয়ে আপ-টু-ডেট থাকতে চান, তবে পড়তে থাকুন।
এই বিবরণ দিয়ে শুরু করি: বড় স্কেলে লো-ল্যাটেন্সি ডেটা প্রসেসিং চ্যালেঞ্জিং। জড়িত ডেটার আকার ও বেগ রিয়েল-টাইম বিশ্লেষণকে অত্যন্ত চাপসাপি করে তোলে। উচ্চ পারফরমেন্স ও বহুমুখী হওয়ায় Redis এধরণের চ্যালেঞ্জ সমাধানের জন্য সাধারণত ব্যবহৃত হয়। সাব-মিলিসেকেন্ড ল্যাটেন্সিতে ডেটা সংরক্ষণ, ম্যানিপুলেট ও সার্ভ করার ক্ষমতা একাধিক কেসে অনলাইন কম্পিউটেশনের জন্য আদর্শ ডেটা কন্টেইনার করে তোলে।
কিন্তু সব কিছু আপেক্ষিক, এবং এমন স্কেল وجود রয়েছে যা সঠিক রিয়েল-টাইম বিশ্লেষণকে বাস্তবিক দৃষ্টিকোণ থেকে অসম্ভব করে তোলে। জটিল সমস্যা বড় হলে আরও কঠিন হয়, কিন্তু আমরা ভুলে যাই সাধারণ সমস্যগুলোও একই নিয়ম মেনে চলে। এমনকি সংখ্যা যোগ করার মতো মৌলিক কাজও অনেক বড়, অনেক দ্রুত বা পর্যাপ্ত রিসোর্স না থাকলে বিশাল কাজ হয়ে ওঠে। আর রিসোর্স সদা সীমিত ও ব্যয়বহুল, ডেটা কিন্তু কাউকে Geschäft নèbres невসে বেড়ে চলছে।
Count-Min Sketch কী?
Count-min sketch (সংক্ষেপে CM sketch) একটি প্রোবাবিলিস্টিক ডেটা স্ট্রাকচার যা একবার বুঝলে এবং কীভাবে ব্যবহার করব সেটি জানলে অত্যন্ত উপকারী হয়।
সৌভাগ্যবশত, CM sketch-এর সাধারণ বৈশিষ্ট্যগুলো इसे নতুনদের জন্য তুলনামূলকভাবে সহজ করে তোলে (বিশ্বাস করুন, আমার অনেক বন্ধু Top-K ব্লগটি ফলো করতে পারেনি)।
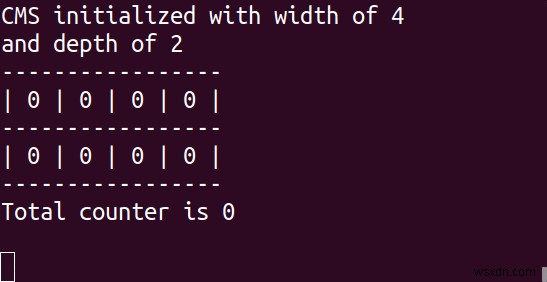
CM sketch অনেক বছর ধরে Redis মডিউল بوده এবং gầnাম বাংলাদেশে RedisBloom মডিউল v2.0-এর অংশ হিসেবে পুনরায় লেখা হয়েছে। কিন্তু CM sketch-এ গভীরে যাওয়ার আগে, বুঝতে হবে কেন আপনি কোনো প্রোবাবিলিস্টিক ডেটা স্ট্রাকচার ব্যবহার করবেন। গতি, স্পেস ও নির্ভুলতার ত্রিভুজে, প্রোবাবিলিস্টিক ডেটা স্ট্রাকচার কিছু নির্ভুলতা ত্যাগ করে স্পেস অর্জন করে—সম্ভবত খুব বেশি স্পেস! গতির প্রভাব অ্যালগরিদম ও সেট সাইজের উপর ভিত্তি করে পরিবর্তিত হয়।
- নির্ভুলতা: সংজ্ঞা অনুযায়ী, আপনার ডেটার শুধু একটি অংশ রাখা এবং স্টোরেজে колиশন অনুমোদন করা নির্ভুলতা কমিয়ে দেয়। তবুও আপনি আপনার ইউজ কেস অনুযায়ী সর্বোচ্চ এরর রেট সেট করতে পারেন।
- মেমরি স্পেস: বিলিয়নের ইভেন্ট রেকর্ড করা বড় ডেটার জগতে, শুধু আংশিক ডেটা সংরক্ষণ করলে স্টোরেজ স্পেস ও খরচ জেনে জানতে কমিয়ে দেয়।
- গতি: কিছু ট্রেডিশনাল ডেটা স্ট্রাকচার আপেক্ষিকভাবে অক্ষমতার সাথে কাজ করে, রেসপন্স টাইম ধীর করে। (উদাহরণস্বরূপ, একটি Sorted Set তার সব এলিমেন্টের ক্রম বজায় রাখে, কিন্তু আপনি শুধু টপ এলিমেন্টগুলোর প্রতি আগ্রহী হতে পারেন। যেহেতু প্রোবাবিলিস্টিক অ্যালগরিদম শুধু আংশিক তালিকা বজায় রাখে, সেগুলো অধিক দক্ষ এবং প্রায়শই কোয়েরি দ্রুত উত্তর দিতে পারে।)
সঠিক প্রোবাবিলিস্টিক ডেটা স্ট্রাকচার আপনাকে আপনার ডেটাসেটের শুধু একটি অংশ রাখতে দেয় বিনিময়ে কম নির্ভুলতা। অবশ্যই অনেক কেসে (ব্যাংক অ্যাকাউন্টের মতো), কম নির্ভুলতা গ্রহণযোগ্য নয়। কিন্তু একটি মুভি রিকমেন্ড করা বা ওয়েবসাইট ইউজারকে অ্যাড দেখানোর মতো কেসে, তুলনামূলকভাবে নিরাপদ ভুলের খরচ কম এবং স্পেস বাঁচাতে পারেন ভালো-খাসো।
মৌলিকভাবে, CM sketch আপনার ডেটাসেটের সব আইটেমের কাউন্টকে বেশ কয়েকটি কাউন্টার অ্যারেতে সমষ্টিগত করে কাজ করে। একটি কোয়েরি आनेে সেটি সব অ্যারে থেকে সেই আইটেমের ন্যূনতম কাউন্ট রিটার্ন করে, যা колиশনের কারণে কাউন্ট ফুলানোর সম্ভাবনা কমিয়ে দেয়। কম উপস্থিতির হার বা স্কোরযুক্ত আইটেমগুলো ("মাউস ফ্লো") এরর রেটের নিচে কাউন্ট পায়, তাই তাদের আসল কাউন্ট সম্পর্কে ডেটা হারিয়ে যায় এবং সেগুলো নויז হিসেবে বিবেচিত হয়। উচ্চ উপস্থিতির হার বা স্কোরযুক্ত আইটেমগুলো ("এলিফ্যান্ট ফ্লো") এর জন্য, প্রাপ্ত কাউন্ট ব্যবহার করলেই চলবে। CM sketch-এর আকার ثابت থাকা এবং অসীম সংখ্যক আইটেমের জন্য ব্যবহার করা সম্ভব হওয়ায়, স্টোরেজ স্পেসে বিশাল বাঁচত সম্ভাবনা দেখা যায়।
পটভূমির জন্য, স্কেচها ডেটা স্ট্রাকচার এবং তাদের συνοলী অ্যালগরিদমের একটি ক্লাস। সেগুলো আপনার ডেটার প্রকৃতি ধারণ করে যাতে সেটি সম্পর্কে প্রশ্নের উত্তর দিতে পারে সবসময় বা সাব-লিনিয়ার স্পেস ব্যবহার করে। CM sketch ২০০৫ সালের একটি পেপারে Graham Cormode এবং S. Muthu Muthukrishnan দ্বারা বর্ণনা করা হয়েছিল, যার নাম "An Improved Data Stream Summary: The Count-Min Sketch and its Applications"।
Count-Min Sketch: কী এবং কীভাবে
CM sketch তার প্রাথমিক ইউজ কেসগুলো সাপোর্ট করার জন্য বেশ কয়েকটি কাউন্টার অ্যারে ব্যবহার করে। অ্যারের সংখ্যকে "ডেপথ" (depth) এবং প্রতিটি অ্যারেতে কাউন্টার সংখ্যকে "উইডথ" (width) বলি।
যখন আমরা একটি আইটেম পাই, একটি হ্যাশ ফাংশন (যে একটি এলিমেন্ট—শব্দ, বাক্য, সংখ্যা বা বাইনারি—কে একটি সংখ্যায় রূপান্তর করে যেটি সেট/অ্যারেতে লোকেশন হিসেবে বা ফিংগারপ্রিন্ট হিসেবে ব্যবহার করা যায়) ব্যবহার করে আইটেমের লোকেশন ক্যালকুলেট করি এবং প্রতিটি অ্যারেতে সেই কাউন্টার বাড়াই। সংশ্লিষ্ট প্রতিটি কাউন্টারের মান আইটেমের আসল মানের সমান বা বেশি হয়। যখন আমরা একটি জিজ্ঞাসা করি, একই হ্যাশ ফাংশনগুলো দিয়ে সব অ্যারেতে যাই এবং আমাদের আইটেমের সাথে জড়িত কাউন্টার ফেচ করি। তারপর আমরা যে ন্যূনতম মান পাই সেটি রিটার্ন করি, কারণ আমরা জানি আমাদের মানগুলো ফুলায়মান (বা সমান)।
আমরা জানি যে অনেক আইটেম অধিকাংশ কাউন্টারের বৃদ্ধিতে সহায়তা করে, স্বাভাবিক колиশনের কারণে (যখন ভিন্ন আইটেম একই লোকেশন পায়), আমরা 'নויז'-কে সহ্য করি যতক্ষণ না সেটি আমাদের বাঞ্ছিত এরর রেটের মধ্যে থাকে।
Count-Min Sketch উদাহরণ
গণিত নির্দেশ করে যে ডেপথ ১০ এবং উইডথ ২,০০০ হলে, এরর না হওয়ার সম্ভাবনা ৯৯.৯% এবং এরর রেট ০.১%। (এটি মোট ইনক্রিমেন্টের শতাংশ, ইউনিক আইটেমের নয়)।
বাস্তব সংখ্যায়, এর মানে যদি আপনি ১ মিলিয়ন ইউনিক আইটেম যোগ করেন, তাহলে গড়ে প্রতিটি আইটেম ৫০০ মান পাবে (১M/২K)। সেটা অসমানুপাতিক মনে হলেও, এটি আমাদের ০.১% এরর রেটের ভেতরেই পড়ে, যা ১ মিলিয়ন আইটেমে ১,০০০।
অনুরূপভাবে, যদি ১০টি এলিফ্যান্ট ১০,০০০ বার আসে, সব সেটে তাদের মান ১০,০০০ বা তার বেশি হবে। ভবিষ্যতে আমরা যখন সেগুলো কাউন্ট করব, তখন আমরা একটি এলিফ্যান্ট দেখব। অন্যান্য সব সংখ্যার জন্য (অর্থাৎ সব মাউস যাদের আসল কাউন্ট ১), সেগুলো সব সেটে এলিফ্যান্টের সাথে колиশন করবে না (যেহেতু CM sketch শুধু ন্যূনতম কাউন্ট বিবেচনা করে) কারণ এটার সম্ভাবনা কম এবং ডেপথ বাড়ালে আরও কমে যায়।
Count-Min Sketch কী কাজে আসে?
এখন CM sketch-এর আচরণ বুঝলে, এই ছোট বাদশাহ দিয়ে কী করা যায়? কিছু সাধারণ ইউজ কেস:
- দুই সংখ্যা কোয়েরি করে তাদের কাউন্ট তুলনা করুন।
- আসন্ন আইটেমের একটি শতাংশ সেট করুন, ধরুন ১%। যখনই একটি আইটেমের মিন-কাউন্ট মোট কাউন্টের ১% এর বেশি হয়, তখন true রিটার্ন করুন। এটি অনলাইন গেমের টপ প্লেয়ার নির্ধারণের জন্য ব্যবহার করা যায়।
- CM sketch-এ একটি মিন-হিপ যোগ করে একটি Top-K ডেটা স্ট্রাকচার তৈরি করুন। যখনই একটি আইটেম বাড়ায়, চেক করুন নয়া মিন-কাউন্ট হিপের মিনিমামের চেয়ে বড় কিনা এবং তা অনুযায়ী আপডেট করুন। RedisBloom-এ Top-K মডিউলের বিপরীতে, যা সময়ের সাথে ডিকে হয়, CM sketch কখনো ভুলে না, তাই এর আচরণ HeavyKeeper-ভিত্তিক Top-K থেকে কিছুটা ভিন্ন।
RedisBloom-এ CM sketch-এর API সহজ ও সরল:
- CM sketch ডেটা স্ট্রাকচার ইনিশিয়ালাইজ করতে: INITBYDIM {key} {width} {depth} বা CMS.INITBYPROB {key} {error} {probability}
- একটি আইটেমের কাউন্টার বাড়াতে: CMS.INCRBY {key} {item} {increment}
- আইটেমের কাউন্টারগুলোর মধ্যে ন্যূনতম কাউন্ট পেতে: CMS.QUERY {key} {item}
উপরোক্ত অ্যানিমেটেড উদাহরণ তৈরিতে নিচের কমান্ডগুলো ব্যবহৃত হয়েছে:
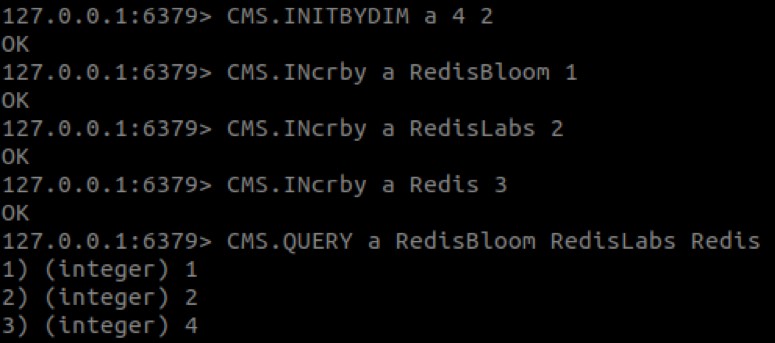
আপনি দেখতে পাচ্ছেন, 'Redis'-এর মান ৩ না হয়ে ৪। এই আচরণ প্রস্তুত, যেহেতু CM sketch-এ একটি আইটেমের কাউন্ট ফুলানোর সম্ভাবনা থাকে।
একটি স্কেচি ব্যবসা
সফটওয়্যার ইঞ্জিনিয়ারিং ট্রেড-অফ করার বিষয়, এবং কোস্ট-ইফেক্টিভ Weise চ্যালেঞ্জ সমাধানের জনপ্রিয় পদ্ধতি হলো দক্ষতার পক্ষে নির্ভুলতা ত্যাগ করা। এই পদ্ধতিটি Redis-এর HyperLogLog বাস্তবায়নে উদাহরণিত, একটি ডেটা স্ট্রাকচার যা সেট কার্ডিন্যালিটি সম্পর্কে কোয়েরির উত্তর দিতে দক্ষতার সাথে ডিজাইন করা হয়েছে। HyperLogLog "স্কেচ" নামে ডেটা স্ট্রাকচার পরিবারের এক সদস্য, যা আসল বিশ্বের শিল্পী প্রতিরূপের মতো তাদের বিষয়ের একটি সন্নিকটন দ্বারা তথ্য প্রকাশ করে।
ব্রড স্ট্রোকসে, স্কেচها ডেটা স্ট্রাকচার (এবং তাদের сопровازمة অ্যালগরিদম) যেগুলো আপনার ডেটার প্রকৃতি ধারণ করে—আপনার ডেটা সম্পর্কে আপনার প্রশ্নের উত্তর, ללא আসল ডেটা সংরক্ষণ করা। আনুষ্ঠানিকভাবে বলা যায়, স্কেচها উপযোগী কারণ তাদের সাব-লিনিয়ার অ্যাসিম্পটটিক কম্পিউটেশনাল কমপ্লেক্সিটি থাকে, যা কম কম্পিউটিং পাওয়ার এবং/অথবা স্টোরেজ দাবি করে। কিন্তু ফ্রি লান্চ নেই এবং দক্ষতার লাভ নির্ভুলতার ঘাটতি দ্বারা ব্যালেন্স করা হয়। অনেক কেসে, তবে, এরর গ্রহণযোগ্য যতক্ষণ না সেটি একটি থ্রেশহোল্ডের নিচে রাখা যায়। একটি ভালো ডেটা স্কেচ वो যা সহজে তার এরর মেনে নেয়, এবং সত্যিকারের অনেক স্কেচ তাদের এরর (বা সেসব এরর হওয়ার সম্ভাবনা) প্যারামিটারাইজ করে যাতে ইউজার সেটি সংজ্ঞায়িত করতে পারে।
ভালো স্কেচها দক্ষ এবং বাউন্ডেড এরর সম্ভাবনা রয়েছে, কিন্তু চমৎকার স্কেচها সেগুলো যেগুলো প্যারালেলে কম্পিউট করা যায়। একটি প্যারালেলাইজেবল স্কেচ वो যা ডেটার অংশগুলোর ওপর স্বাধীনভাবে তৈরি করা যায় এবং যেটির অংশগুলো একটি অর্থপূর্ণ ও সামঞ্জস্যপূর্ণ সমষ্টিতে একত্রিত করা যায়। যেহেতু চমৎকার স্কেচের প্রতিটি টুকরো আলাদা লোকেশন এবং/অথবা সময়ে কম্পিউট করা যায়, প্যারালেলিজম ডিভাইড-এন্ড-কাঙ্কার পদ্ধতিতে স্কেলিং চ্যালেঞ্জ সমাধান করতে সম্ভব করে তোলে।
একটি ঘন ঘন সমস্যা
উপরোক্ত HyperLogLog একটি চমৎকার স্কেচ কিন্তু এটি শুধু একটি নির্দিষ্ট ধরনের প্রশ্নের উত্তর দিতে উপযোগী। অন্য একটি অমূল্য টুল হলো Count Min Sketch (CMS), যেটি G. Cormode এবং S. Muthukrishnan-এর "An Improved Data Stream Summary: The Count-Min Sketch and its Applications" পেপারে বর্ণিত। এই গেনিয়াস কন্ট্রাপশনটি স্যাম্পলের ফ্রিকোয়েন্সি সম্পর্কে উত্তর দিতে তৈরি, যা বড় পortion অ্যানালিটিক্যাল প্রসেসের একটি সাধারণ বিল্ডিং ব্লক।
পর্যাপ্ত সময় ও রিসোর্স দেওয়া থাকলে, স্যাম্পল ফ্রিকোয়েন্সি ক্যালকুলেট করা একটি সহজ প্রক্রিয়া—প্রতিটি স্যাম্পলের নিবেশন (দেখা হয়েছে কতবার) এর জন্য একটি কাউন্ট রাখুন এবং তারপর সেটি মোট নিবেশনের সংখ্যা দিয়ে ভাগ করে সেটি স্যাম্পলের ফ্রিকোয়েন্সি পান। কিন্তু হাই-স্কেল লো-ল্যাটেন্সি ডেটা প্রসেসিং-এর প্রেক্ষাপটে, কখনো পর্যাপ্ত সময় বা রিসোর্স থাকে না। ডেটা স্ট্রিম করার সাথে সাথে উত্তর অবিলম্বে দিতে হয়, এর স্কেল যেন যেন কিছুই না হয়, এবং স্যাম্পলিং স্পেসের বিশাল আকার প্রতিটি স্যাম্পলের জন্য একটি কাউন্টার রাখা অসম্ভব করে দেয়।
তো প্রতিটি স্যাম্পল সঠিকভাবে ট্র্যাক না করে, আমরা ফ্রিকোয়েন্সি অনুমান করার চেষ্টা করতে পারি। একটি উপায় হলো নিবেশনগুলো র্যান্ডমলি স্যাম্পল করা এবং আশা করা যে স্যাম্পলটি সাধারণত পুরো ডেটার বৈশিষ্ট্য রিফ্লেক্ট করবে। এই পদ্ধতির সমস্যা হলো আসল র্যান্ডমনেস নিশ্চিত করা একটি কঠিন কাজ, তাই র্যান্ডম স্যাম্পলিং-এর সাফল্য আমাদের সিলেকশন প্রসেস এবং/অথবা ডেটার নিজস্ব বৈশিষ্ট্য দ্বারা সীমাবদ্ধ হতে পারে। সেখানে CMS একदम ভিন্ন একটি পদ্ধতির সাথে আসে, যা প্রথমে লাগতে পারে চমৎকার স্কেচের বিপরীত: CMS শুধু প্রতিটি নিবেশন রেকর্ড করে না, বরং প্রতিটি একাধিক কাউন্টারে রেকর্ড করা হয়!
বেশক, এতে একটি টুইস্ট আছে, এবং সেটি ততটাই চমৎকার όσο সহজ। মূল পেপার (এবং এর হালকা সংস্করণ "Approximating Data with the Count-Min Data Structure") এটিকে খুব ভালোভাবে ব্যাখ্যা করে, কিন্তু আমি যাক করি সারাংশ দিতে। CMS-এর চমৎকারি নিবেশন সংরক্ষণ করার পদ্ধতিতে নিহিত: প্রতিটি ইউনিক স্যাম্পলকে স্বাধীনভাবে ট্র্যাক করার বদলে, এটি এর হ্যাশ মান ব্যবহার করে। একটি স্যাম্পলের হ্যাশ মান একটি কনস্ট্যান্ট-সাইজ (পেপারে প্যারামিটার d) কাউন্টার অ্যারেতে ইনডেক্স হিসেবে ব্যবহার করা হয়। বেশ কয়েকটি (প্যারামিটার w) ভিন্ন হ্যাশ ফাংশন এবং তাদের নিজস্ব অ্যারে ব্যবহার করে, স্কেচটি কোয়েরি করার সময় হ্যাশ колиশন হ্যান্ডেল করে স্যাম্পলের জন্য সব প্রাসঙ্গিক কাউন্টারের মিনিমাম মান বেছে নিয়ে।
একটি উদাহরণ দরকার, তাই একটি সহজ স্কেচ বানাই ডেটা স্ট্রাকচার এর ইনার ওয়ার্কিং বোঝাতে। স্কেচটি সহজ রাখতে, আমরা ছোট প্যারামিটার মান ব্যবহার করব। w = 3 সেট করি, অর্থাৎ তিনটি হ্যাশ ফাংশন ব্যবহার করব—h1, h2, h3 হিসেবে। এবং d = 4। স্কেচের কাউন্টার সংরক্ষণের জন্য একটি 3×4 অ্যারে ব্যবহার করব যার মোট ১২ এলিমেন্ট ০ দিয়ে ইনিশিয়ালাইজড।
এখন দেখা যাক স্যাম্পলগুলো স্কেচে যোগ হলে কী হয়। ধরি স্যাম্পলগুলো এক এক করে আসে এবং প্রথম স্যাম্পল s1-এর হ্যাশগুলো: h1(s1) = 1, h2(s1) = 2, h3(s1) = 3। s1 কে স্কেচে রেকর্ড করতে, প্রতিটি হ্যাশ ফাংশনের প্রাসঙ্গিক ইনডেক্সের কাউন্টার ১ দিয়ে বাড়াব। নিচের টেবিলটি অ্যারের ইনিশিয়াল ও বর্তমান অবস্থা দেখায়:
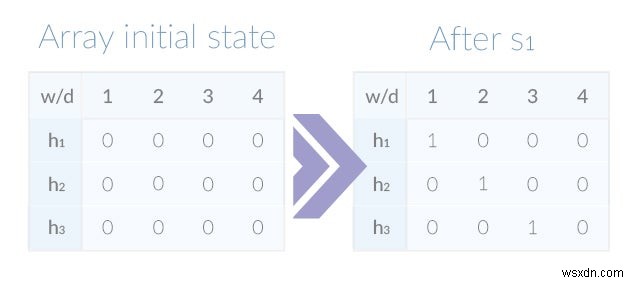
যদিও স্কেচে শুধু একটি স্যাম্পল আছে, আমরা ইতিমধ্যে এটিকে কার্যকরভাবে কোয়েরি করতে পারি। মনে রাখুন, একটি স্যাম্পলের নিবেশন সংখ্যা হলো এর সব কাউন্টারের ন্যূনতম, তাই s1-এর জন্য এটি পাওয়া যায়:
min(array[1][h1(s1)], array[2][h2(s1)], array[3][h3(s1)]) =
 min(array[1][1], array[2][2], array[3][3]) =
 min(1,1,1) = 1
স্কেচটি এখনও যোগ না করা স্যাম্পল সম্পর্কে কোueryর উত্তর দিতে পারে। ধরি h1(s2) = 4, h2(s2) = 4, h3(s2) = 4, লক্ষ্য করুন s2 কোয়েরি করলে ফলাফল ০ আসবে। এখন s2 এবং s3 (h1(s3) = 1, h2(s3) = 1, h3(s3) = 1) যোগ করি, যা নিচের ফলাফল দেয়:
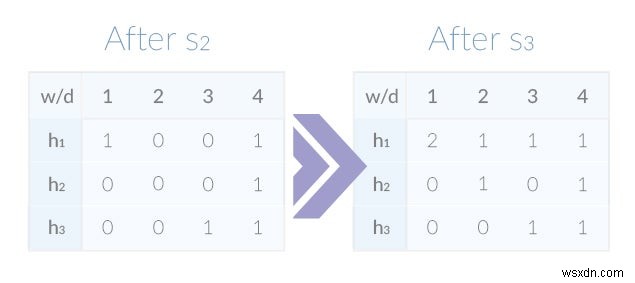
আমাদের কাল্পনিক উদাহরণে, почти সব স্যাম্পলের হ্যাশ ইউনিক কাউন্টারে ম্যাপ হয়েছে, একটি ব্যতিক্রম ছাড়া: h1(s1) এবং h1(s3) এর колиশন। যেহেতু দুটি হ্যাশ একই, h1-এর ১ নম্বর কাউন্টার এখন ২ মান ধারণ করছে। যেহেতু স্কেচ সব কাউন্টারের ন্যূনতম নেয়, s1 এবং s3-এর কোয়েরি এখনও সঠিক ফলাফল ১ দিচ্ছে। কিন্তু শেষে, যতক্ষণ পর্যাপ্ত колиশন ঘটবে, কোয়েরির ফলাফল কম নির্ভুল হবে।
CMS-এর দুটি প্যারামিটার—w এবং d—এইস স্পেস/টাইম রিকোয়ারমেন্টসও এবং এরর-এর সম্ভাবনা ও সর্বোচ্চ মান নির্ধারণ করে। স্কেচ ইনিশিয়ালাইজ করার একটি আরও אינ্টুইটিভ উপায় হলো এরর-এর সম্ভাবনা ও ক্যাপ দিয়ে, তারপর সেটি w এবং d-এর প্রয়োজনীয় মান নির্ণয় করতে দেয়া। প্যারালেলাইজেশন সম্ভব কারণ যেকোনো সংখ্যক সাব-স্কেচ সহজে মার্জ করা যায় অ্যারেগুলোর যোগফল হিসেবে, যতক্ষণ না একই প্যারামিটার ও হ্যাশ ফাংশন ব্যবহার করে সেগুলো তৈরি করা হয়।
Count-min sketch সম্পর্কে কিছু পর্যবেক্ষণ
Count Min Sketch-এর দক্ষতা এর রিকোয়ারমেন্টস রিভিউ করে প্রদর্শন করা যায়। CMS-এর স্পেস কমপ্লেক্সিটি হলো w, d, এবং কাউন্টার প্রাযতির প্রাযতির গুণফল। উদাহরণস্বরূপ, ০.০১% এরর রেট এবং ০.০১% সম্ভাবনা সহ একটি স্কেচ ১০টি হ্যাশ ফাংশন এবং ২০০০-কাউন্টার অ্যারে ব্যবহার করে তৈরি করা হয়। ১৬-বিট কাউন্টার ব্যবহার ধরে, ফলস্বরূপ স্কেচের ডেটা স্ট্রাকচারের মোট মেমরি রিকোয়ারমেন্ট ৪০KB (মোট নিবেশন সংখ্যা এবং কয়েকটি পয়েন্টার সংরক্ষণের জন্য কিছু অতিরিক্ত বাইট যোগ করলে)। স্কেচের অন্যান্য কম্পিউটেশনাল দিকও একইভাবে সুন্দর—যেহেতু হ্যাশ ফাংশন সস্তা তৈরি ও কম্পিউট করা যায়, ডেটা স্ট্রাকচার এক্সেস করা, পড়া বা লেখা যেকোনো কাজে, কনস্ট্যান্ট টাইমে করা যায়।
CMS-এ আরও কিছু আছে; স্কেচের লেখকরা দেখিয়েছেন কিভাবে এটি অন্যান্য সমান প্রশ্নের উত্তর দিতে ব্যবহার করা যায়। এতে পার্সেন্টাইল অনুমান করা এবং হেভি হিটার (ফ্রিকোয়েন্ট আইটেম) চিহ্নিত করা অন্তর্ভুক্ত, যা এই পোস্টের স্কোপ বাইরে।
CMS নিঃসন্দেহে একটি চমৎকার স্কেচ, কিন্তু কমপক্ষে দুটি জিনিস এটিকে পূর্ণতা অর্জন থেকে বাধা দিচ্ছে। আমার CMS সম্পর্কে প্রথম আপত্তি হলো এটি বায়াসড হতে পারে, এবং সেজন্য কম নিবেশনযুক্ত স্যাম্পলদের ফ্রিকোয়েন্সি ওভারএস্টিমেট করতে পারে। CMS-এর বায়াস সুপরিচিত এবং অনেক উন্নতি প্রস্তাবিত হয়েছে। সাম্প্রতিকতম হলো Count Min Log Sketch ("Approximately counting with approximate counters" by G. Pitel and G. Fouquier), যা মূলত CMS-এর লিনিয়ার রেজিস্টারগুলোক লগারিদমিক রেজিস্টার দিয়ে রিপ্লেস করে রিলেটিভ এরর কমাতে এবং কাউন্টার রেজিস্টারের প্রাযতি বাড়ানো nélkül উচ্চ কাউন্ট অনুমতি দেয়।
যদিও উপরের আপত্তিটি সবাই শেয়ার করে (অল্পতঃ তারা যারা ডেটা স্ট্রাকচার বুঝে), আমার দ্বিতীয় আপত্তিটি এক্সক্লूसিভলি Redis কমিউনিটির জন্য। ব্যাখ্যা করতে হলে, আমাকে Redis Modules পরিচয় করাতে হবে।
একটি Redis মডিউল
Redis Modules RedisConf-এ antirez দ্বারা এarring প্রকাশিত হয়েছিল এবং_CHAR_আমাদের জগতকে উল্টো ফেলেছে। সার্ভার-লোডেবল ডাইনামিক লাইব্রেরির চেয়ে আর্টিকেলটা আরও কিছু নয়, Modules Redis ইউজারদের Redis নিজের চেয়ে দ্রুত অগ্রসর হতে এবং কখনো কল্পনা করা যায়নি এমন জায়গায় যেতে সক্ষম করে। এবং যদিও এই পোস্টটি Modules কী বা কিভাবে তৈরি করা যায় তার পরিচয় নয়, এইটি (এবং এই পোস্ট, এবং এই ওয়েবিনার) Modules-এর পরিচয়।
Count Min Sketch Redis মডিউল লিখতে আমার বেশ কয়েকটি কারণ ছিল, এর চরম উপযোগিতার বাইরে। অংশটা ছিল লার্নিং এক্সপেরিয়েন্স এবং অংশটা মডিউলস API-এর ইভালুয়েশন, কিন্তু অধিকাংশটা ছিল এটি Redis-এ একটি নতুন ডেটা স্ট্রাকচার মডেল করার পুরো ফান। মডিউলটি স্কেচে নিবেশন যোগ করার, কোয়েরি করার, এবং একাধিক স্কেচ মার্জ করে একটি করার জন্য একটি Redis ইন্টারফেস প্রদান করে।
মডিউলটি স্কেচের ডেটা একটি Redis String-এ সংরক্ষণ করে এবং কীটির কন্টেন্টকে এর ইন্টারনাল ডেটা স্ট্রাকচারের সাথে ম্যাপ করার জন্য ডায়রেক্ট মেমরি অ্যাক্সেস (DMA) ব্যবহার করে। আমি এখনও এক্সহাস্টিভ পারফরমেন্স বেঞ্চমার্ক করিনি, কিন্তু লোকালি টেস্ট করার আমার প্রাথমিক ধারণা হলো এটি কোনো কোর Redis কমান্ডের মতোই পারফরমেন্ট। আমাদের অন্যান্য মডিউলের মতো, countminsketch ওপেন সোর্স এবং আমি আপনাকে এটি ট্রাই করতে এবং এর ওপর হ্যাক করতে উৎসাহিত করছি।
সাইন অফ করার আগে, আমি আমার وعدা পূরণ করতে চাই এবং CMS সম্পর্কে আমার Redis-নির্দিষ্ট আপত্তি শেয়ার করতে চাই। সমস্যাটি, যা অন্যান্য স্কেচ ও ডেটা স্ট্রাকচারেও প্রযোজ্য, হলো CMS আপনাকে এটি সেট আপ/ইনিশিয়ালাইজ/তৈরি করতে বাধ্য করে ব্যবহার করার আগে। CMS প্যারামিটার সেটআপের মতো একটি বাধ্যতামূলক ইনিশিয়ালাইজেশন স্টেজের প্রয়োজনীয়তা Redis-এর একটি মৌলিক প্যাটার্ন ভাঙে—ডেটা স্ট্রাকচারগুলো ব্যবহার করার আগে এক্সপ্লিসিটলি ডিক্লেয়ার করার প্রয়োজন নেই কারণ সেগুলো অন-ডিমান্ড তৈরি হতে পারে। মডিউলটিকে আরও Redis-ish দেখানোর এবং সেই অ্যান্টি-প্যাটার্নের ওয়ার্কঅরাউন্ড হিসেবে, মডিউলটি ডিফল্ট প্যারামিটার মান ব্যবহার করে যখন একটি নতুন স্কেচ ইম্পলিসিটলি ইম্প্লাইড হয় (অর্থাৎ একটি নন-এক্সিস্টিং কীতে CMS.ADD কমান্ড ব্যবহার করা) কিন্তু দেয়া প্যারামিটার সহ নতুন খালি স্কেচ তৈরি করার অনুমতিও দেয়।
প্রোবাবিলিস্টিক ডেটা স্ট্রাকচার, বা স্কেচها, অদ্ভুত টুল যা আমাদের বড় ডেটার বৃদ্ধি এবং ল্যাটেন্সি বাজেটের সংকোচনের সাথে তাল মিলাতে দক্ষতার সাথে এবং পর্যাপ্ত নির্ভুলতার সাথে সাহায্য করে। এই পোস্টে উল্লেখিত দুটি স্কেচ, এবং অন্যান্য যেমন ব্লুম ফিল্টার এবং T-digest, আধুনিক ডেটা মংগারের 무기 শirenি অবিচ্ছেদ্য টুল হিসেবে দ্রুত পরিণত হচ্ছে। মডিউলها আপনাকে কাস্টম ডেটা টাইপ এবং কমান্ড দিয়ে Redis এক্সটেন্ড করতে দেয় যা নেটিভ স্পিডে অপারেট করে এবং ডেটাতে লোকাল অ্যাক্সেস থাকে। সম্ভাবনারা অसीম এবং কিছুই অসম্ভব নয়।
Redis মডিউল এবং কীভাবে সেগুলো ডেভেলপ করা যায় তার বিষয়ে আরও জানতে চান? কি কোনো ডেটা স্ট্রাকচার, প্রোবাবিলিস্টিক হোক বা না হোক, আপনি আলোচনা বা Redis-এ যোগ করতে চান? বিনামূল্যে আমার টুইটার অ্যাকাউন্ট বা ইমেইলের মাধ্যমে যোগাযোগ করুন—আমি খুবই উপলব্ধ 🙂
