

রেডিস একটি বেডরক টেকনোলজি এবং, такі হিসেবে, আমরা মাঝেমধ্যে লোকদের অ্যাল্টারনেটিভ আর্কিটেকচার বিবেচনা করতে দেখি। কয়েক বছর আগে এটি KeyDB দ্বারা подня गया ছিল, এবং gầnে একটি নতুন প্রজেক্ট, Dragonfly, দাবি করেছে যে তারা সবচেয়ে দ্রুত রেডিস-কম্প্যাটিবল ইন-মেমরি ডেটাস্টোর। আমরা বিশ্বাস করি এই প্রজেক্টগুলো অনেক আকর্ষণীয় টেকনোলজি এবং আইডিয়া নিয়ে এসেছে যা আলোচনা এবং বিতর্কের যোগ্য। এখানে রেডিসে, আমরা এই ধরনের চ্যালেঞ্জ পছন্দ করি, কারণ এটি আমাদের রেডিসের প্রাথমিক আর্কিটেকচারล নীতিগুলো পুনরায় যাচাই করতে বাধ্য করে (স্যালুটো স্যালভাটোর Санফিলিপ্পো যাকে antirez নামে জানা যায়)।
যদিও আমরা সবসময় রেডিসের পারফরম্যান্স এবং ক্যাপাবিলিটি অগ্রসর করার সুযোগ খুঁজি, আমরা আমাদের দৃষ্টিভঙ্গি এবং কিছু চিন্তা শেয়ার করতে চাই কেন রেডিসের আর্কিটেকচার ইন-মেমরি, রিয়েল-টাইম ডেটাস্টোর (ক্যাশ, ডাটাবেস, এবং সেরার মাঝপথের সবকিছু) এর জন্য সেরা ইন ক্লাস বने থাকে।
সুতরাং পরবর্তী সেকশনগুলোতে, আমরা স্পিড এবং আর্কিটেকচারাল পার্থক্যের ওপর আমাদের দৃষ্টিভঙ্গি হাইলাইট করব যেমন তুলনা করা হচ্ছে। এই পোস্টের শেষে, আমরা বেঞ্চমার্ক এবং পারফরম্যান্স তুলনার বিস্তারিতও দিয়েছি Dragonfly প্রজেক্টের সাথে, যা নিচে আলোচনা করা হয়েছে এবং আমরা আপনাকে আমন্ত্রণ জানাই সেগুলো রিভিউ এবং নিজেদের রিপ্রডিউস করার জন্য।
স্পিড
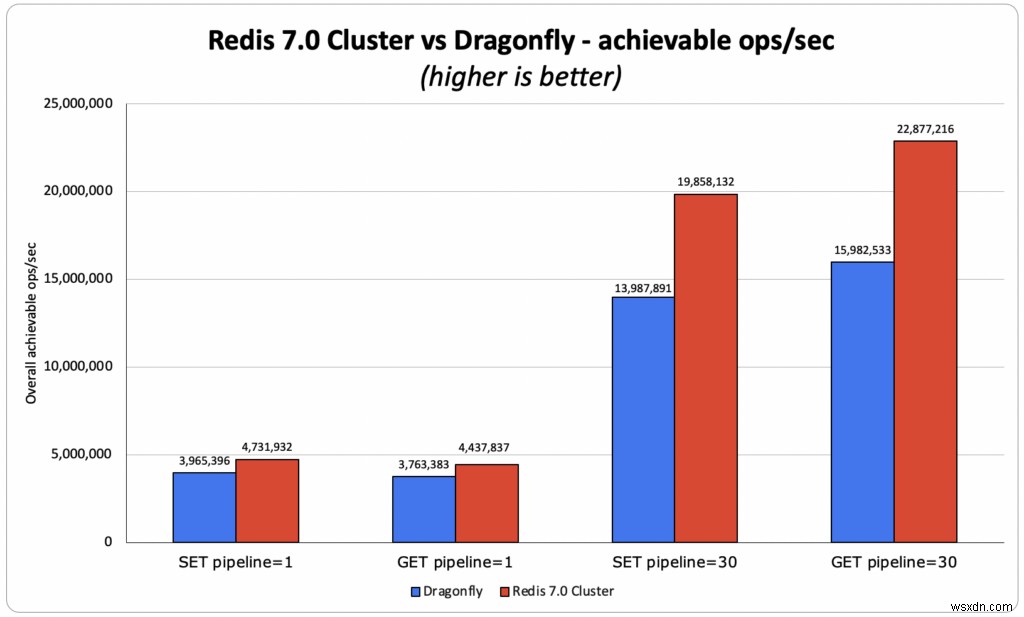
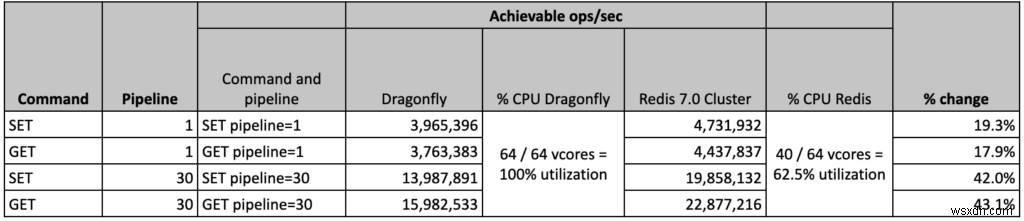
Dragonfly বেঞ্চমার্ক একটি স্ট্যান্ডঅ্যালোন সিঙ্গেল প্রসেস রেডিস ইনস্ট্যান্স (যা শুধু একটি কোর ব্যবহার করতে পারে) একটি মাল্টিথ্রেডেড Dragonfly ইনস্ট্যান্স (যা একটি VM/সার্ভারের সব উপলব্ধ কোর ব্যবহার করতে পারে) এর সাথে তুলনা করেছে। দুর্ভাগ্যক্রমে, এই তুলনা রেডিস বাস্তব বিশ্বে কীভাবে রান করা হয় সেটি প্রতিফলিত করে না। টেকনোলজি বিল্ডাররা হিসেবে, আমরা সঠিকভাবে বুঝতে চাই আমাদের টেকনোলজি অন্যান্য সাথে কীভাবে তুলনা করে, তাই আমরা সেটি করেছি যা আমরা বিশ্বাস করি একটি ন্যায্য তুলনা এবং একটি ৪০-শার্ড রেডিস ৭.০ ক্লাস্টার (যা ইনস্ট্যান্স কোরের অধিকাংশ ব্যবহার করতে পারে) Dragonfly-এর সাথে তুলনা করেছি, AWS c6gn.16xlarge ইনস্ট্যান্স টাইপে যা Dragonfly টিম তাদের বেঞ্চমার্কে সর্বোচ্চ ব্যবহার করেছে। আমাদের ট্রায়ালে, আমরা দেখেছি রেডিস ১৮% – ৪০% বেশি থ্রুপুট অর্জন করেছে Dragonfly-এর চেয়ে, এমনকি ৬৪ vCores-র মধ্যে শুধু ৪০ ব্যবহার করেই।
আর্কিটেকচারাল পার্থক্য
কিছু ব্যাকগ্রাউন্ড
আমরা বিশ্বাস করি এই মাল্টিথ্রেডেড প্রজেক্টের সৃষ্টিকর্তাদের আর্কিটেকচারাল সিদ্ধান্তগুলো তাদের পূর্বের কাজের পেইন পয়েন্টগুলো দ্বারা প্রভাবিত হয়েছে। আমরা একমত যে একটি মাল্টি-কোর মেশিনে একটি সিঙ্গেল রেডিস প্রসেস রান করা, কখনো কখনো দশক কোর এবং শতকরা গিগাবাইট মেমোরির সাথে, উপলব্ধ রিসোর্সগুলো ব্যবহার করবে না। কিন্তু এটিই রেডিস ডিজাইন করা হয়েছিল কিভাবে ব্যবহার করার জন্য; এটা শুধু অনেক রেডিস প্রোভাইডাররা তাদের সার্ভিস রান করার জন্য এই পথ বেছে নিয়েছে।
রেডিস হরিজন্টালি স্কেল করে মাল্টি-প্রসেস চালিয়ে (রেডিস ক্লাস্টার ব্যবহার করে) এমনকি একটি সিঙ্গেল ক্লাউড ইন্সট্যান্সের কনটেক্স্টেও। রেডিস (কোম্পানি) এটাকে আরও বিকাশ করেছি এবং রেডিস এন্টারপ্রাইজ তৈরি করেছি যা একটি ম্যানেজমেন্ট লেয়ার প্রদান করে যা আমাদের ইউজারদের রেডিস বড় স্কেলে চালাতে দেয়, হাই অভেইলেবিলিটি, ইনস্ট্যান্ট ফেইলওভার, ডেটা পারসিস্টেন্স, এবং ব্যাকআপ ডিফল্টভাবে এনাবলড থাকে।
আমরা আমাদের পেছনের কিছু নীতিশেয়ার করতে সিদ্ধান্ত নিয়েছি যাতে লোকেরা বুঝতে পারে আমরা কী ক্যাল করি ভালো エンজিনিয়ারিং প্র্যাক্টিস রেডিস প্রোডাকশন এনভায়রনমেন্টে চালানোর জন্য।
আর্কিটেকচারাল নীতি
প্রতি VM একাধিক রেডিস ইনস্ট্যান্স চালান
প্রতি VM একাধিক রেডিস ইনস্ট্যান্স চালাতে দেয়:
- লিনিয়ারলি স্কেল করতে, ভার্টিক্যালি এবং হরিজন্টালি দুটোই, একটি সম্পূর্ণ শেয়ারড-নথিং আর্কিটেকচার ব্যবহার করে। এটি সবসময় একটি মাল্টিথ্রেডেড আর্কিটেকচারের চেয়ে বেশি ফ্লেক্সিবিলিটি দেবে যা শুধু ভার্টিক্যালি স্কেল করে।
- রেপ্লিকেশনের গতি বাড়াতে, কারণ রেপ্লিকেশন সমান্তরাল একাধিক প্রসেস জুড়ে হয়।
- VM ফেইলার থেকে দ্রুত রিকভারি, কারণ নতুন VM-এর রেডিস ইনস্ট্যান্সগুলো একাধিক এক্সটার্নাল রেডিস ইনস্ট্যান্স থেকে একসাথে ডেটা দিয়ে পপুলেট হবে।
প্রতিটি রেডিস প্রসেসকে যুক্তিসঙ্গত আকারে সীমাবদ্ধ রাখুন
আমরা একটি সিঙ্গেল রেডিস প্রসেসকে ২৫ GB-এর বেশি বড় হওয়া দিই না (এবং ৫০ GB যখন রেডিস অন ফ্ল্যাশ রান করছে)। এটি আমাদের দেয়:
- কপি-অন-রাইটের সুবিধা নেওয়ার জন্য বড় মেমরি ওভারহেড চुकাতে না হয় রেডিস ফর্ক করার জন্য রেপ্লিকেশন, স্ন্যাপশটিং, এবং Append Only File (AOF) রিরাইটের সময়। এবং 'হ্যাঁ' যদি আপনি এটা না করেন, তবে আপনি (বা আপনার ইউজাররা) একটি ভारी দাম চুকাবেন, যেমন এখানে দেখানো হয়েছে।
- আমাদের ক্লাস্টার সহজে ম্যানেজ করতে, শার্ড মাইগ্রেট, রিশার্ড, স্কেল, এবং রিব্যালেন্স দ্রুত করিতে, কারণ রেডিসের প্রতিটি ইনস্ট্যান্স ছোট রাখা হয়।
হরিজন্টাল স্কেলিং সার্বোপরি
ইন-মেমরি ডেটাস্টোরকে হরিজন্টাল স্কেলিং সাথে চালানোর ফ্লেক্সিবিলিটি অত্যন্ত গুরুত্বপূর্ণ। এখানে কয়েকটি কারণ:
- ভালো রেজিলিয়েন্সি – আপনার ক্লাস্টারে যত বেশি নোড ব্যবহার করবেন, তত বেশি রবাস্ট আপনার ক্লাস্টার। উদাহরণস্বরূপ, আপনি যদি আপনার ডেটাসেট ৩-নোড ক্লাস্টারে চালান এবং এক নোড ডিগ্রেডেড হয়, তবে আপনার ক্লাস্টারের ১/৩ পারফর্ম করছে না; কিন্তু আপনি যদি ৯-নোড ক্লাস্টারে চালান এবং এক নোড ডিগ্রেডেড হয়, তবে সেটি আপনার ক্লাস্টারের শুধু ১/৯।
- স্কেল করা সহজ – আপনার ক্লাস্টারে একটি অতিরিক্ত নোড যোগ করা এবং আপনার ডেটাসেটের শুধু একটি অংশ সেখানে মাইগ্রেট করা অনেক সহজ, ভার্টিক্যালি স্কেল করার চেয়ে, যেখানে আপনাকে একটি বড় নোড আনার প্রয়োজন এবং আপনার পুরো ডেটাসেট কপি করতে হয় (এবং সেই সম্ভাব্য দীর্ঘ প্রসেসের মাঝপথে যা খারাপ ঘটতে পারে সেটি চিন্তা করুন…)
- ক্রমাগত স্কেলিং খুব বেশি কাস্ট-ইফেক্টিভ – ভার্টিক্যালি স্কেলিং, বিশেষ করে ক্লাউডে, ব্যয়বহুল। অনেক ক্ষেত্রে, আপনাকে আপনার ইন্সট্যান্স সাইজ ডাবল করতে হয় এমনকি আপনি যদি শুধু কিছু GB আপনার ডেটাসেটে যোগ করতে চান।
- হাই থ্রুপুট – রেডিসে, আমরা অনেক কাস্টমার দেখি যারা হাই থ্রুপুট ওয়ার্কলোড ছোট ডেটাসেটে চালাচ্ছে, খুব হাই নেটওয়ার্ক ব্যান্ডউইথ এবং/অথবা হাই প্যাকেট পার সেকেন্ড (PPS) ডিমांडের সাথে। একটি ১GB ডেটাসেট ১M+ ops/sec ইউজ কেসের কথা চিন্তা করুন। কি এটি একটি সিঙ্গেল-নোড c6gn.16xlarge ক্লাস্টারে চালানোর মানে (১২৮GB সাথে ৬৪ CPU এবং ১০০gbps $২.৭৬৮৪/hr-এ) বজায় ৩-নোড c6gn.xlarge ক্লাস্টারে (৮GB, ৪ CPU পর্যন্ত ২৫Gbps $০.১৭৮৬/hr প্রতিটা) ২০% এর কম খরচে এবং অনেক বেশি রবাস্ট манেরে? থ্রুপুট বাড়াতে পারা এবং কাস্ট-ইফেক্টিভনেস ও রেজিলিয়েন্সি উন্নত করা সহজ উত্তর মনে হচ্ছে।
- NUMA-এর বাস্তবতা – ভার্টিক্যালি স্কেল করার মানে দুই-সকেট সার্ভার একাধিক কোর এবং বড় DRAM এর সাথে রান করা; এই NUMA-ভিত্তিক আর্কিটেকচার একটি মাল্টি-প্রসেসিং আর্কিটেকচারের মতো রেডিসের জন্য চমৎকার কারণ এটি ছোট নোডের একটি নেটওয়ার্কের মতো বiheav করে। কিন্তু NUMA একটি মাল্টিথ্রেডেড আর্কিটেকচারের জন্য আরও চ্যালেঞ্জিং, এবং অন্যান্য মাল্টিথ্রেডেড প্রজেক্টের সাথে আমাদের অভিজ্ঞতা থেকে, NUMA একটি ইন-মেমরি ডেটাস্টোরের পারফরম্যান্স ৮০% পর্যন্ত কমাতে পারে।
- স্টোরেজ থ্রুপুট লিমিট – এক্সটার্নাল ডিস্ক যেমন AWS EBS, মেমরি এবং CPU তত দ্রুত স্কেল করে না। আসলে, ক্লাউড সার্ভিস প্রোভাইডার দ্বারা মেশিন ক্লাসের ভিত্তিতে স্টোরেজ থ্রুপুট লিমিট आरোপ করা থাকে। তাই, একমাত্র উপায় একটি ক্লাস্টার কার্যকরভাবে স্কেল করার জন্য ইতিবাচক সমস্যাগুলো এড়াতে এবং হাই ডেটা-পারসিস্টেন্স রিকোয়ারমেন্ট মেট করার জন্য হরিজন্টাল স্কেলিং ব্যবহার করা, অর্থাৎ আরও নোড এবং আরও নেটওয়ার্ক-অ্যাটাচড ডিস্ক যোগ করা।
- এফেমেরাল ডিস্ক – একটি এফেমেরাল ডিস্ক রেডিস অন SSD চালানোর একটি চমৎকার উপায় (যেখানে SSD DRAM রিপ্লেসমেন্ট হিসেবে ব্যবহৃত হয়, কিন্তু পারসিস্টেন্ট স্টোরেজ হিসেবে নয়) এবং ডিস্ক-ভিত্তিক ডাটাবেসের খরচে রেডিস স্পিড উপভোগ করা (দेखুন আমরা কীভাবে রেডিস অন ফ্ল্যাশ দিয়ে এটা করি)। আবার, যখন এফেমেরাল ডিস্ক তার লিমিটে পৌঁছায়, আপনার ক্লাস্টার স্কেল করার সবচেয়ে ভালো উপায়, এবং অনেক ক্ষেত্রে একমাত্র উপায়, আরও নোড এবং আরও এফেমেরাল ডিস্ক যোগ করা।
- কমোডিটি হার্ডওয়্যার – অবশেষে, আমাদের অনেক অন-প্রেমিস কাস্টমার আছে যারা লোকাল ডেটা সেন্টার, প্রাইভেট ক্লাউড, এবং এমনকি ছোট এজ ডেটা সেন্টারে রান করছে; এই এনভায়রনমেন্টে, ৬৪ GB-এর বেশি মেমরি এবং ৮ CPU বিশিষ্ট মেশিন খুঁজে পাওয়া কঠিন হতে পারে, এবং আবার একমাত্র উপায় স্কেল করার হরিজন্টাল।
সারসংক্ষেপ
আমরা আমাদের কমিউনিটি থেকে তাজা, আকর্ষণীয় আইডিয়া এবং টেকনোলজি আপনাই করি যেন নতুন তরঙ্গের মাল্টিথ্রেডেড প্রজেক্ট অফার করে। এটিও সম্ভব যে এই কনসেপ্টগুলোর কিছু ভবিষ্যতে রেডিসে আসতে পারে (যেমন io_uring যা আমরা ইতিমধ্যে দেখছি, আরও আধুনিক ডিকশনারি, থ্রেডের আরও ট্যাকটিক্যাল ব্যবহার, ইত্যাদি)। কিন্তু নিকট ভবিষ্যতে, আমরা রেডিস যে শেয়ারড-নথিং, মাল্টি-প্রসেস আর্কিটেকচার প্রদান করে সেটি ত্যাগ করব না। এই ডিজাইন সেরা পারফরম্যান্স, স্কেলিং, এবং রেজিলিয়েন্সি প্রদান করে এবং ইন-মেমরি, রিয়েল-টাইম ডেটা প্ল্যাটফর্মের জন্য প্রয়োজনীয় ডিপ্লয়মেন্ট আর্কিটেকচারের varit—¡ সমর্থন করে।
অ্যাপেন্ডিক্স Redis 7.0 vs. Dragonfly বেঞ্চমার্ক ডিটেইলস
বেঞ্চমার্ক সারসংক্ষেপ
ভার্সন:
- আমরা রেডিস ৭.০.০ ব্যবহার করেছি এবং সোর্স থেকে বিল্ড করেছি
- Dragonfly ৩ জুন को সোর্স থেকে বিল্ড করা হয়েছে (hash=e806e6ccd8c79e002f721a1a5ecb847bd7a06489) যেমন https://github.com/Dragonfly/dragonfly#building-from-source-এ রিকমেন্ড করা
লক্ষ্য:
- যাচাই করা যে Dragonfly ফলাফলগুলো রিপ্রডিউসযোগ্য এবং সেটি কোন কন্ডিশনে পাওয়া গেছে তা নির্ধারণ করা (যেহেতু memtier_benchmark-এ কিছু কনফিগ মিসিং ছিল, OS ভার্সন, ইত্যাদি… ) আরও জানতে এখানে দেখুন
- OSS Redis 7.0.0 ক্লাস্টারের সেরা অর্জনযোগ্য পারফরম্যান্স নির্ধারণ করা AWS c6gn.16xlarge ইনস্ট্যান্সে, Dragonfly-এর বেঞ্চমার্ক ম্যাচ করে
ক্লায়েন্ট কনফিগারেশন:
- OSS Redis 7.0 সমাধানটির জন্য রেডিস ক্লাস্টারের সাথে বেশি সংখ্যক ওপেন কানেকশন প্রয়োজন, যেহেতু প্রতিটি memtier_benchmark থ্রেড সব শার্ডের সাথে কানেক্টেড
- OSS Redis 7.0 সমাধানটি সেরা ফলাফল দিয়েছে দুটি memtier_benchmark প্রসেস দিয়ে বেঞ্চমার্ক চালিয়ে কিন্তু একই ক্লায়েন্ট VM-এ Dragonfly বেঞ্চমার্ক ম্যাচ করার জন্য
রিসোর্স ইউটিলাইজেশন এবং অপ্টিমাল কনফিগারেশন:
- OSS Redis ক্লাস্টার সেরা ফলাফল দিয়েছে ৪০ প্রাইমারি শার্ডে, অর্থাৎ VM-এ ২৪ স্পেয়ার vCPUs আছে। যদিও মেশিনটি পুরোপুরি ইউটিলাইজড ছিল না, আমরা পেলাম শার্ড সংখ্যা বাড়ালে সাহায্য করল না, বরং সামগ্রিক পারফরম্যান্স কমে গেল। আমরা এখনও এই আচরণ 조사 করছি।
- অন্যদিকে, Dragonfly সমাধানটি পুরো VM টপ আপ করলো সব ৬৪ VCPUs ১০০% ইউটিলাইজেশন तक পৌঁছে।
- দুই সমাধানের জন্যও, আমরা ক্লায়েন্ট কনফিগারেশন ভেরিয়েট করেছি সেরা সম্ভাব্য ফলাফল পেতে। নিচে দেখা যাচ্ছে, আমরা Dragonfly ডেটার অধিকাংশ রিপ্লিকেট করতে পেরেছি এবং পাইপলাইন ৩০ এর জন্য সেরা ফলাফলও ছাড়িয়ে যাচ্ছি।
- এটি মানে আমরা রেডিসের সাথে আরও বেশি সংখ্যা অর্জন করার সম্ভাবনা রয়েছে।
শেষে, আমরা আরও খুঁজে পেলাম যে রেডিস এবং Dragonfly দুটোই নেটওয়ার্ক PPS বা ব্যান্ডউইথ দ্বারা লিমিটেড ছিল না, যেহেতু আমরা কনফার্ম করেছি যে ব্যবহৃত ২ VM (ক্লায়েন্ট এবং সার্ভারের জন্য, দুটোই c6gn.16xlarge ব্যবহার করে) এর মধ্যে আমরা > ১০M PPS এবং >৩০ Gbps পেতে পারি TCP-তে ~৩০০B পেলোডের সাথে।
ফলাফল বিশ্লেষণ
- GET pipeline 1 sub-ms:
- OSS Redis: ৪.৪৩M ops/sec, যেখানে avg এবং p50 উভয়ই সাব-মিলিসেকেন্ড ল্যাটেন্সি অর্জন করেছে। গড় ক্লায়েন্ট ল্যাটেন্সি ০.৩৮৩ ms
- Dragonfly দাবি ৪M ops/sec:
- আমরা ৩.৮M ops/sec রিপ্রডিউস করতে পেরেছি, গড় ক্লায়েন্ট ল্যাটেন্সি ০.৩৯০ ms
- Redis vs Dragonfly – Redis থ্রুপুট বেশি ১০% Dragonfly দাবির ফলাফলের চেয়ে এবং ১৮% Dragonfly ফলাফলের চেয়ে যা আমরা রিপ্রডিউস করতে পেরেছি।
- GET pipeline 30:
- OSS Redis: ২২.৯M ops/sec গড় ক্লায়েন্ট ল্যাটেন্সি ২.২৩৯ ms-এ
- Dragonfly দাবি ১৫M ops/sec:
- আমরা ১৫.৯M ops/sec রিপ্রডিউস করতে পেরেছি গড় ক্লায়েন্ট ল্যাটেন্সি ৩.৯৯ ms-এ
- Redis vs Dragonfly – Redis ভালো ৪৩% (Dragonfly রিপ্রডিউসড ফলাফলের চেয়ে) এবং ৫২% (Dragonfly দাবির ফলাফলের চেয়ে)
- SET pipeline 1 sub-ms:
- OSS Redis: ৪.৭৪M ops/sec, যেখানে avg এবং p50 উভয়ই সাব-মিলিসেকেন্ড ল্যাটেন্সি অর্জন করেছে। গড় ক্লায়েন্ট ল্যাটেন্সি ০.৩৯১ ms
- Dragonfly দাবি ৪M ops/sec:
- আমরা ৪M ops/sec রিপ্রডিউস করতে পেরেছি, গড় ক্লায়েন্ট ল্যাটেন্সি ০.৫০০ ms
- Redis vs Dragonfly – Redis ভালো ১৯% (আমরা একই ফলাফল রিপ্রডিউস করেছি যা Dragonfly দাবি করেছিল)
- SET pipeline 30:
- OSS Redis: ১৯.৮৫M ops/sec, গড় ক্লায়েন্ট ল্যাটেন্সি ২.৮৭৯ ms-এ
- Dragonfly দাবি ১০M ops/sec:
- আমরা ১৪M ops/sec রিপ্রডিউস করতে পেরেছি, গড় ক্লায়েন্ট ল্যাটেন্সি ৪.২০৩ ms
- Redis vs Dragonfly – Redis ভালো ৪২% (Dragonfly রিপ্রডিউসড ফলাফলের চেয়ে) এবং ৯৯% (Dragonfly দাবির ফলাফলের চেয়ে)
memtier_benchmark কমান্ডগুলো প্রতিটি ভেরিয়েশনের জন্য:
- GET pipeline 1 sub-ms
- Redis:
- 2X: memtier_benchmark –ratio 0:1 -t 24 -c 1 –test-time 180 –distinct-client-seed -d 256 –cluster-mode -s 10.3.1.88 –port 30001 –key-maximum 1000000 –hide-histogram
- Dragonfly:
- memtier_benchmark –ratio 0:1 -t 55 -c 30 -n 200000 –distinct-client-seed -d 256 -s 10.3.1.6 –key-maximum 1000000 –hide-histogram
- Redis:
- GET pipeline 30
- Redis:
- 2X: memtier_benchmark –ratio 0:1 -t 24 -c 1 –test-time 180 –distinct-client-seed -d 256 –cluster-mode -s 10.3.1.88 –port 30001 –key-maximum 1000000 –hide-histogram –pipeline 30
- Dragonfly:
- memtier_benchmark –ratio 0:1 -t 55 -c 30 -n 200000 –distinct-client-seed -d 256 -s 10.3.1.6 –key-maximum 1000000 –hide-histogram –pipeline 30
- Redis:
- SET pipeline 1 sub-ms
- Redis:
- 2X: memtier_benchmark –ratio 1:0 -t 24 -c 1 –test-time 180 –distinct-client-seed -d 256 –cluster-mode -s 10.3.1.88 –port 30001 –key-maximum 1000000 –hide-histogram
- Dragonfly:
- memtier_benchmark –ratio 1:0 -t 55 -c 30 -n 200000 –distinct-client-seed -d 256 -s 10.3.1.6 –key-maximum 1000000 –hide-histogram
- Redis:
- SET pipeline 30
- Redis:
- 2X: memtier_benchmark –ratio 1:0 -t 24 -c 1 –test-time 180 –distinct-client-seed -d 256 –cluster-mode -s 10.3.1.88 –port 30001 –key-maximum 1000000 –hide-histogram –pipeline 30
- Dragonfly:
- memtier_benchmark –ratio 1:0 -t 55 -c 30 -n 200000 –distinct-client-seed -d 256 -s 10.3.1.6 –key-maximum 1000000 –hide-histogram –pipeline 30
- Redis:
ইনফ্রাস্ট্রাকচার ডিটেইলস
আমরা ক্লায়েন্ট (memtier_benchmark চালানোর জন্য) এবং সার্ভার (Redis এবং Dragonfly চালানোর জন্য) উভয়ের জন্য একই VM টাইপ ব্যবহার করেছি, স্পেসিফিকেশন:
- VM:
- AWS c6gn.16xlarge
- aarch64
- ARM Neoverse-N1
- Core(s) per socket: 64
- Thread(s) per core: 1
- NUMA node(s): 1
- AWS c6gn.16xlarge
- Kernel: Arm64 Kernel 5.10
- ইনস্টল্ড মেমরি: 126GB
