

প্রতিটি ব্যবসা গ্রাহকের лоয়ালিটির ওপর নির্ভর করে। গ্রাহক থেকে রিপিট বিজনেস ব্যবসা লাভজনকতার কৌন্স্টারস্টোন 중 하나। তাই জানা গুরুত্বপূর্ণ যে গ্রাহকরা কেন ব্যবসা ছেড়ে যায়। গ্রাহকদের যাওয়াকে কাস্টমার চার্ন বলে। অতীতের ট্রেন্ড দেখে আমরা বুঝতে পারি চার্নকে কী কী ফ্যাক্টর প্রভাবিত করে এবং কীভাবে প্রিডিক্ট করব যে কোনো নির্দিষ্ট গ্রাহক ব্যবসা ছেড়ে যাবে কিনা। এই আর্টিকেলে আমরা ML অ্যালগরিদম ব্যবহার করে অতীতের চার্ন ট্রেন্ড অধ্যয়ন করব এবং তারপর জজ করব কোন গ্রাহকরা চার্ন করতে পারে।
ডেটা প্রিপারেশন
উদাহরণ হিসেবে টেলিকম কাস্টমার চার্ন বিবেচনা করছি। সোর্স ডেটা ক্যাগলএ উপলব্ধ। ডেটা ডাউনলোডের URL প্রোগ্রামে উল্লেখ করা আছে। আমরা Pandas লাইব্রেরি ব্যবহার করে CSV ফাইল পাইথন প্রোগ্রামে লোড করব এবং কিছু স্যাম্পল রো দেখব।
উদাহরণ
import pandas as pd
# Telco-Customer-Churn.csv ডেটাসেট লোড করা হচ্ছে
# https://www.kaggle.com/blastchar/telco-customer-churn
datainput = pd.read_csv('E:\\Telecom_customers.csv')
print("Given input data :\n", datainput)
আউটপুট
উপরোক্ত কোডটি রান করলে নিচের ফলাফল পাবেন:
Given input data :
   customerID gender  SeniorCitizen ... MonthlyCharges TotalCharges Churn
0  7590-VHVEG Female  0 ... 29.85 29.85 No
1  5575-GNVDE Male  0 ... 56.95 1889.5 No
2  3668-QPYBK Male  0 ... 53.85 108.15 Yes
3  7795-CFOCW Male  0 ... 42.30 1840.75 No
4  9237-HQITU Female  0 ... 70.70 151.65 Yes
...
7038 6840-RESVB Male  0 ... 84.80 1990.5 No
7039 2234-XADUH Female  0 ... 103.20 7362.9 No
7040 4801-JZAZL Female  0 ... 29.60 346.45 No
7041 8361-LTMKD Male  1 ... 74.40 306.6 Yes
7042 3186-AJIEK Male  0 ... 105.65 6844.5 No
[7043 rows x 21 columns]
মৌজূদা প্যাটার্ন অধ্যয়ন
এখন ডেটাসেটটি অধ্যয়ন করব চার্ন কখন হয় তার মৌজূদা প্যাটার্ন বের করতে। আমরা কিছু কলাম ড্রপ করব যেগুলো চার্নকে প্রভাবিত করে না। উদাহরণস্বরূপ, কাস্টমার আইডি কলাম চার্নকে প্রভাবিত করে না, তাই সেটি drop বা pop মেথড দিয়ে ড্রপ করব। তারপর দেয়া ডেটাসেটে চার্নের পার্সেন্টেজ দেখানো একটি চার্ট প্লট করব।
উদাহরণ ২
import pandas as pd
import matplotlib.pyplot as plt
from matplotlib import rcParams
datainput = pd.read_csv('E:\\Telecom_customers.csv')
print("Given input data :\n", datainput)
# কলাম ড্রপ করা
datainput.drop(['customerID'], axis=1, inplace=True)
datainput.pop('TotalCharges')
datainput['OnlineBackup'].unique()
data = datainput['Churn'].value_counts(sort=True)
chroma = ["#BDFCC9", "#FFDEAD"]
rcParams['figure.figsize'] = 9, 9
explode = [0.2, 0.2]
plt.pie(data, explode=explode, colors=chroma, autopct='%1.1f%%', shadow=True, startangle=180)
plt.title('Percentage of Churn in the given Data')
plt.show()
আউটপুট
উপরোক্ত কোডটি রান করলে নিচের ফলাফল পাবেন:
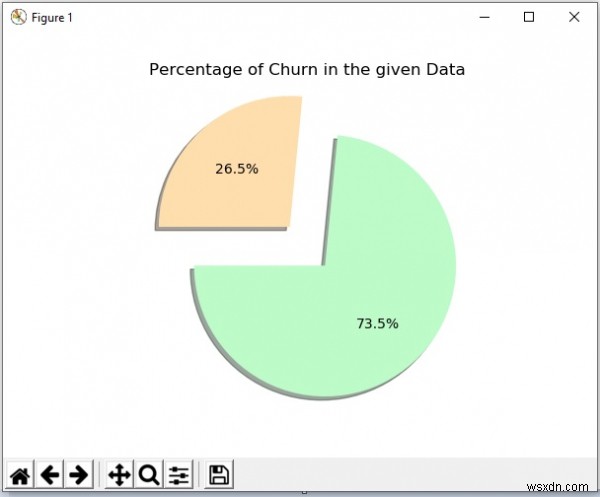
ডেটা প্রিপ্রসেসিং
ML অ্যালগরিদমের জন্য ডেটা রেডি করতে সব ফিল্ড লেবেল করব। টেক্সটুয়াল ভ্যালুগুলো নমেরিক ফ্ল্যাগে কনভার্ট করব। উদাহরণস্বরূপ, জেন্ডার কলামের মেইল/ফিমেইল ০ এবং ১-এ কনভার্ট হবে। এটি بتلك ফিল্ডগুলোর ক্যালকুলেশন এবং অ্যালগরিদমে ব্যবহারে সাহায্য করবে। আমরা sklearn-এর LabelEncoder মেথড ব্যবহার করব।
উদাহরণ ৩
import pandas as pd
from sklearn import preprocessing
label_encoder = preprocessing.LabelEncoder()
datainput['gender'] = label_encoder.fit_transform(datainput['gender'])
datainput['Partner'] = label_encoder.fit_transform(datainput['Partner'])
datainput['Dependents'] = label_encoder.fit_transform(datainput['Dependents'])
datainput['PhoneService'] = label_encoder.fit_transform(datainput['PhoneService'])
datainput['MultipleLines'] = label_encoder.fit_transform(datainput['MultipleLines'])
datainput['InternetService'] = label_encoder.fit_transform(datainput['InternetService'])
datainput['OnlineSecurity'] = label_encoder.fit_transform(datainput['OnlineSecurity'])
datainput['OnlineBackup'] = label_encoder.fit_transform(datainput['OnlineBackup'])
datainput['DeviceProtection'] = label_encoder.fit_transform(datainput['DeviceProtection'])
datainput['TechSupport'] = label_encoder.fit_transform(datainput['TechSupport'])
datainput['StreamingTV'] = label_encoder.fit_transform(datainput['StreamingTV'])
datainput['StreamingMovies'] = label_encoder.fit_transform(datainput['StreamingMovies'])
datainput['Contract'] = label_encoder.fit_transform(datainput['Contract'])
datainput['PaperlessBilling'] = label_encoder.fit_transform(datainput['PaperlessBilling'])
datainput['PaymentMethod'] = label_encoder.fit_transform(datainput['PaymentMethod'])
datainput['Churn'] = label_encoder.fit_transform(datainput['Churn'])
print("input data after label encoder :\n", datainput)
# ফিচার (X) এবং লেবেল (y) আলাদা করা
datainput["Churn"] = datainput["Churn"].astype(int)
y = datainput["Churn"].values
X = datainput.drop(labels=["Churn"], axis=1)
print("\nseparated X and y :")
print("y -", y)
print("X -", X)
আউটপুট
উপরোক্ত কোডটি রান করলে নিচের ফলাফল পাবেন:
input data after label encoder ...
separated X and y :
y - [0 0 1 ... 0 1 0]
X -    customerID  gender ... MonthlyCharges TotalCharges
0  7590-VHVEG  0 ... 29.85 29.85
1  5575-GNVDE  1 ... 56.95 1889.5
...
[7043 rows x 20 columns]
ট্রেনিং এবং টেস্টিং ডেটা
এখন ডেটাসেটকে দুটি অংশে ভাগ করব। একটি ট্রেনিংয়ে, অন্যটি টেস্টিংয়ে। test_size প্যারামিটার দিয়ে ঠিক করব ডেটাসেটের কত শতাংশ শুধু টেস্টিংয়ে ব্যবহার হবে। এই এক্সারসাইজ আমাদের তৈরি মডেলের ওপর আত্মবিশ্বাস দেবে। তারপর লজিস্টিক রিগ্রেশন অ্যালগরিদম প্রয়োগ করব এবং প্রিডিক্টেড ভ্যালু বের করব।
উদাহরণ
import pandas as pd
import warnings
warnings.filterwarnings("ignore")
from sklearn.linear_model import LogisticRegression
datainput = pd.read_csv('E:\\Telecom_customers.csv')
datainput.drop(['customerID'], axis=1, inplace=True)
datainput.pop('TotalCharges')
datainput['OnlineBackup'].unique()
from sklearn import preprocessing
label_encoder = preprocessing.LabelEncoder()
datainput['gender'] = label_encoder.fit_transform(datainput['gender'])
datainput['Partner'] = label_encoder.fit_transform(datainput['Partner'])
datainput['Dependents'] = label_encoder.fit_transform(datainput['Dependents'])
datainput['PhoneService'] = label_encoder.fit_transform(datainput['PhoneService'])
datainput['MultipleLines'] = label_encoder.fit_transform(datainput['MultipleLines'])
datainput['InternetService'] = label_encoder.fit_transform(datainput['InternetService'])
datainput['OnlineSecurity'] = label_encoder.fit_transform(datainput['OnlineSecurity'])
datainput['OnlineBackup'] = label_encoder.fit_transform(datainput['OnlineBackup'])
datainput['DeviceProtection'] = label_encoder.fit_transform(datainput['DeviceProtection'])
datainput['TechSupport'] = label_encoder.fit_transform(datainput['TechSupport'])
datainput['StreamingTV'] = label_encoder.fit_transform(datainput['StreamingTV'])
datainput['StreamingMovies'] = label_encoder.fit_transform(datainput['StreamingMovies'])
datainput['Contract'] = label_encoder.fit_transform(datainput['Contract'])
datainput['PaperlessBilling'] = label_encoder.fit_transform(datainput['PaperlessBilling'])
datainput['PaymentMethod'] = label_encoder.fit_transform(datainput['PaymentMethod'])
datainput['Churn'] = label_encoder.fit_transform(datainput['Churn'])
datainput["Churn"] = datainput["Churn"].astype(int)
Y = datainput["Churn"].values
X = datainput.drop(labels=["Churn"], axis=1)
from sklearn.model_selection import train_test_split
X_train, X_test, Y_train, Y_test = train_test_split(X, Y, test_size=0.2)
classifier = LogisticRegression()
classifier.fit(X_train, Y_train)
Y_pred = classifier.predict(X_test)
print("\npredicted values :\n", Y_pred)
আউটপুট
উপরোক্ত কোডটি রান করলে নিচের ফলাফল পাবেন:
predicted values : [0 0 1 ... 0 1 0]
ইভ্যালুয়েশন প্যারামিটার বের করা
যখন একুরেসি লেভেল গ্রহণযোগ্য হয়, তখন আমরা মডেলের আরও ইভ্যালুয়েশন করব। আমরা একুরেসি এবং কনফিউশন ম্যাট্রিক্স ব্যবহার করব মডেল কতটা সঠিক কাজ করছে তা জজ করতে। বেশি একুরেসি মডেলকে बेटার ফিট বোঝায়। কনফিউশন ম্যাট্রিক্স ট্রু পজিটিভ, ট্রু 네가েটিভ, ফালস পজিটিভ, ফালস 네가েটিভের ম্যাট্রিক্স দেখায়। ট্রু ভ্যালুর পার্সেন্টেজ ফালস চেয়ে বেশি হলে মডেল ভালো।
উদাহরণ
import pandas as pd
import warnings
warnings.filterwarnings("ignore")
from sklearn.linear_model import LogisticRegression
from sklearn import metrics
from sklearn.metrics import confusion_matrix
datainput = pd.read_csv('E:\\Telecom_customers.csv')
datainput.drop(['customerID'], axis=1, inplace=True)
datainput.pop('TotalCharges')
datainput['OnlineBackup'].unique()
from sklearn import preprocessing
label_encoder = preprocessing.LabelEncoder()
datainput['gender'] = label_encoder.fit_transform(datainput['gender'])
datainput['Partner'] = label_encoder.fit_transform(datainput['Partner'])
datainput['Dependents'] = label_encoder.fit_transform(datainput['Dependents'])
datainput['PhoneService'] = label_encoder.fit_transform(datainput['PhoneService'])
datainput['MultipleLines'] = label_encoder.fit_transform(datainput['MultipleLines'])
datainput['InternetService'] = label_encoder.fit_transform(datainput['InternetService'])
datainput['OnlineSecurity'] = label_encoder.fit_transform(datainput['OnlineSecurity'])
datainput['OnlineBackup'] = label_encoder.fit_transform(datainput['OnlineBackup'])
datainput['DeviceProtection'] = label_encoder.fit_transform(datainput['DeviceProtection'])
datainput['TechSupport'] = label_encoder.fit_transform(datainput['TechSupport'])
datainput['StreamingTV'] = label_encoder.fit_transform(datainput['StreamingTV'])
datainput['StreamingMovies'] = label_encoder.fit_transform(datainput['StreamingMovies'])
datainput['Contract'] = label_encoder.fit_transform(datainput['Contract'])
datainput['PaperlessBilling'] = label_encoder.fit_transform(datainput['PaperlessBilling'])
datainput['PaymentMethod'] = label_encoder.fit_transform(datainput['PaymentMethod'])
datainput['Churn'] = label_encoder.fit_transform(datainput['Churn'])
datainput["Churn"] = datainput["Churn"].astype(int)
Y = datainput["Churn"].values
X = datainput.drop(labels=["Churn"], axis=1)
from sklearn.model_selection import train_test_split
X_train, X_test, Y_train, Y_test = train_test_split(X, Y, test_size=0.2)
classifier = LogisticRegression()
classifier.fit(X_train, Y_train)
Y_pred = classifier.predict(X_test)
# Accuracy
LR = metrics.accuracy_score(Y_test, Y_pred) * 100
print("\nThe accuracy score using the LR is -> ", LR)
# Confusion matrix
cm = confusion_matrix(Y_test, Y_pred)
print("\nconfusion matrix : \n", cm)
আউটপুট
উপরোক্ত কোডটি রান করলে নিচের ফলাফল পাবেন:
The accuracy score using the LR is -> 80.8374733853797
confusion matrix :
[[928 109]
 [161 211]]
ভেরিয়েবল ওয়েট (Variable Importance)
এখন জজ করব প্রতিটি ফিল্ড বা ভেরিয়েবল কীভাবে চার্ন ভ্যালুকে প্রভাবিত করে। এটি আমাদের নির্দিষ্ট ভেরিয়েবল টার্গেট করতে সাহায্য করবে যেগুলোর চার্নের ওপর বেশি 임প্যাক্ট আছে। এর জন্য ক্লাসিফায়ারের কোএফিশিয়েন্ট শূন্য সেট করে সব ভেরিয়েবলের ওয়েট বের করব।
উদাহরণ
import pandas as pd
import warnings
warnings.filterwarnings("ignore")
from sklearn.linear_model import LogisticRegression
datainput = pd.read_csv('E:\\Telecom_customers.csv')
datainput.drop(['customerID'], axis=1, inplace=True)
datainput.pop('TotalCharges')
datainput['OnlineBackup'].unique()
from sklearn import preprocessing
label_encoder = preprocessing.LabelEncoder()
datainput['gender'] = label_encoder.fit_transform(datainput['gender'])
datainput['Partner'] = label_encoder.fit_transform(datainput['Partner'])
datainput['Dependents'] = label_encoder.fit_transform(datainput['Dependents'])
datainput['PhoneService'] = label_encoder.fit_transform(datainput['PhoneService'])
datainput['MultipleLines'] = label_encoder.fit_transform(datainput['MultipleLines'])
datainput['InternetService'] = label_encoder.fit_transform(datainput['InternetService'])
datainput['OnlineSecurity'] = label_encoder.fit_transform(datainput['OnlineSecurity'])
datainput['OnlineBackup'] = label_encoder.fit_transform(datainput['OnlineBackup'])
datainput['DeviceProtection'] = label_encoder.fit_transform(datainput['DeviceProtection'])
datainput['TechSupport'] = label_encoder.fit_transform(datainput['TechSupport'])
datainput['StreamingTV'] = label_encoder.fit_transform(datainput['StreamingTV'])
datainput['StreamingMovies'] = label_encoder.fit_transform(datainput['StreamingMovies'])
datainput['Contract'] = label_encoder.fit_transform(datainput['Contract'])
datainput['PaperlessBilling'] = label_encoder.fit_transform(datainput['PaperlessBilling'])
datainput['PaymentMethod'] = label_encoder.fit_transform(datainput['PaymentMethod'])
datainput['Churn'] = label_encoder.fit_transform(datainput['Churn'])
datainput["Churn"] = datainput["Churn"].astype(int)
Y = datainput["Churn"].values
X = datainput.drop(labels=["Churn"], axis=1)
from sklearn.model_selection import train_test_split
X_train, X_test, Y_train, Y_test = train_test_split(X, Y, test_size=0.2)
classifier = LogisticRegression()
classifier.fit(X_train, Y_train)
Y_pred = classifier.predict(X_test)
# সব ভেরিয়েবলের ওয়েট
wt = pd.Series(classifier.coef_[0], index=X.columns.values)
print("\nweight of all the variables :")
print(wt.sort_values(ascending=False))
আউটপুট
উপরোক্ত কোডটি রান করলে নিচের ফলাফল পাবেন:
weight of all the variables :
PaperlessBilling      0.389379
SeniorCitizen         0.246504
InternetService       0.209283
Partner               0.067855
StreamingMovies       0.054309
MultipleLines         0.042330
PaymentMethod         0.039134
MonthlyCharges        0.027180
StreamingTV          -0.008606
gender               -0.029547
tenure               -0.034668
DeviceProtection     -0.052690
OnlineBackup         -0.143625
Dependents           -0.209667
OnlineSecurity       -0.245952
TechSupport          -0.254740
Contract             -0.729557
PhoneService         -0.950555
dtype: float64
