সেন্সাস হচ্ছে একটি প্রদত্ত জনসংখ্যা সম্পর্কে তথ্য সিস্টেমেটিকভাবে রেকর্ড করা। সংগৃহীত ডেটা অন্তর্ভুক্ত করে বিভিন্ন ক্যাটাগরির তথ্য যেন- ডেমোগ্রাফিক, ইকোনমিক, হ্যাবিটেশন ডিটেইলস ইত্যাদি। এটি চূড়ান্তভাবে সরকারকে বর্তমান পরিস্থিতি বুঝতে এবং ভবিষ্যতের জন্য প্ল্যানিং করতে সাহায্য করে। এই আর্টিকেলে আমরা দেখব কীভাবে পাইথন লিভারেজ করে ভারতীয় জনসংখ্যার সেন্সাস ডেটা অ্যানালাইসিস করা যায়। আমরা বিভিন্ন ডেমোগ্রাফিক এবং ইকোনমিক দিক দেখব। তারপর চার্ট প্লট করব যা অ্যানালাইসিসকে গ্রাফিক্যালি প্রজেক্ট করবে। সোর্স ক্যাগল থেকে সংগৃহীত।
ডেটা অর্গানাইজ করা
নিচের প্রোগ্রামে প্রথমে আমরা একটি ছোট পাইথন প্রোগ্রাম দিয়ে ডেটা অ্যাকোয়ার করব। এটি শুধু ডেটা পান্ডাস ডেটাফ্রেমে লোড করে পরবর্তী অ্যানালাইসিসের জন্য। আউটপুটে কিছু ফিল্ড দেখানো হয়েছে সিম্পল রিপ্রেজেন্টেশনের জন্য।
উদাহরণ
import pandas as pd
datainput = pd.read_csv('E:\\india-districts-census-2011.csv')
# https://www.kaggle.com/danofer/india-census#india-districts-census-2011.csv
print(datainput)
আউটপুট
উপরোক্ত কোডটি রান করলে নিচের ফলাফল পাবেন:
    District code ... Total_Power_Parity
0               1 ... 1119
1               2 ... 1066
2               3 ... 242
3               4 ... 214
4               5 ... 629
..            ... ... ...
635           636 ... 10027
636           637 ... 4890
637           638 ... 3151
638           639 ... 3151
639           640 ... 5782
[640 rows x 118 columns]
দুই রাজ্যের সাদৃশ্য বিশ্লেষণ (Analysing Similarity Between Two States)
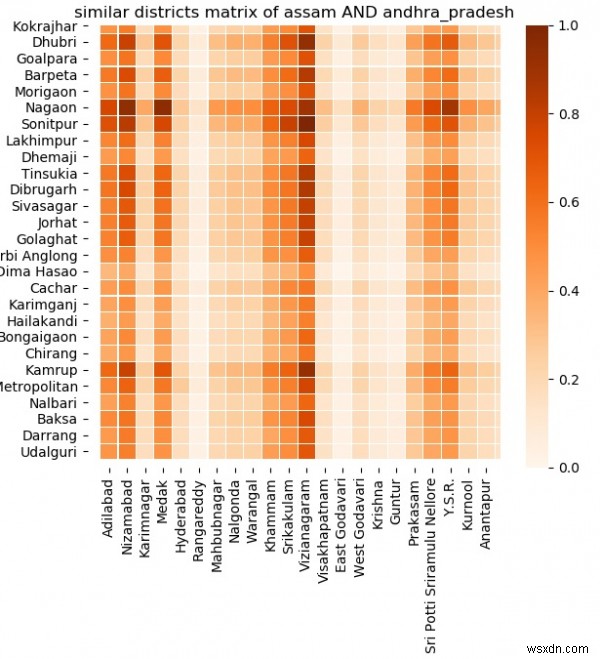
এখন যেহেতু ডেটা সংগৃহীত হয়েছে, আমরা দুই রাজ্যের মধ্যে ভিন্ন ফ্রন্টে সাদৃশ্য বিশ্লেষণ করতে পারি। সাদৃশ্য হতে পারে এজ গ্রুপ, কম্পিউটার অনারশিপ, হাউজিং অ্যাক্সেস, এডুকেশন লেভেল ইত্যাদির ভিত্তিতে। নিচের উদাহরণে আমরা'Assam' এবং 'Andhra Pradesh' নামক দুটি রাজ্য নিচ্ছি। তারপর similarity_matrix ব্যবহার করে দুটি রাজ্য তুলনা করব। ডেটাসেটের সব ফিল্ড দুটি রাজ্যের প্রতিটি ডিস্ট্রিক্টের সম্ভাব্য জোড়ার জন্য কম্পেয়ার করা হবে। ফলাফল হিটম্যাপ ইন্ডিকেট করবে কতটা কস إِلি সম্পর্কিত। যেন যত গাঢ় রঙ, ততটা নিকটবর্তী সম্পর্ক।
উদাহরণ
import pandas as pd
import matplotlib.pyplot as plot
from matplotlib.colors import Normalize
import seaborn as sns
import math
datainput = pd.read_csv('E:\\india-districts-census-2011.csv')
df_ASSAM = datainput.loc[datainput['State name'] == 'ASSAM']
df_ANDHRA_PRADESH = datainput.loc[datainput['State name'] == 'ANDHRA PRADESH']
def segment(x1, x2):
    # উভয় ডেটাফ্রেমের ইনডেক্স সেট
    x1.set_index('District code')
    x2.set_index('District code')
    # সাদৃশ্য ম্যাট্রিক্স সাইজ len(x1) X len(x2)
    similarity_matrix = []
    # df1-এর রোগুলোর ওপর ইটারেশন
    for r1 in x1.iterrows():
        # x2-এর অন্যান্য রো સાથે রো১ এর সাদৃশ্য স্কোর রাখার লিস্ট
        y = []
        # x2-এর রোগুলোর ওপর ইটারেশন
        for r2 in x2.iterrows():
            # স্কয়ারড ডিফারেন্সের সমষ্টি ক্যালকুলেট
            n = 0
            for c in list(datainput)[3:]:
                maximum_c = max(datainput[c])
                minimum_c = min(datainput[c])
                n += pow((r1[1][c] - r2[1][c]) / (maximum_c - minimum_c), 2)
            # স্কয়ার রুট নেওয়া এবং ইনভার্স করা
            y.append(1 / math.sqrt(n))
        # সাদৃশ্য স্কোর অ্যাপেন্ড
        similarity_matrix.append(y)
    p = 0
    q = 0
    r = 0
    for m in range(len(similarity_matrix)):
        for n in range(len(similarity_matrix[m])):
            if (similarity_matrix[m][n] > p):
                p = similarity_matrix[m][n]
                q = m
                r = n
    print("%s from ASSAM and %s from ANDHRA PRADESH are most similar" % (x1['District name'].iloc[q], x2['District name'].iloc[r]))
    return similarity_matrix
m = segment(df_ASSAM, df_ANDHRA_PRADESH)
normalization = Normalize()
s = plot.axes()
sns.heatmap(normalization(m), xticklabels=df_ANDHRA_PRADESH['District name'], yticklabels=df_ASSAM['District name'], linewidths=0.05, cmap='Oranges').set_title("similar districts matrix of assam AND andhra_pradesh")
plot.rcParams['figure.figsize'] = (20, 20)
plot.show()
আউটপুট
উপরোক্ত কোডটি রান করলে নিচের ফলাফল পাবেন:
নির্দিষ্ট প্যারামিটার তুলনা (Comparing specific parameters)
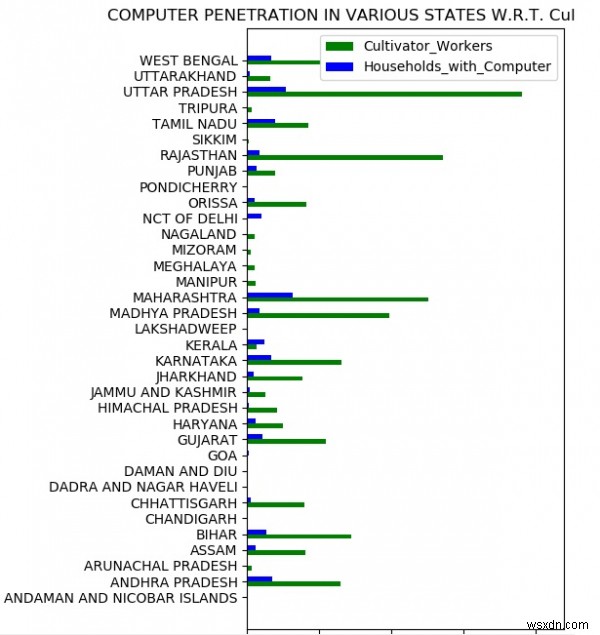
আমরা নির্দিষ্ট প্যারামিটার wzglęতে স্থানগুলো তুলনা করব। নিচের উদাহরণে আমরা চাষি শ্রমিকদের জন্য হাউজহোল্ড কম্পিউটার উপলব্ধতার তুলনা করব। আমরা একটি গ্রাফ তৈরি করব যা প্রতিটি রাজ্যের জন্য এই দুটি প্যারামিটার তুলনা করবে।
উদাহরণ
import pandas as pd
import matplotlib.pyplot as plot
from numpy import *
datainput = pd.read_csv('E:\\india-districts-census-2011.csv')
z = datainput.groupby(by="State name")
m = []
w = []
for k, g in z:
    t = 0
    t1 = 0
    for r in g.iterrows():
        t += r[1][36]
        t1 += r[1][21]
    m.append((k, t))
    w.append((k, t1))
mp = pd.DataFrame({
    'state': [x[0] for x in m],
    'Households_with_Computer': [x[1] for x in m],
    'Cultivator_Workers': [x[1] for x in w]})
d = arange(35)
wi = 0.3
fig, f = plot.subplots()
plot.xlim(0, 22000000)
r1 = f.barh(d, mp['Cultivator_Workers'], wi, color='g', align='center')
r2 = f.barh(d + wi, mp['Households_with_Computer'], wi, color='b', align='center')
f.set_xlabel('Population')
f.set_title('COMPUTER PENETRATION IN VARIOUS STATES W.R.T. Cultivator_Workers')
f.set_yticks(d + wi / 2)
f.set_yticklabels((x for x in mp['state']))
f.legend((r1[0], r2[0]), ('Cultivator_Workers', 'Households_with_Computer'))
plot.rcParams.update({'font.size': 15})
plot.rcParams['figure.figsize'] = (15, 15)
plot.show()
আউটপুট
উপরোক্ত কোডটি রান করলে নিচের ফলাফল পাবেন: