স্ট্যাটিস্টিক্স এমএল এবং এআই শিখতে ফান্ডামেন্টাল। যেহেতু পাইথন এই টেকনোলজিগুলোর পছন্দের ল্যাঙ্গুয়েজ, আমরা দেখব কীভাবে স্ট্যাটিস্টিক্যাল ან্যালসিস অন্তর্ভুক্ত করে পাইথন প্রোগ্রাম লিখা যায়। এই আর্টিকেলে আমরা দেখব কিভাবে বিভিন্ন পাইথন মডিউল ব্যবহার করে গ্রাফ এবং চার্ট তৈরি করা যায়। এই চার্টের বৈচিত্র্য আমাদের ডেটা দ্রুত বিশ্লেষণ করে গ্রাফিক্যালি ইনসাইট বা উপসংহার বের করতে সাহায্য করে।
ডেটা প্রিপারেশন
আমরা বীজের ডেটাসেট নিচ্ছি যা ক্যাগলএ উপলব্ধ। এতে আট কলাম আছে যেগুলো ব্যবহার করে বীজের বিভিন্ন বৈশিষ্ট্য তুলনা করার জন্য বিভিন্ন ধরণের চার্ট বানাব। নিচের প্রোগ্রাম লোকাল এনভায়রনমেন্ট থেকে ডেটাসেট লোড করে কিছু স্যাম্পল রো প্রদর্শন করে।
উদাহরণ
import pandas as pd
import warnings
warnings.filterwarnings("ignore")
datainput = pd.read_csv('E:\\seeds.csv')
# https://www.kaggle.com/jmcaro/wheat-seedsuci
print(datainput)
আউটপুট
উপরোক্ত কোডটি রান করলে নিচের ফলাফল পাবেন:
     Area  Perimeter  Compactness ... Asymmetry.Coeff  Kernel.Groove  Type
0   15.26      14.84       0.8710 ...          2.221          5.220     1
1   14.88      14.57       0.8811 ...          1.018          4.956     1
2   14.29      14.09       0.9050 ...          2.699          4.825     1
3   13.84      13.94       0.8955 ...          2.259          4.805     1
4   16.14      14.99       0.9034 ...          1.355          5.175     1
..    ...        ...          ... ...            ...            ...   ...
194 12.19      13.20       0.8783 ...          3.631          4.870     3
195 11.23      12.88       0.8511 ...          4.325          5.003     3
196 13.20      13.66       0.8883 ...          8.315          5.056     3
197 11.84      13.21       0.8521 ...          3.598          5.044     3
198 12.30      13.34       0.8684 ...          5.637          5.063     3
[199 rows x 8 columns]
হিস্টোগ্রাম তৈরি করা
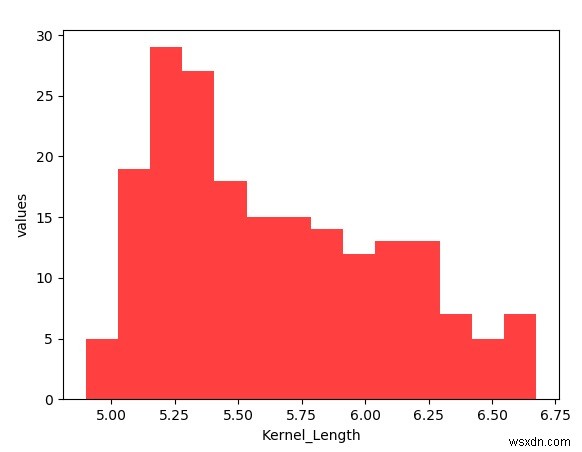
হিস্টোগ্রাম বানাতে হেডার রো সরিয়ে CSV ফাইলকে NumPy অ্যারে হিসেবে পড়ব। তারপর genfromtxt মডিউল দিয়ে ফাইল পড়ব। কার্নেল লেন্থ ফিল্ড অ্যারেতে কলাম ইনডেক্স ৩-এ অবস্থিত। শেষে matplotlib ব্যবহার করে NumPy-র ডেটাসেট দিয়ে হিস্টোগ্রাম প্লট করব এবং লেবেল যোগ করব।
উদাহরণ
import matplotlib.pyplot as plot
import numpy as np
from numpy import genfromtxt
seed_data = genfromtxt('E:\\seeds.csv', delimiter=',')
Kernel_Length = seed_data[:, [3]]
x = len(Kernel_Length)
y = np.sqrt(x)
y = int(y)
z = plot.hist(Kernel_Length, bins=y, color='#FF4040')
z = plot.xlabel('Kernel_Length')
z = plot.ylabel('values')
plot.show()
আউটপুট
উপরোক্ত কোডটি রান করলে নিচের ফলাফল পাবেন:
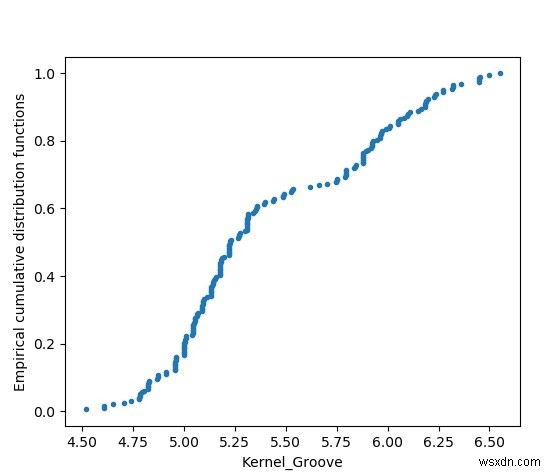
এমপিরিক্যাল কিউমুলেটিভ ডিস্ট্রিবিউশন ফাংশন (ECDF)
এই চার্টটি ডেটাসেটে কার্নেল গ্রুভ সাইজের ডিস্ট্রিবিউশন দেখায়। এটি কম থেকে বেশি মান অনুযায়ী সাজানো এবং ডিস্ট্রিবিউশন হিসেবে দেখানো হয়েছে।
উদাহরণ
import matplotlib.pyplot as plot
import numpy as np
from numpy import genfromtxt
seed_data = genfromtxt('E:\\seeds.csv', delimiter=',')
Kernel_groove = seed_data[:, 6]
def ECDF(seed_data): # Empirical cumulative distribution functions
    i = len(seed_data)
    m = np.sort(seed_data)
    n = np.arange(1, i + 1) / i
    return m, n
m, n = ECDF(Kernel_groove)
plot.plot(m, n, marker='.', linestyle='none')
plot.xlabel('Kernel_Groove')
plot.ylabel('Empirical cumulative distribution functions')
plot.show()
আউটপুট
উপরোক্ত কোডটি রান করলে নিচের ফলাফল পাবেন:
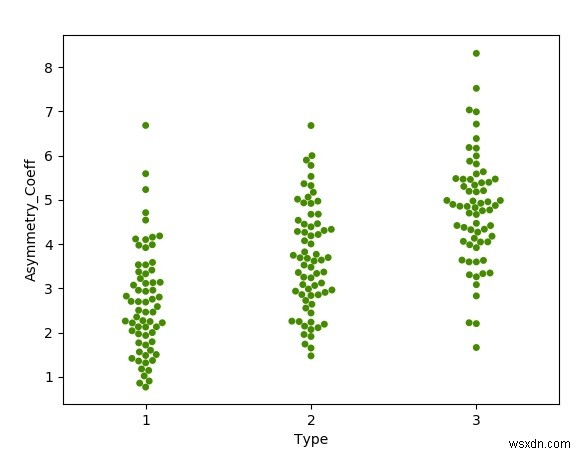
বি সওয়ার্ম প্লট (Bee Swarm Plot)
বি সওয়ার্ম প্লট ডেটা পয়েন্টের গোষ্ঠীর আকার দৃশ্যমানভাবে ক্লাস্টার করে প্রতিটি ইনডিভিজুয়াল ডেটা পয়েন্ট দেখায়। আমরা seaborn লাইব্রেরি ব্যবহার করে এই গ্রাফ বানাব। ডেটাসেট থেকে Type কলাম ব্যবহার করে একই টাইপের বীজগুলো একসাথে ক্লাস্টার করব।
উদাহরণ
import pandas as pd
import matplotlib.pyplot as plot
import seaborn as sns
datainput = pd.read_csv('E:\\seeds.csv')
sns.swarmplot(x='Type', y='Asymmetry.Coeff', data=datainput, color='#458B00')
plot.xlabel('Type')
plot.ylabel('Asymmetry_Coeff')
plot.show()
আউটপুট
উপরোক্ত কোডটি রান করলে নিচের ফলাফল পাবেন: