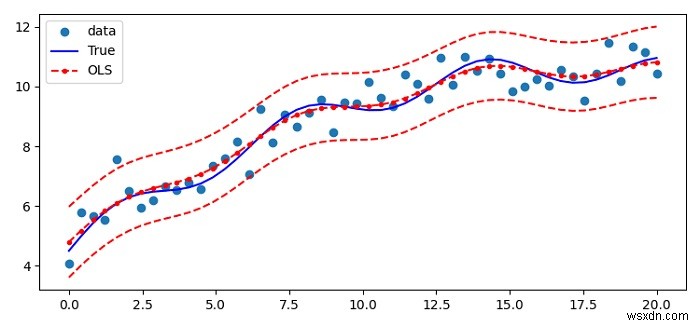
statsmodels লিনিয়ার রিগ্রেশন (OLS) একটি নন-লিনিয়ার কার্ভ ولی লিনিয়ার ডেটার সাথে প্লট করা যায়।
ধাপসমূহ
- ফিগার আকার সেট করুন এবং সাবপ্লটগুলির মধ্যে এবং চারপাশে প্যাডিং অ্যাডজাস্ট করুন।
- নতুন তৈরি করতে seed() মেথড ব্যবহার করুন।
- স্যাম্পলের সংখ্যা এবং সিগমা ভেরিয়েবল ইনিশিয়ালাইজ করুন।
- NumPy ব্যবহার করে লিনিয়ার ডেটা পয়েন্ট x, X, beta, t_true, y এবং res তৈরি করুন।
- Res একটি অর্ডিনারি লিস্ট স্কোয়ার ক্লাস ইনস্ট্যান্স।
- স্ট্যান্ডার্ড ডেভিয়েশন ক্যালকুলেট করুন। প্রেডিকশনের জন্য কনফিডেন্স ইন্টারভাল WLS এবং OLS-এ প্রয়োগ হয়, জেনারেল GLS-এ নয়।
- subplot() মেথড ব্যবহার করে একটি ফিগার এবং সাবপ্লটের সেট তৈরি করুন।
- plot() মেথড ব্যবহার করে সব কার্ভ প্লট করুন (x, y), (x, y_true), (x, res.fittedvalues), (x, iv_u) এবং (x, iv_l) ডেটা পয়েন্টসহ।
- প্লটে লেজেন্ড রাখুন।
- ফিগার প্রদর্শন করতে show() মেথড ব্যবহার করুন।
উদাহরণ
import numpy as np
from matplotlib import pyplot as plt
from statsmodels import api as sm
from statsmodels.sandbox.regression.predstd import wls_prediction_std
plt.rcParams["figure.figsize"] = [7.50, 3.50]
plt.rcParams["figure.autolayout"] = True
np.random.seed(9876789)
nsample = 50
sig = 0.5
x = np.linspace(0, 20, nsample)
X = np.column_stack((x, np.sin(x), (x - 5) ** 2, np.ones(nsample)))
beta = [0.5, 0.5, -0.02, 5.]
y_true = np.dot(X, beta)
y = y_true + sig * np.random.normal(size=nsample)
res = sm.OLS(y, X).fit()
prstd, iv_l, iv_u = wls_prediction_std(res)
fig, ax = plt.subplots()
ax.plot(x, y, 'o', label="data")
ax.plot(x, y_true, 'b-', label="True")
ax.plot(x, res.fittedvalues, 'r--.', label="OLS")
ax.plot(x, iv_u, 'r--')
ax.plot(x, iv_l, 'r--')
ax.legend(loc='best')
plt.show()
আউটপুট