

আমার এখনো সন্তান নেই, কিন্তু যখন হবে, আমি চাই তারা দুটি বিষয় শিখে:
- পার্সনাল ফাইন্যান্স (ব্যক্তিগত অর্থনীতি)
- মেশিন লার্নিং
আপনি সিঙ্গুলারিটি আসলো বলে বিশ্বাস করুন বা না করুন, অন্য তर्क দিতে পারবেন না যে বিশ্ব ডেটায় চলে। সেই ডেটা কীভাবে জ্ঞানে রূপান্তর হয় সেটি বুঝা আজকের যুবপिढ়ির জন্য অত্যন্ত গুরুত্বপূর্ণ — এবং ডেভেলপারদের জন্য তো আরও বেশি।
এটি একটি সিরিজের প্রথম আর্টিকেল যা ফুল-স্ট্যাক Ruby ডেভেলপারদের জন্য মেশিন লার্নিং (ML) সহজ করে তুলতে চেষ্টা করবে। আপনার হাতে কী ML টুল আছে সেটি বুঝলে আপনি আপনার স্টেকহোল্ডারদের ভালো ডিসিশন নেওয়ায় সাহায্য করতে পারবেন। ভবিষ্যতের আর্টিকেলগুলো নির্দিষ্ট টেকনিক এবং প্র্যাক্টিক্যাল উদাহরণে ফোকাস করবে, কিন্তু এখানে আমরা মঞ্চ সজাচ্ছি — আপনাকে একটি ম্যাপ দেখাচ্ছি যেখানে লিখা আছে "আপনি এখানে আছেন"।
বিনয়ী শুরু
কৃত্রিম বুদ্ধিমত্তা (AI) এবং মেশিন লার্নিং কিছু নতুন নয়। ১৯৫০之 দশকে আর্থার স্যামুয়েল একটি কম্পিউটার প্রোগ্রাম বানিয়েছিলেন যা চেকার্স খেলতে পারত। তিনি "আলফা-বিটা প্রুনিং" ব্যবহার করেছিলেন — একটি সাধারণ সার্চ অ্যালগরিদম।
১৯৬০之 দশকে মাল্টি-লেইয়ার্ড নিউরাল নেটওয়ার্ক এবং नियरेस्ट-নেইবর অ্যালগরিদম এসেছিল, যা গোদামে অপ্টিমাল পাথ খুঁজে বের করতে ব্যবহৃত হত।
তাহলে AI এত পুরনো হলে AI স্টার্টআপগুলো কেন এখন ট্রেন্ডি? আমার মতে এর দুটি কারণ:
- কম্পিউটিং পাওয়ার (মুরের নিয়ম দেখুন)
- প্রতিদিন ইন্টারনেটে যোগ হচ্ছে ডেটার পরিমাণ
প্রতিদিন সৃষ্টি হওয়া ডেটার পরিমাণ সংক্রান্ত দুটি স্ট্যাটিস্টিক আমাকে হেরান করে দেয়:
- ২০১৮ সালের itibরে আমরা প্রতিদিন ২.৫ কווিন্টিলিয়ন বাইট ডেটা উৎপাদন করছি। নিশ্চয়ই এই সংখ্যা Forbes আর্টিকেল পাবলিশ হওয়ার পর থেকে আরো বেড়েছে।
- গত দুই বছরে বিশ্বের ৯০% ডেটা তৈরি হয়েছে।
এই দুটো মিলে মানে: (১) ডেটা স্টোর এবং অ্যালগরিদম চালানোর হার্ডওয়ার দিন দিন সস্তা হচ্ছে এবং (২) ML মডেল ট্রেন করার জন্য উপলব্ধ ডেটার পরিমাণ অদ্ভুত গতিতে বেড়ছে।
প্রতিদিন আমরা কৃত্রিম বুদ্ধিমত্তা এবং মেশিন লার্নিং-এর সাথে ইন্টারঅ্যাক্ট করছি, তার 의해 প্রভাবিত হচ্ছি, এবং সেটিতে অবদান রেখে যাচ্ছি। উদাহরণস্বরূপ, আপনি অ্যালগরিদমকে ধন্যবাদ (দোষ) দিতে পারেন এই জিনিসগুলোর জন্য:
- আপনার ক্রেডিট লিমিট
- রোগ নির্ণয়ে সাহায্য
- হয়তো আপনি চাকরি পেয়েছেন কিনা সেটাও
- বর্তমান ট্রাফিক কন্ডিশনে সবচেয়ে দক্ষ রুট খুঁজে বের করা
- Alexa বুঝতে পারছে আপনি কী বললেন যখন আপনি বললেন আপনি হাচ্ছু করেছেন
- Spotify আপনাকে আপনার নতুন প্রিয় গান দিয়ে পরিচয় করাচ্ছে
আমি আমার কাল্পনিক ভবিষ্যতের সন্তানদের কথা এই জন্য তুলে ধরলাম: আমি চাই তারা বুঝে যে তাদের ডিজিটাল জীবন কীভাবে তাদের "বাস্তব" জীবনকে প্রভাবিত করে, তাদের ডেটা প্রাইভেসি ডিসিশনের ইমপ্লিকেশন, এবং কীভাবে তারা নিজের মতামত তৈরি করবে যে মেশিনে কখন আস্থা রাখবেন আর কখন রাখবেন না।
এই পোস্টের বাকি অংশে আমি তিনটি মেশিন লার্নিং টাইপের ওভারভিউ দিতে চাই যা আমি পড়েছি: সুপারভাইজড লার্নিং, আনসুপারভাইজড লার্নিং, এবং রিইনফোর্সমেন্ট লার্নিং। আমরা আলোচনা করব প্রতিটি অ্যাপ্রোচের يونিকনেস এবং কোন সমস্যা সমাধানে কোনটি বিশেষভাবে কার্যকর।
সুপারভাইজড লার্নিং
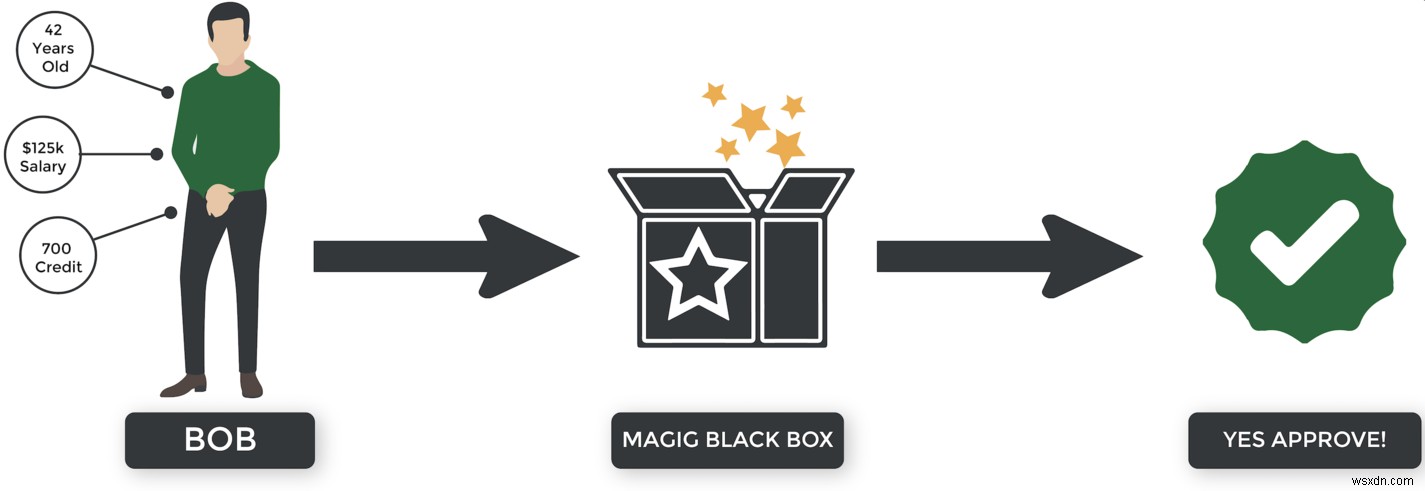
সুপারভাইজড লার্নিং হচ্ছে... যেটি মানুষ দ্বারা সুপারভাইজড। :) কল্পনা করুন আমরা একটি সুপারভাইজড লার্নিং সিস্টেম বানাচ্ছি যা সিদ্ধান্ত নেবে কে মার্গেজ পাবে। এটি কীভাবে কাজ করতে পারে:
- ব্যাঙ্ক একটি ডেটাসেট কম্পাইল করে যা কাস্টমার অ্যাট্রিবিউট (বয়স, স্যালারি ইত্যাদি) কে আউটকাম (রিপেমেন্ট, ডিফল্ট ইত্যাদি) এর সাথে ম্যাপ করে।
- আমরা ডেটা দিয়ে সিস্টেমকে ট্রেন করি।
- সিস্টেম যা শিখল সেটি ব্যবহার করে একটি আবেদনকারীর অ্যাট্রিবিউটের ভিত্তিতে ভবিষ্যৎ আউটকাম অনুমান করে।
- যদি অ্যালগরিদম সঠিক অনুমান করে, আমরা বলি, "শাবাশ! তুমি ঠিক আছ।" আর যদি ভুল হয়, তবে বলি, "না, তুমি ভুল করছ। উন্নতি করো এবং আবার চেষ্টা করো।"
এই উদাহরণটি একটি ক্লাসিফিকেশন সমস্যা কারণ অ্যালগরিদমের আউটপুট একটি ক্যাটাগরি — এই কেসে, অনুমোদিত বা অনুমোদিত নয়। অন্যান্য ক্লাসিফিকেশন সমস্যার উদাহরণ:
- একজন ব্যক্তি কি রোগগ্রস্ত
- একটি এক্স-রেতে কি ভাঙা হাড্ডি আছে
- একটি ইমেইল কি স্প্যাম
আপনি যদি ML ক্লাসিফিকেশন অ্যালগরিদমের ম্যাথ সম্পর্কে জানতে চান, তবে গুগল করুন: naive Bayes classifiers, support vector machines, logistic regression, neural networks, random forests।
ক্লাসিফিকেশন সমস্যা (যেসব "হ্যাঁ/না" আউটপুট দেয়) ছাড়াও সুপারভাইজড লার্নিং রিগ্রেশন সমস্যাও সমাধান করতে পারে — এখানে আমরা একটি কন্টিনিউয়াস স্কেলে প্রিডিকশন করি, উদাহরণস্বরূপ:
- স্টকের ভবিষ্যতের মান
- New England Patriots সুপার বাউল জিতবে সেটির প্রোবাবিলিটি
- এক কোম্পানি ক্যান্ডিডেটকে প্রস্তাব করার জন্য গড় স্যালারি কত দরকার যাতে সে জয়েন করবে
সুপারভাইজড রিগ্রেশন সমস্যার জন্য ব্যবহৃত অ্যালগরিদমের উদাহরণ: লিনিয়ার রিগ্রেশন, নন-লিনিয়ার রিগ্রেশন, এবং বেজিয়ান লিনিয়ার রিগ্রেশন।
আনসুপারভাইজড লার্নিং
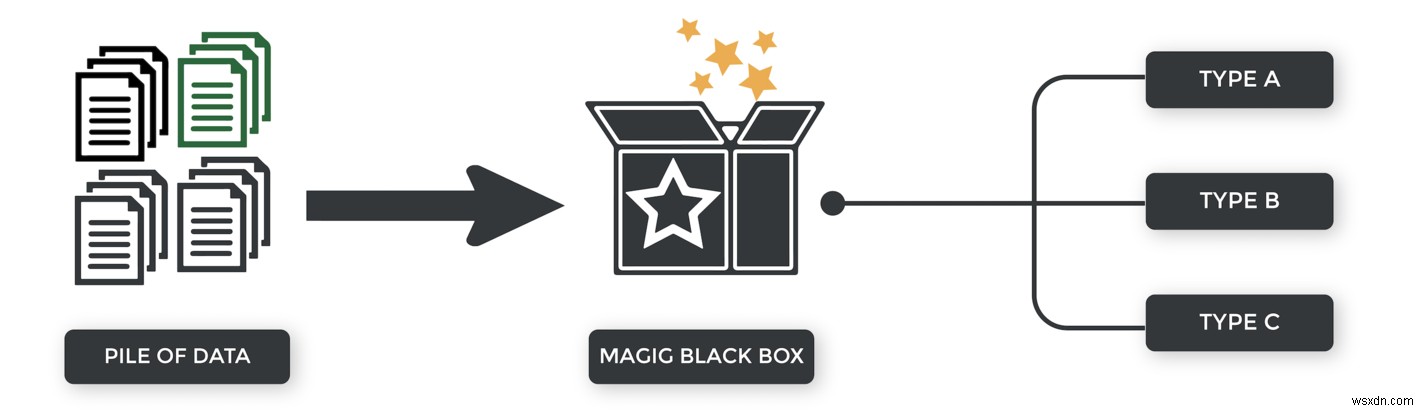
সুপারভাইজড লার্নিং-এ আমরা পূর্বনির্ধারিত ক্লাসিফিকেশন ক্যাটাগরি দিয়ে দিয়েছিলাম। মার্গেজ আবেদনকারী বা অনুমোদিত হতো বা ডেনাইড।
আনসুপারভাইজড লার্নিং-এ আমরা ক্যাটাগরি দিয়ে দি না। সেগুলো আমাদের কাছে থাকে না। অ্যালগরিদমই নিজে নিজের কনক্লাজন বের করতে হবে।
আমরা আনসুপারভাইজড অ্যাপ্রোচ কেন ব্যবহার করব?
১) কখনো কখনো আমরা আগে থেকে ক্যাটাগরি না জানি। ইন্টারনেটে ঘুরে বেড়ানো ডেটার অধিকাংশ আনস্ট্রাকচারড — অর্থাৎ লেবেল থাকে না।
২) অন্য সময় আমরা জানি না আমরা কী খুঁজছি, তাই অ্যালগরিদমকে বলতে পারি প্যাটার্ন/ফিচার খুঁজে বের করতে যা ক্যাটাগরাইজেশনে কাজে লাগবে।
আনস্ট্রাকচারড ডেটা ML-এ হ্যান্ডল করার আরেকটি পদ্ধতি হলো মানুষকে সেটি দেখিয়ে ম্যানুয়ালি লেবেল করানো। অনেক কোম্পানি ওয়ার্কার নিয়োগ করে ডেটা ম্যানুয়ালি ক্লাসিফাই করায়: লেবেলিং ডেটা।
আনসুপারভাইজড লার্নিং-এর অ্যাপ্রোচগুলো
আনসুপারভাইজড লার্নিং-এ دوটি সাধারণ টেকনিক হলো অ্যাসোসিয়েশন (association) এবং ক্লাস্টারিং (clustering)।
অ্যাসোসিয়েশন: কল্পনা করুন আপনি Amazon। আপনার पास হজার হাজার কাস্টমার ডেটা, পারচেজ হিস্টরি আছে। আনসুপারভাইজড লার্নিং ব্যবহার করে আপনি কাস্টমারদের "শপারের টাইপ" এ পার্টিশন করতে পারেন — হয়তো বের করতে পারেন যে যারা গুলাবি ছাতা কিনে তারা.Matcha চা কিনার সম্ভাবনা বেশি।
ক্লাস্টারিং: ক্লাস্টারিং আপনার ডেটা দেখে সেটিকে নির্দিষ্ট সংখ্যক গ্রুপ বা ক্লাস্টারে ভাগ করে। উদাহরণস্বরূপ, হয়তো আপনার কাছে হাউজিং ডেটা আছে এবং আপনি চান দেখতে কোন ফিচার (হয়তো ক্রাইম ডেটা?) কি কোন neighbouhood-এ বাড়ি আছে সেটি প্রিডিক্ট করতে পারে। অথবা cosine similarity-এর মতো টেকনিক টেক্সট ক্লাসিফিকেশনে ব্যবহার করা যায় (যেমন: এই আর্টিকেল টেনিস, কুকিং, নাকি স্পেস সম্পর্কে?)।
নির্দিষ্ট আনসুপারভাইজড লার্নিং টেকনিক জানতে গুগল সার্চ করুন: k-means clustering, cosine similarity, hierarchical clustering, k-nearest-neighbor clustering।
রিইনফোর্সমেন্ট লার্নিং
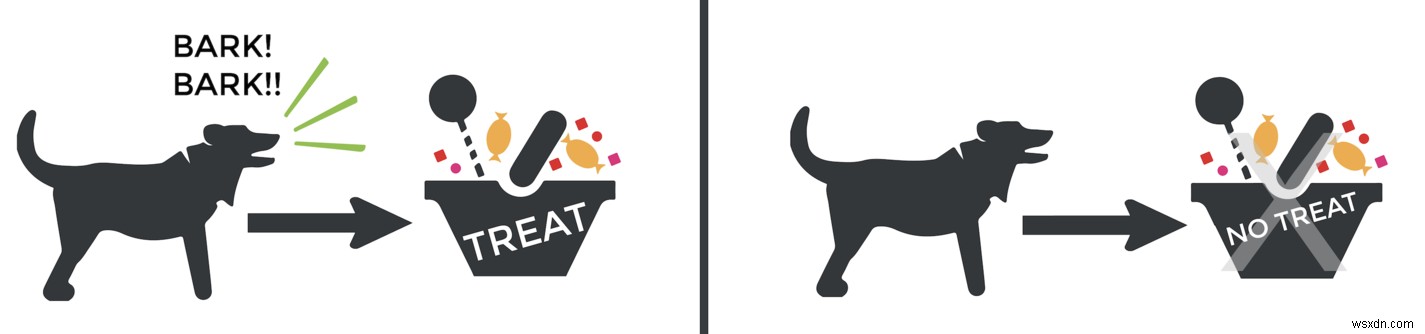
মেশিন লার্নিং-এর এই সাবসেটটি গেমে খুব বেশি ব্যবহৃত হয় কারণ এটি গোল-ওরিয়েন্টেড অ্যালগরিদম ব্যবহার করে। সুপারভাইজড লার্নিং-এর বিপরীতে, এখানে প্রতিটি ডিসিশন স্বাধীন নয় — একটি করেন্ট ইনপুট দেওয়ায়, অ্যালগরিদম একটি ডিসিশন নেয় এবং পরবর্তী ইনপুট এই ডিসিশনের উপর নির্ভর করে।
যেমন আমি আমার কুকুরকে ডোরবেল বাজলে ভেঙে বাজতে না পারলে মাথায় হাত ফেরাই দি, আর বন্ধ না করলে কেনেলে পাঠাই, ঠিক उसीভাবে রিইনফোর্সমেন্ট অ্যালগরিদমকে গোল-অপ্টিমাইজিং ডিসিশন নেয়ায় (যেমন সর্বোচ্চ পয়েন্ট স্কোর করা) পুরস্কৃত করা হয় এবং খারাপ ডিসিশনে পেনাল্টি।
রিইনফোর্সমেন্ট লার্নিং অ্যালগরिदমের স্পষ্ট অ্যাপ্লিকেশনগুলো:
- চেস এবং Go-এর মতো গেম (Netflix-এ AlphaGo ডকুমেন্টারি দেখেন না থাকলে খুব সুপারিশ করছি।)
- রোবোটিক্স (বটকে ডিজায়ারড টাস্ক কমপ্লিট করা শেখানো)
- অটোনোমাস ভহিকেল
- রোবো-অ্যাডভাইজার যাদের ট্রেন করা হয় স্টক মার্কেট জিততে
রিইনফোর্সমেন্ট লার্নিং-এর পেছনের অ্যালগরিদম জানতে গুগল সার্চ করুন: Q-learning, state-action-reward-state-action (SARSA), DQN, asynchronous advantage actor critic।
উপসংহার
আশা করি এই উদাহরণগুলো আপনাকে মেশিন লার্নিং টেকনিক এবং প্রতিটির ব্যবহার কীভাবে আজকের এই পাগল dünyাকে প্রভাবিত করছে সেটি বুঝতে সাহায্য করেছে। আমি কখনো কখনো শিখতে থাকা অপরিমিত জ্ঞান থেকে অভিভূত হই, কিন্তু কোথাও থেকে শুরু করা কিছুই না করার চেয়ে ভালো, এবং মনে রাখবেন যে এখান원의 অনেক কিছু আসলে নতুন নয় — আমরা শুধু বেশি শুনছি কারণ ডেটা বেশি উপলব্ধ হয়েছে এবং প্রসেসিং পাওয়ার সস্তা হয়েছে।
