

রিডিস SQL কোয়েরি চালানো কঠিন হতে হবে না। আমি আসলে এই পয়েন্টটি কয়েক বছর আগে উত্থাপন করেছিলাম একটি বন্ধুকে বল하면서 যিনি একটি রিটেল কোম্পানিতে ডেটা ওয়ারহাউজিং সমাধান ম্যানেজ করেন। আমরা রিডিস কোয়েরি নিয়ে কথা বলতে শুরু করলাম একবার তিনি একটা সমস্যা ব্যাখ্যা করলেন।
"আমাদের ডেটা ওয়ারহাউজিং সমাধানগুলির সাথে একটি পেন পয়েন্ট আছে। আমাদের কিছু ইউজ কেস আছে যেখানে আমাদের ডেটা রেকর্ড করতে হবে এবং রিয়েল-টাইমে অ্যানালিটিক্যাল অপারেশন করতে হবে। তবে কখনো কখনো রেজাল্ট পেতে মিনিটগুলোর সময় লাগে। কি রিডিস এখানে সাহায্য করতে পারে? মনে রাখবেন যে আমরা আমাদের SQL-ভিত্তিক সমাধান একসাথে রিপ্লেস করতে পারি না। আমরা একবারে শুধু বেবি স্টেপ নিতে পারি।"
এখন, যদি আপনি আমার বন্ধুর মত একই পরিস্থিতিতে হন, তাহলে আমাদের আপনার জন্য ভালো খবর আছে। আপনার বর্তমান SQL-ভিত্তিক সমাধানকে বাধা दिए বিনা রিডিস কোয়েরি চালানোর এবং আপনার আর্কিটেকচারে রিডিস পরিচয় করানোর অনেক উপায় রয়েছে।
চলুন অন্বেষণ করি কীভাবে আপনি এটি করতে পারেন। কিন্তু তার আগে, আমাদের একটি রিডিস হ্যাকাথন প্রতিযোগী তার নিজস্ব অ্যাপ তৈরি করেছেন যা আপনাকে SQL দিয়ে রিডিসে ডেটা কোয়েরি করতে দেয়।
নিচের ভিডিওটি দেখুন।
আপনার টেবিলগুলো রিডিস ডেটা স্ট্রাকচার হিসেবে রিমডেল করুন
আপনার টেবিলকে রিডিস ডেটা স্ট্রাকচারে ম্যাপ করা বেশ সাদা। সবচেয়ে উপযোগী ডেটা স্ট্রাকচারগুলো হলো:
- Hash
- Sorted Set
- Set
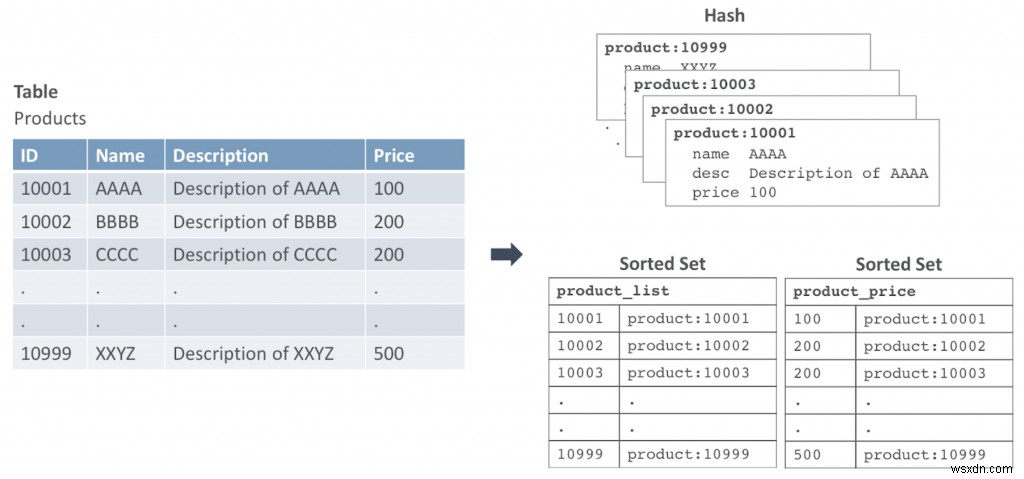
এটি করার একটি উপায় হচ্ছে প্রতিটি সারি একটি Hash হিসেবে সংরক্ষণ করা যার কী টেবিলের প্রাইমারি কী ভিত্তিক হবে এবং কীটি একটি Set বা Sorted Set-এ সংরক্ষণ করা।
ফিগার ১ দেখায় কীভাবে একটি টেবিলকে রিডিস ডেটা স্ট্রাকচারে ম্যাপ করা যায় এই উদাহরণে, আমাদের Products নামে একটি টেবিল আছে। প্রতিটি সারি একটি Hash ডেটা স্ট্রাকচারে ম্যাপ করা হয়েছে।
প্রাইমারি আইডি ১০০০১ olan সারিটি একটি Hash-এ যাবে যার কী: product:10001। এই উদাহরণে দুটি Sorted Set আছে: প্রথমটি প্রাইমারি কী দ্বারা ডেটাসেটের মাধ্যমে ইটারেট করার জন্য এবং দ্বিতীয়টি প্রাইস অনুযায়ী কোয়েরি করার জন্য।
এই অপশনে, আপনাকে আপনার কোড পরিবর্তন করতে হবে রিডিস কোয়েরি ব্যবহার করার জন্য SQL কমান্ডের পরিবর্তে। নিচে SQL এবং রিডিস সমতুল্য কমান্ডের কিছু উদাহরণ দেওয়া হলো:
A. ডেটা ইনসার্ট করা
SQL: insert into Products (id, name, description, price) values = (10200, "ZXYW","Description for ZXYW", 300);
Redis: MULTI HMSET product:10200 name ZXYW desc "Description for ZXYW" price 300 ZADD product_list 10200 product:10200 ZADD product_price 300 product:10200 EXEC
B. প্রোডাক্ট আইডি দ্বারা কোয়েরি
SQL: select * from Products where id = 10200
Redis: HGETALL product:10200
C. প্রাইস দ্বারা কোয়েরি
SQL: select * from Product where price < 300
Redis: ZRANGEBYSCORE product_price 0 300
এটি কীগুলো রিটার্ন করে: product:10001, product:10002, product:10003। এখন প্রতিটি কী জন্য HGETALL চালান।
HGETALL product:10001 HGETALL product:10002 HGETALL product:10003
DataFrames ব্যবহার করে স্বয়ংক্রিয়ভাবে আপনার টেবিলগুলিকে রিডিস ডেটা স্ট্রাকচারে ম্যাপ করুন
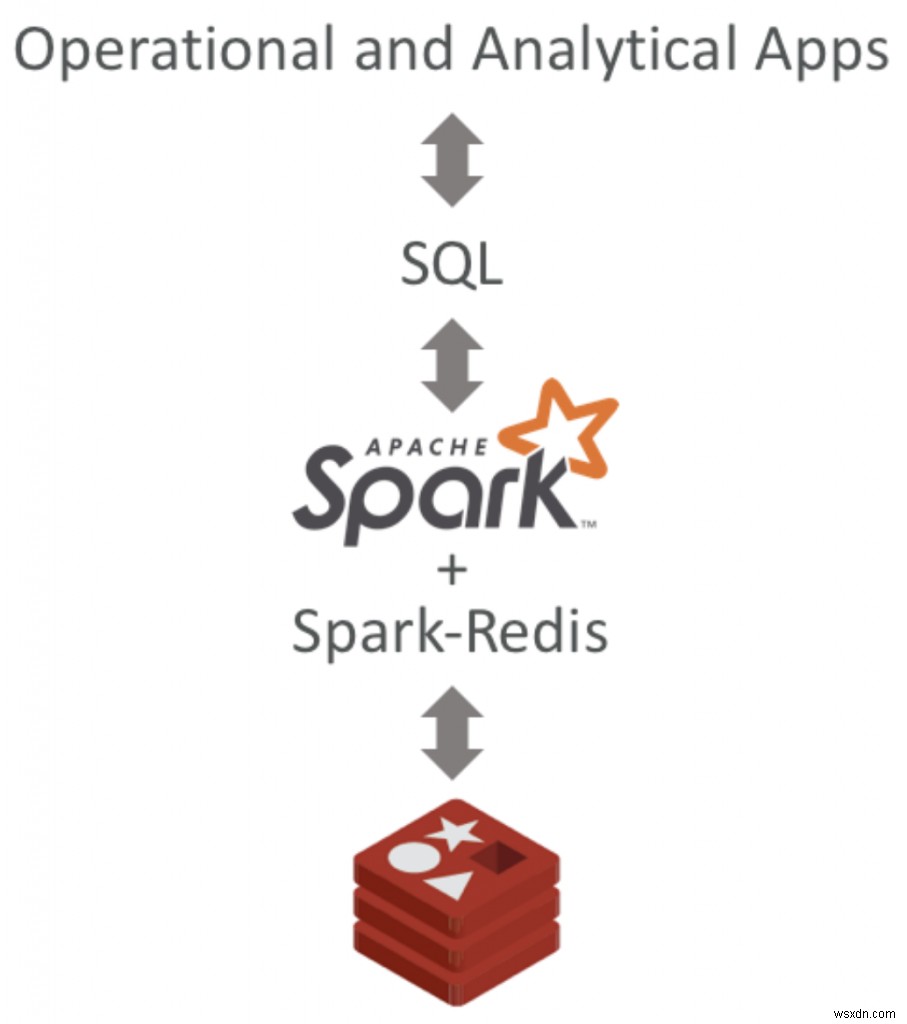
এখন, আপনি যদি আপনার সমাধানে SQL ইন্টারফেস মেনটেইন করতে চান এবং কেবল আন্ডারলাইং ডেটা স্টোরকে রিডিসে পরিবর্তন করতে চান স্পিড বাড়াতে, তবে আপনি Apache Spark এবং Spark-Redis লাইব্রেরি ব্যবহার করে তা করতে পারেন।
Spark-Redis লাইব্রেরি আপনাকে DataFrame APIs ব্যবহার করে রিডিস ডেটা সংরক্ষণ এবং অ্যাক্সেস করতে দেয়। অন্য কথায়, আপনি SQL কমান্ড ব্যবহার করে ডেটা ইনসার্ট, আপডেট এবং কোয়েরি করতে পারেন, কিন্তু ডেটা অভ্যন্তরীণভাবে রিডিস ডেটা স্ট্রাকচারে ম্যাপ করা থাকে।
প্রথমে, আপনাকে spark-redis ডাউনলোড করতে হবে এবং লাইব্রেরি বিল্ড করে jar ফাইল পেতে হবে। উদাহরণস্বরূপ, spark-redis 2.3.1-এর সাথে, আপনি spark-redis-2.3.1-SNAPSHOT-jar-with-dependencies.jar পাবেন।
তারপর আপনাকে নিশ্চিত করতে হবে যে আপনার রিডিস ইনস্ট্যান্স চলছে। আমাদের উদাহরণে, আমরা লোকালহোস্টে ডিফল্ট পোর্ট ৬৩৭৯-এ রিডিস চালাব।
আপনি Apache Spark ইঞ্জিনেও আপনার কোয়েরি চালাতে পারেন। এখানে কীভাবে করা যায় তার একটি উদাহরণ:
$ spark-shell --jars spark-redis-2.3.1-SNAPSHOT-jar-with-dependencies.jar
scala> import org.apache.spark.sql.SparkSession scala> val spark = SparkSession .builder() .appName("redis-sql") .master("local[*]") .config("spark.redis.host","localhost") .config("spark.redis.port","6379").getOrCreate() scala> import spark.sql scala> import spark.implicits._ scala> sql("create table if not exists products(id string, name string, description string, price int) using org.apache.spark.sql.redis options (table 'product')") scala> sql("insert into products values = ('10200','ZXYW','Description of ZXYW', 300)") scala> val results = sql("select * from products") scala> results.show() +-----+----+-------------------+-----+ | id|name| description|price| +-----+----+-------------------+-----+ |10200|ZXYW|Description of ZXYW| 300| +-----+----+-------------------+-----+ এখন আপনি আপনার রিডিস ক্লায়েন্টও ব্যবহার করে এই ডেটাটি রিডিস ডেটা স্ট্রাকচার হিসেবে অ্যাক্সেস করতে পারেন:
127.0.0.1:6379> keys product* 1) "product:2e3f8611dbe94a588706a2aaea547caa"
একটি আরও কার্যকর পদ্ধতি হবে scan কমান্ড ব্যবহার করা কারণ এটি আপনাকে ডেটার মাধ্যমে নেভিগেট করার সময় পেজিনেট করতে দেয়।
127.0.0.1:6379> scan 0 match product* 1) "3" 2) 1) "product:2e3f8611dbe94a588706a2aaea547caa" 127.0.0.1:6379> hgetall product:2e3f8611dbe94a588706a2aaea547caa 1) "name" 2) "ZXYW" 3) "price" 4) "300" 5) "description" 6) "Description of ZXYW" 7) "id" 8) "10200"
এবাEledu - দুটি সহজ উপায় जिससे আপনি ডিসরাপশন ছাড়া রিডিস SQL কোয়েরি चला सकते हैं। এক ধাপ جلو যেতে চাইলে, আপনি জানতে পারেন Why Your SQL Server Needs Redis আমাদের নতুন হোয়াইটপেপারে।
কिंतु রিডিসের সাথে রিয়েল-টাইম ডেটা সম্পর্কে, এটি 그중 এক মাত্র উপায় নয় যা আপনি রিয়েল-টাইম অভিজ্ঞতা প্রদানের জন্য ব্যবহার করতে পারেন।
আপনি যদি জানতে চান কীভাবে রিডিস আপনাকে রিয়েল-টাইম ডেটা ট্রান্সমিশন গ্যারান্টি দিতে পারে, তবে আমাদের সাথে যোগাযোগ করতে ভুলবেন না।
