

অ্যাপল последरों vài মাস ধরে বাগ-ভরা সমস্যার সম্মুখীন হচ্ছে। এখন আইফোনের টেক্সট-রেন্ডারিং ফাংশনালিটিতে একটি নতুন, গুরুতর বাগ খুঁজে পাওয়া গেছে। এই বাগ একটি একক తెలుగు ক্যারেক্টার দ্বারা ট্রিগার হয়, যা শুধু সেই ক্যারেক্টার ধারণকারী একটি নোটিফিকেশন পাওয়ায় একটি আইফোনকে অটুট বুট লুপে প্রবেশ করাতে পারে। চলুন+iOS-এ একটি একক ক্যারেক্টার কীভাবে এত বড় সমস্যা সৃষ্টি করতে পারে তা অন্বেষণ করি।
দ্রষ্টব্য: తెలుగు বাগের ফিক্স সাম্প্রতিক iOS সংস্করণ (১১.২.৬) তে উপলব্ধ। যদি తెలుగు ক্যারেক্টার আপনার অ্যাপ বা ডিভাইস লক করে দেয়, তবে আইটিউনসের মাধ্যমে আইফোন রিস্টোর করুন এবং সাম্প্রতিক iOS সংস্করণে আপডেট করুন। যদি আইফোন বুট লুপে আটকে যায়, তবে আইটিউনসের ডিভাইস সনাক্ত করতে ডিভাইস ফার্মওয়্যার আপডেট (DFU) স্টেটে রাখতে হতে পারে। শেষে, আপনার ডিভাইসটি সাম্প্রতিক ব্যাকআপ থেকে রিস্টোর করুন, যা আপনি সৃষ্টি করেছেন বলে আশা করি।
తెలుగు কী?
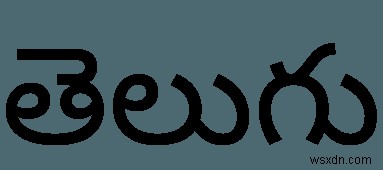
తెలుగు భారతের কিছু রাজ্যে বোলা ও লেখা একটি ভাষা, বিশেষত আంధ্র প্রদেশ, তেলঙ্গানা এবং যানাম শহরে। আরবি এবং অন্যান্য ব্রাহ্মি লিপির মতো অনেক লিপি-ভিত্তিক ভাষার মতই, తెలుగు কম্পিউটার স্ক্রিনে আপনার ক্যারেক্টারগুলো প্রদর্শন করতে ইউনিকোড ক্যারেক্টার সেটের কিছু বিশেষ বৈশিষ্ট্য ব্যবহার করে।
অনেক ল্যাটিন অক্ষর ASCII কম্প্যাটিবিলিটির জন্য একক ৮-বিট ইউনিকোড কোড পয়েন্ট দ্বারা প্রতিনিধিত্ব করা হয় (উদাহরণস্বরূপ, A অক্ষরটি ইউনিকোড কোড পয়েন্ট U+0041-এ অবস্থিত, যা বাইনারি দ্বারা 01000001 আকারে প্রতিনিধিত্ব করা হয়), লিপি বা নন-ল্যাটিন অক্ষরগুলিতে লেখা ভাষাগুলি সাধারণত তাদের ক্যারেক্টারগুলিকে উপস্থাপন করতে একাধিক ইউনিকোড কোড পয়েন্ট সংমিশ্রণ করে।
এটি বিশেষভাবে لتلك ভাষাগুলির জন্য সত্য যেগুলি তাদের অক্ষরগুলিকে ক্লাস্টার-এ সংমিশ্রণ করে, যেমন తెలుగు। ইংরেজির স্টাইলিস্টিক লিগেচারের বিপরীতে, প্রতিটি తెలుగు অক্ষরের মধ্যে সংযোগ ভাষাবিজ্ঞানগতভাবে গুরুত্বপূর্ণ। এটি সামঞ্জস্য করার জন্য, ইউনিকোড প্রতিটি কোড পয়েন্ট দ্বারা প্রতিনিধিত্ব করা সংযুক্ত ক্যারেক্টারগুলোর একটি জটিল সিস্টেম অন্তর্ভুক্ত করে।
ইউনিকোড কোড পয়েন্টের বিশাল সংখ্যা বিবেচনা করলে, এটি लगभग অনন্ত ধরনের সংমিশ্রণ সৃষ্টি করতে পারে। এই পয়েন্টগুলো একসাথে মিলে একটি পঠনযোগ্য ক্যারেক্টার রেন্ডার করে। এইভাবে ইউনিকোডকে букваলি প্রতিটি সম্ভাব্য తెలుగు শব্দের জন্য ইউনিকোড কোড পয়েন্টের প্রয়োজন নেই। বরং, ইউনিকোড తెలుగు ব্যঞ্জনবর্ণ, স্বরবর্ণ এবং ডায়াক্রিটিক্স (“বিরাম”) একসাথে সংমিশ্রণ করে শব্দ তৈরি করে যা একটি একক ক্যারেক্টারのように প্রদর্শিত হয়। একই বিষয় লিগেচার জন্য অর্থোগ্রাফিক নিয়মવાળি অন্যান্য ভাষার জন্যও প্রযোজ্য, যেমন আরবি।
ক্র্যাশের কারণ কী?
সমস্যাটি কোড পয়েন্ট U+200C-এ জিরো উইডথ নন-জয়েনার (ZWNJ)-এর সাথে সম্পর্কিত বলে মনে হচ্ছে। ZWNJ অনুরোধ করে যে দুটি সন্নিহিত ক্যারেক্টার তাদের সাধারণ লিগেচার ছাড়া রেন্ডার হোক। ইংরেজিতে, ZWNJ ক্যারেক্টার ff কে তাদের স্ট্যান্ডার্ড সংযোগ লিগেচারের সাথে প্রিন্ট হতে বাধা দিয়ে প্রতিটি f কে পৃথক করে। কিন্তু যখন চারটি নির্দিষ্ট తెలుగు কোড পয়েন্টের একটি নির্দিষ্ট সেটের সাথে সংমিশ্রিত হয় (যেগুলি সব একসাথে একক একটি ক্লাস্টার তৈরি করতে পারে), তখন কाही 모르는 কারণে iOS ফলাফলটি সঠিকভাবে প্রদর্শন করতে পারে না।
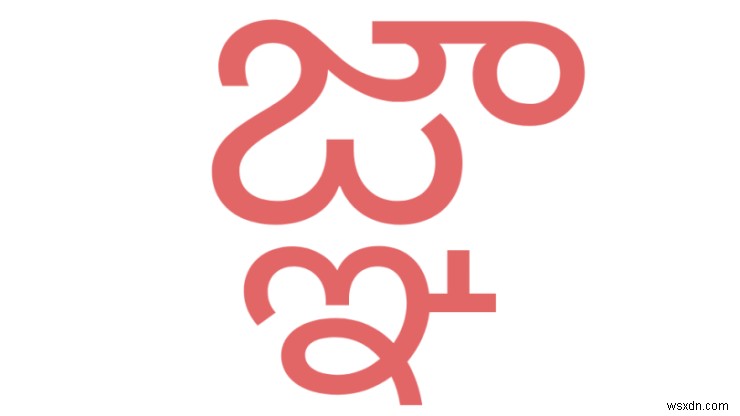
কিছু লোক অনুমান করেছেন যে অ্যাপলের সান ফ্রান্সিস্কো ফন্ট ক্যারেক্টারটি প্রদর্শন করতে পারে না, অন্যদের মতে অ্যাপল যে নির্দিষ্ট রেন্ডারিং প্রসেস ব্যবহার করে সেটিই দোষী। যাইহোক সঠিক কারণ, ক্যারেক্টারটি রেন্ডার করার চেষ্টা এটি রেন্ডার করছেন যাইহোক থেকে একটি నাটকীয় ক্র্যাশ সৃষ্টি করে, যেমন মেসেজেস এবং হুয়াটসঅ্যাপ থেকে স্প্রিংবোর্ড পর্যন্ত। ক্যারেক্টারটি গঠনকারী ইউনিকোড কোড পয়েন্টগুলো (“গ্যা” অর্থ “জ্ঞান”) নিচে দেওয়া হলো:
U+0C1Cja ( )
U+0C4Dএকটি বিরাম, বা ডায়াক্রিটিক চিহ্ন ( )
U+0C1Enya ( )
U+200Cজিরো উইডথ নন-জয়েনারU+0C3Eaa ( )
কিন্তু আমরা শুধু জিরো উইডথ নন-জয়েনার (ZWNJ)-কে দোষী ঠহরায় পারি না। এটি নির্জিব পারিবারিক ইমোজি (????) তেও কোনো সমস্যা ছাড়া ব্যবহৃত হয়। এটি নির্দিষ্ট কিছু কোড পয়েন্ট এবং ZWNJ-এর একটি নির্দিষ্ট সংমিশ্রণের কারণে হয় বলে মনে হচ্ছে। কষ্টের কথা হল, ZWNJ বা এই తెలుగు ক্লাস্টারের রেন্ডারিং-এ কোনো বিশেষ প্রভাব ফেলে না অথবা সেটি সেখানে থাকা উচিত ছিল না।
অন্যান্য ব্রাহ্মি লিপি সমস্যা
তెలুগুর পাশাপাশি অন্যান্য ভাষাগুলোও এই সমস্যায় ভুগছে। বাঙালি এবং দেবনাগরী, যেগুলি তাদের ব্রাহ্মি লিপির জন্য ইউনিকোডকে অনুরূপভাবে ব্যবহার করে, একই সমস্যাটি রয়েছে। মনীশ গোরেগাওকর একটি আকর্ষণীয় এবং বিস্তারিত ব্লগ পোস্ট লিখেছেন যা ক্র্যাশ কেসটি আরও ভাঙন করে:
দেবনাগরী, বাঙালি, এবং తెలুগুতে
<consonant1, virama, consonant2, ZWNJ, vowel>যেকোনো ক্রম, যেখানে:1.
consonant2হলো সুফিক্স-জয়েনিং (pstf/vatu)
2.consonant1হলো রেফ-ফর্মিং অক্ষর নয়
3.vowelএর দুটি গ্লাইফ কম্পোনেন্ট নেই
উপসংহার: অ্যাপল এটি কেন ধরতে পারলো না?
এই বাগ কীভাবে উপেক্ষা হয়েছে তা বুঝতে হলে আপনাকে অ্যাপলের জুতায় পা রাখতে হবে। নিশ্চিত, এই ক্যারেক্টার সংমিশ্রণ 텔ুগু ভাষার কোনো অত্যন্ত অস্বাভাবিক শব্দ নয়। কিন্তু আইফোন দर्जনাবধি ভাষা সাপোর্ট করে। ইউনিকোডে বিলিয়ন বিলিয়ন সম্ভাব্য সংমিশ্রণ রয়েছে। এত বৈচিত্র্যের মধ্যে একটি রিলিজের আগে ইউনিকোড বাগের জন্য অর্থবহ টেস্টিং করলে রেগুলার সফটওয়্যার আপডেট اساسেই অসম্ভব হয়ে যাবে।
তবে, এই ত্রুটি এতটাই ক্ষতি করতে উচিত ছিল না। একটি টেক্সট মেসেজের কন্টেন্টের ভিত্তিতে ফোন ব্রিক হয়ে যাবেনা। পশ্চাদ্দৃষ্টি নিশ্চয়ই ২০/২০, কিন্তু ক্যারেক্টারটি একটি প্রশ্ন চিহ্ন বক্স () হিসেবে রেন্ডার করা স্প্রিংবোর্ড ক্র্যাশ করার চেয়ে ভালো হতো।
