

সঠিকই বলা হয়েছে আজকের বিশ্বে ডেটা অর্থ পইসা। অ্যাপ-ভিত্তিক বিশ্বে ট্রানজিশনের সাথে সাথে ডেটার এক্সপোনেনশিয়াল বৃদ্ধি এসেছে। যাই হোক, অধিকাংশ ডেটা আনস্ট্রাকচারড এবং তাই উপযোগী ইনফরমেশন ডেটা থেকে বের করে বোঝারযোগ্য এবং ব্যবহারযোগ্য রূপে রূপান্তর করার জন্য একটি প্রক্রিয়া এবং মেথড লাগে।
ডেটা মাইনিং বা "Knowledge Discovery in Databases" হলো বড় ডেটা সেটে প্যাটার্ন আবিষ্কার করার প্রক্রিয়া আর্টিফিশিয়াল ইন্টেলিজেন্স, মেশিন লার্নিং, স্ট্যাটিস্টিক্স, এবং ডেটাবেস সিস্টেমের মাধ্যমে।
ফ্রি ডেটা মাইনিং টুলস রেঞ্জ করে Knime এবং Orange-এর মতো সম্পূর্ণ মডেল ডেভেলপমেন্ট এনভায়রনমেন্ট থেকে, Java, C++ এবং অধিকাংশ সময় Python-এ লেখা লাইব্রেরির রূপांतর। সাধারণত ডেটা মাইনিং-এ চার ধরনের টাস্ক জড়িত থাকে:
- Classification: পরিচিত স্ট্রাকচার জেনারালাইজ করে নতুন ডেটায় প্রয়োগ করার টাস্ক
- Clustering: ডেটাতে গ্রুপ ও স্ট্রাকচার খুঁজে বের করার টাস্ক যেগুলো কোনোভাবে একই, ডেটাতে নোটেড স্ট্রাকচার ব্যবহার ছাড়া।
- Association rule learning: ভেরিয়েবলগুলোর মধ্যে সম্পর্ক খুঁজে বের করে
- Regression: স্লাইটএস্ট এরর সহ ডেটাকে মডেল করার একটি ফাংশন খুঁজে বের করার লক্ষ্য
নিচে ডেটা মাইনিং-এর জন্য ফ্রি সফটওয়্যার টুলের তালিকা:
২০২২ সালের সেরা ফ্রি ডেটা মাইনিং টুলের তালিকা:-
১. Rapid Miner –
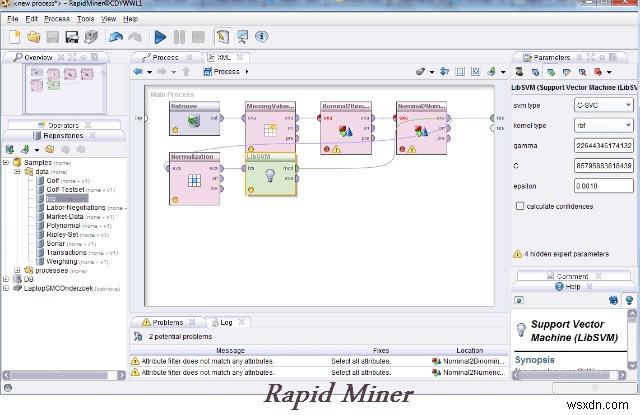
Rapid Miner, যাকে আগে YALE (Yet another Learning Environment) বলা হতো, মেশিন লার্নিং এবং ডেটা মাইনিং এক্সপেরিমেন্টের জন্য একটি এনভায়রনমেন্ট যা রিসার্চ এবং রিয়েল-ওয়ার্ল্ড ডেটা-মাইনিং টাস্ক দুটোই জন্য ব্যবহৃত হয়। এটি নিঃসন্দেহে ডেটা মাইনিং-এর জন্য বিশ্বের 최고의 ওপেন-সোর্স সিস্টেম। Java প্রোগ্রামিং ল্যাঙ্গুয়েজে লেখা, এই টুল টেমপ্লেট-ভিত্তিক ফ্রেমওয়ার্কের মাধ্যমে উন্নত অ্যানালিটিক্স অফার করে।
এটি এক্সপেরিমেন্টগুলিকে ভারি লার্জ সংখ্যায় আবিট্রেরিলি নেস্টেবল অপারেটরใชতে সক্ষম করে, যেগুলো XML ফাইলে ডিটেইলড থাকে এবং Rapid Miner-এর গ্রাফিক্যাল ইউজার ইন্টারফেস দিয়ে তৈরি হয়। সেরা ব্যাপার হলো ব্যবহারকারীদের কোড লিখতে হয় না। এতে ইতিমধ্যে অনেক টেমপ্লেট এবং অন্যান্য টুল থাকে যা ডেটা সহজে বিশ্লেষণ করতে দেয়।
২. IBM SPSS Modeler –
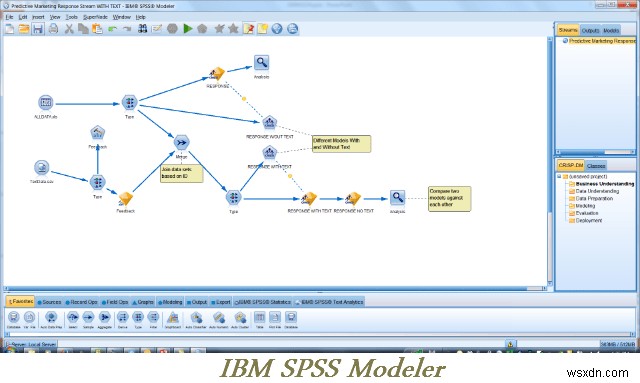
IBM SPSS Modeler টুল ওয়ার্কবেঞ্চ বড় স্কেলের প্রজেক্টের জন্য সেরা যেমন টেক্সটুয়াল অ্যানালিটিক্স, এবং এর ভিজ্যুয়াল ইন্টারফেস অত্যন্ত মূল্যবান। এটি আপনাকে প্রোগ্রামিং ছাড়া ডেটা মাইনিং অ্যালগরিদমের বিভিন্ন ধরন জেনারেট করতে দেয়। এটিও অ্যানোমালি ডিটেকশন, বায়েসিয়ান নেটওয়ার্ক, CARMA, Cox রিগ্রেশন এবং বেসিক নিউরাল নেটওয়ার্ক যা মাল্টিলেয়ার পারসেপট্রন উইথ ব্যাক-প্রোপাগেশন লার্নিং ব্যবহার করে সেটি জন্য ব্যবহার করা যেতে পারে। হriday দুর্বলদের জন্য নয়।
৩. Oracle Data Mining –
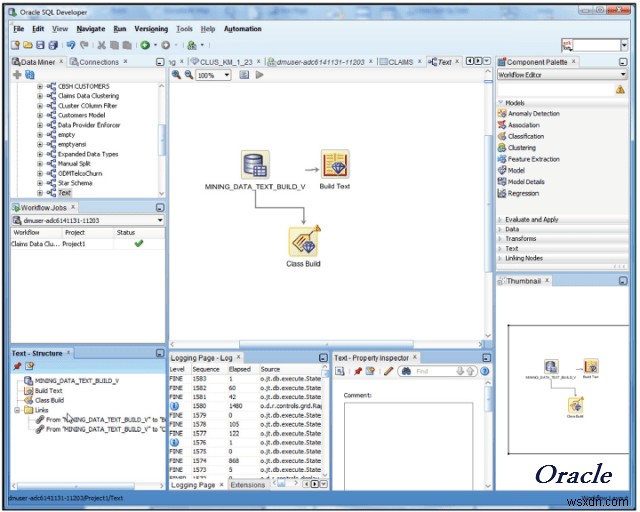
ডেটা মাইনিং sfear-এ অন্য একটি বড় প্লেয়ার হল Oracle। তাদের Advanced Analytics Database অপশনের অংশ হিসেবে, Oracle data mining তার ব্যবহারকারীদের ইনসাইট আবিষ্কার, প্রেডিকশন এবং তাদের Oracle ডেটা ليفারেজ করতে দেয়। আপনি মডেল বানাতে পারেন কাস্টমার আচরণ আবিষ্কার করতে, সেরা কাস্টমার টার্গেট করতে এবং প্রোফাইল ডেভেলপ করতে।
The Oracle Data Miner GUI ডেটা অ্যানালিস্ট, বিজনেস অ্যানালিস্ট এবং ডেটা সায়েন্টিস্টকে ডেটাবেসের ভিতর ডেটার সাথে কাজ করতে দেয় একটিuttosto এলিগ্যান্ট ড্র্যাগ অ্যান্ড ড্রপ সমাধানের মাধ্যমে। এটি SQL এবং PL/SQL স্ক্রিপ্টও তৈরি করতে পারে অটোমেশন, শিডিউলিং এবং এন্টারপ্রাইজ 전반ে ডিপ্লয়মেন্টের জন্য।
৪. Teradata –
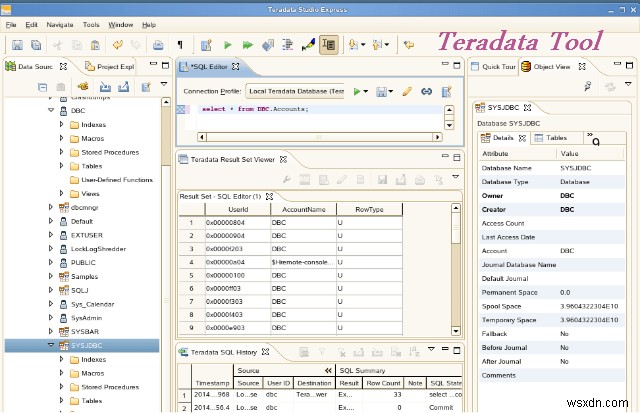
Teradata এই সত্যকে স্বীকার করে যে, বড় ডেটা চমৎকার হলেও, আপনি যদি আসলে জানেন না কীভাবে এটিকে বিশ্লেষণ ও ব্যবহার করবেন, তবে সেটি বেকার। কল্পনা করুন মিলিয়ন মিলিয়ন ডেটা পয়েন্ট থাকা কিন্তু সেগুলো কুয়েরি করার স্কিল নেই। সেটাই যেখানে Teradata আসে। তারা এন্ড-টু-এন্ড সমাধান এবং সেবা প্রদান করে ডেটা ওয়্যারহাউসিং, বিগ ডেটা এবং অ্যানালিটিক্স এবং মার্কেটিং অ্যাপ্লিকেশনে।
Teradata এছাড়া সার্ভিসের একটি সম্পূর্ণ হোস্ট অফার করে যার মধ্যে ইমপ্লিমেন্টেশন, বিজনেস কনসাল্টিং, ট্রেনিং এবং সাপোর্ট রয়েছে।
৫. Framed Data –
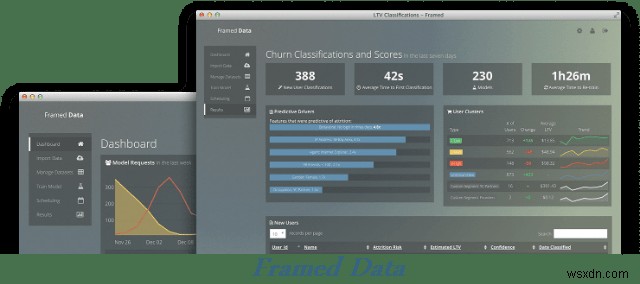
এটি একটি ফুলি ম্যানেজড সমাধান যার মানে আপনাকে কিছুই করতে হবে না শুধু পেছনে বসে ইনসাইটের জন্য অপেক্ষা করুন। Framed Data ব্যবসা থেকে ডেটা নিয়ে সেটিকে actionable insights এবং সিদ্ধান্তে রূপান্তর করে। তারা মডেল ট্রেইন, অপ্টিমাইজ, এবং প্রোডাকশনাইজড মডেল তাদের ক্লাউডে সংরক্ষণ করে এবং API-এর মাধ্যমে প্রেডিকশন প্রদান করে, ইনফ্রাস্ট্রাকচার ওভারহেড দূর করে। তারা ড্যাশবোর্ড এবং সিনেরিও অ্যানালিসিস টুল প্রদান করে যা বলে কোম্পানির কোন লিভার মেট্রিক্স চালাচ্ছে যেগুলো আপনার কাছে যত্নের বিষয়।
৬. Kaggle –
Kaggle বিশ্বের সবচেয়ে বড় ডেটা সায়েন্স কমিউনিটি। কোম্পানি এবং রিসার্চাররা তাদের ডেটা পোস্ট করে এবং স্ট্র্যাটিস্টিশিয়ান ও ডেটা মাইনাররা সারা বিশ্ব থেকে প্রতিযোগিতা করে সেরা মডেল তৈরি করতে।
Kaggle একটি ডেটা সায়েন্স কম্পিটিশন প্ল্যাটফর্ম। এটি আপনাকে কঠিন সমস্যা সমাধান, স্ট্রอง টিম রিক্রুট, এবং আপনার ডেটা সায়েন্স ট্যালেন্টের শক্তি বাড়াতে সাহায্য করে।
কাজ করার ৩ ধাপ –
- একটি প্রিডিকশন সমস্যা আপলোড করুন
- সাবমিট করুন
- ইভ্যালুয়েট এবং এক্সচেঞ্জ করুন
৭. Weka –
WEKA একটি খুব সোফিস্টিকেটেড সেরা ডেটা মাইনিং টুল। এটি আপনাকে ডেটা সেটের মধ্যে বিভিন্ন সম্পর্ক, ক্লাস্টার, প্রিডিক্টিভ মডেলিং, ভিজ্যুয়ালাইজেশন ইত্যাদি দেখায়। ডেটাতে আরও ইনসাইট পाने জন্য আপনি যে কতগুলো ক্লাসিফায়ার প্রয়োগ করতে পারেন।
৮. Rattle –

Rattle হলো R Analytical Tool to Learn Easily-এর সংক্ষিপ্ত রূপ। এটি ডেটার স্ট্যাটিস্টিক্যাল ও ভিজ্যুয়াল সামারি প্রেজেন্ট করে, ডেটাকে এমন ফর্মে রূপান্তর করে যাতে সহজে মডেল করা যায়, ডেটা থেকে unsupervised এবং supervised উভয় মডেল বানায়, মডেলের পারফরম্যান্স গ্রাফিক্যালি প্রেজেন্ট করে, এবং নতুন ডেটাসেট স্কোর করে।
এটি একটি ফ্রি এবং ওপেন সোর্স সেরা ডেটা মাইনিং টুলকিট যা স্ট্যাটিস্টিক্যাল ল্যাঙ্গুয়েজ R-এ লেখা হয়েছে Gnome গ্রাফিক্যাল ইন্টারফেস ব্যবহার করে। এটি GNU/Linux, Macintosh OS X, এবং MS/Windows-এ চলে।
৯. KNIME –
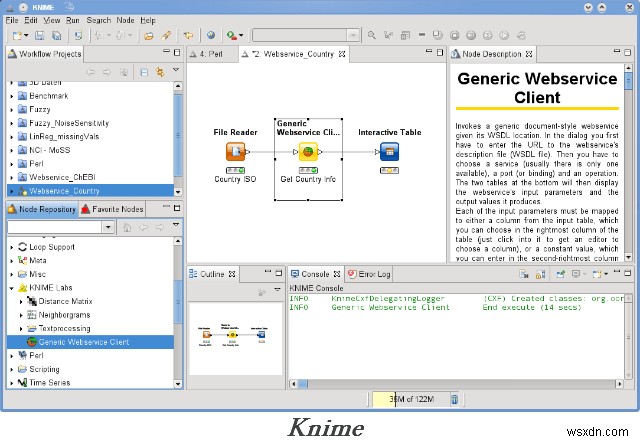
Konstanz Information Miner একটি ইউজার-ফ্রেন্ডলি, বোধগম্য এবং ব্যাপক ওপেন-সোর্স ডেটা ইন্টিগ্রেশন, প্রসেসিং, অ্যানালिसিস এবং এক্সপ্লোরেশন প্ল্যাটফর্ম। এর একটি গ্রাফিক্যাল ইউজার ইন্টারফেস আছে যা ব্যবহারকারীদের নোডস সহজে কানেক্ট করতে সাহায্য করে ডেটা প্রসেসিং-এর জন্য।
KNIME মেশিন লার্নিং এবং ডেটা মাইনিং-এর জন্য çeşitli কম্পোনেন্ট ইন্টিগ্রেট করে তার মডুলার ডেটা পাইপলাইনিং কনসেপ্টের মাধ্যমে এবং বিজনেস ইন্টেলিজেন্স এবং ফাইন্যানশিয়াল ডেটা অ্যানালিসিসের দৃষ্টি আকর্ষণ করেছে।
১০. Python –
একটি ফ্রি এবং ওপেন সোর্স ল্যাঙ্গুয়েজ হিসেবে, Pythonকে প্রায়শই R-এর সাথে ইজ অফ ইউজের জন্য তুলনা করা হয়। R-এর বিপরীতে, Python-এর লার্নিং কর্ভ如此 সংক্ষিপ্ত যে এটি লেজেন্ডারি হয়ে উঠেছে। অনেক ব্যবহারকারী খুঁজে পেয়েছে যে তারা মিনিটের মধ্যে ডেটা সেট বানাতে এবং অত্যন্ত জটিল অ্যাফিনিটি অ্যানালিসিস করতে পারছে। সবচেয়ে সাধারণ বিজনেস-ইউজ কেস-ডেটা ভিজ্যুয়ালাইজেশন সহজ যতক্ষণ আপনি বেসিক প্রোগ্রামিং কনসেপ্ট যেমন ভেরিয়েবল, ডেটা টাইপ, ফাংশন, কন্ডিশনাল এবং লুপস সাথে কমফরটেবল থাকেন।
১১. Orange –
Orange একটি কম্পোনেন্ট-ভিত্তিক ডেটা মাইনিং এবং মেশিন লার্নিং সফটওয়্যার স্যুট যা Python ল্যাঙ্গুয়েজে লেখা। এটি নович এবং এক্সপার্ট উভয়ের জন্য ওপেন সোর্স ডেটা ভিজ্যুয়ালাইজেশন এবং অ্যানালাইসিস। ডেটা মাইনিং ভিজ্যুয়াল প্রোগ্রামিং বা Python স্ক্রিপ্টিংয়ের মাধ্যমে করা যেতে পারে। এটিও ডেটা অ্যানালিটিক্স, বিভিন্ন ভিজ্যুয়ালাইজেশন, স্ক্যাটারপ্লট, বার চার্ট, ট্রি, থেকে ডেন্ড্রোগ্রাম, নেটওয়ার্ক এবং হিট ম্যাপস까지 প্যাক করা ফিচারসহ আসে।
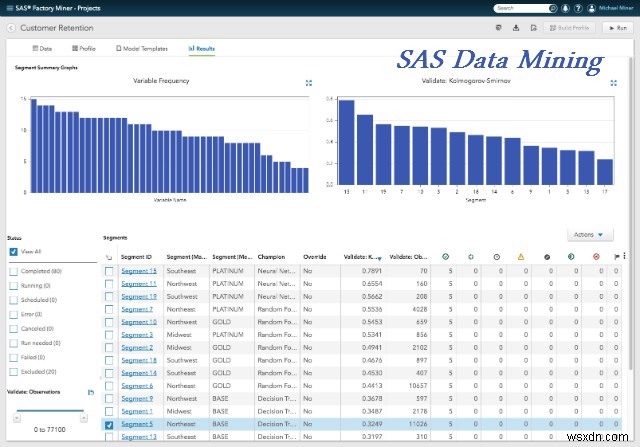
১২. SAS Data Mining –
SAS Data Mining কমার্শিয়াল সফটওয়্যার ব্যবহার করে ডেটা সেট প্যাটার্ন আবিষ্কার করুন। এর ডেসক্রিপ্টিভ এবং প্রিডিক্টিভ মডেলিং ডেটা ভালো বোঝার জন্য ইনসাইট দেয়। তারা ইজি টু ইউজ GUI অফার করে। তাদের অটোমেটেড টুলস আছে ডেটা প্রসেসিং, ক্লাস্টারিং থেকে শেষ পর্যন্ত যেখানে আপনি সঠিক সিদ্ধান্ত নেওয়ার জন্য সেরা ফলাফল পেতে পারেন। কমার্শিয়াল সফটওয়্যার হওয়ায় এটিও এডভান্সড টুলস ইনক্লুড করে যেমন স্কেলেবল প্রসেসিং, অটোমেশন, ইনটেনসিভ অ্যালগরিদম, মডেলিং, ডেটা ভিজ্যুয়ালাইজেশন এবং এক্সপ্লোরেশন ইত্যাদি।
১৩. Apache Mahout –
Apache Mahout হলো Apache Software Foundation-এর একটি প্রজেক্ট যা ডিস্ট্রিবিউটেড বা অন্যথায় স্কেলেবল মেশিন লার্নিং অ্যালগরিদমের ফ্রি ইমপ্লিমেন্টেশন তৈরি করার জন্য प्रमुखত কোলাবরেটিভ ফিল্টারিং, ক্লাস্টারিং এবং ক্লাসিফিকেশনের ক্ষেত্রে ফোকাস করে।
Apache Mahout মূলত তিনটি ইউজ কেস সাপোর্ট করে: রিকমেন্ডেশন মাইনিং ব্যবহারকারীদের আচরণ নেয় এবং সেটি থেকে চেষ্টা করে যেসব আইটেম ব্যবহারকারীরা পছন্দ করতে পারে সেগুলো খুঁজে বের করতে। ক্লাস্টারিং নেয় যেমন টেক্সট ডকুমেন্ট এবং সেগুলো টপিকালি রিলেটেড ডকুমেন্টের গ্রুপে গ্রুপ করে। ক্লাসিফিকেশন বিদ্যমান ক্যাটাগরাইজড ডকুমেন্ট থেকে শিখে একটি নির্দিষ্ট ক্যাটাগরির ডকুমেন্ট কেমন দেখে সেটি বুঝতে পারে এবং আনলেবেলড ডকুমেন্টকে (আশা করি) সঠিক ক্যাটাগরিতে অ্যাসাইন করতে পারে।
১৪. PSPP –
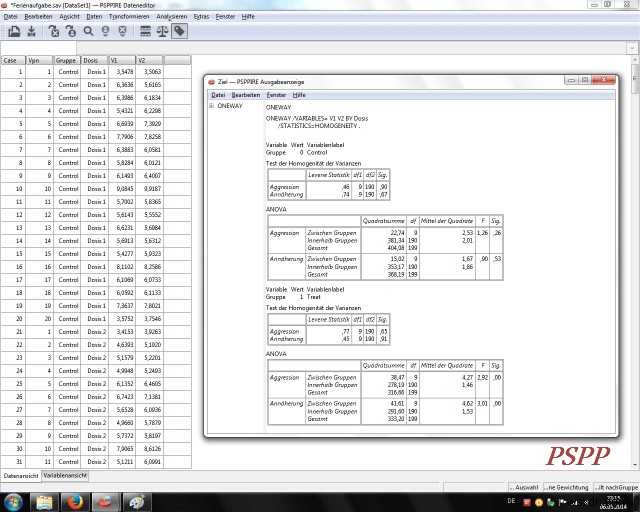
PSPP হলো স্যাম্পলড ডেটার স্ট্যাটিস্টিক্যাল অ্যানালিসিসের জন্য একটি প্রোগ্রাম। এর একটি গ্রাফিক্যাল ইউজার ইন্টারফেস এবং কনভেনশনাল কমান্ড-লাইন ইন্টারফেস আছে। এটি C-এ লেখা, GNU Scientific Library ব্যবহার করে তার ম্যাথমেটিক্যাল রুটিনের জন্য, এবং প্লট UTILS গ্রাফ জেনারেট করার জন্য। এটি SPSS-এর (IBM থেকে) একটি ফ্রি রিপ্লেসমেন্ট 자신ের সাথে কী হবে তা প্রিডিক্ট করতে পারবেন যাতে আপনি স্মার্টার সিদ্ধান্ত নিতে পারেন, সমস্যা সমাধান করতে পারেন এবং ফলাফল উন্নত করতে পারেন।
১৫. jHepWork –
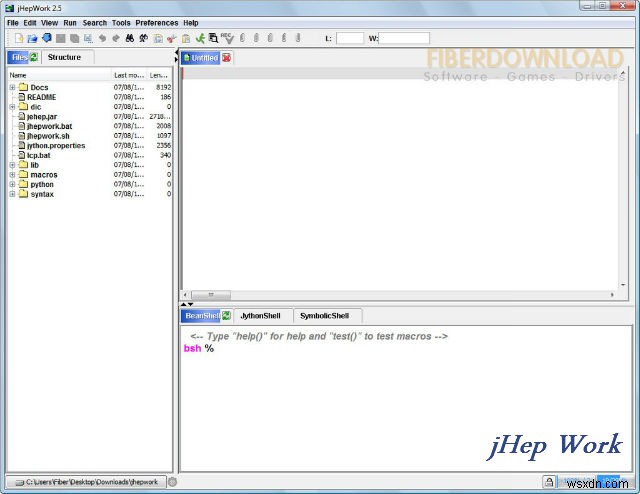
jHepWork একটি ফ্রি এবং ওপেন-সোর্স ডেটা-অ্যানালিসিস ফ্রেমওয়ার্ক যা ওপেন-সোর্স প্যাকেজ ব্যবহার করে একটি ডেটা-অ্যানালিসিস এনভায়রনমেন্ট তৈরি করার চেষ্টা হিসেবে তৈরি হয়েছে একটি বোঝার যোগ্য ইউজার ইন্টারফেস এবং কমার্শিয়াল প্রোগ্রামের সাথে প্রতিযোগিতামূলক একটি টুল তৈরি করতে।
JHepWork ডেটা সেটের জন্য ইন্টারঅ্যাক্টিভ ২D এবং ৩D প্লট দেখায় ভালো অ্যানালিসিসের জন্য। সেখানে न्यूमেরিক্যাল সায়েন্টিফিক লাইব্রেরি এবং ম্যাথমেটিক্যাল ফাংশন Java-এ ইমপ্লিমেন্ট করা আছে। jHepWork একটি হাই-লেভেল প্রোগ্রামিং ল্যাঙ্গুয়েজ Jython-এ ভিত্তি করে, কিন্তু Java কোডিংও ব্যবহার করা যেতে পারে jHepWork-এর न्यুমেরিক্যাল এবং গ্রাফিক্যাল লাইব্রেরি কল করার জন্য।
১৬. R Programming Language–
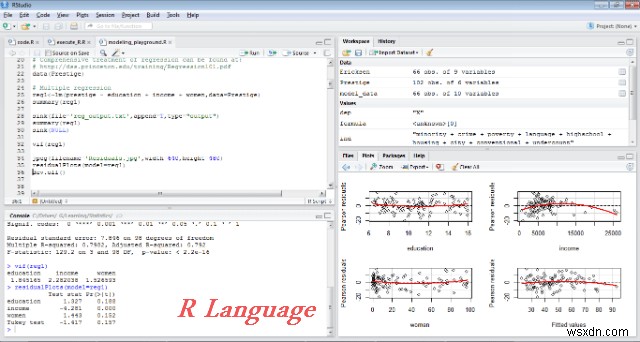
এই তালিকায় ফ্রি ডেটা মাইনিং টুলসের সুপারস্টার R কেন সেটি কোনো রহস্য নেই। এটি ফ্রি, ওপেন সোর্স এবং কম বা শূন্য প্রোগ্রামিং অভিজ্ঞতার মানুষের জন্য সহজে পিক আপ করা যায়। буквально হাজার হাজার লাইব্রেরি আছে যেগুলো R এনভায়রনমেন্টে ইনকর্পোরেট করা যেতে পারে এটিকে একটি পাওয়ারফুল ডেটা মাইনিং এনভায়রনমেন্ট বানাতে। এটি একটি ফ্রি সফটওয়্যার প্রোগ্রামিং ল্যাঙ্গুয়েজ এবং সফটওয়্যার এনভায়রনমেন্ট স্ট্যাটিস্টিক্যাল কম্পিউটিং এবং গ্রাফিক্সের জন্য।
R ল্যাঙ্গুয়েজ ডেটা মাইনাররা ব্যাপকভাবে ব্যবহার করে স্ট্যাটিস্টিক্যাল সফটওয়্যার এবং ডেটা অ্যানালিসিস ডেভেলপ করার জন্য। ইজ অফ ইউজ এবং এক্সটেনসিবিলিটি gần年在位 R-এর জনপ্রিয়তাকে উল্লেখযোগ্যভাবে বাড়িয়েছে।
১৭. Pentaho –
Pentaho ডেটা ইন্টিগ্রেশন, বিজনেস অ্যানালিটিক্স এবং বিগ ডেটার জন্য একটি ব্যাপক প্ল্যাটফর্ম প্রদান করে। এই কমার্শিয়াল টুল দিয়ে আপনি যেকোনো সোর্স থেকে ডেটা ব্লেন্ড করতে সহজে পারবেন। আপনার বিজনেস ডেটায় ইনসাইট পান এবং ভবিষ্যতের জন্য আরও সঠিক ইনফরমেশন-চালিত সিদ্ধান্ত নিন।
১৮. Tanagra –
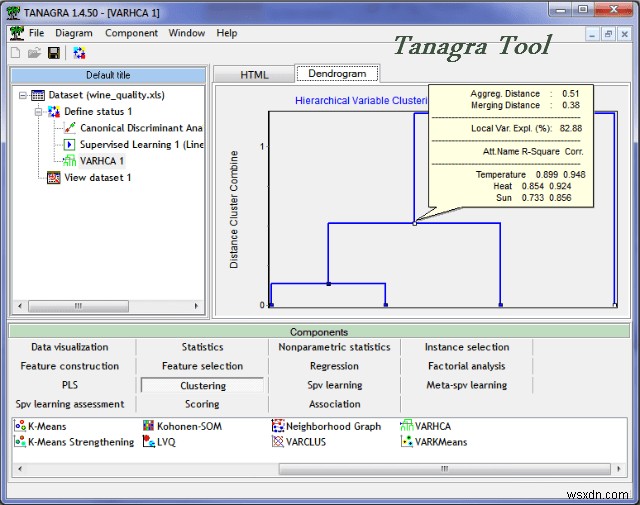
TANAGRA একাডেমিক এবং রিসার্চ উদ্দেশ্যে ডেটা মাইনিং সফটওয়্যার। এক্সপ্লোরেটরি ডেটা অ্যানালিসিস, স্ট্যাটিস্টিক্যাল লার্নিং, মেশিন লার্নিং এবং ডেটাবেস এরিয়া জন্য টুলস আছে। Tanagra কিছু সুপারভাইজড লার্নিং কন্টেইন করে কিন্তু অন্যান্য পারাডাইমও যেমন ক্লাস্টারিং, ফ্যাক্টোরিয়াল অ্যানালিসিস, প্যারামেট্রিক এবং নন-প্যারামেট্রিক স্ট্যাটিস্টিক্স, অ্যাসোসিয়েশন রুল, ফিচার সিলেকশন এবং কনস্ট্রাকশন অ্যালগরিদম।
১৯. NLTK –
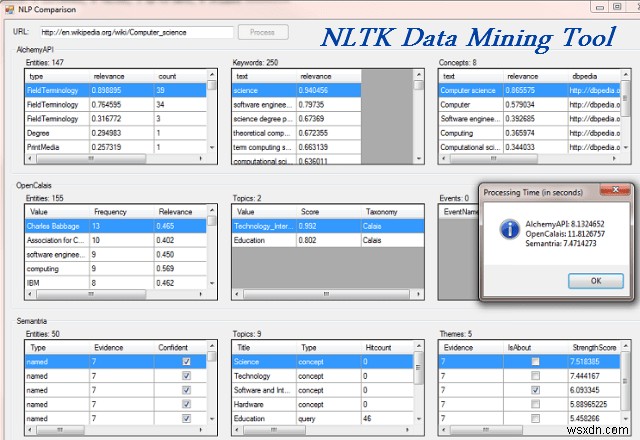
Natural Language Toolkit, হলো লাইব্রেরি এবং প্রোগ্রামের একটি স্যুট যা পাইথন ল্যাঙ্গুয়েজের জন্য সিম্বোলিক এবং স্ট্যাটিস্টিক্যাল ন্যাচারাল ল্যাঙ্গুয়েজ প্রসেসিং (NLP)-এর জন্য। এটি ল্যাঙ্গুয়েজ প্রসেসিং টুলের একটি পুল প্রদান করে যার মধ্যে ডেটা মাইনিং, মেশিন লার্নিং, ডেটা স্ক্র্যাপিং, সেন্টিমেন্ট অ্যানালিসিস এবং অন্যান্য বিভিন্ন ল্যাঙ্গুয়েজ প্রসেসিং টাস্ক রয়েছে। মানব ভাষার ডেটা নিয়ে কাজ করার জন্য পাইথন প্রোগ্রাম বানান।
আমাদের সেরা ফ্রি ডেটা মাইনিং টুলের তালিকা আপনাকে সাহায্য করেছে তা আশা করি। আমরা আপনার মতামত জানতে চাই, দয়া করে কমেন্ট সেকশনে আপনার মতামত শেয়ার করুন।
