

আপনি কী করবেন যদি আপনাকে একটি বড় টেক্সট কালেকশন দেয়া হয় এবং আপনি সেটি থেকে কিছু মিনিং আউট করতে চান?
একটি ভালো শুরু হলো আপনার টেক্সটকে n-gram-এ ভাঙা।
এখানে একটি বিবরণ:
কম্পিউটেশনাল লিংগুইস্টিক্স এবং প্রোবেবিলিটির ক্ষেত্রে, একটি n-gram হলো একটি প্রদত্ত টেক্সট সিকোয়েন্স থেকে n সংখ্যক আইটেমের একটি কন্টিগুয়াস সিকোয়েন্স। — উইকিপিডিয়া
উদাহরণস্বরূপ:
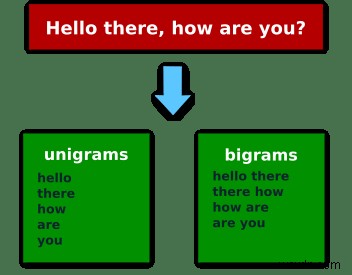
যদি আমরা ফ्रेजটি “Hello there, how are you?” নিই, তবে ইউনিগ্রাম (একটি এলিমেন্টের ngram) হবেন: "Hello", "there", "how", "are", "you", এবং বাইগ্রাম (দুই এলিমেন্টের ngrams): ["Hello", "there"], ["there", "how"], ["how", "are"], ["are", "you"]।
আপনি ছবি দিয়ে ভালো শিখেন তবে এখানে সেটির একটি ছবি:
এখন চলুন দেখি আপনি রুবিতে এটিকে কীভাবে ইমপ্লিমেন্ট করতে পারেন!
স্যাম্পল ডেটা ডাউনলোড করা
আমরা হাত আঁটো করার আগে আমাদের কিছু স্যাম্পল ডেটা লাগবে।
আপনার যদি নিজের কোনো ডেটা না থাকে তবে আপনি কয়েকটি উইকিপিডিয়া বা ব্লগ আর্টিকেল ডাউনলোড করতে পারেন। এই পर्टিকুলার কেসে, আমি #ruby freenode চ্যানেলের কিছু IRC লগ ডাউনলোড করতে সিদ্ধান্ত নিয়েছিলাম।
লগগুলো এখানে পাওয়া যাবে:
irclog.whitequark.org/ruby
ডেটা ফরম্যাট সম্পর্কে একটি নোট:
আপনি যদি যে রিসোর্সটি আপনি অ্যানালাইজ করতে চান তার প্লেইন টেক্সট ভার্শন উপলব্ধ না থাকে, তবে আপনি Nokogiri ব্যবহার করে পেজটি পার্স করে ডেটা এক্সট্রাক্ট করতে পারেন।
IRC লগগুলো প্লেইন টেক্সটে উপলব্ধ URL-এর শেষে .txt অ্যাপেন্ড করলে, তাই আমরা এর সুবিধা নেব।
এই ক্লাসটি ডেটা ডাউনলোড এবং সেভ করবে:
require 'restclient' class LogParser LOG_DIR = 'irc_logs' def initialize(date) @date = date @log_name = "#{LOG_DIR}/irc-log-#{@date}.txt" end def download_page(url) return log_contents if File.exist? @log_name RestClient.get(url).body end def save_page(page) File.open(@log_name, "w+") { |f| f.puts page } end def log_contents File.readlines(@log_name).join end def get_messages page = download_page("https://irclog.whitequark.org/ruby/#{@date}.txt") save_page(page) page end end log = LogParser.new("2015-04-15") msg = log.get_messages
এটি একটি খুব সোজা ক্লাস।
আমরা RestClient আমাদের HTTP ক্লায়েন্ট হিসেবে ব্যবহার করি এবং তারপর রেজাল্টগুলো একটি ফাইলে সেভ করি যাতে প্রোগ্রাম মডিফাই করার সময় আমাদের একাধিকবার রিকোয়েস্ট করতে না হয়।
ডেটা অ্যানালাইসিস
এখন যেহেতু আমাদের ডেটা আছে, আমরা এটিকে অ্যানালাইজ করতে পারি।
এখানে একটি সিম্পল Ngram ক্লাস।
এই ক্লাসে আমরা Array#each_cons মেথড ব্যবহার করি যা ngrams প্রডিউস করে।
কারণ এই মেথডটি একটি Enumerator রিটার্ন করে, আমাদের to_a কল করতে হবে একটি Array পেতে।
class Ngram def initialize(input) @input = input end def ngrams(n) @input.split.each_cons(n).to_a end end
তারপর আমরা সব কিছু একসাথে বানাই একটি লুপ, Hash#merge! এবং Enumerable#sort_by ব্যবহার করে।
যেন:
# এই সংখ্যা থেকে কম বার আসা ওয়ার্ড ফিল্টার করুন MIN_REPETITIONS = 20 total = {} # মাসের প্রথম ১৫ দিনের লগ পান এবং ট্রাইগ্রাম রিটার্ন করুন (1..15).each do |n| day = '%02d' % [n] total.merge!(get_trigrams_for_date "2015-04-#{day}") { |k, old, new| old + new } end # ডিসেন্ডিং অর্ডারে সর্ট করুন total = total.sort_by { |k, v| -v }.reject { |k, v| v < MIN_REPETITIONS } total.each { |k, v| puts "#{v} => #{k}" }
নোট: brevity-এর জন্য
get_trigrams_for_dateমেথডটি এখানে নেই, কিন্তু আপনি এটিকে গিটহাবে পাবেন।
আউটপুট এমন দেখাবে:
112 => i want to 83 => link for more 82 => is there a 71 => you want to 66 => i don't know 66 => i have a 65 => i need to
আপনি দেখতে পাচ্ছেন #ruby-এ কিছু করার ইচ্ছা খুব জনপ্রিয় 🙂
উপসংহার
এখন আপনার পালা!
আপনার এডিটর খুলুন এবং n-gram অ্যানালাইসিসের সাথে খেলা শুরু করুন। n-gram অ্যাকশনে দেখার আরেকটি পদ্ধতি হলো Google Ngram Viewer।
ন্যাচারেল ল্যাঙ্গুয়েজ প্রসেসিং (NLP) একটি আকর্ষণীয় বিষয় হতে পারে, উইকিপিডিয়াতে এই টপিকের একটি ভালো ওভারভিউ রয়েছে।
এই পোস্টের সম্পূর্ণ কোড এখানে পাবেন: https://github.com/matugm/ngram-analysis/blob/master/irc_histogram.rb
