

আমি সম্প্রতিতে একটি আর্টিকেল পাবলিশ করেছিলাম যেখানে আমি রুবির অধিকাংশ স্ট্রিং মেথডকে নির্দিষ্ট ইউনিকোড ক্যারেক্টার দিয়ে টেস্ট করেছিলাম দেখতে কি সেগুলো অপ্রত্যাশিতভাবে behave করে। उनमें से অনেকই করত।
আর্টিকেলের một সমালোচনা ছিল যে আমি টেস্টের জন্য unnormalized স্ট্রিং ব্যবহার করেছিলাম। স্পষ্টভাবে, আমি ইউনিকোড নর্মালাইজেশন নিয়ে কিছুটা fuzzy ছিলাম। আমি অনুমান করি অনেক রুবিস্টরা এই বিষয়ে একই অবস্থানে আছে।
নর্মালাইজেশন ব্যবহার করে, আপনি অনেক ইউনিকোড স্ট্রিং নেওয়া যাবে যা আমার টেস্টে অপ্রত্যাশিতভাবে behave করেছিল, এবং সেগুলো রুবির স্ট্রিং মেথডের সাথে ভালোভাবে কাজ করার মতো স্ট্রিং-এ কনভার্ট করা যাবে। যাহোক:
- কনভারশনটি সবসময় পারফেক্ট নয়। কিছু ইউনিকোড সিকোয়েন্স সবসময় রুবির স্ট্রিং মেথডকে মিসবিহেভ করাবে।
- এটি আপনাকে ম্যানুয়ালি করতে হয়। না রুবি, না রেলস, না ডিবি ডিফল্টরূপে অটোমেটিক্যালি নর্মালাইজ করে।
এই আর্টিকেলটি রুবিতে ইউনিকোড নর্মালাইজেশনের একটি সংক্ষিপ্ত পরিচয়। আশা করি এটি আপনার নিজস্ব এক্সপ্লোরেশনের জন্য একটি জাম্পিং-অফ পয়েন্ট দেবে।
একটি স্ট্রিং নর্মালাইজ করুন
String#unicode_normalizeমেথডটি রুবি ২.২-এ চালু করা হয়েছিল। রুবিতে লেখা হওয়ায়, এটি utf8_proc এবং unicode জেমের মত C-কে লিভারেজ করে এমন নর্মালাইজেশন লাইব্রেরির চেয়ে দ্রুত নয়।
নর্মালাইজেশনের প্রয়োজন কারণ ইউনিকোডে একটি ক্যারেক্টার লেখার একাধিক উপায় আছে। অক্ষর "Å" কোড পয়েন্ট "\u00c5" হিসেবে রিপ্রেজেন্ট করা যাবে, অথবা "A" অক্ষর এবং একটি এক্সেন্টের কম্পোজিশন হিসেবে: "A\u030A"।
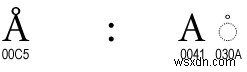
নর্মালাইজেশন একটি ফর্মকে অন্য ফর্মে কনভার্ট করে:
"A\u030A".unicode_normalize #=> 'Å' (same as "\u00C5")
ব অবশ্য, ইউনিকোড নর্মালাইজ করার শুধু একটি উপায় নেই। এটা খুব সহজ হতো! ইউনিকোড নর্মালাইজ করার চারটি উপায় আছে, যাকে "নর্মালাইজেশন ফর্ম" বলা হয়। এগুলো ক্রিপ্টিক এক্রোনিম দিয়ে নামকরণ করা হয়েছে: NFD, NFC, NFKD এবং NFKC।
String#unicode_normalize ডিফল্টরূপে NFC ব্যবহার করে, কিন্তু আমরা এটিকে অন্য ফর্ম ব্যবহার করার জন্য বলতে পারি:
"a\u0300".unicode_normalize(:nfkc) #=> 'à' (same as "\u00E0")
কিন্তু এটের আসল মানে কী? চারটি নর্মালাইজেশন ফর্ম আসলে কী করে? চলুন এক নজর দেই।
নর্মালাইজেশন ফর্ম
দুই ধরনের নর্মালাইজেশন অপারেশন আছে:
- কম্পোজিশন (Composition): মাল্টি-কোড-পয়েন্ট ক্যারেক্টারকে সিংগল কোড পয়েন্টে কনভার্ট করে। উদাহরণ:
"a\u0300"হয়ে যায়"\u00E0", যদুইàক্যারেক্টার এনকোড করার উপায়। - ডিকম্পোজিশন (Decomposition): কম্পোজিশনের বিপরীত। সিংগল-কোড-পয়েন্ট ক্যারেক্টারকে মাল্টিপল কোড পয়েন্টে কনভার্ট করে। উদাহরণ:
"\u00E0"হয়ে যায়"a\u0300"।
কম্পোজিশন এবং ডিকম্পোজিশন প্রতিটি দুটিভাবে করা যায়:
- ক্যানোনিক্যাল (Canonical): গ্লিফ সংরক্ষণ করে। উদাহরণ:
"2⁵"থাকে"2⁵"এমনকি কিছু সিস্টেম সুপারস্ক্রিপ্ট-ফাইভ ক্যারেক্টার সাপোর্ট না করলেও। - কম্প্যাটিবিলিটি (Compatibility): গ্লিফকে তাদের কম্প্যাটিবিলিটি ক্যারেক্টার দিয়ে রিপ্লেস করতে পারে। উদাহরণ:
"2⁵"কনভার্ট হয়ে যাবে"2 5"।
দুই অপারেশন এবং দুটি অপশন বিভিন্নভাবে কম্বাইন হয়ে চারটি "নর্মালাইজেশন ফর্ম" তৈরি করে। আমি उन সবগুলোকে নিচের টেবিলে লিস্ট করেছি, বর্ণনা এবং ইনপুট/আউটপুট উদাহরণসহ:
| নাম | বর্ণনা | ইনপুট | আউটপুট |
|---|---|---|---|
| NFD | Canonical Decomposition | Å "\u00c5" |
Å "A\u030A" |
| NFC | Canonical Decomposition Followed by Canonical Composition | Å "A\u030A" |
Å "\u00c5" |
| NFKD | Compatibility Decomposition | ẛ̣ "\u1e9b\u0323" |
ṩ "\u0073\u0323\u0307" |
| NFKC | Compatibility Decomposition Followed by Canonical Composition | ẛ̣ "\u1e9b\u0323" |
ṩ "\u1e69" |
যদি আপনি এই টেবিলকে কিছু মিনিট দেখেন তবে আপনি লক্ষ্য করতে পারেন যে এক্রোনিমগুলো কিছুটা সেন্স দেয়:
- "NF" står করে "normalization form"-এর জন্য।
- "D" står করে "decomposition"-এর জন্য।
- "C" står করে "composition"-এর জন্য।
- "K" står করে "kompatibility" :)-এর জন্য।
আরও উদাহরণ এবং çok আরও গভীর টেকনিক্যাল ব্যাখ্যা জন্য, Unicode Standard Annex #15 চেক করুন।
একটি নর্মালাইজেশন ফর্ম বাছাই
আপনার যে কাজে ব্যবহার করবেন সেটি নির্ভর করে নর্মালাইজেশন ফর্ম বাছাই করার ওপর। আমার নিচের সুপারিশগুলো Unicode Normalization FAQ-র ওপর ভিত্তি করে।
স্ট্রিং কম্প্যাটিবিলিটির জন্য NFC ব্যবহার করুন
যদি আপনার লক্ষ্য হয় রুবির স্ট্রিং মেথডগুলোকে অধিকাংশ ইউনিকোডের সাথে ভালোভাবে কাজ করার জন্য, তবে আপনি সম্ভবত NFC চান। এটার একটি কারণ আছে যে এটি String#unicode_normalize-এর ডিফল্ট।
- এটি মাল্টি-কোড-পয়েন্ট ক্যারেক্টারকে সিংগল কোড পয়েন্টে কম্পোজ করে যেখানে সম্ভব। মাল্টি-কোড-পয়েন্ট ক্যারেক্টার স্ট্রিং মেথডের অধিকাংশ সমস্যার উৎস।
- এটি গ্লিফ পরিবর্তন করে না, তাই আপনার এন্ড-ইউজাররা তাদের ইনপুট টেক্সটে কোনো পরিবর্তন লক্ষ্য করবেন না।
そう言うと, সব মাল্টি-কোড-পয়েন্ট ক্যারেক্টারকে সিংগল কোড পয়েন্টে কম্পোজ করা যায় না। সেই কেসগুলোতে রুবির স্ট্রিং মেথড খারাপ behave করে:
s = "\u01B5\u0327\u0308" # => "Ƶ̧̈", একটি un-composable ক্যারেক্টার
s.unicode_normalize(:nfc).size # => 3, যদিও শুধু একটা ক্যারেক্টার আছে
সিকিউরিটি এবং DB কম্প্যাটিবিলিটির জন্য NFKC ব্যবহার করুন
আপনি যদি সিকিউরিটি-রিলেটেড টেক্সট যেমন ইউজারনেমের সাথে কাজ করেন, বা মূলত আপনার ডাটাবেসের সাথে টেক্সট ভালোভাবে কাজ করানো চান, তবে NFKC সম্ভবত একটি ভালো চয়েস।
- এটি সম্ভাব্যভাবে সমসাময়িক ক্যারেক্টারকে তাদের কম্প্যাটিবিলিটি ক্যারেক্টারে কনভার্ট করে।
- তারপর এটি সকল ক্যারেক্টারকে সিংগল কোড পয়েন্টে কম্পোজ করে।
এটি কেন সিকিউরিটির জন্য উপযোগী তা বুঝতে, কল্পনা করুন আপনার কাছে "HenryIV" ইউজারনেমের একটি ইউজার আছে। একটি ম্যালিশিয়াস এক্টর এই ইউজারকে ইমপারসোনেট করার চেষ্টা করতে পারে একটি নতুন ইউজারনেম রেজিস্টার করে: "HenryⅣ"।
আমি জানি, সেগুলো একই দেখায়। এটাই পয়েন্ট। কিন্তু আসলে সেগুলো দুটি ভিন্ন স্ট্রিং। পুরনোটি ASCII ক্যারেক্টার "IV" ব্যবহার করে যখন নতুনটি রোমান নম্বর ৪-এর ইউনিকোড ক্যারেক্টার ব্যবহার করে: "Ⅳ"।
আপনি ইউনিকোড স্ট্রিংকে ইউনিক নেস বৈধ করার আগে NFKC ব্যবহার করে নর্মালাইজ করে এই ধরনের সমস্যা প্রতিরোধ করতে পারেন। এই কেসে, NFKC ইউনিকোড "\u2163"-কে ASCII লেটার "IV"-তে কনভার্ট করে।
a = "Henry\u2163"
b = "HenryIV"
a.unicode_normalize(:nfc) == b.unicode_normalize(:nfc) # => false, কারণ NFC গ্লিফ সংরক্ষণ করে
a.unicode_normalize(:nfkc) == b.unicode_normalize(:nfkc) # => true, কারণ NFKC উভয়কে ASCII "IV"-তে ইভ্যালুয়েট করে
বিচ্ছেদের কথা
এখন যেহেতু আমি এরা দেখেছি, আমি একটু আশ্চর্য যে ইউনিকোড নর্মালাইজেশন রুবি এবং রেলস কমিউনিটিতে একটি বড় টপিক নয়। আপনি আশা করতে পারেন এটি রেলস দ্বারা আপনার জন্য করা হবে, কিন্তু যতদূর আমি জানি তা নয়। এবং আপনার ইউজাররা যা ডেটা দিচ্ছে সেটি নর্মালাইজ না করার মানে হলো রুবির অনেক স্ট্রিং মেথড विश्वস্ত নয়।
আপনাদের মধ্যে কারো যদি কিছু জানেন যা আমি না জানি, তবে টুইটার @StarrHorne বা ইমেইল starr@honeybadger.io-তে যোগাযোগ করুন। ইউনিকোড একটি বড় টপিক এবং আমি ইতিমধ্যে প্রুফ করেছি যে আমি সব কিছু জানি না। :)
