

এই আর্টিকেলে আপনি রুবির pack এবং unpack মেথড সম্পর্কে শিখবেন!
কিন্তু এই মেথডগুলো কেন দরকার?
টেক্সটের সাথে কাজ করা বাইনারি ডেটার চেয়ে অনেক সহজ।
টেক্সটে আপনি ব্যবহার করতে পারেন:
- রেগুলার এক্সপ্রেশন
scanএবংmatchএর মতো মেথডgsub
কিন্তু যদি আপনি বাইনারি ডেটার সাথে কাজ করতে চান, তবে কিছু অতিরিক্ত কাজ করতে হয়। সেখানে Array#pack এবং String#unpack মেথডগুলো কাজে আসে।
আমি কিছু উদাহরণ দেখাবো, একটি সাধারণ স্ট্রিং দিয়ে শুরু করে তারপর আরও रोচক বিষয়গুলোর দিকে যাব।
স্ট্রিংকে ASCII মানে রূপান্তর
এটি স্ট্রিং-এর প্রতিটি ক্যারেক্টারকে ডেসিমেল ভ্যালুতে রূপান্তর করবে:
str = "AABBCC"
str.unpack("c*") # [65, 65, 66, 66, 67, 67]
unpack-এর জন্য "c*" আর্গুমেন্টটি লক্ষ্য করুন।
এটি একটি ফরম্যাট স্ট্রিং যা unpack-কে বলে ডেটার সাথে কী করবে। এখানে c মানে একটি ক্যারেক্টার নিয়ে সেটিকে ইন্টিজার ভ্যালুতে রূপান্তর করা (String#ord মেথডও একই কাজ করে)।
এস্টারিস্ক * শুধু বলে "ইনপুট ডেটার সব местоে এই ফরম্যাটটি রিপিট কর"।
হেক্সাডেসিমালকে স্ট্রিংয়ে রূপান্তর
pack মেথডের সাথে H ব্যবহার করলে হেক্স নম্বর থেকে স্ট্রিং রূপান্তর করা যায়।
উদাহরণ:
["414243"].pack("H*") # "ABC"
"ABC".unpack("H*") # ["414243"]
হেক্সাডেসিমালকে ইন্টিজারে রূপান্তর
এই ফরম্যাট স্ট্রিং ৪ বাইট ডেটা নিয়ে একটি ইন্টিজার রিটার্ন করে। একটি জিনিস লক্ষ্য করুন - এই বাইটগুলো "লিটেল-এন্ডিয়ান" ফরম্যাটে থাকে।
উদাহরণ:
"\xff\x00\x00\x00".unpack("l").first # 255
"\x90\xC0\xDD\x08".unpack("l").first # 148750480
এখানে first ব্যবহার করলাম কারণ unpack একটি অ্যারে রিটার্ন করে।
আনপ্যাক মেথড দিয়ে বাইনারি ফাইল পার্সিং
EXE, PNG বা GZIP এর মতো বাইনারি ফাইল কীভাবে পড়বেন?
যদি আপনি এই ফাইলগুলো সাধারণ টেক্সটের মত পড়েন, তবে যেন যাদুকরী ডেটা দেখবেন...
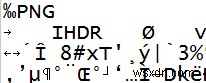
এটি যাদুকরী জিনিস নয়।
এই ফাইল ফরম্যাটের बहুতের জন্য একটি ডকুমেন্টেড স্ট্রাকচার রয়েছে এবং unpack মেথডটি হলো সেই ডেটা পড়ে সেটিকে ব্যবহারযোগ্য কিছুর রূপে রূপান্তর করার উপায়।
এখানে একটি উদাহরণ:
binary_data = "\x05\x00\x68\x65\x6c\x6c\x6f"
length, message = binary_data.unpack("Sa*") # [5, "hello"]
এই উদাহরণে, বাইনারি ডেটা (হেক্সাডেসিমেলে প্রকাশিত, যা ১ এবং ০ এর চেয়ে অনেক বেশি কম্প্যাক্ট) একটি দুই-বাইট (১৬ বিট) লেন্থ ফিল্ড ধারণ করে যা পরের স্ট্রিং-এর দৈর্ঘ্য বোঝায়। তারপর স্ট্রিংটি নিজেই থাকে।
বাইনারি ফাইল এবং বাইনারি নেটওয়ার্ক প্রোটোকলে "লেন্থ" ফিল্ড থাকা খুব সাধারণ।
এটি পার্সারকে সঠিকভাবে বলে দেয় কত বাইট পড়তে হবে।
হ্যাঁ, আমি জানি এই উদাহরণে আমি লেন্থ এবং ডেটা একসাথে পড়লাম, সেটি শুধু সহজ রাখার জন্য।
BinData জেম ব্যবহার করা
bindata জেমও রয়েছে, যা বাইনারি স্ট্রাকচার পার্স করতে সাহায্য করার জন্য তৈরি।
এখানে একটি উদাহরণ:
class BinaryString < BinData::Record
  endian :little
  uint16 :len
  string :name, :read_length => :len
end
read_length প্যারামিটারটি লক্ষ্য করুন। এটি bindata-কে বলে দিচ্ছে যে লেন্ঠটি ফিল্ড থেকে বের করবে, যা আপনার অনেক কাজ বাঁচাবে 🙂
তাই যেকোনো বাইনারি ফরম্যাটের জন্য পার্সার লিখতে চাইলে এই ধাপগুলো অনুসরণ করুন:
- সেই ফরম্যাটের স্পেসিফিকেশন খুঁজুন (যদি পাবলিক না হয় তবে রিভার্স-ইঞ্জিনিয়ারিং করতে হবে, যা নিজে একটি বড় টপিক)
- ফাইলের প্রতিটি সেকশনের জন্য একটি
bindataক্লাস লিখুন (সাধারণত প্রথমে মেটাডেটার সাথে একটি হেডার সেকশন পাবেন, তারপর একাধিক ডেটা সেকশন) - ডেটা পড়ে আপনার ইচ্ছামতো প্রক্রিয়া করুন (উদাহরণস্বরূপ, PNG-এ ছবির রং পরিবর্তন করতে পারেন)
- সাফল্য!
যদি আপনি bindata-র সম্পূর্ণ উদাহরণ দেখতে চান তবে আমার GitHub-এ PNG পার্সার দেখুন।
Base64 এনকোডিং
"Base64" নামে একটি এনকোডিং টাইপ রয়েছে। আপনি URL-এ এটি আগে দেখতে পেতে পারেন।
এটি কিছু এই রকম দেখায়:
U2VuZCByZWluZm9yY2VtZW50cw==
শেষে ডবল ইকুয়াল সাইন সাধারণত Base64-এর पहचान, যদিও কিছু ইনপুটে ইকুয়াল সাইন থাকে না (এগুলো প্যাডিং হিসেবে ব্যবহৃত হয়)।
তো আমি কেন আপনাকে এটা বলছি...
স্বয়ংক্রিয়ভাবে একটি উপকারী জ্ঞান হওয়া ছাড়াও?
দरअসলে, pack মেথড ব্যবহার করে একটি স্ট্রিংকে Base64-এ রূপান্তর করা যায়।
এখানে দেখুন:
def encode64(bin)
  [bin].pack("m")
end
encode64 "abcd" # "YWJjZA==\n"
বাস্টান্ডার্ড লাইব্রেরির Base64 মডিউলে একই মেথডটি ব্যবহার করা হয়েছে।
সারাংশ
এই পোস্টে আপনি pack এবং unpack মেথড সম্পর্কে শিখেছেন, যা বাইনারি ডেটার সাথে কাজ করতে সাহায্য করে। এই মেথডগুলো ব্যবহার করে আপনি বাইনারি ফাইল পার্স করতে পারেন, স্ট্রিংকে ASCII মানে রূপান্তর করতে পারেন, এবং Base64 এনকোডিং করতে পারেন।
শেয়ার এবং সাবস্ক্রাইব করুন ভুলবেন না, যাতে এই রকম আরও ব্লগ পোস্ট উপভোগ করতে পারেন! 🙂
