

আমার পছন্দের ডেটা স্ট্রাকচারের মধ্যে একটি হলো হ্যাশ টেবিল, কারণ এটি সহজ এবং শক্তিশালী।
আপনি সম্ভবত এর আগে ব্যবহার করেছেন, কারণ কী-ভ্যালু জোড়া সংরক্ষণের জন্য এটি একটি দক্ষ পদ্ধতি।
হ্যাশ টেবিলের বাস্তবায়নের পেছনে কিছু আকর্ষণীয় কম্পিউটার সায়েন্স ধারণা রয়েছে যা অধ্যয়ন করার যোগ্য, এবং আজকের এই আর্টিকেলে আমরা সেটিই করব!
বালতি (Buckets) এবং হ্যাশ ফাংশন
হ্যাশ টেবিলের মৌলিক ধারণা হলো আমাদের একটি কী দ্বারা সূচিবद्ध ডেটাকে দক্ষতার সাথে (O(1)-এ) পুনরুদ্ধার করার সুবিধা দেওয়া।
হালনাগাদ হিসেবে, রুবি (Ruby)-এ হ্যাশ টেবিল ব্যবহার কেমন তা দেখুন:
prices = { apple: 0.50, ice_cream: 3, steak: 10 }
একটি হ্যাশ টেবিল বাস্তবায়ন করতে হলে আমাদের দুটি উপাদান দরকার:
- টেবিল এন্ট্রিগুলো সংরক্ষণের জন্য একটি জায়গা
- কী/ভ্যালু জোড়াগুলোকে এই ডেটা স্টোরের ভিতর একটি নির্দিষ্ট পজিশন (ইন্ডেক্স)-এ নির্ধারণ করার একটি পদ্ধতি
অন্য কথায়, আমাদের একটি অ্যারে এবং একটি হ্যাশ ফাংশন দরকার।
হ্যাশ ফাংশন হ্যাশ টেবিলের একটি গুরুত্বপূর্ণ উপাদান।
এই ফাংশনটি কীকে একটি ইন্ডেক্সে রূপান্তরিত করে যা সংশ্লিষ্ট মানটি লুকআপ বা আপডেট করতে ব্যবহৃত হয়।
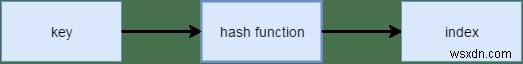
সাদা অ্যারে এবং হ্যাশ টেবিলের মধ্যে এইটিই বড় পার্থক্য।
একটি অ্যারেতে আপনি শুধু তাদের ইন্ডেক্সের মাধ্যমে মান অ্যাক্সেস করতে পারেন এবং ইন্ডেক্স শুধু সংখ্যা হতে পারে। কিন্তু হ্যাশ টেবিলে, আপনি কী-এর মাধ্যমে মান অ্যাক্সেস করেন এবং কীটি যেকোনো কিছু হতে পারে (স্ট্রিং, সিম্বল, ইন্টিজার...) যতক্ষণ না আপনি তার জন্য একটি হ্যাশ ফাংশন লিখতে পারেন।
আপনি স্ট্রিং-এর জন্য একটি সহজ হ্যাশ ফাংশন লিখতে পারেন সকল অক্ষরকে তাদের ASCII মানগুলোতে রূপান্তরিত করে এবং সেগুলো যোগ করে।
এখানে একটি উদাহরণ:
BUCKETS = 32
def hash(input)
  input.to_s.chars.inject(0) { |sum, ch| sum + ch.ord } % BUCKETS
end
এই মেথডে আমরা to_s ব্যবহার করি যেন আমরা একটি স্ট্রিং-এর সাথে কাজ করছি তা নিশ্চিত হয়।
এটি আমাদের 'undefined method' এরর থেকে বাঁচাবে। তারপর chars (স্ট্রিংকে এর অক্ষরগুলোর একটি Array-তে রূপান্তর করার জন্য) এবং inject (মানগুলো যোগ করার জন্য) এর সংমিশ্রণ ব্যবহার করা হয়েছে।
ব্লকের ভিতরে আমি ord মেথড ব্যবহার করি অক্ষরগুলোক তাদের অর্ডিনাল মানগুলিতে রূপান্তরিত করার জন্য।
শেষে, আমি মডুলো অপারেটর % ব্যবহার করি যেন ফলাফল মানটি অ্যারেতে ফিট হয়। আমরা এই অ্যারেতে প্রতিটি এন্ট্রিকে একটি 'বালতি' (bucket) বলি।
বালতি বিতরণ (Bucket Distribution)
আদর্শভাবে আমরা চাই আমাদের সকল বালতি সমানভাবে ভরা থাকে, যাতে কোনো মান পুনরুদ্ধার করার সময় সেরা পারফরম্যান্স পাওয়া যায়।
আমাদের হ্যাশ ফাংশনটি নিচের কোড দিয়ে টেস্ট করলে কী হয় তা দেখুন:
# BUCKETS আকারের একটি অ্যারে তৈরি করুন যেটির সব এলিমেন্ট 0
table = Array.new(BUCKETS) { 0 }
letters = Array('a'..'z')
10_000.times do
# একটি র্যান্ডম স্ট্রিং তৈরি করুন
input = Array.new(5) { letters.sample }.join
# হ্যাশ বিতরণ গণনা করুন
table[hash(input)] += 1
end
এটি নিচের ফলাফল দেয়:
[302, 290, 299, 309, 321, 293, 316, 301, 296, 306, 340, 321, 313, 304, 318, 296, 331, 306, 348, 330, 310, 313, 298, 292, 304, 315, 337, 325, 325, 331, 319, 291]
লাগছে আমাদের কীগুলো সমানভাবে বিতরণ হয়েছে...
...কিন্তু যদি আমরা বালতির সংখ্যা বাড়িয়ে দিই তবে কী হয়?
এই উদাহরণে আমি 128 বালতি ব্যবহার করেছি (পहলে 32 ছিল):
[22, 24, 33, 36, 41, 58, 61, 66, 97, 77, 88, 110, 89, 82, 123, 121, 119, 111, 147, 178, 136, 176, 144, 180, 190, 193, 185, 192, 223, 209, 208, 196, 215, 251, 233, 226, 231, 236, 219, 218, 227, 221, 206, 220, 208, 213, 201, 191, 182, 165, 188, 141, 160, 135, 130, 117, 139, 106, 121, 85, 70, 93, 74, 61, 57, 54, 40, 46, 32, 36, 30, 21, 25, 17, 14, 16, 16, 14, 8, 11, 5, 5, 1, 1, 2, 1, 3, 0, 1, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 1, 2, 0, 4, 3, 6, 0, 2, 9, 13, 11, 12, 14, 12, 23, 12, 22]
এটি ভালো বিতরণের মতো দেখাচ্ছে না!
কী হচ্ছে?
সমস্যা হলো আমাদের হ্যাশ ফাংশনটি যথেষ্ট ভালো নয় কারণ একই আকারের সকল স্ট্রিং একটি নির্দিষ্ট রেঞ্জে থাকে। তাই মাঝপথে অনেক খালি বালতি থাকে।
একটি ভালো হ্যাশ ফাংশন
আমাদের স্ট্রিংকে ইন্ডেক্সে রূপান্তরিত করার একটি ভালো পদ্ধতি দরকার। একটি সম্ভাব্য বাস্তবায়ন দেখুন:
BUCKETS = 256
def hash(input)
  input.to_s.each_char.inject(0) do |sum, ch|
    (sum << 8) ^ (ch.ord) ^ (sum >> 4)
  end % BUCKETS
end
এখানে বিট শিফটিং (Bit shifting) হচ্ছে (>> এবং << অপারেটর)। মানগুলো 'এক্সক্লুসিভ OR অপারেটর' (^) দিয়ে সংমিশ্রিত হচ্ছে।
এই বিট শিফটিং বিষয়গুলো মিশিয়ে দেবে, যা আমাদের উত্তম কী বিতরণ দেবে। সম্পূর্ণ নয়, কিন্তু আমাদের সহজ ASCII-ভিত্তিক ফাংশন থেকে ভালো 🙂
যদি আপনি একটি প্রোফেশনাল হ্যাশ ফাংশন চান তবে আপনি MurmurHash-কে লক্ষ্য করবেন, যা আমার মনে হয় রুবি ব্যবহার করে।
সংঘর্ষ (Collision) হ্যান্ডলিং
আমাদের এখনও একটি ব্যবহারযোগ্য হ্যাশ টেবিল নেই।
কেন?
হয়তো আপনি লক্ষ্য করেছেন যখন দুটি কী একই ইন্ডেক্সে হ্যাশ হয় তবে সেগুলো পুরনো মানটি ওভাররাইট (overwrite) করবে, এবং এটা ভালো না!
একে হ্যাশ সংঘর্ষ (hash collision) বলা হয় এবং এগুলো হ্যান্ডল করার কিছু কৌশল রয়েছে।
উদাহরণস্বরূপ:
- ডাবল হ্যাশিং (Double Hashing)
- লিনিয়ার প্রোবিং (Linear probing)
- সেপারেট চেইনিং (Separate chaining)
সেপারেট চেইনিং দেখি, যেখানে আমরা একটি লিঙ্কড লিস্ট ব্যবহার করি একটি নির্দিষ্ট 'বালতি'-র জন্য এন্ট্রিগুলো সংরক্ষণ করতে।
যেমন, যদি আমরা অনুমান করি :abc এবং :ccc একই ইন্ডেক্সে হ্যাশ হয়, তবে আমাদের হ্যাশ টেবিলটি এমন দেখাবে:
3: [:abc, 100] -> [:ccc, 200]
4: nil
5: [:yx, 50]
তারপর সঠিক কী খুঁজে বের করতে আমাদের লিনিয়ার সার্চ (linear search) করতে হবে।
এটি আমাদের পারফরম্যান্সে প্রভাব ফেলবে কারণ আমাদের লুকআপ টাইম ধীরে ধীরে O(n)-এর দিকে নেমে যেতে পারে, প্রত্যাশিত O(1)-এর বদলে।
যদি আপনি এই
O(something)নোটেশনটি নিয়ে পরিচিত নন, তাকে "বিগ-ও নোটেশন" (Big-O Notation) বলা হয়।
লিঙ্কড লিস্ট খুব গভীর হয়ে না যাওয়া এবং সেজন্য হ্যাশ টেবিলের পারফরম্যান্স অবনত না হওয়া নিশ্চিত করতে, আরও বড় সংখ্যক বালতি দিয়ে হ্যাশ টেবিলটি পুনর্নির্মাণ করা প্রয়োজন।
রুবি এটি আপনার জন্য স্বয়ংক্রিয়ভাবে করে দেয়, তবে জানা থাকা ভালো।
উপসংহার
এই আর্টিকেলের উদ্দেশ্য হলো আপনাকে হ্যাশ টেবিল বাস্তবায়ন করতে শেখানো নয়, বরং এটি কীভাবে কাজ করে সেটি বুঝতে সাহায্য করা, তাই আশা করি আপনি এটি আকর্ষণীয় পেয়েছেন!
ব্লগ চলতে থাকার জন্য এই পোস্টটি শেয়ার করতে ভুলবেন না 🙂
