

সম্পর্কিক ডেটা মডেল
C. F. Codd ১৯৭০ সালে সম্পর্কিক ডেটা মডেল পরিচয় দিয়েছিলেন। বর্তমানে এটি সবচেয়ে প্রচলিত ডেটা মডেল। এটি বিশ্বকে "পারস্পরিক সম্পর্কিত রিলেশন (বা টেবিল) সংগ্রহ" হিসেবে বর্ণনা করে। সম্পর্কিক ডেটা মডেল ডেটা টেবিল ব্যবহার করে যেগুলো এলিমেন্ট গ্রুপকে রিলেশনে সংগৃহিত করে। এই মডেল এই ধারণায় কাজ করে যে প্রতিটি টেবিল সেটআপে একটি প্রাইমারি কী বা আইডেন্টিফায়ার থাকবে। অন্যান্য টেবিল সেই আইডেন্টিফায়ার ব্যবহার করে "রিলেশনাল" ডেটা লিঙ্ক এবং রেজাল্ট প্রদান করে।
আজকাল অনেক কমার্শিয়াল RDBMS আছে: Oracle, IBM DB2, Microsoft SQL Server। ফ্রি ও ওপেন-সোর্স RDBMS: MySQL, mSQL (mini-SQL), embedded Java DB (Apache Derby)। ডাটাবেস অ্যাডমিনিস্ট্রেটর SQL ব্যবহার করে সম্পর্কিক ডাটাবেস থেকে ডেটা এলিমেন্ট রিট্রিভ করে।
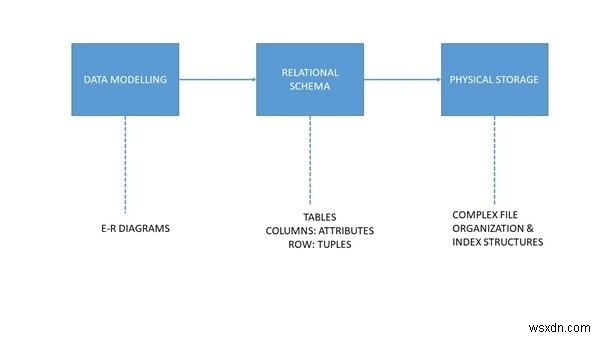
উল্লেখ্য, প্রাইমারি কী সম্পর্কিক ডেটা মডেল তৈরি ও ব্যবহারের মৌলিক টুল। এটি ডেটা সেটের প্রতিটি মেম্বারের জন্য ইউনিক হতে হবে এবং সব মেম্বারের জন্য পপুলেটেড থাকতে হবে। ইনকনসিস্টেন্সি ডেটা রিট্রিভালে সমস্যা সৃষ্টি করে। অন্যান্য সমস্যা: অতিরিক্ত ডেটা ডুপ্লিকেশন, ত্রুটিপূর্ণ বা আংশিক ডেটা, বা টেবিলের মধ্যে অপ্রoper লিঙ্ক। রুটিন ডাটাবেস অ্যাডমিনিস্ট্রেশনের বড় অংশ হলো সব ডেটা সেট যাচাই করা যে সেগুলো কনসিস্টেন্টলি পপুলেটেড এবং SQL বা অন্য রিট্রিভাল মেথডে ভালো রেসপন্স দেবে।
উদাহরণ: একটি সাধারণ ডাটাবেস সারি একটি টাপল (tuple) রিপ্রেজেন্ট করে, যা একটি ইনস্ট্যান্স বা ভার্চুয়াল অবজেক্টের চারপাশে ঘুরে এমন ডেটা সেট, যার প্রাইমারি কী ইউনিক আইডেন্টিফায়ার। ডেটা টেবিলের কলাম নাম একটি অ্যাট্রিবিউটের সাথে জড়িত, যা ডেটা সেটের সব অংশের জন্য একটি আইডেন্টিফায়ার বা বৈশিষ্ট্য। এই কনভেনশনগুলো ডাটাবেস অ্যাডমিন ও ডিজাইনারের জন্য স্ট্যান্ডার্ড প্রদান করে।
ডাটাবেস ডিজাইনের উদ্দেশ্য
- ডেটা রিডান্ডেন্সি দূর করা: একই ডেটা একাধিক জায়গায় সংরক্ষিত নয়। ডুপ্লিকেট ডেটা স্টোরেজ বর্জন করে এবং ইনকনসিস্টেন্সি থেকে বাঁচায়।
- ডেটা ইন্টিগ্রিটি ও নির্ভুলতা নিশ্চিত করা: ডেটার পুরো লাইফসাইকেলে নির্ভুলতা ও কনসিস্টেন্সি রক্ষা, যা ডিজাইন, ইমপ্লিমেন্টেশন এবং ব্যবহারে অত্যন্ত গুরুত্বপূর্ণ।
সম্পর্কিক মডেল নিম্নলিখিতের ভিত্তি প্রদান করেছে:
- ডেটা/রিলেশনশিপ/কনস্ট্রেইন্ট থিওরি पर গবেষণা
- অনেক ডাটাবেস ডিজাইন মেথডলজি
- স্ট্যান্ডার্ড ডাটাবেস অ্যাক্সেস ল্যাঙ্গুয়েজ SQL
- প্রায় সব আধুনিক কমার্শিয়াল ডাটাবেস ম্যানেজমেন্ট সিস্টেম
সম্পর্কিক ডাটাবেস SQL-এর উন্নতির সাথে সাথেไป। SQL-এর সহজতা (নবীনও অল্প সময়ে বেসিক কোয়েরি শিখতে পারে) সম্পর্কিক মডেলের জনপ্রিয়তার বড় কারণ।
নিচের দুটি টেবিল প্রোডাক্ট কোড ফিল্ড দিয়ে একে অপরের সাথে রিলেটেড। যেকোনো দুটি টেবিল একটি কমন ফিল্ড তৈরি করে রিলেট করা যায়।
টেবিল ১
| Product_code | Description | Price |
|---|---|---|
| A416 | Colour Pen | ₹ 25.00 |
| C923 | Pencil box | ₹ 45.00 |
টেবিল ২
| Invoice_code | Invoice_line | Product_code | Quantity |
|---|---|---|---|
| 3804 | 1 | A416 | 15 |
| 3804 | 2 | C923 | 24 |
RDM-এর চারটি ধাপ
- Relations and attributes: টেবিল এবং অ্যাট্রিবিউট চিহ্নিত করা। টেবিল = এন্টিটি, অ্যাট্রিবিউট = প্রোপার্টি।
- Primary keys: রেকর্ড ইউনিকভাবে শনাক্তকারী অ্যাট্রিবিউট বা সেট প্রাইমারি কী হিসেবে বেছে নেওয়া।
- Relationships: ফরেন কী দিয়ে টেবিলের মধ্যে সম্পর্ক স্থাপন। ফরেন কী = অন্য টেবিলের প্রাইমারি কী। সম্পর্কের ধরন: One-to-one, One-to-many, Many-to-many।
- Normalization: ডাটাবেস স্ট্রাকচার অপ্টিমাইজ করা। রিডান্ডেন্সি এবং কনফিউশন এড়াতে ডিজাইন সিম্পলিফাই। নরমাল ফর্ম: 1NF, 2NF, 3NF, BCNF, 5NF।
নियम প্রয়োগ করে টেবিল ক্রমাগত উচ্চতর নরমাল ফর্মে নরমালাইজ করা হয়। প্রতিটি উচ্চতর ডিগ্রিতে ডিজাইন দক্ষতা বাড়ে।
সম্পর্কিক ডাটাবেসের সুবিধা
প্রধান সুবিধা: ডেটা সহজে ক্যাটাগরাইজ, স্টোর, কোয়েরি ও ফিল্টার করে নির্দিষ্ট তথ্য এক্সট্র্যাক্ট করা যায়। সহজে এক্সটেন্ড করা যায় এবং ফিজিক্যাল অর্গানাইজেশনের ওপর নির্ভরশীল নয়। নতুন ডেটা ক্যাটাগরি যোগ করলে এক্সিস্টিং অ্যাপ্লিকেশন মডিফাই করতে হয় না।
অন্যান্য সুবিধা
- নির্ভুল (Accurate): ডেটা একবার সংরক্ষিত, ডিডুপ্লিকেশন নেই।
- ফ্লেক্সিবল (Flexible): জটিল কোয়েরি সহজে করা যায়।
- কোলাবোরেটিভ (Collaborative): একাধিক ব্যবহারকারী একই ডাটাবেস অ্যাক্সেস করতে পারে।
- বিশ্বস্ত (Trusted): মেচিউর এবং ভালোভাবে বোঝা মডেল।
- নিরাপদ (Secure): RDBMS-এ টেবিলের ডেটা নির্দিষ্ট ব্যবহারকারীর জন্য সীমাবদ্ধ করা যায়।
