

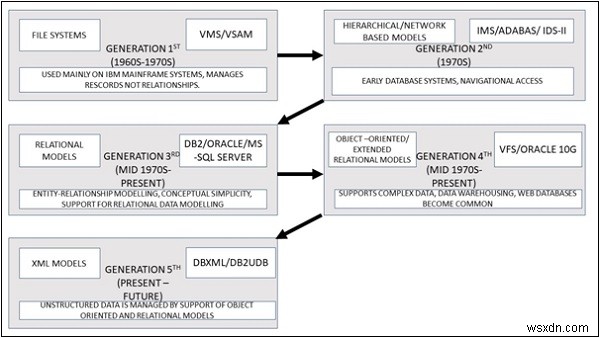
একটি ডাটাবেস মডেল ডাটাবেসের লজিক্যাল স্ট্রাকচার নির্ধারণ করে এবং ডেটা কীভাবে সংরক্ষণ, সংগঠিত ও ম্যানিপুলেট হবে তা মৌলিক ভিত্তিতে নির্ধারণ করে। ডাটাবেস ডিজাইনের আগে ডেটা সংরক্ষণের একমাত্র উপায় ছিল ফাইল স্টোরেজ, যা জটিলতা বড়ায় কারণ প্রোগ্রামারদের ডেটা এক্সট্র্যাক্ট করতে বহু পরিশ্রম করতে হতো এবং তাদের প্রোগ্রামকে জটিল পারসিং ও রিলেটিং করতে হতো।
Perl-এর মতো ভাষা পাওয়ারফুল রেগুলার এক্সপ্রেশন দিয়ে টেক্সট প্রসেসিং সহজ করে, কিন্তু ফাইল থেকে ডেটা অ্যাক্সেস এখনও জটিল। ডেটা অ্যাক্সেসের কোনো স্ট্যান্ডার্ড নেই, তাই সিস্টেমগুলো এরর-প্রোন, ডেভেলপমেন্টে ধীর এবং মেইনটেইন করতে কঠিন। ডেটা রিডান্ডেন্সি (অনাবশ্যক ডুপ্লিকেশন) এবং খারাপ ডেটা ইন্টিগ্রিটি (সকল লোকেশনে ডেটা আপডেট না হওয়া) সমস্যা রয়েছে।
এই সমস্যাগুলো সমাধান করতে Database Management Systems (DBMS) ডেভেলপ করা হয়েছে, যা ডেটা অ্যাক্সেস ও আপডেটের একটি স্ট্যান্ডার্ড এবং বিশ্বস্ত উপায় প্রদান করে। অ্যাপ্লিকেশন এবং ডেটার মাঝপথে একটি ইন্টারমিডিয়ারি লেয়ার থাকে, যাতে প্রোগ্রামার অ্যাপ্লিকেশন ডেভেলপমেন্টে ফোকাস করতে পারে, ডেটা অ্যাক্সেস ইস্যুর চিন্তা ছাড়া।
অতএব, ডাটাবেস মডেলকে একটি লজিক্যাল মডেল হিসেবে ডিফাইন করা যায় যা ডেটা কীভাবে রিপ্রেজেন্ট করা হয় সে চিন্তা করে। ডাটাবেস ডিজাইনাররা হাই-লেভেল কনসেপচুয়াল লেভেলে ফোকাস করে, ফিজিক্যাল স্টোরেজের চিন্তা ছাড়া, যা রিয়েল-ওয়ার্ল্ড সমস্যা এবং টেকনিক্যাল ইমপ্লিমেন্টেশনের গ্যাপ কমায়।
একটি ডেটা মডেল ডেটা এলিমেন্ট সংগঠিত করতে এবং ডেটা এলিমেন্টের মধ্যে সম্পর্ক স্ট্যান্ডার্ডাইজ করতে ব্যবহৃত হয়। যেহেতু ডেটা এলিমেন্ট রিয়েল লাইফ মানুষ, জায়গা, জিনিস এবং তাদের মাঝপথের ইভেন্ট ডকুমেন্ট করে যা রিয়েলিটি রিপ্রেজেন্ট করে (যেমন: একটি বিল্ডিংয়ে অনেক উইন্ডো, একটি কুকুরের দুটি চোখ)। একটি মডেল ডেটা স্ট্রাকচার করতে সাহায্য করে এবং সাথে সাথে ডেটার ওপর করা যাবে এমন অপারেশন সেটও ডিফাইন করে। একটি DBMS একাধিক মডেল প্রদান করতে পারে। সেরা স্ট্রাকচার অ্যাপ্লিকেশনের ডেটার প্রাকৃতিক সংগঠন এবং অ্যাপ্লিকেশনের প্রয়োজনীয়তা ওপর নির্ভর করে। কিছু ফ্যাক্টর: ট্রানজ্যাকশন রেট (স্পিড), विश्वसनিয়তা, মেইনটেইনযোগ্যতা, স্কেলেবিলিটি, খরচ।
ফ্ল্যাট (অথবা টেবিল) মডেল
সবচেয়ে প্রথাগত এবং সহজ ডেটা মডেল, যাতে একটি একক, টু-ডাইমেনশনাল অ্যারে থাকে। একই কলামের সব মেম্বার সমান ভ্যালু রিপ্রেজেন্ট করে এবং একই সারির সব মেম্বার পারস্পরিকভাবে রিলেটেড। উদাহরণ: সিস্টেম সিকিউরিটি ডাটাবেসে নাম এবং পাসওয়ার্ডের জন্য কলাম। প্রতিটি সারিতে নির্দিষ্ট ব্যবহারকারীর নির্দিষ্ট পাসওয়ার্ড থাকে। টেবিলের কলামে টাইপ থাকে যা ক্যারাক্টার ডেটা, ডেট/টাইম, ইন্টিজার বা ফ্লোটিং-পয়েন্ট নম্বর ডিফাইন করে।
এখন আমরা বলতে পারি একটি ফ্ল্যাট ফাইল ডাটাবেস হলো একটি ডাটাবেস যা একটি সাধারণ অস্ট্রাকচারড ফাইল (flat file) সংরক্ষণ করে। ফাইলটি সম্পূর্ণরূপে কম্পিউটার মেমরিতে লোড হয় যাতে ডেটা স্ট্রাকচার এবং ম্যানিপুলেশন সহজ হয়। ডাটাবেস অপারেশন শেষ হলে ফাইল কম্পিউটার সিস্টেম থেকে হস্টের ফাইল সিস্টেমে ট্রান্সফার হয়। এই স্টোরেজ মোডকে "flat" বলা হয় কারণ এতে কোনো ইন্ডেক্সিং স্ট্রাকচার নেই এবং রেকর্ডের মধ্যে সাধারণত কোনো স্ট্রাকচারাল রিলেশনশিপ নেই।
এই ফ্ল্যাট মডেল ছোট, সহজ ডাটাবেসের জন্য সেরা। ডেটার আকার বড় হলে মেমরি অ্যাক্সেস কঠিন হয় এবং আরও সফিস্টিকেটেড ডাটাবেস দরকার। হাতের লিখা নাম, কন্টাক্ট নম্বর, ঠিকানা, সিটি একটি ফ্ল্যাট ফাইল ডাটাবেস। একই তথ্য স্প্রেডশিটে থাকলে آنলাইন উন্নত সার্চ ক্যাপাবিলিটি দেয়। ফ্ল্যাট ফাইল ডাটাবেস মডেল দিয়ে ডেটা ট্রান্সফারও করা যায়।
উদাহরণ ডাটাবেস
নিচের উদাহরণ ফ্ল্যাট-ফাইল ডাটাবেসের মৌলিক এলিমেন্ট দেখাচ্ছে। এটি কলাম ও সারির সিরিজ যা টেবিলে সংগঠিত।
কলামগুলো: নাম (দ্বিতীয় কলাম), টিম (তৃতীয় কলাম), এবং যুনিক আইডি (প্রথম কলাম)।
নিচের ডেটা রিপ্রেজেন্টেশন ফ্ল্যাট-ফাইল ডাটাবেসের জন্য স্ট্যান্ডার্ড:
| ID | NAME | TEAM |
|---|---|---|
| 101 | Abhinav | Blues |
| 102 | Aditya | Blues |
| 103 | Anjali | Pink |
| 104 | Bhavna | Pink |
| 105 | Charu | Pink |
| 106 | Divy | Blues |
| 107 | Disha | Pink |
| 108 | Eashan | Blues |
| 109 | Gauri | Pink |
