

এই নিবন্ধে আমরা পাইথনে উপলব্ধ lxml মডিউল ব্যবহার করে ওয়েব স্ক্র্যাপিং কৌশল নিয়ে আলোচনা করব।
ওয়েব স্ক্র্যাপিং কী?
ওয়েব স্ক্র্যাপিং হলো একটি ক্রলার/স্ক্যানারের সাহায্যে ওয়েবসাইট থেকে ডেটা প্রাপ্ত করার পদ্ধতি। এটি সেই ওয়েব পেজ থেকে ডেটা বের করার জন্য কাজে আসে যা API ফাংশনালিটি অফার করে না। পাইথনে ওয়েব স্ক্র্যাপিং Beautiful Soup, Scrapy এবং lxml মতো বিভিন্ন মডিউল দিয়ে করা যায়।
এখানে আমরা lxml মডিউল ব্যবহার করে ওয়েব স্ক্র্যাপিং নিয়ে আলোচনা করব।
সেজন্য, প্রথমে lxml ইনস্টল করতে হবে।
টার্মিনাল বা কমান্ড প্রম্পটে টাইপ করুন:
>>> pip install lxml
এখানে ডেটা অ্যাক্সেস করার জন্য xpath ব্যবহার করা হয়েছে।
এই নিবন্ধে, আমরা স্টিম (steam) নামে একটি ওয়েবসাইট থেকে বিভিন্ন গেমের তথ্য বের করব।
https://store.steampowered.com/genre/Free%20to%20Play/
পেজে, আমরা জনপ্রিয় নতুন রিলিজ সেকশন থেকে তথ্য বের করার চেষ্টা করব। এখানে আমরা নাম, দাম, সংশ্লিষ্ট ট্যাগ এবং টার্গেট প্ল্যাটফর্ম বের করব।
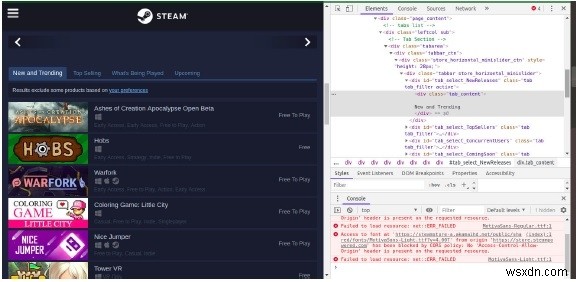
ক্রোমের ইনস্পেক্ট এলিমেন্ট ফিচার ব্যবহার করে নতুন রিলিজ ট্যাবের HTML কোড দেখুন। এখানে থেকে জানতে পারবেন কোন ট্যাগে প্রয়োজনীয় তথ্য সংরক্ষিত।
এই ওয়েবসাইটে; প্রতিটি লিস্ট এলিমেন্ট একটি div ট্যাগে id=tab_content হিসেবে এনক্যাপসুলেট করা আছে, যা আবার একটি div ট্যাগে id=tab_select_newreleases হিসেবে এনক্যাপসুলেট করা আছে।
a div tag id=tab_select_newreleases
বাস্তবায়ন
এখন বাস্তবায়নটি দেখা যাক।
