

লেখক: অ্যালেক্স ন্যাডালিন
ওয়েব অ্যাপ্লিকেশন সিকিউরিটির পরিচয়
 _ফটো: লিয়াম টাকার আনসপ্ল্যাশে থেকে_
চলুন ওয়েব অ্যাপ্লিকেশন সিকিউরিটির এই সিরিজটি শুরু করি ব্রাউজার কী করে এবং কীভাবে করে সেটি ব্যাখ্যা করে। যেহেতু আপনার অধিকাংশ কাস্টমার ব্রাউজার 통해 আপনার ওয়েব অ্যাপ্লিকেশনের সাথে ইন্টারঅ্যাক্ট করবে, তাই এই চমৎকার প্রোগ্রামগুলির মৌলিক বিষয়গুলো বুঝতে অপরিহার্য।
ব্রাউজার হল একটি রেন্ডারিং ইঞ্জিন। এর কাজ হল একটি ওয়েব পেজ ডাউনলোড করা এবং সেটিকে এমনভাবে রেন্ডার করা যা একজন মানুষ বুঝতে পারে।
এটি почти-অপরাধীভাবে সরলীকরণ হলেও, আমাদের জানার জন্য এটিই যথেষ্ট।
- ব্যবহারকারী ব্রাউজারের অ্যাড্রেস বারে একটি ঠিকানা লিখে।
- ব্রাউজার সেই URL-এ मौजूद "ডকুমেন্ট" ডাউনলোড করে এবং রেন্ডার করে।
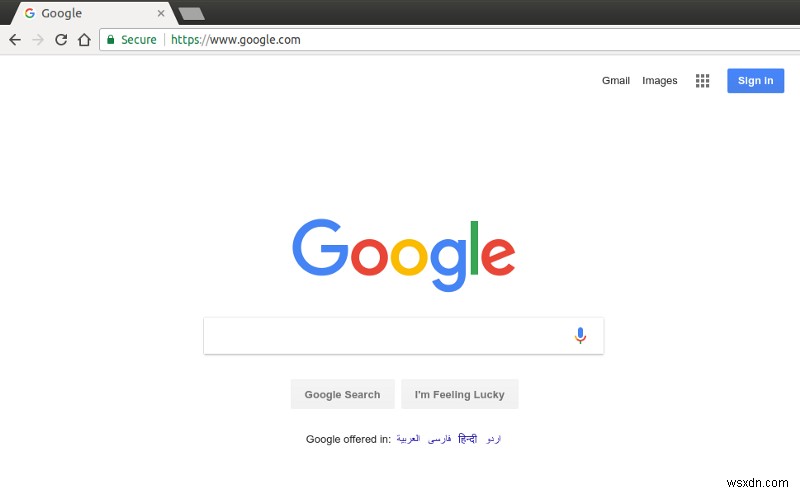
আপনি ক্রোম, ফায়ারফক্স, এজ বা সাফারি মতো জনপ্রিয় ব্রাউজারগুলোর সাথে কাজ করার অভ্যাসী হতে পারেন, কিন্তু এর মানে এটি নয় যে অন্য ব্রাউজারগুলো নেই।
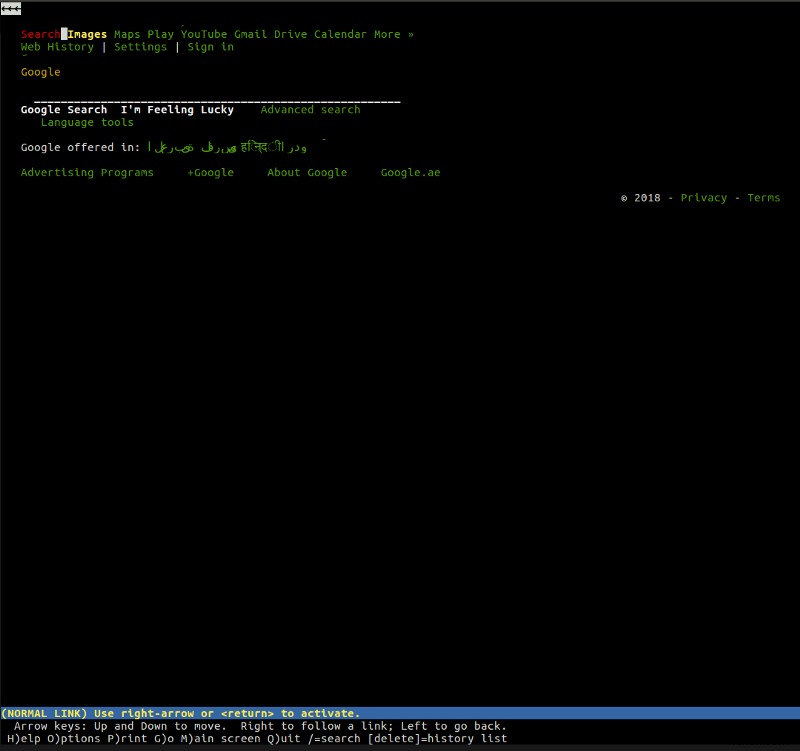
উদাহরণস্বরূপ, lynx একটি হালকা, টেক্সট-ভিত্তিক ব্রাউজার যা আপনার কমান্ড লাইন থেকে কাজ করে। লিক্সের হৃদয়ে অন্যান্য সব "মেনস্ট্রিম" ব্রাউজারের মতো একই সঠিক নীতিগুলো রয়েছে। একটি ব্যবহারকারী একটি ওয়েব ঠিকানা (URL) লিখে, ব্রাউজার ডকুমেন্টটি ফেচ করে এবং রেন্ডার করে — একমাত্র পার্থক্য হল লিক্স ভিজ্যুয়াল রেন্ডারিং ইঞ্জিন ব্যবহার না করে বরং একটি টেক্সট-ভিত্তিক ইন্টারফেস ব্যবহার করে, যা গুগল এর মতো ওয়েবসাইটগুলিকে এই রকম দেখায়:
ব্রাউজার কী করে সেটি আমরা বড় আকারে বুঝতে পেরেছি, তবে চলুন এই বুদ্ধিমান অ্যাপ্লিকেশনগুলো আমাদের জন্য কী কী ধাপ নেয় সেটি নিকট থেকে দেখি।
ব্রাউজার কী করে?
সংক্ষেপে, একটি ব্রাউজারের কাজ মূলত নিম্নলিখিত:
- ডিএনএস রেজোলিউশন
- এইচটিটিপি এক্সচেঞ্জ
- রেন্ডারিং
- ধারাবাহিকতা বজায় রাখা
ডিএনএস রেজোলিউশন
এই প্রক্রিয়াটি নিশ্চিত করে যে ব্যবহারকারী একবার URL লিখলে ব্রাউজার বুঝতে পারে যে কোন সার্ভারের সাথে সংযোগ করতে হবে। ব্রাউজার একটি ডিএনএস সার্ভারের সাথে যোগাযোগ করে জানতে চায় যে google.com কে 216.58.207.110-এ অনুবাদ করা হয়েছে, একটি আইপি অ্যাড্রেস जिससे ব্রাউজার সংযোগ করতে পারে।
এইচটিটিপি এক্সচেঞ্জ
ব্রাউজার একবার যেই সার্ভার আমাদের রিকোয়েস্ট সার্ভ করবে সেটি শনাক্ত করলে, সেটির সাথে একটি TCP সংযোগ শুরু করে এবং HTTP এক্সচেঞ্জ আরম্ভ করে। এটি ব্রাউজারের জন্য সার্ভারের সাথে যোগাযোগ করার একটি পদ্ধতি যে সেটি কী চায়, এবং সার্ভারের জন্য উত্তর দেওয়ার পদ্ধতি।
HTTP হল ওয়েবে যোগাযোগের জন্য সবচেয়ে জনপ্রিয় প্রোটোকলের নাম, এবং ব্রাউজারগুলো অধিকাংশ ক্ষেত্রে সার্ভারের সাথে HTTP 통해 কথা বলে। একটি HTTP এক্সচেঞ্জে ক্লায়েন্ট (আমাদের ব্রাউজার) একটি রিকোয়েস্ট পাঠায়, এবং সার্ভার একটি রেসপন্স দিয়ে উত্তর দেয়।
উদাহরণস্বরূপ, ব্রাউজার সফলভাবে google.com-এর পেছনের সার্ভারের সাথে সংযোগ সাধন করলে, এটি নিচের মত একটি রিকোয়েস্ট পাঠাবে:
GET / HTTP/1.1
Host: google.com
Accept: */*
রিকোয়েস্টটি লাইন বাই লাইন ভাঙে দেখি:
GET / HTTP/1.1: এই প্রথম লাইনে ব্রাউজার সার্ভারকে/লোকেশনে থাকা ডকুমেন্টটি রিট্রিভ করতে বলে, এবং বলে যে বাকি রিকোয়েস্ট HTTP/1.1 প্রোটোকল অনুসরণ করবে (এটি1.0বা2ও হতে পারে)Host: google.com: এটি HTTP/1.1-এ একমাত্র বাধ্যতামূলক HTTP হেডার। যেহেতু সার্ভার একাধিক ডোমেইন সার্ভ করতে পারে (google.com,google.co.uk, ইত্যাদি), তাই ক্লায়েন্ট এখানে উল্লেখ করে যে রিকোয়েস্টটি সেটি নির্দিষ্ট হোস্টের জন্যAccept: */*: একটি অপশনাল হেডার, যেখানে ব্রাউজার সার্ভাকে বলে যে এটি যেকোনো ধরনের রেসপন্স গ্রহণ করবে। সার্ভারের पास একটি রিসোর্স JSON, XML বা HTML ফরম্যাটে থাকতে পারে, তাই সেটি যেকোনো ফরম্যাট বেছে নিতে পারে
ব্রাউজার, যielt ক্লায়েন্ট হিসেবে কাজ করে, একবার রিকোয়েস্ট শেষ করলে, সার্ভারের পালা উত্তর দেওয়ার। রেসপন্সটি দেখতে এভাবেঃ
HTTP/1.1 200 OK
Cache-Control: private, max-age=0
Content-Type: text/html; charset=ISO-8859-1
Server: gws
X-XSS-Protection: 1; mode=block
X-Frame-Options: SAMEORIGIN
Set-Cookie: NID=1234; expires=Fri, 18-Jan-2019 18:25:04 GMT; path=/; domain=.google.com; HttpOnly

<!doctype html><html">......</html>
উফ, হজম করার জন্য অনেক তথ্য! সার্ভার আমাদের জানায় যে রিকোয়েস্টটি সফল (200 OK) এবং রেসপন্সের সাথে কিছু হেডার যোগ করে, উদাহরণস্বরূপ এটি বিজ্ঞাপন দেয় যে কোন সার্ভার আমাদের রিকোয়েস্ট প্রসেস করেছে (Server: gws), এই রেসপন্সের X-XSS-Protection পলিসি কী, ইত্যাদি।
এখন, আপনাকে রেসপন্সের প্রতিটি লাইন বুঝতে হবে না। আমরা এই সিরিজে পরে HTTP প্রোটোকল, এর হেডারগুলো, ইত্যাদি কভার করব।
ফিলহাল, আপনাকে শুধু এটি বুঝতে হবে যে ক্লায়েন্ট এবং সার্ভার তথ্য আদান-প্রদান করছেন এবং সেটি HTTP 통해 হচ্ছে।
রেন্ডারিং
শেষে, কিন্তু কম গুরুত্বপূর্ণ নয়, রেন্ডারিং প্রক্রিয়া। একটি ব্রাউজার কতটা ভালো হতো যদি সেটি ব্যবহারকারীকে শুধু অদ্ভুত ক্যারেক্টারের একটি তালিকা দেখাত?
<!doctype html><html">......</html>
রেসপন্সের বডি-তে, সার্ভার Content-Type হেডার অনুযায়ী রেসপন্সের রিপ্রেজেন্টেশন অন্তর্ভুক্ত করে। আমাদের কেসে, কন্টেন্ট টাইপ ছিল text/html, তাই আমরা রেসপন্সে HTML মার্কআপ আশা করি — যা বডিতে সঠিকভাবে পাওয়া যায়।
এই জায়গায় ব্রাউজার আসল দক্ষতা দেখায়। এটি HTML পার্স করে, মার্কআপে অন্তর্ভুক্ত অতিরিক্ত রিসোর্সগুলো লোড করে (উদাহরণস্বরূপ, জাভাস্ক্রিপ্ট ফাইল বা CSS ডকুমেন্ট ফেচ করতে পারে) এবং সেগুলো যত দ্রুত সম্ভব ব্যবহারকারীর সামনে উপস্থাপন করে।
একবার আবার, ফলাফলটি কিছু যা সাধারণ মানুষ বুঝতে পারে।
ব্রাউজারের অ্যাড্রেস বারে এন্টার চাপলে কী কী ঘটে তার আরও বিস্তারিত সংস্করণের জন্য আমি "What happens when…" পড়ার পরামর্শ দেব, যা প্রক্রিয়ার মেকানিক্স ব্যাখ্যা করার একটি ব্যাপক প্রচেষ্টা।
যেহেতু এটি সিকিউরিটি-ফোকাসড একটি সিরিজ, আমি আমরা যা শিখলাম তার ওপর একটি হিন্ট দিচ্ছি: অ্যাটাকাররা সহজেই HTTP এক্সচেঞ্জ এবং রেন্ডারিং অংশের ভালনারেবিলিটি থেকে জীবিকা চালান। ভালনারেবিলিটি এবং ম্যালিশাস ব্যবহারকারীরা অন্য জায়গাও থাকতে পারে, কিন্তু সেই লেভেলগুলোর ওপর ভালো সিকিউরিটি অ্যাপ্রোচ আপনার সিকিউরিটি পজিশন উন্নত করতে বড় বাড়ানো দিতে পারে।
ভেন্ডররা
সর্বाधিক জনপ্রিয় ৪টি ব্রাউজার বিভিন্ন ভেন্ডরের:
- গুগলের ক্রোম
- মজিলার ফায়ারফক্স
- অ্যাপলের সাফারি
- মাইক্রোসফটের এজ
এদের বাজার দখল বাড়াতে একে অপর সাথে লড়াই ছাড়া, ভেন্ডররা ওয়েব স্ট্যান্ডার্ড উন্নত করতে একে অপর সাথে জড়িত হন, যা ব্রাউজারগুলির জন্য一种 "ন্যূনতম প্রয়োজনীয়তা"।
W3C স্ট্যান্ডার্ড ডেভেলপমেন্টের পেছনের সংগঠন, কিন্তু ব্রাউজারগুলোর নিজস্ব ফিচার ডেভেলপ করা অস্বাভাবিক নয় যা পরবর্তীতে ওয়েব স্ট্যান্ডার্ড হয়ে যায়, এবং সিকিউরিটি তৎপরতা সেটি ব্যতিক্রম নয়।
উদাহরণস্বরূপ, ক্রোম ৫১ SameSite কুকি ফিচারটি আনার মাধ্যমে ওয়েব অ্যাপ্লিকেশনগুলিকে CSRF নামে একটি নির্দিষ্ট ধরনের ভালনারেবিলিটি থেকে মুক্তি পেতে সাহায্য করেছিল (এর সাথে পরে আলোচনা হবে)। অন্য ভেন্ডররা এটি ভালো আইডিয়া মনে করে অনুসরণ করেছিল, ফলে SameSite একটি ওয়েব স্ট্যান্ডার্ড হয়ে উঠেছে: এখনো সাফারি একমাত্র বড় ব্রাউজার যেটি SameSite কুকি সাপোর্ট করে না।
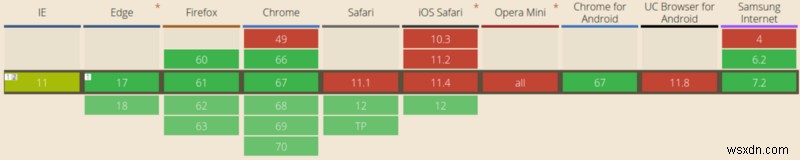
এটি আমাদের ২টি কথা বলে:
- সাফারি তাদের ব্যবহারকারীদের সিকিউরিটির পর্যাপ্ত যত্ন নেয় না (মজাক করছি: SameSite কুকি সাফারি ১২-এ আসবে, যা আপনি এই আর্টিকেল পড়ার সময় কি রিলিজ হয়ে থাকতে পারে)
- একটি ব্রাউজারে ভালনারেবিলিটি প্যাচ করা মানে আপনার সব ব্যবহারকারীরা নিরাপদ হচ্ছে না
প্রথম পয়েন্টটি সাফারির ওপর একটি কটাক্ষ (যেমন বললাম, মজাক!), দ্বিতীয় পয়েন্টটি খুব গুরুত্বপূর্ণ। ওয়েব অ্যাপ্লিকেশন ডেভেলপ করার সময়, আমাদের শুধু নিশ্চিত করতে হবে না যে সেগুলো বিভিন্ন ব্রাউজারে এক जैसा দেখায়, বরং ব্যবহারকারীরা প্ল্যাটফর্ম জুড়ে একইভাবে সুরক্ষিত হচ্ছে কিনা।
ওয়েব সিকিউরিটির প্রতি আপনার কৌশল ব্রাউজারের ভেন্ডর যা আমাদের করতে দেয় তার অনুযায়ী পরিবর্তনশীল হওয়া উচিত। আজকাল অধিকাংশ ব্রাউজার একই ফিচার সেট সাপোর্ট করে এবং তাদের সাধারণ রোডম্যাপ থেকে খুব কম विचলিত হয়, কিন্তু উপরের মতো ঘটনাগুলো এখনও ঘটে, এবং সিকিউরিটি কৌশল সংজ্ঞায়িত করার সময় সেটি বিবেচনা করতে হবে।
আমাদের কেসে, যদি আমরা সিদ্ধান্ত নিই যে CSRF আটকে শুধু SameSite কুকির মাধ্যমে করব, তবে আমাদের সচেতন থাকতে হবে যে আমরা আমাদের সাফারি ব্যবহারকারীদের ঝুঁকিতে ফেলছি। এবং আমাদের ব্যবহারকারীদেরও সেটি জানা উচিত।
শেষে, মনে রাখবেন যে আপনি কোন ব্রাউজার ভার্সন সাপোর্ট করবেন বা না সেটি সিদ্ধান্ত নিতে পারেন: প্রতিটি ব্রাউজার ভার্সন সাপোর্ট করা অযৌক্তিক (ইন্টারনেট এক্সপ্লোরার ৬ ভাবুন)। যাইহোক, বড় ব্রাউজারগুলির শেষ কয়েকটি ভার্সন সাপোর্ট করা সাধারণত একটি ভালো সিদ্ধান্ত। আপনি যদি কোনো নির্দিষ্ট প্ল্যাটফর্মে সুরক্ষা অফার না করার পরিকল্পনা করেন, তবে সাধারণত ব্যবহারকারীদের জানাতে ভালো।
প্রো টিপ: আপনি কখনও আপনার ব্যবহারকারীদের পুরনো ব্রাউজার ব্যবহার করতে উৎসাহিত করবেন না, বা সক্রিয়ভাবে সাপোর্ট করবেন না। আপনি যদি সকল সতর্কতা নেওয়া থাকেন, তবুও অন্যান্য ওয়েব ডেভেলপাররা নিতে পারে না। ব্যবহারকারীদের বড় ব্রাউজারগুলির সর্বশেষ সাপোর্টেড ভার্সন ব্যবহার করতে উৎসাহিত করুন।
ভেন্ডর বা স্ট্যান্ডার্ড বাগ?
সাধারণ ব্যবহারকারী একটি থার্ড-পার্টি ক্লায়েন্ট (ব্রাউজার) মাধ্যমে আমাদের অ্যাপ্লিকেশন অ্যাক্সেস করে সেটি একটি পরিশুদ্ধ, নিরাপদ ব্রাউজিং অভিজ্ঞতার দিকে আরেকটি স্তর যোগ করে: ব্রাউজারটিই একটি সিকিউরিটি ভালনারেবিলিটি উপস্থাপন করতে পারে।
ভেন্ডররা সাধারণত সিকিউরিটি গবেষকদের পুরস্কার (একে বাগ বাউন্টি বলা হয়) দান করে যারা ব্রাউজারেই একটি ভালনারেবিলিটি খুঁজে পান। এই বাগগুলো আপনার ইমপ্লিমেন্টেশনের সাথে জড়িত নয়, বরং ব্রাউজার নিজে সিকিউরিটি কীভাবে হ্যান্ডল করে সেটির সাথে জড়িত।
ক্রোম রিওয়ার্ড প্রোগ্রাম, উদাহরণস্বরূপ, সিকিউরিটি ইঞ্জিনিয়ারদের ক্রোম সিকিউরিটি টিমের সাথে যোগাযোগ করতে দেয় যারা খুঁজে পেয়েছে। যদি এই ভালনারেবিলিটি গুলো নিশ্চিত হয়, একটি প্যাচ ইশু করা হয়, একটি সিকিউরিটি অ্যাডভাইজরি নোটিশ সাধারণত পাবলিক्ली রিলিজ করা হয়, এবং গবেষক প্রোগ্রাম থেকে একটি (সাধারণত আর্থিক) পুরস্কার পান।
গুগল এর মতো কোম্পানিগুলো তাদের বাগ বাউন্টি প্রোগ্রামে tương đối ভালো পরিমাণ ক্যাপিটাল বিনিয়োগ করে, কারণ এটি গবেষকদের আকর্ষণ করে আর্থিক সুবিধার আশ্বাস দিয়ে যদি তারা অ্যাপ্লিকেশনে কোনো সমস্যা খুঁজে পান।
একটি বাগ বাউন্টি প্রোগ্রামে সবাই জিতেন: ভেন্ডর তার সফটওয়্যারের সিকিউরিটি উন্নত করতে পারে, এবং গবেষক তাদের খুঁজে পাওয়ার জন্য টাকা পান। আমরা এই প্রোগ্রামগুলো পরে আলোচনা করব, কারণ আমি মনে করি বাগ বাউন্টি উদ্যোগগুলো সিকিউরিটি ل্যান্ডস্কেপে নিজস্ব একটি বিভাগ পাওয়ার যোগ্য।
জেক আর্কিবাল্ড গুগলের একটি ডেভেলপার অ্যাডভোকেট যিনি gầnে একাধিক ব্রাউজারকে প্রভাবিত করে একটি ভালনারেবিলিটি আবিষ্কার করেছেন। তিনি তার প্রচেষ্টা, কীভাবে তিনি বিভিন্ন ভেন্ডরকে আপনার করান, এবং তাদের প্রতিক্রিয়া একটি আকর্ষণীয় ব্লগ পোস্টে ডকুমেন্ট করেছেন যা আমি আপনাকে পড়ার পরামর্শ দেব।
ডেভেলপারদের জন্য একটি ব্রাউজার
এখন পর্যন্ত, আমাদের একটি খুব সহজ কিন্তু খুব গুরুত্বপূর্ণ কনসেপ্ট বুঝতে হবে: ব্রাউজারগুলো সাধারণ ইন্টারনেট সার্ফারের জন্য নির্মিত শুধু HTTP ক্লায়েন্ট।
এইগুলো নিশ্চিতভাবে একটি প্ল্যাটফর্মের বেয়ার HTTP ক্লায়েন্টের চেয়ে শক্তিশালী (নোডজেএস-এর require('http') চিন্তা করুন), কিন্তু দিনের শেষে, সেগুলো সহজ HTTP ক্লায়েন্টের একটি প্রাকৃতিক উন্নতি।
ডেভেলপাররা আমাদের পছন্দের HTTP ক্লায়েন্ট সম্ভবত ড্যানিয়েল স্টেনবার্গের cURL, ওয়েব ডেভেলপাররা যেটি দিনে দিনে ব্যবহার করেন। এটি আমাদের কমান্ড লাইন থেকে একটি HTTP এক্সচেঞ্জ অন-দ-ফ্লাই করতে দেয়, একটি HTTP রিকোয়েস্ট পাঠিয়ে:
$ curl -I localhost:8080
HTTP/1.1 200 OK
server: ecstatic-2.2.1
Content-Type: text/html
etag: "23724049-4096-"2018-07-20T11:20:35.526Z"
last-modified: Fri, 20 Jul 2018 11:20:35 GMT
cache-control: max-age=3600
Date: Fri, 20 Jul 2018 11:21:02 GMT
Connection: keep-alive
উপরের উদাহরণে, আমরা localhost:8080/-এ থাকা ডকুমেন্টটি রিকোয়েস্ট করেছি, এবং একটি লোকাল সার্ভার সফলভাবে উত্তর দিয়েছে।
রেসপন্সের বডি কমান্ড লাইনে ডাম্প করার বদলে, এখানে আমরা -I ফ্ল্যাগ ব্যবহার করেছি যা cURL কে বলে যে আমরা শুধু রেসপন্স হেডারগুলোতে আগ্রহী। এক ধাপ এগিয়ে, আমরা cURL কে নির্দেশ দিতে পারি কিছু আরও তথ্য ডাম্প করার জন্য, একই সাথে এটি কী রিকোয়েস্ট করে সেটিও, যাতে আমরা পুরো HTTP এক্সচেঞ্জটি ভালোভাবে দেখতে পাই। যে অপশনটি লাগবে সেটি -v (verbose):
$ curl -I -v localhost:8080
* Rebuilt URL to: localhost:8080/
* Trying 127.0.0.1...
* Connected to localhost (127.0.0.1) port 8080 (#0)
> HEAD / HTTP/1.1
> Host: localhost:8080
> User-Agent: curl/7.47.0
> Accept: */*
>
< HTTP/1.1 200 OK
< server: ecstatic-2.2.1
< Content-Type: text/html
< etag: "23724049-4096-"2018-07-20T11:20:35.526Z"
< last-modified: Fri, 20 Jul 2018 11:20:35 GMT
< cache-control: max-age=3600
< Date: Fri, 20 Jul 2018 11:25:55 GMT
< Connection: keep-alive
* Connection #0 to host localhost left intact
প্রায় একই তথ্য মেনস্ট্রিম ব্রাউজারগুলোর DevTools-এও পাওয়া যায়।
যেsprechend, ব্রাউজারগুলো বের করে দাঁড়ানো কঠিন HTTP ক্লায়েন্ট ছাড়া আর কিছু নয়। নিশ্চিতভাবেই, সেগুলো অনেক ফিচার যোগ করে (ক্রেডেনশিয়াল ম্যানেজমেন্ট, বুকমার্কিং, ইতিহাস, ইত্যাদি চিন্তা করুন) কিন্তু সত্যি হল সেগুলো মানুষের জন্য HTTP ক্লায়েন্ট হিসেবে জন্ম নিয়েছিল। এটি গুরুত্বপূর্ণ, কারণ অধিকাংশ ক্ষেত্রে আপনার ওয়েব অ্যাপ্লিকেশনের সিকিউরিটি টেস্ট করার জন্য আপনাকে একটি ব্রাউজারের প্রয়োজন নেই, আপনি সহজে "curl it" করে রেসপন্স দেখতে পারেন।
একশেষ কথা যা আমি বলতে চাই, সেটি হল যেকোনো জিনিস ব্রাউজার হতে পারে। আপনার কাছে যদি একটি মোবাইল অ্যাপ্লিকেশন থাকে যা HTTP প্রোটোকল মাধ্যমে API কনসাম করে, তবে সেটিই আপনার ব্রাউজার — সেটি শুধু একটি অত্যন্ত কাস্টমাইজড ব্রাউজার যা আপনি নিজে তৈরি করেছেন, যা কেবল একটি নির্দিষ্ট ধরনের HTTP রেসপন্স বুঝতে পারে (আপনার নিজের API থেকে)।
HTTP প্রোটোকলে গভীরে
যেطور আমরা উল্লেখ করেছি, HTTP এক্সচেঞ্জ এবং রেন্ডারিং ফেজগুলো যেগুলো আমরা অধিকাংশ কভার করব, কারণ সেগুলো ম্যালিশাস ব্যবহারকারীদের জন্য অ্যাটাক ভেক্টরের সবচেয়ে বড় সংখ্যা প্রদান করে।
পরবর্তী আর্টিকেলে, আমরা HTTP প্রোটোকলে আরও গভীরে যাব এবং বুঝতে চেষ্টা করব HTTP এক্সচেঞ্জ সুরক্ষিত করার জন্য আমাদের কী কী ব্যবস্থা নেওয়া উচিত।
মূলত odino.org-এ প্রকাশিত (২৯ জুলাই ২০১৮)।
_আপনি টুইটারে আমাকে ফলো করতে পারেন - র্যান্টস স্বাগত!_ ?
নি:শুল্কে কোডিং শিখুন। freeCodeCamp-এর ওপেন সোর্স ক্যারিকুলাম ৪০,০০০-এর অধিক লোককে ডেভেলপার হিসেবে চাকরি পেতে সাহায্য করেছে। শুরু করুন।
