

কনভোলিউশনাল নিউরাল নেটওয়ার্ক তৈরি করা থেকে iOS-এ OCR ডিপ্লয় করা পর্যন্ত
প্রজেক্টের động lực ✍️ ??
কয়েক মাস আগে MNIST ডেটাসেটের জন্য ডিপ লার্নিং মডেল তৈরি শিখতে শিখতে আমি একটি iOS অ্যাপ তৈরি করেছিলাম যা হ্যান্ডরিটেন ক্যারেক্টার রিকগনাইজ করতে পারত।
আমার বন্ধু কাইচি মোমোস একটি জাপানি ভাষা লার্নিং অ্যাপ, Nukon ডেভেলপ করছিলেন। তিনি হঠাৎ একটি সিমিলার ফিচার চেয়েছিলেন। আমরা তখন কোলাবোরেট করলাম কিছু більш সফিস্টিকেটেড তৈরি করতে - একটি ডিজিট রিকগনাইজারের চেয়ে: জাপানি ক্যারেক্টারের (হিরাগানা এবং কatakanা) জন্য একটি OCR (অপটিক্যাল ক্যারেক্টার রিকগনিশন/রিডার)।
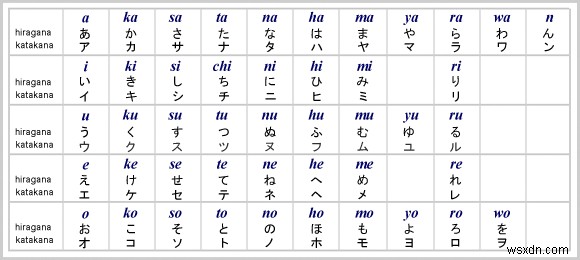
Nukon ডেভেলপমেন্টের সময় জাপানি হ্যান্ডরাইটিং রিকগনিশনের জন্য কোনো API ছিল না। আমাদের নিজেরা OCR বানাতে ছিল ছাড়া কোনো উপায় ছিল না। নিজেদের OCR বানাতে সবচেয়ে বড় সুবিধা ছিল এটি অফলাইন কাজ করে। ইউজাররা ইন্টারনেট ছাড়া গভীর পর্বত श्रেণিতেও Nukon খুলে জাপানি শেখার দৈনন্দিন রুটিন মেইনটেইন করতে পারত। আমরা প্রক্রিয়াটি থেকে অনেক কিছু শিখলাম, কিন্তু更重要的是, আমরা আমাদের ইউজারদের জন্য একটি বেটার প্রোডাক্ট শিপ করতে পেরে আহ্লাদিত।
এই আর্টিকেলে আমরা ব্রেক ডাউন করব কীভাবে আমরা iOS অ্যাপের জন্য একটি জাপানি OCR বানিয়েছিলাম। যারা অন্য ভাষা/সিম্বলের জন্য তৈরি করতে চান, ডেটাসেট পরিবর্তন করে কাস্টমাইজ করতে পারেন।
বез দেরি, নजर দেই কী কী কভার করা হবে:
Part 1️⃣: ডেটাসেট প্রাপ্তি এবং ইমেজ প্রিপ্রসেসিং
Part 2️⃣: CNN (কনভোলিউশনাল নিউরাল নেটওয়ার্ক) বিল্ড ও ট্রেনিং
Part 3️⃣: ট্রেনড মডেল iOS-এ ইন্টিগ্রেট করা
ডেটাসেট প্রাপ্তি & ইমেজ প্রিপ্রসেসিং ?
ডেটাসেট আসে ETL ক্যারেক্টার ডেটাবেস থেকে, যাতে হ্যান্ডরিটেন ক্যারেক্টার এবং সিম্বলের নয় সেট ইমেজ রয়েছে। যেহেতু আমরা হিরাগানার জন্য OCR বানাব, ETL8 হলো আমাদের ব্যবহৃত ডেটাসেট।
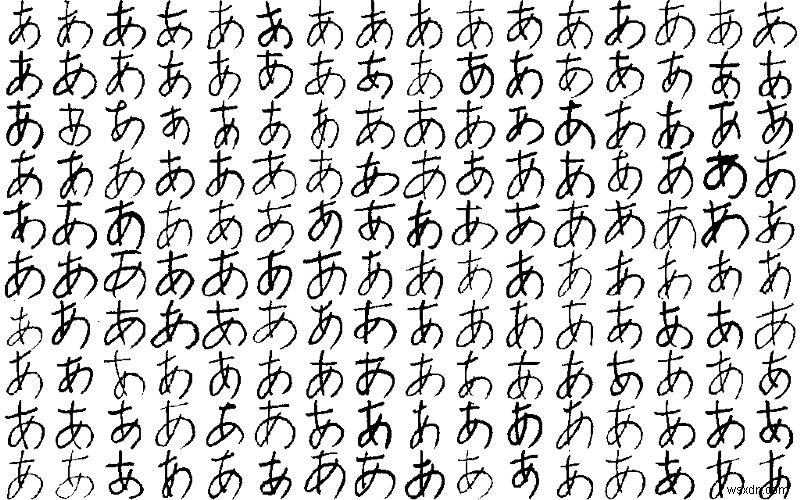
ডেটাবেস থেকে ইমেজ পেতে কিছু হেল্পার ফাংশন দরকার যা ইমেজ পড়ে এবং .npz ফরম্যাটে সংরক্ষণ করে।
import struct import numpy as np from PIL import Image sz_record = 8199 def read_record_ETL8G(f): s = f.read(sz_record) r = struct.unpack('>2H8sI4B4H2B30x8128s11x', s) iF = Image.frombytes('F', (128, 127), r[14], 'bit', 4) iL = iF.convert('L') return r + (iL,) def read_hiragana(): # ক্যারেক্টার টাইপ = 70, পার্সন = 160, y = 127, x = 128 ary = np.zeros([71, 160, 127, 128], dtype=np.uint8) for j in range(1, 33): filename = '../../ETL8G/ETL8G_{:02d}'.format(j) with open(filename, 'rb') as f: for id_dataset in range(5): moji = 0 for i in range(956): r = read_record_ETL8G(f) if b'.HIRA' in r[2] or b'.WO.' in r[2]: if not b'KAI' in r[2] and not b'HEI' in r[2]: ary[moji, (j - 1) * 5 + id_dataset] = np.array(r[-1]) moji += 1 np.savez_compressed("hiragana.npz", ary)hiragana.npz সংরক্ষণ হয়ে গেলে, ফাইল লোড করে এবং ইমেজ ডাইমেনশন ৩২x৩২ পিক্সেলে রিশেপ করে ইমেজ প্রসেসিং শুরু করি। ডেটা অগমেন্টেশনও যোগ করব রোটেটেড এবং জুমড অতিরিক্ত ইমেজ জেনারেট করার জন্য। যখন আমাদের মডেল বিভিন্ন কোণ থেকে ক্যারেক্টার ইমেজে ট্রেনড হবে, তখন এটি মানুষের হ্যান্ডরাইটিংয়ের সাথে আরও ভালো অ্যাডাপ্ট করতে পারবে।
import scipy.misc from keras.layers import Conv2D, MaxPooling2D from keras.layers import Dense, Dropout, Activation, Flatten from keras.models import Sequential from keras.preprocessing.image import ImageDataGenerator from keras.utils import np_utils from sklearn.model_selection import train_test_split # 71 ক্যারেক্টার nb_classes = 71 # ইনপুট ইমেজ ডাইমেনশন img_rows, img_cols = 32, 32 ary = np.load("hiragana.npz")['arr_0'].reshape([-1, 127, 128]).astype(np.float32) / 15 X_train = np.zeros([nb_classes * 160, img_rows, img_cols], dtype=np.float32) for i in range(nb_classes * 160): X_train[i] = scipy.misc.imresize(ary[i], (img_rows, img_cols), mode='F') y_train = np.repeat(np.arange(nb_classes), 160) X_train, X_test, y_train, y_test = train_test_split(X_train, y_train, test_size=0.2) # ক্লাস ভেক্টর ক্যাটেগরিক্যাল ম্যাট্রিক্সে কনভার্ট y_train = np_utils.to_categorical(y_train, nb_classes) y_test = np_utils.to_categorical(y_test, nb_classes) # ডেটা অগমেন্টেশন datagen = ImageDataGenerator(rotation_range=15, zoom_range=0.20) datagen.fit(X_train)CNN বিল্ড ও ট্রেনিং ?️
এখন মজার অংশ! আমরা Keras ব্যবহার করে আমাদের মডেলের জন্য একটি CNN (কনভোলিউশনাল নিউরাল নেটওয়ার্ক) কনস্ট্রাক্ট করব। যখন আমি প্রথমে মডেল বানিয়েছিলাম, হাইপার-প্যারামিটার এক্সপেরিমেন্ট করলাম এবং একাধিকবার টিউন করলাম। নিচের কম্বিনেশন আমাকে সর্বোচ্চ একুরেসি দিয়েছিল - ৯৮.৭৭%। আপনি নিজেরাই বিভিন্ন প্যারামিটার দিয়ে খেলতে পারেন।
model = Sequential() def model_6_layers(): model.add(Conv2D(32, 3, 3, input_shape=input_shape)) model.add(Activation('relu')) model.add(Conv2D(32, 3, 3)) model.add(Activation('relu')) model.add(MaxPooling2D(pool_size=(2, 2))) model.add(Dropout(0.5)) model.add(Conv2D(64, 3, 3)) model.add(Activation('relu')) model.add(Conv2D(64, 3, 3)) model.add(Activation('relu')) model.add(MaxPooling2D(pool_size=(2, 2))) model.add(Dropout(0.5)) model.add(Flatten()) model.add(Dense(256)) model.add(Activation('relu')) model.add(Dropout(0.5)) model.add(Dense(nb_classes)) model.add(Activation('softmax')) model_6_layers() model.compile(loss='categorical_crossentropy', optimizer='adam', metrics=['accuracy']) model.fit_generator(datagen.flow(X_train, y_train, batch_size=16), samples_per_epoch=X_train.shape[0], nb_epoch=30, validation_data=(X_test, y_test))ট্রেনিং ধাপে মডেলের পারফরম্যান্স অসন্তোষজনক হলে কিছু টিপস:
মডেল ওভারফিটিং হচ্ছে
এটি মানে মডেল ভালো জেনারালাইজড নয়। ин্টুইটিভ ব্যাখ্যার জন্য এই আর্টিকেল চেক করুন।
ওভারফিটিং ডিটেক্ট করার উপায়: ট্রেনিং প্রক্রিয়ায় acc (একুরেসি) বাড়তে থাকে, কিন্তু val_acc (ভ্যালিডেশন একুরেসি) বিপরীত দিকে যায়।
ওভারফিটিং সমাধান: রেগুলারাইজেশন (যেমন ড্রপআউট), ডেটা অগমেন্টেশন, ডেটাসেটের গুণমান উন্নতি
মডেল "লার্নিং" করছে কিনা জানার উপায়
ট্রেনিং চলতে থাকলে val_loss (ভ্যালিডেশন লস) বাড়লে বা কম না হলে মডেল লার্নিং করছে না।
TensorBoard ব্যবহার করুন - এটি সময়ের সাথে মডেল পারফরম্যান্সের ভিজ্যুয়ালাইজেশন দেয়। প্রতিটি epoch দেখে মান তুলনা করার ক্লান্তিকর কাজ থেকে মুক্তি দেয়।
একুরেসি থেকে সন্তুষ্ট হলে, ওজন এবং মডেল কনফিগারেশন ফাইল হিসেবে সংরক্ষণ করার আগে ড্রপআউট লেয়ারগুলো সরিয়ে দিই।
for k in model.layers: if type(k) is keras.layers.Dropout: model.layers.remove(k) model.save('hiraganaModel.h5')iOS পার্টে যাওয়ার আগে একমাত্র কাজ বাকি: hiraganaModel.h5 কে CoreML মডেলে কনভার্ট করা।
import coremltools output_labels = [ 'あ', 'い', 'う', 'え', 'お', 'か', 'く', 'こ', 'し', 'せ', 'た', 'つ', 'と', 'に', 'ね', 'は', 'ふ', 'ほ', 'み', 'め', 'や', 'ゆ', 'よ', 'ら', 'り', 'る', 'わ', 'が', 'げ', 'じ', 'ぞ', 'だ', 'ぢ', 'づ', 'で', 'ど', 'ば', 'び', 'ぶ', 'べ', 'ぼ', 'ぱ', 'ぴ', 'ぷ', 'ぺ', 'ぽ', 'き', 'け', 'さ', 'す', 'そ', 'ち', 'て', 'な', 'ぬ', 'の', 'ひ', 'へ', 'ま', 'む', 'も', 'れ', 'を', 'ぎ', 'ご', 'ず', 'ぜ', 'ん', 'ぐ', 'ざ', 'ろ'] scale = 1/255. coreml_model = coremltools.converters.keras.convert('./hiraganaModel.h5', input_names='image', image_input_names='image', output_names='output', class_labels= output_labels, image_scale=scale) coreml_model.author = 'Your Name' coreml_model.license = 'MIT' coreml_model.short_description = 'হ্যান্ডরাইটিং থেকে হিরাগানা ক্যারেক্টার ডিটেক্ট করুন' coreml_model.input_description['image'] = 'হ্যান্ডরিটেন ক্যারেক্টার ধারণকারী গ্রেস্কেল ইমেজ' coreml_model.output_description['output'] = 'হিরাগানা ক্যারেক্টার আউটপুট করুন' coreml_model.save('hiraganaModel.mlmodel')output_labels হলো iOS-এ পরে দেখাবেন এমন সব সম্ভাব্য আউটপুট।
মজার তথ্য: আপনি জাপানি বুঝলে জানেন আউটপুট ক্যারেক্টারের অর্ডার হিরাগানার "অ্যালফাবেটিক্যাল অর্ডার" এর সাথে মেলে না। ETL8-এ ইমেজগুলো "অ্যালফাবেটিক্যাল অর্ডার" এ ছিল না তা বুঝতে আমাদের কিছু সময় লেগেছিল (কাইচিকে ধন্যবাদ যেন এটি বুঝতে পারলেন)। ডেটাসেট একটি জাপানি বিশ্ববিদ্যালয় কম্পাইল করেছিল...?
ট্রেনড মডেল iOS-এ ইন্টিগ্রেট করুন ?
আমরা সব কিছু একসাথে করছি! hiraganaModel.mlmodel একটি Xcode প্রজেক্টে ড্র্যাগ অ্যান্ড ড্রপ করুন। তাহলে আপনি এমন কিছু দেখবেন:
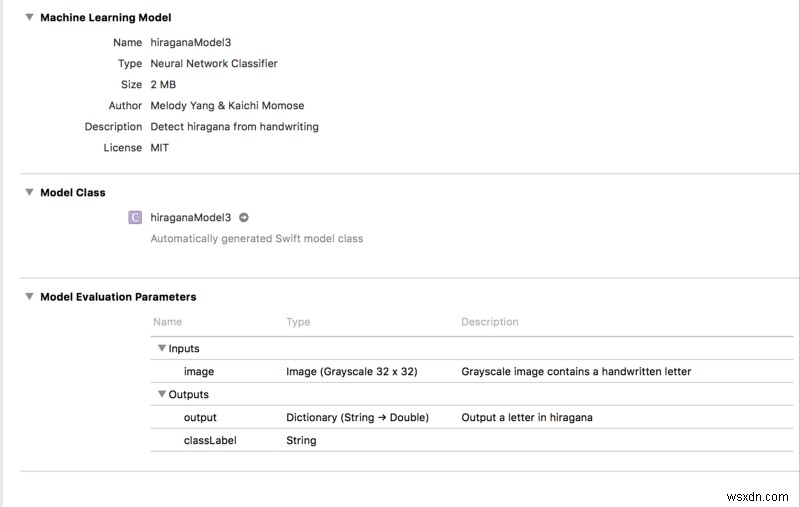
নোট: মডেল কপি করলে Xcode একটি workspace তৈরি করবে। ML মডেল কাজ করার জন্য আমাদের কোডিং এনভায়রনমেন্ট workspace-এ সইচ করতে হবে!
UIView-এUIBezierPathদিয়ে ক্যারেক্টার "ড্র" করুন
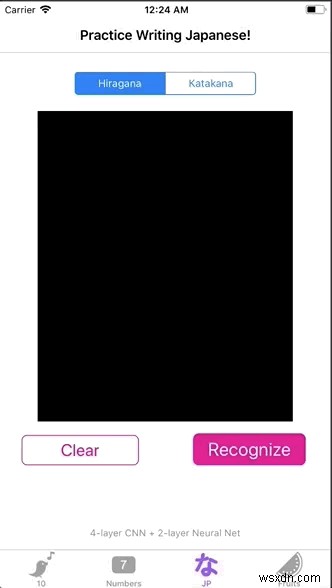
import UIKit class viewController: UIViewController { @IBOutlet weak var canvas: UIView! var path = UIBezierPath() var startPoint = CGPoint() var touchPoint = CGPoint() override func viewDidLoad() { super.viewDidLoad() canvas.clipsToBounds = true canvas.isMultipleTouchEnabled = true } override func touchesBegan(_ touches: Set<UITouch>, with event: UIEvent?) { let touch = touches.first if let point = touch?.location(in: canvas) { startPoint = point } } override func touchesMoved(_ touches: Set<UITouch>, with event: UIEvent?) { let touch = touches.first if let point = touch?.location(in: canvas) { touchPoint = point } path.move(to: startPoint) path.addLine(to: touchPoint) startPoint = touchPoint draw() } func draw() { let strokeLayer = CAShapeLayer() strokeLayer.fillColor = nil strokeLayer.lineWidth = 8 strokeLayer.strokeColor = UIColor.orange.cgColor strokeLayer.path = path.cgPath canvas.layer.addSublayer(strokeLayer) } // ভিউতে ড্রইং ক্লিয়ার করুন @IBAction func clearPressed(_ sender: UIButton) { path.removeAllPoints() canvas.layer.sublayers = nil canvas.setNeedsDisplay() } }strokeLayer.strokeColor যেকোনো কালার হতে পারে। কিন্তু canvas-এর ব্যাকগ্রাউন্ড কালার অবশ্যই কালো হতে হবে। যদিও আমাদের ট্রেনিং ইমেজগুলিতে সাদা ব্যাকগ্রাউন্ড এবং কালো স্ট্রোক ছিল, ML মডেল এই স্টাইলের ইনপুট ইমেজে ভালো রিয়াক্ট করে না।
2. UIView-কে UIImage-তে রূপান্তর করুন এবং CVPixelBuffer-এ পিক্সেল ভ্যালু রিট্রিভ করুন
এক্সটেনশনে দুটি হেল্পার ফাংশন আছে। একসাথে তারা ইমেজকে পিক্সেল বাফারে অনুবাদ করে, যা পিক্সেল ভ্যালুর সমতুল্য। ইনপুট width এবং height উভয়ই ৩২ হতে হবে কারণ আমাদের মডেলের ইনপুট ডাইমেনশন ৩২ বাই ৩২ পিক্সেল।
যেহেতু আমাদের কাছে pixelBuffer আছে, আমরা model.prediction() কল করে pixelBuffer পাস করতে পারি। এবং হয়ে গেল! আমরা classLabel আউটপুট পেতে পারি!
@IBAction func recognizePressed(_ sender: UIButton) { // ভিউকে ইমেজে রূপান্তর let resultImage = UIImage.init(view: canvas) let pixelBuffer = resultImage.pixelBufferGray(width: 32, height: 32) let model = hiraganaModel3() // একটি হিরাগানা ক্যারেক্টার আউটপুট let output = try? model.prediction(image: pixelBuffer!) print(output?.classLabel) } extension UIImage { // ইমেজকে width x height-এ রিসাইজ করে গ্রেস্কেল CVPixelBuffer-এ কনভার্ট করুন func pixelBufferGray(width: Int, height: Int) -> CVPixelBuffer? { return _pixelBuffer(width: width, height: height, pixelFormatType: kCVPixelFormatType_OneComponent8, colorSpace: CGColorSpaceCreateDeviceGray(), alphaInfo: .none) } func _pixelBuffer(width: Int, height: Int, pixelFormatType: OSType, colorSpace: CGColorSpace, alphaInfo: CGImageAlphaInfo) -> CVPixelBuffer? { var maybePixelBuffer: CVPixelBuffer? let attrs = [kCVPixelBufferCGImageCompatibilityKey: kCFBooleanTrue, kCVPixelBufferCGBitmapContextCompatibilityKey: kCFBooleanTrue] let status = CVPixelBufferCreate(kCFAllocatorDefault, width, height, pixelFormatType, attrs as CFDictionary, &maybePixelBuffer) guard status == kCVReturnSuccess, let pixelBuffer = maybePixelBuffer else { return nil } CVPixelBufferLockBaseAddress(pixelBuffer, CVPixelBufferLockFlags(rawValue: 0)) let pixelData = CVPixelBufferGetBaseAddress(pixelBuffer) guard let context = CGContext(data: pixelData, width: width, height: height, bitsPerComponent: 8, bytesPerRow: CVPixelBufferGetBytesPerRow(pixelBuffer), space: colorSpace, bitmapInfo: alphaInfo.rawValue) else { return nil } UIGraphicsPushContext(context) context.translateBy(x: 0, y: CGFloat(height)) context.scaleBy(x: 1, y: -1) self.draw(in: CGRect(x: 0, y: 0, width: width, height: height)) UIGraphicsPopContext() CVPixelBufferUnlockBaseAddress(pixelBuffer, CVPixelBufferLockFlags(rawValue: 0)) return pixelBuffer } } 3. UIAlertController দিয়ে আউটপুট দেখান
এই ধাপটি সম্পূর্ণ অপশনাল। শুরুর GIF-এ দেখানো মতো, আমি রেজাল্ট জানাতে একটি অ্যালার্ট কন্ট্রোলার যোগ করেছিলাম।
func informResultPopUp(message: String) { let alertController = UIAlertController(title: message, message: nil, preferredStyle: .alert) let ok = UIAlertAction(title: "Ok", style: .default, handler: { action in self.dismiss(animated: true, completion: nil) }) alertController.addAction(ok) self.present(alertController, animated: true) { () in } }Voila! আমরা একটি OCR বানালাম যা ডেমো-রেডি (এবং App-Store-রেডি)! ??
উপসংহার ?
OCR বানানো সাॅই হ্যাড নয়। আপনি দেখলেন, এই আর্টিকেল ধাপগুলো এবং প্রজেক্ট বানানোর সময় আমি যে সমস্যায় পড়েছিলাম সেগুলো নিয়ে। পাইথন কোডকে iOS-এ কানেক্ট করে ডেমোনস্ট্রেবল বানানোর প্রসেসে আমি উপভোগ করেছি, এবং আমি এগিয়েও এভাবে করব।
আশা করি এই আর্টিকেল OCR বানাতে চাইলে কিন্তু কোথায় শুরু করতে হবে সে সম্পর্কে কিছু উপকারী তথ্য দিতে পারবে।
এখানে সোর্স কোড পাওয়া যাবে।
বোনাস: আপনি যদি শ্যালো অ্যালগরিদমে এক্সপেরিমেন্ট করতে আগ্রহী হন, তবে পড়তে থাকুন!
[Optional] শ্যালো অ্যালগরিদম দিয়ে ট্রেনিং ?
CNN বাস্তবায়নের আগে, কাইচি এবং আমি অন্যান্য মেশিন লার্নিং অ্যালগরিদম টেস্ট করেছিলাম কি সেগুলো কাজটি করতে পারে (এবং কম্পিউটিং কস্ট বাঁচাতে!)। আমরা KNN এবং Random Forest বেছে নেছিলাম।
পারফরম্যান্স ইভ্যালুয়েট করার জন্য, আমরা বেসলাইন একুরেসি 1/71 = 0.014 ডিফাইন করেছিলাম।
আমরা অনুমান করেছিলাম জাপানি ভাষা সম্পর্কে কোনো জ্ঞান না থাকলে একজন ব্যক্তির 1.4% সুযোগ থাকবে ক্যারেক্টার সঠিক অনুমান করার।
সেজন্য মডেলটি ভালো করছে যদি এর একুরেসি 1.4% ছাড়া যেতে পারে। দেখি কেসটা কেমন। ?
KNN
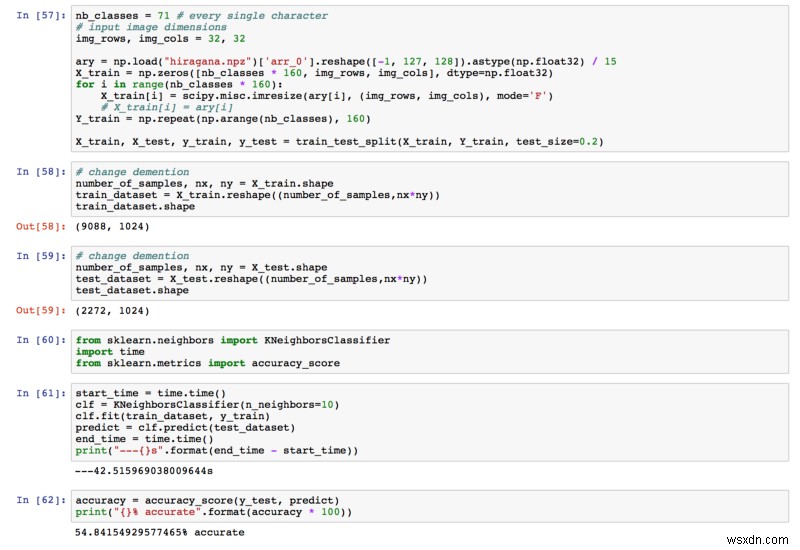
ফাইনাল একুরেসি পেয়েছিলাম ৫৪.৮৪%। ১.৪% থেকে অনেক বেশি!
Random Forest
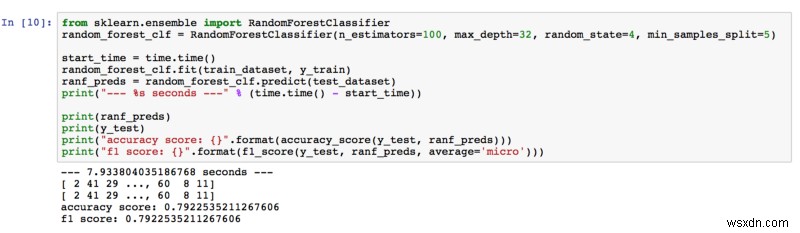
৭৯.২৩% একুরেসি, সেজন্য Random Forest আমাদের আশা অতিক্রম করেছে। হাইপার-প্যারামিটার টিউন করার সময়, এস্টিমেটর এবং ট্রি-এর ডেপথ বাড়িয়ে আমরা ভালো রেজাল্ট পেয়েছিলাম। আমরা মনে করেছিলাম ফরেস্টে বেশি ট্রি (এস্টিমেটর) থাকলে ইমেজের বেশি ফিচার শিখা হয়। এছাড়া, ট্রি যত গভীর, ফিচার থেকে তত ডিটেইল শিখে।
আপনি আগ্রহী হলে, ইমেজ ক্লাসিফিকেশন উইথ Random Forest নিয়ে এই পেপার পড়তে পারেন।
পড়ার জন্য ধন্যবাদ! যেকোনো মতামত ও ফিডব্যাক স্বাগত।
