

অনেক সম্ভব আপনি Ruby এক্সেপশন দেখেছেন যেমন UndefinedConversionError বা IncompatibleCharacterEncodings। কম সম্ভব আপনি বুঝতে পেরেছেন এক্সেপশনটি কী বোঝাচ্ছে। এই আর্টিকেল আপনাকে সাহায্য করবে। আপনি শিখবেন ক্যারেক্টার এনকোডিং কীভাবে কাজ করে এবং Ruby-এ কীভাবে ইমপ্লিমেন্টেড। শেষে, আপনি এই এররগুলো অনেক সহজে বুঝতে এবং ফিক্স করতে পারবেন।
তাহলে "ক্যারেক্টার এনকোডিং" আসলে কী?
প্রতিটি প্রোগ্রামিং ল্যাঙ্গুয়েজে, আপনি স্ট্রিং নিয়ে কাজ করেন। কখনো আপনি সেটি ইনপুট হিসেবে প্রসেস করেন, কখনো আউটপুট হিসেবে ডিসপ্লে করেন। কিন্তু আপনার কম্পিউটার "স্ট্রিং" বুঝে না। সেটি শুধু বিট বুঝে: ১ এবং ০। স্ট্রিংকে বিটে রূপান্তর করার প্রসেসকে ক্যারেক্টার এনকোডিং বলা হয়।
কিন্তু ক্যারেক্টার এনকোডিং শুধু কম্পিউটারের যুগের জিনিস নয়। কম্পিউটারের আগের একটি সিম্পলার প্রসেস থেকে আমরা শিখতে পারি: মোর্স কোড।
মোর্স কোড
মোর্স কোড তার ডেফিনিশনে খুব সিম্পল। আপনার কাছে দুটি সিম্বল বা সিগন্যাল প্রোডিউস করার উপায় থাকে (শর্ট এবং লং)। সেই দুটি সিম্বল দিয়ে আপনি সিম্পল ইংরেজি অ্যালফাবেট রিপ্রেজেন্ট করেন। উদাহরণস্বরূপ:
- A হলো .- (একটি শর্ট মার্ক এবং একটি লং মার্ক)
- E হলো . (একটি শর্ট মার্ক)
- O হলো --- (তিনটি লং মার্ক)
এই সিস্টেম ১৮৩৭ এর দিকে আবিষ্কৃত হয়েছিল এবং কেবল দুটি সিম্বল বা সিগন্যাল দিয়ে পুরো অ্যালফাবেট এনকোড করার অনুমতি দিয়েছিল।
আপনি অনলাইন একটি ট্রান্সলেটরের সাথে খেলতে পারেন এখানে।
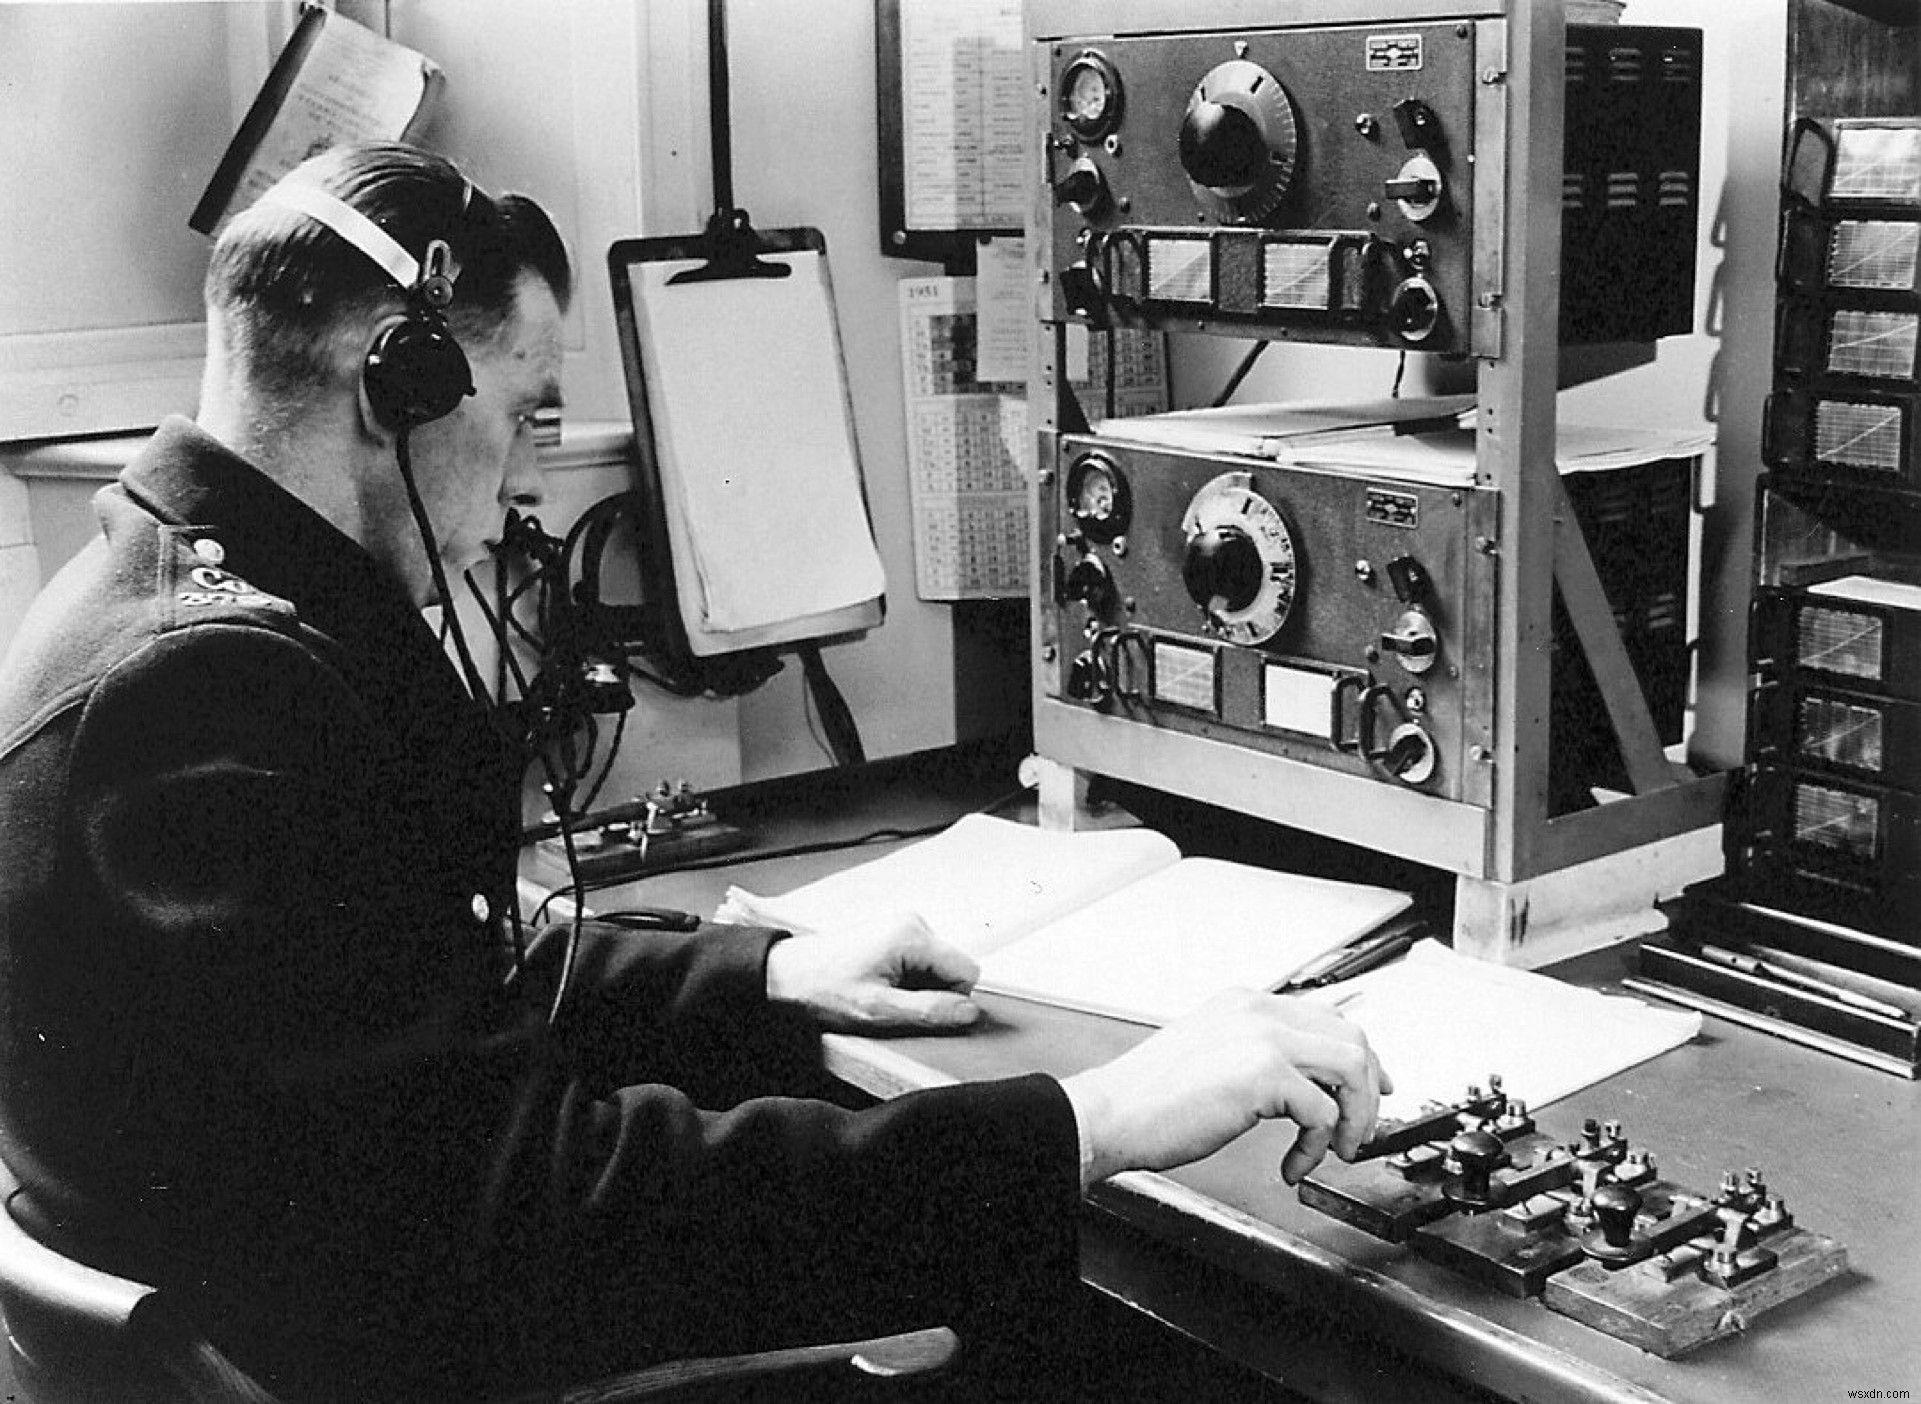
চিত্রে আপনি একটি "এনকোডার" দেখতে পাচ্ছেন, একজন ব্যক্তি যিনি মেসেজ এনকোড এবং ডিকোড করার দায়িত্বে ছিলেন। কম্পিউটারের আগমনের সাথে এটি শীঘ্রই পরিবর্তন হবে।
ম্যানুয়াল থেকে অটোমেটিক এনকোডিং-এ
একটি মেসেজ এনকোড করতে, আপনাকে একজন ব্যক্তি দরকার যিনি ম্যানুয়ালি ক্যারেক্টারগুলোকে মোর্স কোডের অ্যালগরিদম ফলো করে সিম্বলে অনুবাদ করবেন।
মোর্স কোডের মতো, কম্পিউটারও কেবল দুটি "সিম্বল" ব্যবহার করে: ১ এবং ০। আপনি কম্পিউটারে শুধু এই সিকোয়েন্স সংরক্ষণ করতে পারেন, এবং যখন সেগুলো পড়া হবে, সেগুলোকে এমনভাবে ইন্টারপ্রেট করতে হবে যাতে ইউজারের কাছে অর্থবহ হয়।
প্রসেসটি দুই কেসেই একইভাবে কাজ করে:
Message -> Encoding -> Store/Send -> Decoding -> Message মোর্স কোডে SOS হবে:
SOS -> Encode('SOS') -> ...---... -> Decode('...---...') -> SOS
----------------------- --------------------------
Sender                  Receiver
কম্পিউটার এবং অন্যান্য টেকনোলজির সাথে বড় পরিবর্তন হলো এনকোডিং এবং ডিকোডিং প্রসেস অটোমেটেড হয়ে গেলো তাই আর লোকের দরকার নেই ইনফরমেশন অনুবাদ করার জন্য।
যখন কম্পিউটার আবিষ্কৃত হয়, ক্যারেক্টারকে ১ এবং ০-তে অটোমেটিক্যালি রূপান্তর করার জন্য বানানো প্রারম্ভিক স্ট্যান্ডার্ডগুলোতে একটি ছিল ASCII (যদিও প্রথম নয়)।
ASCII মানে American Standard Code for Information Interchange। "American" অংশ কম্পিউটারের কিছু সময় তথ্য নিয়ে কীভাবে কাজ করত সেটিতে গুরুত্বপূর্ণ ভূমিকা পালন করলো; আমরা পরের সেকশনে দেখব কেন।
ASCII (১৯৬৩)
মোর্স কোডের মতো টেলিগ্রাফিক কোড এবং খুব প্রারম্ভিক কম্পিউটারের নলেজ বেস্ড একটি স্ট্যান্ডার্ড তৈরি হয়েছিল ১৯৬৩ সালের দিকে কম্পিউটারে ক্যারেক্টার এনকোড এবং ডিকোড করার জন্য। এই সিস্টেমיחסית সিম্পল ছিল কারণ এটি প্রথমে শুধু ১২৭ ক্যারেক্টার কভার করত, ইংরেজি অ্যালফাবেট প্লাস এক্সট্রা সিম্বল।
ASCII প্রতিটি ক্যারেক্টারকে একটি ডেসিমেল নম্বরের সাথে অ্যাসোসিয়েট করে কাজ করত যেটি বাইনারি কোডে অনুবাদ করা যেত। একটি উদাহরণ দেখি:
"A" ASCII-তে ৬৫, তাই আমাদের ৬৫ কে বাইনারি কোডে অনুবাদ করতে হবে।
আপনি যদি না জানেন কীভাবে কাজ করে, এখানে একটি কুইক উপায়: আমরা ৬৫ কে ২ দিয়ে ভাগ করি শুরু করি এবং ০ পাওয়া পর্যন্ত চালিয়ে যাই। যদি ভাগ এক্স্যাক্ট না হয়, তবে রিমেইন্ডার হিসেবে ১ যোগ করি:
65 / 2 = 32 + 1
32 / 2 = 16 + 0
16 / 2 = 8 + 0
8 / 2 = 4 + 0
4 / 2 = 2 + 0
2 / 2 = 1 + 0
1 / 2 = 0 + 1
এখন, আমরা রিমেইন্ডারগুলো নিই এবং উল্টা অর্ডারে সাজাই:
1000001 তাহলে আসল ASCII এনকোডিং, যা এখন US-ASCII হিসেবে পরিচিত, "A" কে "1000001" হিসেবে স্টোর করত। আজকাল ৮-বিট কম্পিউটার সাধারণ হলে, সেটি হবে 01000001 (৮ বিট = ১ বাইট)।
প্রতিটি ক্যারেক্টারের জন্য একই প্রসেস ফলো করলে, ৭ বিট দিয়ে আমরা 2^7 ক্যারেক্টার = ১২৭ পর্যন্ত স্টোর করতে পারি।
এখানে পূর্ণ টেবিল:
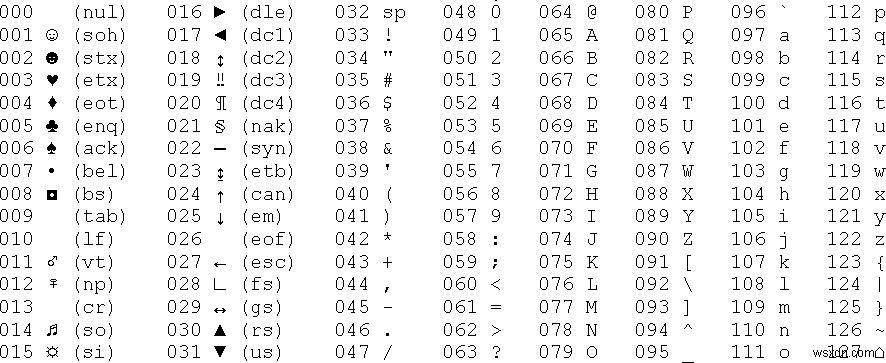 (From https://www.plcdev.com/ascii_chart)
ASCII-এর সমস্যা
কী হয় যদি আমরা আরেকটি ক্যারেক্টার যোগ করতে চাই, যেমন ফরাসি ç বা জাপানি ক্যারেক্টার 大?
হ্যাঁ, সমস্যা হবে।
ASCII-এর পর, লোকেরা এই সমস্যা সমাধান করার জন্য নিজেদের এনকোডিং সিস্টেম বানাতে লাগল। তারা বেশি বিট ব্যবহার করল, কিন্তু এটি পরে আরেকটি সমস্যা সৃষ্টি করল।
মূল সমস্যা ছিল ফাইল পড়ার সময়, আপনি জানতেন না আপনার কন কোন এনকোডিং সিস্টেম। ভুল এনকোডিং দিয়ে ইন্টারপ্রেট করলে জিবারিশ আউটপুট আসত যেমন "" বা "Ã,ÂÂÂÂ"।
এই এনকোডিং সিস্টেমগুলোর إيفোলিউশন বড় এবং ব্যাপক ছিল। ভাষার উপর নির্ভর করে আলাদা সিস্টেম ছিল। চীনা মতো বেশি ক্যারেক্টার বিশিষ্ট ভাষাগুলো তাদের অ্যালফাবেট এনকোড করার জন্য আরও জটিল সিস্টেম ডেভেলপ করেছিল।
বহু বছর এই সমস্যায় জkräfte করার পর, একটি নতুন স্ট্যান্ডার্ড তৈরি হয়: Unicode। এই স্ট্যান্ডার্ড আধুনিক কম্পিউটার কীভাবে ইনফরমেশন এনকোড এবং ডিকোড করে সেটি ডিফাইন করল।
Unicode (১৯৮৮)
Unicode-এর লক্ষ্য খুব সিম্পল। এর অফিসিয়াল সাইট অনুযায়ী: "প্রতিটি ক্যারেক্টারের জন্য একটি ইউনিক নম্বর প্রদান করা, প্ল্যাটফর্ম, প্রোগ্রাম, বা ভাষা নির্বিশেষে।"
সুতরাং একটি ভাষার প্রতিটি ক্যারেক্টারের একটি ইউনিক কোড থাকে, যাকে কোড পয়েন্টও বলা হয়। বর্তমানে ১৩৭,০০০ এর অধিক ক্যারেক্টার আছে।
Unicode স্ট্যান্ডার্ডের অংশ হিসেবে, সেই ভ্যালু বা কোড পয়েন্টগুলো এনকোড করার বিভিন্ন উপায় আছে, কিন্তু UTF-8 সবচেয়ে ব্যাপক।
Go প্রোগ্রামিং ল্যাঙ্গুয়েজের ক্রিয়েটররা, রব পাইক এবং কেন থম্পসন, UTF-8 ও তৈরি করেছেন। এটি সফল হয়েছে কারণ এটি ইফিশিয়েন্ট এবং চতুরভাবে সেই নম্বরগুলো এনকোড করে। কেন একদম সেটি দেখি।
UTF-8: Unicode Transformation Format (১৯৯৩)
UTF-8 এখন ওয়েবসাইটের জন্য ডি ফ্যাক্টো এনকোডিং (৯৪% এর অধিক ওয়েবসাইট এই এনকোডিং ব্যবহার করে)। এটিও অনেক প্রোগ্রামিং ল্যাঙ্গুয়েজ এবং ফাইলের ডিফল্ট এনকোডিং। তাহলে এটি কেন এত সফল হয়েছে এবং কীভাবে কাজ করে?
UTF-8, অন্যান্য এনকোডিং সিস্টেমের মত, Unicode-এ ডিফাইনড নম্বরগুলো বাইনারি-তে রূপান্তর করে কম্পিউটারে স্টোর করার জন্য।
UTF-8-এর দুটি খুব গুরুত্বপূর্ণ দিক: - এটি বিট স্টোর করার ক্ষেত্রে ইফিশিয়েন্ট, কারণ একটি ক্যারেক্টার ১ থেকে ৪ বাইট নিতে পারে। - Unicode এবং ডাইনামিক বাইট পরিমাণ ব্যবহার করে, এটি ASCII এনকোডিং-এর সাথে কম্প্যাটিবল কারণ প্রথম ১২৭ ক্যারেক্টার ১ বাইট নেয়। এর মানে আপনি ASCII ফাইল UTF-8 হিসেবে খুলতে পারেন।
UTF-8 কীভাবে কাজ করে সেটি ব্রেক ডাউন করি।
UTF-8 ১ বাইট দিয়ে
Unicode টেবিলের ভ্যালুর উপর নির্ভর করে UTF-8 ভিন্ন সংখ্যক ক্যারেক্টার ব্যবহার করে।
প্রথম ১২৭-এর জন্য, এটি নিচের টেমপ্লেট ব্যবহার করে: 0_______ (Rust1 টাইপো ঠিক করা হয়েছে)
তাহলে ০ সবসময় থাকবে, তারপর Unicode-এ ভ্যালু রিপ্রেজেন্ট করার বাইনারি নম্বর (যেটি ASCII-ও হবে)। উদাহরণ: A = 65 = 1000001।
Ruby-এ String-এর unpack মেথড ব্যবহার করে চেক করি:
'A'.unpack('B*').first # 01000001 B মানে আমরা মোস্ট সিগনিফিকেন্ট বিট ফাস্ট সহ বাইনারি ফরম্যাট চাই। এই কনটেক্সটে, মানে হাইএস্ট ভ্যালুর বিট। অ্যাস্ট্রিস্ক Ruby-কে বলче বিটগুলো আর নেই পর্যন্ত চালাতে। যদি নম্বর ব্যবহার করতাম, তবে শুধু সেই নম্বর পর্যন্ত বিট পেতাম:
'A'.unpack('B4').first # 01000 UTF-8 ২ বাইট দিয়ে
যদি Unicode-এ কোনো ক্যারেক্টারের ভ্যালু বা কোড পয়েন্ট ১২৭-এর বেশি, ২০৪৭ পর্যন্ত হয়, তবে আমরা দুটি বাইট ব্যবহার করি নিচের টেমপ্লেটে:
110_____ 10______ তাহলে আমাদের Unicode-এ ভ্যালুর জন্য ১১ খালি বিট থাকে। একটি উদাহরণ দেখি:
À Unicode-তে ১৯২, তাই বাইনারি-তে এটি 11000000, ৮ বিট নেয়। এটি প্রথম টেমপ্লেটে ফিট করে না, তাই আমরা দ্বিতীয়টি ব্যবহার করি:
110_____ 10______ আমরা ডান থেকে বামে ফিল করা শুরু করি:
110___11 10000000 খালি বিটগুলোতে কী হয়? আমরা সেখানে ০ দিয়ে দিই, তাই ফাইনাল রেজাল্ট: 11000011 10000000।
এখানে একটি প্যাটার্ন দেখা যাচ্ছে। যদি আমরা বাম থেকে ডানে পড়ি, প্রথম ৮ বিট গ্রুপের শুরুতে দুটি ১ থাকে। এর ইমপ্লিকেশন হচ্ছে ক্যারেক্টারটি ২ বাইট নেবে:
11000011 10000000 -- আবার Ruby-এ চেক করি:
'À'.unpack('B*').first # 1100001110000000 এখানে একটি ছোট টিপ: আউটপুট ভালো ফরম্যাট করতে পারি:
'À'.unpack('B8 B8').join(' ') # 11000011 10000000 'À'.unpack('B8 B8') থেকে অ্যারে পাই এবং সপেস দিয়ে জয়েন করি স্ট্রিং পেতে। unpack প্যারামিটারের ৮ গুলো Ruby-কে বলছে ২ গ্রুপে ৮ বিট করে নিতে।
UTF-8 ৩ বাইট দিয়ে
যদি Unicode-এ কোনো ক্যারেক্টারের ভ্যালু পূর্বের টেমপ্লেটের ১১ বিটে ফিট না করে, তবে আমাদের এক্সট্রা বাইট দরকার:
1110____ 10______ 10______ আবার, টেমপ্লেটের শুরুতে তিনটি ১ বলে আমরা বুঝতে পারি আমরা একটি ৩-বাইট ক্যারেক্টার পড়ব।
একই প্রসেস এই টেমপ্লেটে অ্যাপ্লাই হবে; Unicode ভ্যালুকেও বাইনারি-তে রূপান্তর করি এবং ডান থেকে বামে স্লট ফিল করি। এর পর কিছু খালি জায়গা থাকলে ০ দিয়ে ফিল করি।
UTF-8 ৪ বাইট দিয়ে
কিছু ভ্যালু পূর্বের টেমপ্লেটের ১৬ খালি স্লটের চেয়ে বেশি নেয়। ইমোজি 🙂-র সাথে একটি উদাহরণ দেখি, যা Unicode-এ একটি ক্যারেক্টার যেমন "a" বা "大" হিসেবেও দেখা যায়।
"🙂"-র Unicode-এ ভ্যালু বা কোড পয়েন্ট ১২৮৫৭৮। সেটি বাইনারি-তে: 11111011001000010, ১৭ বিট। এর মানে ৩-বাইট টেমপ্লেটে ফিট করে না যেহেতু আমাদের শুধু ১৬ খালি স্লট ছিল, তাই ৪ বাইট মেমরি নেওয়া একটি নতুন টেমপ্লেট ব্যবহার করতে হবে:
11110___ 10______ 10______ 10______ আমরা আবার বাইনারি নম্বর দিয়ে ফিল করা শুরু করি: 11110___ 10_11111 10011001 10000010 (Rust1 টাইপো ঠিক করা হয়েছে)
এবং এখন, বাকিগুলো ০ দিয়ে ফিল করি: 11110000 10011111 10011001 10000010 (Rust1 টাইপো ঠিক করা হয়েছে)
Ruby-এ কীভাবে দেখে সেটি দেখি।
যেহেতু আমরা ইতিমধ্যে জানি এটি ৪ বাইট নেবে, আউটপুটের রিডেবিলিটির জন্য অপ্টিমাইজ করি:
'🙂'.unpack('B8 B8 B8 B8').join(' ') # 11110000 10011111 10011001 10000010 আমরা যদি না জানতাম, তবে শুধু ব্যবহার করতাম:
'🙂'.unpack('B*') আমরা "bytes" স্ট্রিং মেথডও ব্যবহার করতে পারি বাইট এক্সট্র্যাক্ট করে অ্যারেতে পেতে:
"🙂".bytes # [240, 159, 153, 130] তারপর, এলিমেন্টগুলো বাইনারি-তে ম্যাপ করতে পারি:
"🙂".bytes.map {|e| e.to_s 2} # ["11110000", "10011111", "10011001", "10000010"] যদি স্ট্রিং চাই, তবে join ব্যবহার করি:
"🙂".bytes.map {|e| e.to_s 2}.join(' ') # 11110000 10011111 10011001 10000010 UTF-8-তে Unicode-এর প্রয়োজন থেকে বেশি স্পেস আছে
UTF-8-এর আরেকটি গুরুত্বপূর্ণ দিক হচ্ছে এটি সকল Unicode ভ্যালু (বা কোড পয়েন্ট) ইনক্লুড করতে পারে — শুধু আজকের থাকা নয়, বরং ভবিষ্যতে থাকা সকল।
এটি কারণ UTF-8-তে, ৪-বাইট টেমপ্লেটে, ২১ স্লট আছে ফিল করার জন্য। এর মানে আমরা 2^21 (= ২,০৯৭,১৫২) ভ্যালু পর্যন্ত স্টোর করতে পারি, Unicode স্ট্যান্ডার্ডের সাথে থাকা সর্বোচ্চ পরিমাণ (~১.১ মিলিয়ন) থেকে অনেক বেশি।
এর মানে আমরা UTF-8 ব্যবহার করতে পারি আত্মবিশ্বাসের সাথে যে ভবিষ্যতে নতুন ক্যারেক্টার বা ভাষা আলোকেট করার জন্য অন্য এনকোডিং সিস্টেমে সুইচ করতে হবে না।
Ruby-এ বিভিন্ন এনকোডিংয়ের সাথে কাজ করা
Ruby-এ, আমরা একটি দিয়ে স্ট্রিংয়ের এনকোডিং দেখতে পারি:
'Hello'.encoding.name # "UTF-8" আমরা একটি স্ট্রিংকে ভিন্ন এনকোডিং সিস্টেম দিয়ে এনকোড ও করতে পারি। উদাহরণ:
encoded_string = 'hello, how are you?'.encode("ISO-8859-1", "UTF-8")
encoded_string.encoding.name # ISO-8859-1
যদি ট্রান্সফরমেশন কম্প্যাটিবল না হয়, ডিফল্টলি এরর পাব। ধরুন আমরা "hello 🙂" কে UTF-8 থেকে ASCII-তে কনভার্ট করতে চাই। যেহেতু ইমোজি "🙂" ASCII-তে ফিট করে না, আমরা পারি না। Ruby সেটি কেসে এরর রেইজ করে:
"hello 🙂".encode("ASCII", "UTF-8")
# Encoding::UndefinedConversionError (U+1F642 from UTF-8 to US-ASCII)
তবে Ruby আমাদের এক্সেপশন দেয় যেখানে, যদি ক্যারেক্টার এনকোড করা না যায়, তবে সেটি "?" দিয়ে রিপ্লেস করা যাবে।
"hello 🙂".encode("ASCII", "UTF-8", undef: :replace) # hello ? আমাদের আরেকটি অপশন আছে নির্দিষ্ট ক্যারেক্টারকে নতুন এনকোডিং-এ বৈধ ক্যারেক্টার দিয়ে রিপ্লেস করার:
"hello 🙂".encode("ASCII", "UTF-8", fallback: {"🙂" => ":)"}) # hello :) Ruby-এ একটি স্ক্রিপ্টের এনকোডিং ইনস্পেক্ট করা
আপনি যে স্ক্রিপ্ট ফাইলে কাজ করছেন (".rb" ফাইল), তার এনকোডিং দেখতে নিচের কাজ করুন:
__ENCODING__ # আমার কেসে এটি "#" দেখাবে। Ruby 2.0 থেকে, Ruby স্ক্রিপ্টের ডিফল্ট এনকোডিং UTF-8, কিন্তু আপনি ফাস্ট লাইনে একটি কমেন্ট দিয়ে চেঞ্জ করতে পারেন:
# encoding: ASCII
__ENCODING__ # #
তবে UTF-8 স্ট্যান্ডার্ডে থাকা ভালো যদি খুব ভালো কারণ না থাকে চেঞ্জ করার।
Ruby-এ এনকোডিংয়ের সাথে কাজ করার কিছু টিপস
Ruby-এ সাপোর্টেড সকল এনকোডিংর লিস্ট দেখতে পারেন Encoding.name_list দিয়ে। এটি একটি বড় অ্যারে রিটার্ন করবে:
["ASCII-8BIT", "UTF-8", "US-ASCII", "UTF-16BE", "UTF-16LE", "UTF-32BE", "UTF-32LE", "UTF-16", "UTF-32", "UTF8-MAC"... ইংরেজি ভাষার বাইরের ক্যারেক্টার নিয়ে কাজ করার وقت আরেকটি গুরুত্বপূর্ণ দিক হচ্ছে Ruby 2.4-এর আগে, কিছু মেথড যেমন upcase বা reverse এক্সপেক্টেডভাবেই কাজ করত না। উদাহরণস্বরূপ, Ruby 2.3-এ upcase আপনার চিন্তা অনুযায়ী কাজ করে না:
# Ruby 2.3
'öıüëâñà'.upcase # 'öıüëâñà'
ওয়ার্কঅরাউন্ড ছিল ActiveSupport (Rails থেকে) বা অন্য এক্সটার্নাল জেম ব্যবহার করা, কিন্তু Ruby 2.4 থেকে আমাদের পূর্ণ Unicode কেস ম্যাপিং আছে:
# Ruby 2.4 এবং তার উপরে
'öıüëâñà'.upcase # 'ÖIÜËÂÑÀ'
ইমোজি নিয়ে কিছু ফান
ইমোজি Unicode এবং Ruby-এ কীভাবে কাজ করে সেটি দেখি:
'🖖'.chars # ["🖖"] এটি "Raised Hand with Part Between Middle and Ring Fingers," যেটিকে "Vulcan Salute" ইমোজিও বলা হয়। যদি আমাদের একই ইমোজি থাকে কিন্তু অন্য স্কিন টোণে যা ডিফল্ট নয়, তবে কিছু ইন্টারেস্টিং হয়:
'🖖🏾'.chars # ["🖖", "🏾"] তাহলে শুধু এক ক্যারেক্টার নয়, এক ইমোজির জন্য আমাদের দুটি ক্যারেক্টার আছে।
সেখানে কী হয়েছিল?
Unicode-এ কিছু ক্যারেক্টার একাধিক ক্যারেক্টারের কম্বিনেশন হিসেবে ডিফাইনড থাকে। এই কেসে, যদি কম্পিউটার এই দুটি ক্যারেক্টার একসাথে দেখে, তবে শুধু একটি দেখায় স্কিন টোণ অ্যাপ্লাই করে।
ফ্ল্যাগ নিয়ে আরেকটি ফান উদাহরণ আছে।
'🇦🇺'.chars # ["🇦", "🇺"] Unicode-এ, ফ্ল্যাগ ইমোজি ইন্টারন্যালি কিছু অ্যাবস্ট্রাক্ট Unicode ক্যারেক্টার দিয়ে রিপ্রেজেন্ট করা হয় যাকে "Regional Indicator Symbols" বলা হয় যেমন 🇦 বা 🇿। সেগুলো সাধারণত ফ্ল্যাগের বাইরে ব্যবহার হয় না, এবং যখন কম্পিউটার দুটি সিম্বল একসাথে দেখে, তবে সেটি ফ্ল্যাগ দেখায় যদি সেই কম্বিনেশনের জন্য ফ্ল্যাগ থাকে।
আপনি নিজে দেখতে পারেন, এই টেক্সট কপি করে যেকোনো টেক্সট এডিটরে বা ফিল্ডে কমা মুছে দিয়ে:
🇦,🇺 উপসংহার
আশা করি Unicode এবং UTF-8 কীভাবে কাজ করে এবং সেগুলো Ruby এবং পোটেনশিয়াল এররোর সাথে কীভাবে রিলেটেড সেটি রিভিউ আপনাকে উপযোগী লাগল।
সর্বোচ্চ গুরুত্বপূর্ণ লেসন হচ্ছে মনে রাখা যে আপনি যেকোনো টেক্সট নিয়ে কাজ করছেন, সেটির সাথে একটি এনকোডিং সিস্টেম জড়িত, এবং সেটি স্টোর বা চেঞ্জ করার সময় উপস্থিত রাখা গুরুত্বপূর্ণ। আপনি যদি পারেন, আধুনিক এনকোডিং সিস্টেম যেমন UTF-8 ব্যবহার করুন যাতে ভবিষ্যতে এটিকে চেঞ্জ করতে না হয়।
Ruby রিলিজ সম্পর্কে নোট
এই আর্টিকেলের সব উদাহরণে আমি Ruby 2.6.5 ব্যবহার করেছি। আপনি অনলাইন REPL-এ বা লোকালি আপনার টার্মিনালে irb এক্সিকিউট করে ট্রাই করতে পারেন যদি Ruby ইনস্টলড থাকে।
যেহেতু Unicode সাপোর্ট লেটেস্ট রিলিজগুলোতে উন্নত হয়েছে, আমি লেটেস্ট ব্যবহার করেছি যাতে আর্টিকেলটি প্রাসঙ্গিক থাকে। যেকোনো কেসে, Ruby 2.4 এবং তার উপরে, সব উদাহরণ এখানে দেখানো অনুযায়ী কাজ করবে।
