

মূলভাবে Tricore দ্বারা প্রকাশিত: জুলাই ১১, ২০১৭
Apache™ Hadoop®-এ এই দুই পর্বের সিরিজের প্রথম পর্বে, আমরা Hadoop ইকোসিস্টেম এবং Hadoop ফ্রেমওয়ার্ক পরিচয় করিয়েছিলাম। দ্বিতীয় পর্বে, আমরা Hadoop ফ্রেমওয়ার্কের আরও কোর কম্পোনেন্ট কভার করব, যার মধ্যে কোয়েরি, এক্সটার্নাল ইন্টিগ্রেশন, ডেটা এক্সচেঞ্জ, কোঅর্ডিনেশন, এবং ম্যানেজমেন্টের জন্য রয়েছে। আমরা একটি মডিউলও পরিচয় করব যা Hadoop ক্লাস্টার মনিটর করে।
কোয়েরি
এই সিরিজের প্রথম পর্বে Apache Pig™-কে একটি স্ক্রিপ্টিং টুল হিসেবে পরিচয় করানো হয়েছিল। Pig Latin-এ লেখা, Pig এক্সিকিউটেবল MapReduce জবে ট্রান্সলেট হয়। এটি অনেক সুবিধা অফার করে যা আপনি প্রথম পর্বে জানতে পারেন।
তবে, কিছু ডেভেলপার এখনও SQL পছন্দ করেন। আপনি যদি জানা পথে যেতে চান, তবে আপনি Hadoop-এ SQL ব্যবহার করতে পারেন।
Hive
Apache Hive™ একটি ডিস্ট্রিবিউটেড ডেটা ওয়ারহাউস যা বড় পরিমাণ ডেটা ম্যানেজ এবং অর্গানাইজ করে। এই ওয়ারহাউস Hadoop Distributed File System (HDFS™)-এর ওপর তৈরি। Hive কোয়েরি ল্যাঙ্গুয়েজ, HiveQL, SQL সেমান্টিক্সের ওপর ভিত্তি করে। রানটাইম ইঞ্জিন HiveQL-কে MapReduce জবে কনভার্ট করে যা ডেটা কোয়েরি করে।
Hive নিচের ক্যাপাবিলিটি অফার করে:
বড় পরিমাণ রস ডেটা হাউস করার জন্য একটি স্কিমাটাইজড ডেটা স্টোর।
HDFS-এ রস ডেটায় অ্যানালিসিস এবং কোয়েরি এক্সিকিউট করার জন্য একটি SQL-লাইক এনভায়রনমেন্ট।
বহিরাগত রিলেশনাল ডাটাবেস ম্যানেজমেন্ট সিস্টেম (RDBMS) অ্যাপ্লিকেশনের সাথে ইন্টিগ্রেশন।
নিচের ছবিটি Hadoop ইকোসিস্টেমের আর্কিটেকচার ভিজ্যুয়ালাইজ করে:
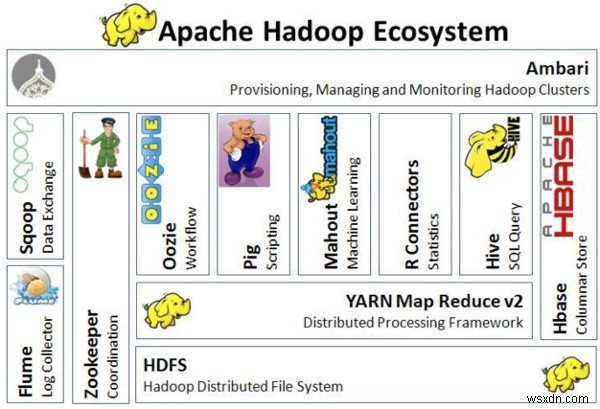 Architecture of the Hadoop ecosystem
এক্সটার্নাল ইন্টিগ্রেশন
Apache Flume™ একটি ডিস্ট্রিবিউটেড, নির্ভরযোগ্য, এবং উপলব্ধ সার্ভিস যা কার্যকরভাবে বড় পরিমাণ লগ ডেটা কালেক্ট, অ্যাগ্রিগেট, এবং HDFS-এ সরানোর জন্য। Flume বড় পরিমাণ ইভেন্ট ডেটা ট্রান্সপোর্ট করে একটি স্ট্রিমিং ডেটা ফ্লো আর্কিটেকচার ব্যবহার করে যা ফল্ট টলারেন্ট এবং ফেইলওভার রিকভারি রেডি।
Flume নিচের ক্যাপাবিলিটিও অফার করে:
নেটওয়ার্ক ট্রাফিক, লগ, এবং ইমেইল মেসেজ যেন বড় পরিমাণ ইভেন্ট ডেটা ট্রান্সপোর্ট করে।
মাল্টিপল সোর্স থেকে HDFS-এ ডেটা স্ট্রিম করে।
Hadoop অ্যাপ্লিকেশনের জন্য নির্ভরযোগ্য, রিয়েল-টাইম ডেটা স্ট্রিমিং গ্যারান্টি করে।
ডেটা এক্সচেঞ্জ
Apache Sqoop™ ডিজাইন করা হয়েছে Hadoop এবং এক্সটার্নাল ডেটা স্টোর যেমন রিলেশনাল ডাটাবেস এবং এন্টারপ্রাইজ ডেটা ওয়ারহাউসের মধ্যে কার্যকরভাবে বাল্ক ডেটা ট্রান্সফার করার জন্য। Sqoop রিলেশনাল ডাটাবেস যেমন Teradata Database, IBM® Netezza, Oracle® Database, MySQL™, এবং PostgreSQL®-এর সাথে কাজ করে। বাল্ক ডেটা কালেক্ট বা অ্যানালাইজ করা অধিকাংশ কোম্পানিতে Sqoop ব্যাপকভাবে ব্যবহৃত হয়।
Sqoop নিচের ফাংশনালিটি অফার করে:
ডাটাবেসের উপর নির্ভর করে, এটি ইম্পোর্টেড ডেটার স্কিমা ডেসক্রাইব করার প্রসেসের অধিকাংশ অটোমেট করতে পারে।
এটি ডেটা ইম্পোর্ট এবং এক্সপোর্ট করার জন্য MapReduce ফ্রেমওয়ার্ক ব্যবহার করে। এটি Sqoop-কে প্যারালেল মেকানিজম এবং ফল্ট টলারেন্স প্রদান করতে সক্ষম করে।
এটি সকল মেজর RDBMS ডাটাবেসের জন্য কানেক্টর প্রদান করে।
এটি ফুল এবং ইনক্রিমেন্টাল লোড, ডেটার প্যারালেল এক্সপোর্ট এবং ইম্পোর্ট, এবং ডেটা কমপ্রেশন সাপোর্ট করে।
এটি Kerberos সিকিউরিটি ইন্টিগ্রেশন সাপোর্ট করে।
কোঅর্ডিনেশন
Apache Zookeeper™ ডিস্ট্রিবিউটেড অ্যাপ্লিকেশনের জন্য একটি কোঅর্ডিনেশন সার্ভিস যা ক্লাস্টার জুড়ে সিঙ্ক্রোনাইজেশন সক্ষম করে। এটি একটি সেন্ট্রালাইজড রিপোজিটরি প্রদান করে যেখানে ডিস্ট্রিবিউটেড অ্যাপ্লিকেশন ডেটা স্টোর এবং রিট্রিভ করতে পারে।
Zookeeper একটি অ্যাডমিনিস্ট্রেটিভ Hadoop টুল যা ক্লাস্টারে জব ম্যানেজ করতে ব্যবহৃত হয়। কিছু ডেভেলপার এই টুলকে "watch guard" বলে কারণ এক নোডে ডেটায় যেকোনো পরিবর্তন অন্য নোডগুলোর সাথে যোগাযোগ করা হয়।
প্রোভিশনিং, ম্যানেজিং, এবং মনিটরিং Hadoop ক্লাস্টার
Apache Ambari™ একটি ওয়েব-ভিত্তিক টুল Apache Hadoop ক্লাস্টার প্রোভিশন, ম্যানেজ, এবং মনিটর করার জন্য। এর একটি খুব সিম্পল কিন্তু হাইলি ইন্টারঅ্যাক্টিভ ইউজার ইন্টারফেস রয়েছে টুল ইনস্টল এবং ম্যানেজমেন্ট, কনফিগারেশন, এবং মনিটরিং টাস্ক পারফর্ম করার জন্য। Ambari একটি ড্যাশবোর্ড প্রদান করে ক্লাস্টার হেলথের ইনফোরমেশন দেখার জন্য, যেন হিট ম্যাপ। এটি আপনাকে আপনার MapReduce, Pig, এবং Hive অ্যাপ্লিকেশন ফিচারসহ পাশাপাশি দেখতে সক্ষম করে যাতে আপনি সহজে তাদের পারফরম্যান্স ক্যারাক্টেরিস্টিক ডায়াগনোস করতে পারেন।
Ambari নিচের ক্যাপাবিলিটিও প্রদান করে:
মাস্টার সার্ভিসেস ম্যাপিং উইথ নোডস।
যে সার্ভিসগুলো আপনি ইনস্টল করতে চান সেগুলো বেছে নেওয়ার ক্ষমতা।
সিম্পল কাস্টম স্ট্যাক সিলেকশন।
একটি ক্লিনার ইন্টারফেস।
স্ট্রিমলাইনড ইনস্টলেশন, মনিটরিং, এবং ম্যানেজমেন্ট।
উপসংহার
Hadoop তাদের জন্য খুব কার্যকর সমাধান যারা বড় পরিমাণ ডেটা স্টোর এবং অ্যানালাইজ করতে চান। এটি ডিস্ট্রিবিউটেড সিস্টেমে ডেটা ম্যানেজমেন্টের জন্য খুব.after_demand টুল। কারণ এটি ওপেন সোর্স, এটি কোম্পানিগুলো ফ্রিতে লিভারেজ করতে পারেন। Hadoop সম্পর্কে আরও জানতে, Apache Software Foundation ওয়েবসাইটের অফিসিয়াল ডকুমেন্টেশন দেখুন।
আপনি কি Hadoop ব্যবহার করেছেন? Feedback ট্যাব ব্যবহার করে যেকোনো মন্তব্য বা প্রশ্ন করুন।
