

মূলভাবে Tricore দ্বারা প্রকাশিত: জুলাই ১০, ২০১৭
Apache™ Hadoop® একটি ওপেন সোর্স, জাভা-ভিত্তিক ফ্রেমওয়ার্ক যা ডিস্ট্রিবিউটেড কম্পিউটিং এনভায়রনমেন্টে বড় পরিমাণ ডেটা প্রসেস করার জন্য ডিজাইন করা হয়েছে। Doug Cutting এবং Mike Cafarella Hadoop ডেভেলপ করেছেন, যা ২০০৫ সালে রিলিজ করা হয়েছিল।
কমোডিটি হার্ডওয়্যারের ওপর নির্মিত, Hadoop এই বেসিক অনুমানের ওপর কাজ করে যে হার্ডওয়ার ফেইলার সাধারণ। Hadoop ফ্রেমওয়ার্ক এই ফেইলারগুলোর সমাধান করে।
এই দুই পর্বের ব্লগ সিরিজের প্রথম পর্বে, আমরা বিগ ডেটা, Hadoop ইকোসিস্টেম, এবং Hadoop ফ্রেমওয়ার্কের কিছু মূল কম্পোনেন্ট কভার করব।
ডেটা অনাদি বড়
সকল সংস্থার জন্য ডেটা অত্যন্ত গুরুত্বপূর্ণ, এবং বিগ ডেটা নতুন সুযোগ খুলছে বিশ্লেষণের জন্য যেগুলো মূল্যবান ব্যবসায়িক ইনসাইটে নিয়ে যেতে পারে। বিগ ডেটা বলতে সংস্থার স্টোরেজ ক্যাপাসিটি এবং প্রসেসিং পাওয়ারের বাইরে ডেটাকে বোঝায়।
বিগ ডেটা সোশ্যাল নেটওয়ার্ক, ক্লোজড ক্যাপশন টেলিভিশন (CCTV) ক্যামেরা, সেন্সর, অনলাইন শপিং পোর্টাল, হসপিটালিটি ডেটা, গ্লোবাল পজিশনিং সিস্টেম (GPS), অটোমোবাইল ইন্ডাস্ট্রি, এবং অন্যান্য উৎস থেকে উদ্ভূত হতে পারে যেগুলো বিশাল পরিমাণ ইনফরমেশন জেনারেট করে।
বিগ ডেটার তিনটি মূল দিক রয়েছে, যেগুলো দুর্দান্ত গতিতে প্রগতি করছে:
Volume (আয়তন): বিগ ডেটার আয়তন দ্রুত বেড়ছে গিগাবাইট থেকে টেরাবাইট এবং পেটাবাইটে। এটিকে স্টোর করতে বিশাল পরিমাণ ডিস্ক স্পেস লাগে।
Velocity (বেগ): বিগ ডেটা সাধারণত ডেটা সেন্টারে স্টোর থাকে। লোকাল ওয়ার্কস্টেশনে ডেটা ডেলিভারি করতে হাই-স্পিড ডেটা প্রসেসর লাগে।
Variety (বৈচিত্র্য): ডেটা বড় পক্ষাপাতে স্ট্রাকচার্ড, আনস্ট্রাকচার্ড, বা সেমি-স্ট্রাকচার্ড হিসেবে শ্রেণিবদ্ধ করা যায়।
আমরা বিগ ডেটাকে নিচের সমীকরণ দিয়ে সারসংক্ষেপ করতে পারি:
Big data = (Volume + Velocity + Variety) of data
নিচের ছবিটি এই কনসেপ্টগুলো ভিজ্যুয়ালাইজ করে।
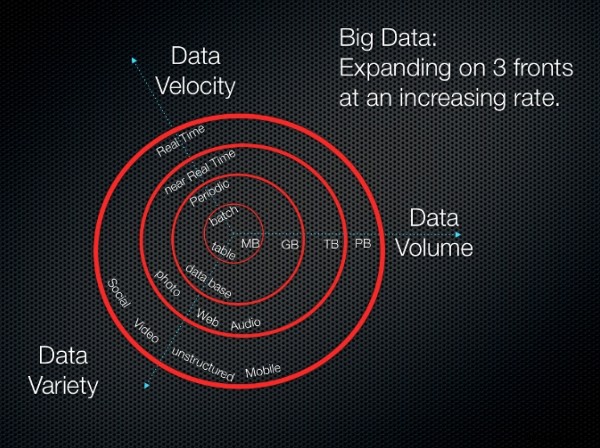 3Vs (volume, variety, and velocity)
Image source: 3Vs (volume, variety and velocity)
Hadoop ইকোসিস্টেম
Hadoop ইকোসিস্টেম শব্দটি Apache Hadoop সফটওয়্যার লাইব্রেরির বিভিন্ন কম্পোনেন্টকে বোঝায়। এই ইকোসিস্টেম একটি সেট আলাদা মডিউল से গঠিত যা পরস্পর ইন্টারঅ্যাক্ট করে। এই মডিউলগুলো বিগ ডেটা প্রসেসিং-এ জড়িত অনন্য রিকোয়ারমেন্ট সমাধান করার জন্য ডিজাইন করা টুল এবং অ্যাকসেসরি সেট প্রদান করে। ইকোসিস্টেমটি Hadoop-এর সকল মডিউলকে घেরে রাখে, যার মধ্যে Hadoop ফ্রেমওয়ার্কের মূল কম্পোনেন্টগুলো রয়েছে যা আমরা নিচে আলোচনা করব, সেইসাথে অ্যাড-অন মডিউলও।
Hadoop ফ্রেমওয়ার্কের কম্পোনেন্ট
Hadoop ফ্রেমওয়ার্ক নিচের মূল কম্পোনেন্টগুলো ধারণ করে।
ডিস্ট্রিবিউটেড স্টোরেজ
Hadoop-এ ডিস্ট্রিবিউটেড স্টোরেজ সক্ষম করতে বেশ কিছু আলাদা টুকরো একসাথে আসে।
Hadoop Distributed File System
Hadoop-এ, ডিস্ট্রিবিউটেড স্টোরেজকে Hadoop Distributed File System (HDFS) বলা হয়। এই সিস্টেম রিডান্ড্যান্ট স্টোরেজ প্রদান করে এবং এর নিচের বৈশিষ্ট্যগুলো রয়েছে:
কমোডিটি হার্ডওয়্যারে ডেটা নির্ভরযোগ্যভাবে স্টোর করার জন্য ডিজাইন করা।
হার্ডওয়ার ফেইলার অহ্বান করার জন্য নির্মিত।
- বড় ফাইল এবং ব্যাচ ইনসার্টের জন্য অভিপ্রেত। (একবার লিখুন, অনেকবার পড়ুন।)
HBase
HBase একটি ডিস্ট্রিবিউটেড, কলাম-ওরিয়েন্টেড NoSQL ডাটাবেস। HBase তার আন্ডারলাইং স্টোরেজের জন্য HDFS ব্যবহার করে এবং MapReduce ব্যবহার করে ব্যাচ-স্টাইল কম্পিউটেশন এবং পয়েন্ট কোয়েরি (র্যান্ডম রিড) দুটোই সাপোর্ট করে।
HBase নিচের কাজগুলোও করে:
কমোডিটি হার্ডওয়্যারের ক্লাস্টার উপরে বড় ডেটা ভলিউম (বিলিয়ন রো পর্যন্ত) স্টোর করে।
লগ, ডকুমেন্ট, রিয়েল-টাইম এক্টিভিটি ফিড, এবং রস ইম্পোর্টেড ডেটা বাল্ক স্টোর করে।
Hadoop অ্যাপ্লিকেশন যেগুলো ব্যবহার করে সেসব ডেটায় কনসিস্টেন্টলি রিড এবং রাইট করে।
ডেটা স্টোরকে MapReduce ফাংশনালিটি ব্যবহার করে অ্যাগ্রিগেট বা প্রসেস করতে সক্ষম করে।
আনালিটিক্স এবং মেশিন লার্নিং-এর জন্য ডেটা প্ল্যাটফর্ম অফার করে।
HCatalog
HCatalog Hadoop-এর জন্য একটি টেবিল এবং স্টোরেজ ম্যানেজমেন্ট লেয়ার যা Hadoop অ্যাপ্লিকেশন যেমন Pig™, MapReduce, এবং Hive™-কে ফাইলসের পরিবর্তে টেবুলার ফরম্যাটে ডেটা পড়তে এবং লিখতে সক্ষম করে।
এটি নিচের ফিচারগুলোও অফার করে:
Hadoop অ্যাপ্লিকেশন যেগুলো ব্যবহার করে সেসব ডেটা স্টোর করার জন্য একটি সেন্ট্রালাইজড লোকেশন।
সিকোয়েন্সড এবং ইটারেটেড Hadoop প্রসেসের জন্য একটি রিযুজেবল ডেটা স্টোর।
রিলেশনাল অ্যাবস্ট্রাকশনে ডেটা স্টোরেজ।
মেটাডেটা ম্যানেজমেন্ট।
ডিস্ট্রিবিউটেড প্রসেসিং
Hadoop MapReduce এবং Yet Another Resource Negotiator (YARN)-এ নির্ভর করে ডিস্ট্রিবিউটেড প্রসেসিং সক্ষম করতে।
MapReduce
MapReduce একটি ডিস্ট্রিবিউটেড ডেটা প্রসেসিং মডেল এবং এক্সিকিউশন এনভায়রনমেন্ট যা কমোডিটি মেশিনের বড় ক্লাস্টার ওপর চলে। MapReduce আপনাকে আপনার স্টোর করা ডেটা থেকে ইনসাইট তৈরি করতে সক্ষম করে। এটি MapReduce অ্যালগরিদম ব্যবহার করে সকল অপারেশনকে Map বা Reduce ফাংশনে ভাঙে।
MapReduce নিচের সুবিধাগুলো অফার করে:
বড় এবং বিচিত্র ডেটা সেটে অ্যাগ্রিগেশন (কাউন্টিং, সর্টিং, এবং ফিল্টারিং)।
Map বা Reduce টাস্কের স্কেলেবল প্যারালেলিজম।
ডিস্ট্রিবিউটেড টাস্ক এক্সিকিউশন।
YARN
YARN Apache Hadoop ইকোসিস্টেমের জন্য ক্লাস্টার এবং রিসোর্স ম্যানেজমেন্ট লেয়ার। এটি Hadoop ফ্রেমওয়ার্কের দ্বিতীয় প্রজন্মের প্রধান ফিচারগুলোর একটি।
YARN নিচের ফাংশনালিটি অফার করে:
এটি অ্যাপ্লিকেশন শিডিউল করে টাস্ক প্রায়োরিটাইজ করতে এবং বিগ ডেটা অ্যানালিটিক্স সিস্টেম মেইনটেইন করতে।
একটি বড় আর্কিটেকচারের একটি অংশ হিসেবে, YARN ডেটা অ্যাগ্রিগেট এবং সর্ট করে স্পেসিফিক কোয়েরি কন্ডাক্ট করতে ডেটা রিট্রিভালের জন্য।
এটি নির্দিষ্ট অ্যাপ্লিকেশনের জন্য রিসোর্স অ্যালোকেট করতে সাহায্য করে এবং অন্যান্য রিসোর্স মনিটরিং টাস্ক ম্যানেজ করে।
মেশিন লার্নিং
Hadoop Apache Mahout দিয়ে মেশিন লার্নিং সাপোর্ট করে, একটি ওপেন সোর্স প্রজেক্ট যা প্রাথমিকভাবে স্কেলেবল মেশিন লার্নিং অ্যালগরিদম তৈরি করতে ব্যবহৃত হয়। Mahout একটি ডেটা মাইনিং ফ্রেমওয়ার্ক যা সাধারণত Hadoop ইনফ্রাস্ট্রাকচার ব্যাকগ্রাউন্ডে রান করে বড় পরিমাণ ডেটা ম্যানেজ করতে।
Mahout নিচের ক্যাপাবিলিটি অফার করে:
বড় পরিমাণ ডেটায় ডেটা মাইনিং টাস্ক পারফর্ম করার জন্য একটি রেডি-টু-ইউজ ফ্রেমওয়ার্ক।
Hadoop-এর ওপর লিখিত অ্যালগরিদম, যা Mahout-কে ডিস্ট্রিবিউটেড এনভায়রনমেন্টে ভালো কাজ করতে সক্ষম করে।
বড় ডেটা সেটের দ্রুত বিশ্লেষণ।
এভোলিউশনারি প্রোগ্রামিং-এর জন্য ডিস্ট্রিবিউটেড ফিটনেস ফাংশন ক্যাপাবিলিটি। এছাড়া ম্যাট্রিক্স এবং ভেক্টর লাইব্রেরি রয়েছে।
ওয়ার্কফ্লো মনিটরিং এবং শিডিউলিং
Oozie Hadoop-এর জব ম্যানেজ করার সিস্টেম। এই ওয়ার্কফ্লো শিডিউলার ডিপেন্ডেন্ট জবগুলোর ওয়ার্কফ্লো রান করে। এটি ইউজারদের ডিরেক্টেড এসাইক্লিক গ্রাফ (DAGs) তৈরি করতে সক্ষম করে ওয়ার্কফ্লোর যেগুলো Hadoop-এ প্যারালেল এবং সিকোয়েনশিয়াল জব রান করে।
Oozie খুব ফ্লেক্সিবল। আপনি সহজে জব শুরু, বন্ধ, সাসপেন্ড, এবং রি-রান করতে পারেন। Oozie ব্যর্থ ওয়ার্কফ্লো রি-রান করা খুব সহজ করে দেয়।
Oozie স্কেলেবল এবং একটি Hadoop ক্লাস্টারে হাজার হাজার ওয়ার্কফ্লো (প্রতিটি দर्जন জব সম্বলিত) এর টাইমলি এক্সিকিউশন ম্যানেজ করতে পারে।
স্ক্রিপ্টিং
ডেভেলপাররা Hadoop-এ স্ক্রিপ্টিংয়ের জন্য Apache Pig ব্যবহার করতে পারেন। স্ক্রিপ্টিং SQL-ভিত্তিক ল্যাঙ্গুয়েজ এবং এক্সিকিউশন এনভায়রনমেন্ট ব্যবহার করে কমপ্লেক্স MapReduce ট্রান্সফরমেশন তৈরি করতে। যদিও Pig Pig Latin কোডিং ল্যাঙ্গুয়েজে লেখা হয়, এটি এক্সিকিউটেবল MapReduce জবে ট্রান্সলেট হয়। Pig ইউজারদের এক্সটেন্ডেড বা ইউজার-ডিফাইনড ফাংশন (UDFs) জাভা ব্যবহার করে তৈরি করতে সক্ষম করে।
Pig নিচের কন্টেন্টগুলোরও অফার করে:
HDFS-এ রস ডেটায় Extract-Transform-Load (ETL) টাস্ক এবং প্রসিডিউর এক্সিকিউট করার জন্য একটি স্ক্রিপ্টিং এনভায়রনমেন্ট।
কমপ্লেক্স Map Reduce ফাংশন তৈরি এবং রান করার জন্য একটি SQL-ভিত্তিক ল্যাঙ্গুয়েজ।
বড় এবং বিচিত্র ডেটা সেটে ডেটা প্রসেসিং, স্টিচিং, এবং স্কিমাটাইজিং।
একটি হাই-লেভেল ডেটা ফ্লো ল্যাঙ্গুয়েজ।
একটি অ্যাবস্ট্রাকশন লেয়ার যা আপনাকে ডেটা প্রসেসিং-এ ফোকাস করতে সক্ষম করে।
উপসংহার
Hadoop এবং MapReduce ফ্রেমওয়ার্কের ইতিমধ্যে বায়োইনফরমেটিক্স কমিউনিটিতে উল্লেখযোগ্য ইউজার বেস রয়েছে, বিশেষ করে নেক্সট-জেনারেশন সিকোয়েন্সিং অ্যানালিসিস ক্ষেত্রে। এর এই ক্ষেত্রে জনপ্রিয়তা আংশিকভাবে এর রবাস্ট, ফল্ট-টলারেন্ট HDFS-এর কারণে।
HBase একটি ডিস্ট্রিবিউটেড, ফল্ট-টলারেন্ট, স্কেলেবল ডাটাবেস যোগ করে যা HDFS ফাইল সিস্টেমের ওপর নির্মিত, র্যান্ডম রিয়েল-টাইম রিড এবং রাইট অ্যাক্সেস ডেটায়। আপনি Mahout চেক আউট করতে পারেন স্কেলেবল মেশিন লার্নিং লাইব্রেরি বিল্ড করতে, অথবা Pig ব্যাচ প্রসেসিং ডেটার জন্য।
এই সিরিজের পর্ব ২-এ, আমরা Hadoop ইকোসিস্টেমের আরও কম্পোনেন্ট কভার করব।
Feedback ট্যাব ব্যবহার করে যেকোনো মন্তব্য বা প্রশ্ন করুন।
