

ভাষা ও ভাষাবিজ্ঞান গবেষণায় শব্দ কীভাবে ব্যবহার হয়, বিশেষ করে সময়ের সাথে সাথে, সেটা জানতে ডেটা প্রয়োজন। গবেষণা আবশ্যক হলেও, আপনার প্রয়োজনীয় ডেটা দিয়ে দিতে পারে এমন টুল থাকলে সুবিধা হয়। গুগল বুকস লাইব্রেরি থেকে শব্দ ট্রেন্ড দ্রুত খুঁজে বের করার জন্য গুগল এনগ্রাম ভিউয়ার (Google Ngram Viewer) একটি চমৎকার টুল।
এই পোস্টে আমরা দেখাবো কীভাবে গুগল এনগ্রাম আরও কার্যকরভাবে ব্যবহার করা যায়। প্রথমে, আপনাকে টুলটির সাথে পরিচয় করাই।
গুগল এনগ্রাম পরিচিতি
গুগল একটি বহুভাষিক ডাটাবেস মেইনটেইন করে প্রকাশিত ভাষার। বইগুলো বড় পরিমাণে স্ক্যান করে, সার্চ জায়ান্টটি টেক্সট প্রসেস করতে পারে এবং শব্দের ফ্রিকোয়েন্সি ভিত্তিক статистиক প্রদান করতে পারে।
গুগল এনগ্রাম ভিউয়ার সার্চ টুল দিয়ে আপনি এই ডেটা সার্চ করতে পারেন। শব্দগুলোর আপেক্ষিক জনপ্রিয়তা তুলনা করে, আপনি ভাষা ও সংস্কৃতি কীভাবে সময়ের সাথে পরিবর্তন হয়েছে সেটা ম্যাপ করতে পারেন।
তবে, গুগল এনগ্রাম টুল শুধু শব্দ ফ্রিকোয়েন্সি রিপোর্ট করছে না, এর চেয়ে অনেক বেশি কিছু করতে পারে, যা আমরা এগিয়ে দেখব।
বেসিক সার্চ করার পদ্ধতি
এডভান্সড "ট্যাকটিক্স"-এ যাওয়ার আগে, বেসিক সার্চ কীভাবে করবেন সেটা দেখি। গুগল এনগ্রাম পেজ থেকে সার্চ বক্সে একটি কিওয়ার্ড টাইপ করুন।
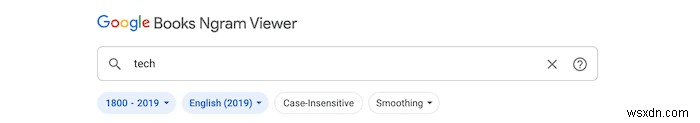
আপনি যদি শব্দের সকল ক্যাপিটালাইজেশন ইনক্লুড করতে চান, তবে Case-Insensitive বাটনে টিক দিন। এই সার্চে "Tech" এবং "tech" উভয়ই থাকবে।
সার্চ বক্সের নিচে আপনি প্যারামিটারও সেট করতে পারেন যেমন ডেট রেঞ্জ এবং "smoothing"। স্মুথিং মান আপনার ডেটা থেকে অটিপিক্যাল স্পাইক ও ডিপ সরিয়ে দেয়। কম স্মুথিং মান বেশি প্রিসাইজ, বেশি মান শুধু গভীর ট্রেন্ড দেখায়।
"Corpus" সিলেক্ট করার পদ্ধতি
Corpus হলো টেক্সট কালেকশন যা এনগ্রাম ভিউয়ার পরীক্ষা করবে। ডিফল্ট "English" ক্যাজুয়াল ব্রাউজিংয়ের জন্য গ্রহণযোগ্য কিন্তু একাডেমিক হতে পারে।
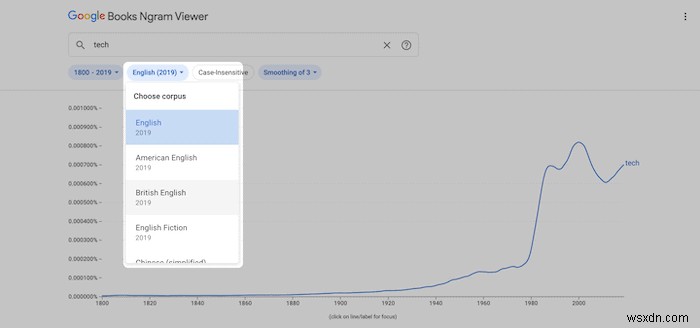
"English Fiction" সাধারণ ভাষাকে আরও কাছাকাছি প্রতিফলিত করে। স্ট্যান্ডার্ড "English" corpus নন-ফিকশন ভারী হতে পারে টেকনিক্যাল শব্দের সাথে।
আপনার corpus চয়ন গভীর অর্থ এই লেখার সুযোগের বাইরে, গুগল আপনার জন্য সঠিক চয়ন সম্পর্কে সংক্ষিপ্ত ইনসাইট দেয়।
এডভান্সড সার্চ চালান
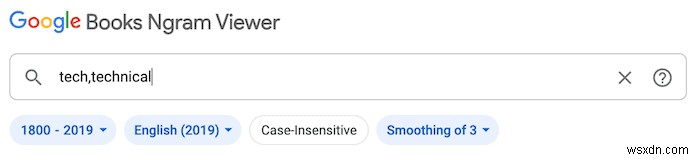
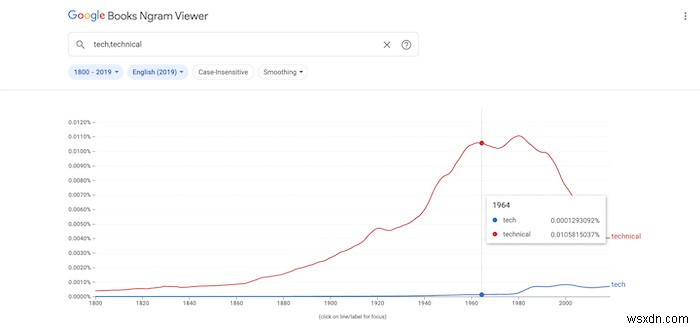
অতিরিক্ত সার্চ শব্দ ব্যবহার করে আপনি জটিল তুলনা করতে পারেন। প্রতিটি টার্ম কমা দিয়ে আলাদা করুন।
এনগ্রাম ভিউয়ার আপনার সার্চ টার্মগুলোর আপেক্ষিক ফ্রিকোয়েন্সি একটি সিঙ্গল গ্রাফে দেখাবে। আপনি গ্রাফের লাইনের ওপর হোভার করলে প্রিসাইজ ডেটা পয়েন্ট দেখতে পারেন।
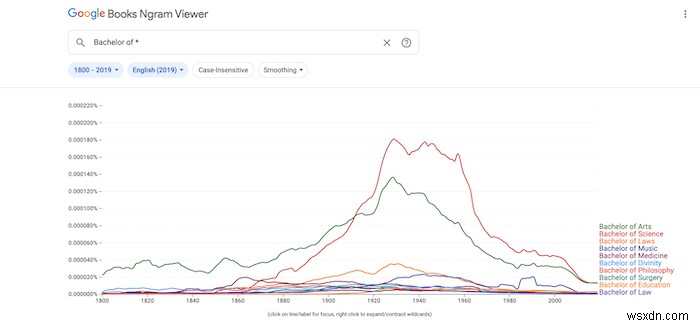
আপনি আপনার সার্চ টার্মে এস্টারিস্ক (*) ব্যবহার করতে পারেন 와일্ডকার্ড হিসেবে। উদাহরণস্বরূপ, "Bachelor of *" অনেক ব্যাচেলর ডিগ্রির রেজাল্ট রিটার্ন করবে।
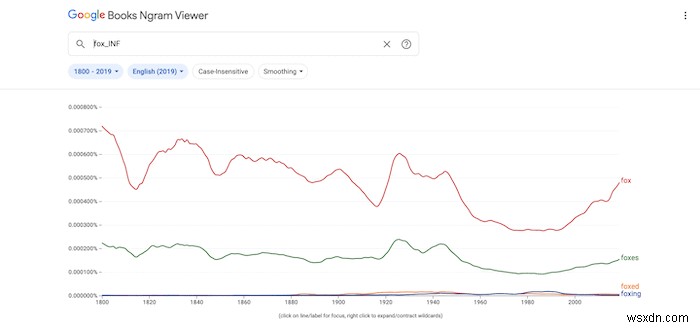
একটি টার্মের সকল ইনফ্লেকশন খুঁজে বের করতে "_INF" মডিফায়ার অ্যাপেন্ড করুন।
যদি একটি শব্দ অনেক পার্ট অফ স্পিচ সম্বলিত থাকে, তবে টেক্সট অপারেটর ব্যবহার করে আরও স্পেসিফিক হতে পারেন। গুগলের ডাটাবেসে বৈধ পার্ট অফ স্পিচগুলো হলো:
- _ADJ_: অ্যাডজেক্টিভ (fast, large, smart)
- _ADV_: অ্যাডভার্ব (quickly, later, always)
- _PRON_: প্রোনাউন (their, it, we)
- _DET_: ডিটারমাইনার বা আর্টিকেল (a, an, the)
- _ADP_: অ্যাডপজিশন (প্রিপজিশন ও পোস্টপজিশন)
- _NUM_: न्यুমেরাল (first, second, fifth)
- _CONJ_: কানজাঙ্কশন (and, nor, but)
- _PRT_: পার্টিকেল, অন্যান্য শব্দ ফাংশনের জন্য ক্যাচ-অল, বিরল ব্যবহৃত ক্যাটাগরি
এইগুলো ফ্রেজে কম্বাইন করা যায়। উদাহরণস্বরূপ, "_ADJ_ boy" অ্যাডজেক্টিভ এবং "boy" শব্দের ওয়ার্ড পেয়ার রিটার্ন করবে।
একটি সার্চ টার্মের জন্য স্পেসিফিক পার্ট অফ স্পিচ নির্দিষ্ট করতে, এটিকে শেষে অ্যাপেন্ড করুন। উদাহরণস্বরূপ, "water_VERB" ট্রেইলিং আন্ডারস্কোর ছাড়া। একটি দেয়া শব্দের সকল পার্ট অফ স্পিচ ইনক্লুড করতে, আন্ডারস্কোরের পর 와일্ডকার্ড অপারেটর ব্যবহার করুন।
ফাংশনাল ভেরিয়েবল, কম্পোজিশন, এবং ডিপেনডেন্সি
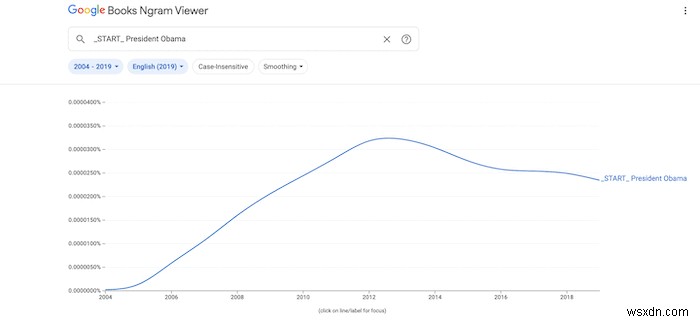
ফাংশনাল ভেরিয়েবল আপনাকে শব্দের ফাংশন বা প্লেসমেন্ট দিয়ে সার্চ করতে দেয়।
- _ROOT_ হলো সেন্টেন্সের পার্স ট্রির রুটের প্লেসহোল্ডার। এটি সাধারণত প্রাইমারি সাবজেক্ট বা ভার্ব দ্বারা মডিফাইড শব্দ।
- _START_ নির্দেশ করে সেন্টেন্সের শুরু। ("_START_ President Obama" শুধু সেই সেন্টেন্সগুলো রিটার্ন করবে যা "President Obama" ফ্রেজ দিয়ে শুরু হয়।)
- _END_ নির্দেশ করে সেন্টেন্সের শেষ। ("_ADP_ _END_" প্রিপজিশনে শেষ হওয়া সেন্টেন্সগুলো রিটার্ন করবে।)
সার্চ টার্মগুলো=arithmetic অপারেটরসহ কম্বাইন করলে, আপনি টার্ম ফ্রিকোয়েন্সির মান দিয়ে সহজ ম্যাথম্যাটিক্যাল অ্যানালিসিস করতে পারেন:
- + একাধিক এক্সপ্রেশন এক সার্চ টার্মে যোগ করে
- − লেফট এক্সপ্রেশন থেকে রাইট এক্সপ্রেশন বিয়োগ করে, দুটি সার্চ টার্মের আপেক্ষিক ব্যবহার দ্রুত তুলনা করতে
- / লেফট এক্সপ্রেশনকে রাইট এক্সপ্রেশন দিয়ে ভাগ করে
- * এক্সপ্রেশন গুণ করে বিপরীত ফ্রিকোয়েন্সিवाले ngrams তুলনা করতে। পুরো ngram কে প্যারেনথেসিসে এনক্লোজ করুন যাতে এস্টারিস্ক ওয়াইল্ডকার্ড ক্যারেক্টার হিসেবে পার্স না হয়।
- : (কোলন) লেফট ngram কে রাইট corpus-এ সার্চ করে।
শেষে, আপনি "=>" দিয়ে ডিপেন্ডেন্সি সেট করতে পারেন লিংগুইস্টিক রিলেশনশিপ সার্চ করতে।
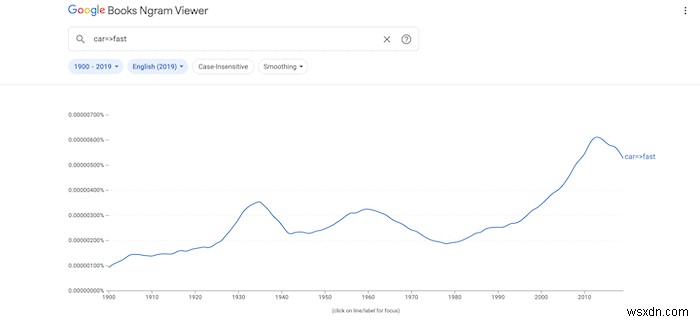
উদাহরণস্বরূপ, "car=>fast" সেই রেজাল্টগুলো রিটার্ন করবে যেখানে "fast" গ্রামারিক্যালি "car" শব্দের ওপর ডিপেন্ডেন্ট বা সেটাকে মডিফাই করে। এটাকে যেকোনো এডভান্সড সার্চ অপারেশনের সাথে মিক্স করা যায়।
উপসংহার
শব্দ ট্রেন্ড সার্চ করার অনেক একাডেমিক অ্যাপ্লিকেশন আছে। আপনার প্রয়োজনীয় ইনফো দ্রুত পাওয়ার উপায় হচ্ছে গুগলের এনগ্রাম টুল। ভালো খবর: এটি শুধু বেসিক সার্চ করাতে না, পাওয়ারফুল মডিফায়ারও দিয়ে আপনার প্রয়োজনীয় ইনফোতে ফোকাস করতে দেয়।
গুগল এনগ্রাম টুলের কোনো ফাংশনালিটি সার্চ ইঞ্জিনের এডভান্সড গ্রান্ট ছাড়া সম্ভব হতো না। গুগল এনগ্রাম টুল কী কী করতে পারে সেটি দেখে আপনি কি প্রফুল্লিত? কমেন্ট সেকশনে জানান!
