

রেডিসটাইমসিরিজ একটি রেডিস মডিউল যা রেডিসে নেটিভ টাইম-সিরিজ ডেটা স্ট্রাকচার নিয়ে আসে। আগে সর্টেড সেটস (অথবা রেডিস স্ট্রিমস) এর উপরে তৈরি টাইম-সিরিজ সমাধানগুলো রেডিসটাইমসিরিজের বৈশিষ্ট্যগুলি থেকে লাভান্বিত হতে পারে—যেমন উচ্চ-আয়তন ইনসার্ট, কম-লেটেন্সি রিড, নমনীয় কোয়েরি ল্যাঙ্গুয়েজ, ডাউন-স্যাম্পলিং, এবং আরও অনেক কিছু!
সাধারণভাবে বলতে গেলে, টাইম-সিরিজ ডেটা (সাপেক্ষিকভাবে) সরল।そう言うと, আমাদের অন্যান্য বৈশিষ্ট্যগুলোও বিবেচনা করতে হবে:
- ডেটা ভেলোসিটি: যেমন—হাজার হাজার ডিভাইস থেকে প্রতি সেকেন্ডে সैकड़ো মেট্রিক
- ভলিউম (বিগ ডেটা): মাস أبو accueillir বছরের পর মাস ডেটা জমা হতে পারে
সুতরাং, রেডিসটাইমসিরিজের মতো ডাটাবেসগুলো কেবল সমগ্র সমাধানের একটি অংশ। আপনাকে এটিও চিন্তা করতে হবে যে কীভাবে আপনার সকল ডেটা সংগ্রহ (ইনজেস্ট), প্রক্রিয়া, এবং পাঠানো যাবে রেডিসটাইমসিরিজে। আপনার যা ভাবেই দরকার সেটি হল একটি স্কেলেবল ডেটা পাইপলাইন যা প্রোডিউসার এবং কনসিউমারকে ডিকাপল করার জন্য একটি বাফার হিসেবে কাজ করতে পারে।
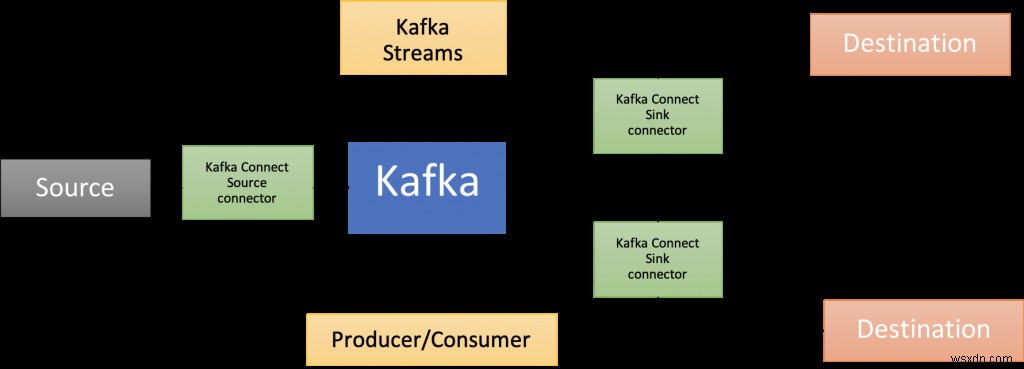
এখানেই অ্যাপাচি কাফ্কা আসে! কোর ব্রোকারের পাশাপাশি, এর একটি সমৃদ্ধ ইকোসিস্টেম আছে, যার মধ্যে রয়েছে কাফ্কা কনেক্ট (যে এই ব্লগ পোস্টে প্রস্তাবিত সমাধান আর্কিটেকচারের একটি অংশ), একাধিক ভাষায় ক্লায়েন্ট লাইব্রেরি, কাফ্কা স্ট্রিমস, মিরর মেকার, ইত্যাদি।
এই ব্লগ পোস্টটি রেডিসটাইমসিরিজ এবং অ্যাপাচি কাফ্কা ব্যবহার করে টাইম-সিরিজ ডেটা বিশ্লেষণ করার একটি ব্যবহারিক উদাহরণ প্রদান করে।
কোডটি এই গিটহাব রিপোতে উপলব্ধ: https://github.com/abhirockzz/redis-timeseries-kafka
প্রথমে ইউজ কেসটি অন্বেষণ করা যাক। দ্রষ্টব্য, ব্লগ পোস্টের উদ্দেশ্যে এটি সহজ রাখা হয়েছে এবং পরবর্তী अनुभাগগুলোতে আরও ব্যাখ্যা করা হয়েছে।
পরিস্থিতি: ডিভাইস মনিটরিং
কল্পনা করুন, অনেক লোকেশন আছে, প্রত্যেকের একাধিক ডিভাইস, এবং আপনাকে ডিভাইস মেট্রিক্স মনিটর করার দায়িত্ব দেওয়া হয়েছে—এখন আমরা তাপমাত্রা এবং চাপ বিবেচনা করব। এই মেট্রিক্স রেডিসটাইমসিরিজে সংরক্ষিত হবে (অবশ্যই!) এবং কী-এর জন্য নিচের নেমিং কনভেনশন ব্যবহার করা হবে—<মেট্রিক নাম>:<লোকেশন>:<ডিভাইস>। উদাহরণস্বরূপ, লোকেশন ৫-এ ডিভাইস ১-এর তাপমাত্রা হবে temp:5:1। প্রতিটি টাইম-সিরিজ ডেটা পয়েন্টে নিচের লেবেলগুলো (কী-ভ্যালু জোড়া) থাকবে—metric, location, device। এটি নমনীয় কোয়েরির জন্য अनुमতি দেয়, যা আপনি আগামী अनुभাগগুলিতে দেখবেন।
এখানে কিছু উদাহরণ দেওয়া হলো TS.ADD কমান্ড ব্যবহার করে ডেটা পয়েন্ট কীভাবে যোগ করবেন:
# লেবেলসহ লোকেশন ৩-এ ডিভাইস ২-এর তাপমাত্রা:
TS.ADD temp:3:2 * 20 LABELS metric temp location 3 device 2
# লোকেশন ৩-এ ডিভাইস ২-এর চাপ:
TS.ADD pressure:3:2 * 60 LABELS metric pressure location 3 device 2
সমাধান আর্কিটেকচার
উচ্চ স্তরে সমাধানটি কেমন দেখায়:
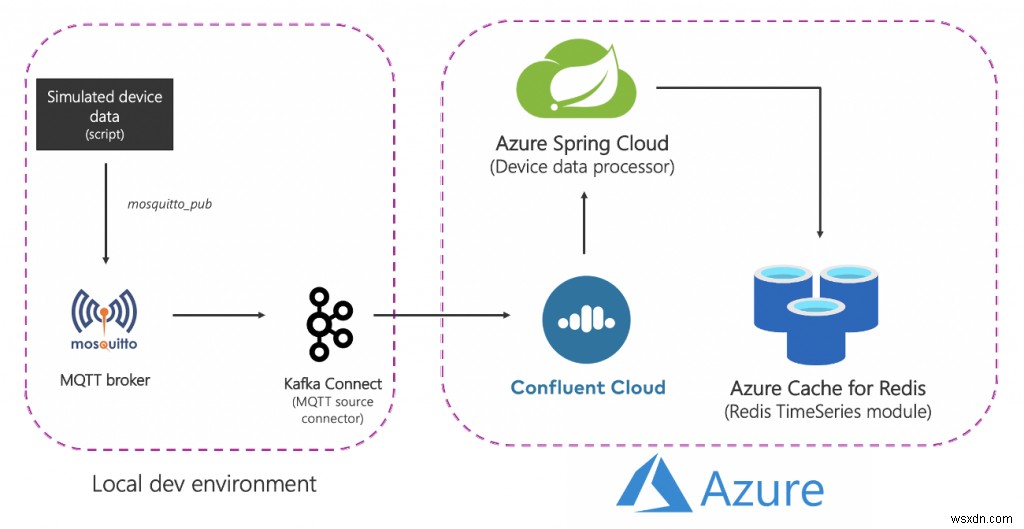
এটি ভাঙে দেখা যাক:
সোর্স (লোকাল) কম্পোনেন্টস
- MQTT ব্রোকার (mosquitto): MQTT হল IoT ইউজ কেসের জন্য ডি-ফ্যাক্টো প্রোটোকল। আমরা যে পরিস্থিতি ব্যবহার করব সেটি IoT এবং টাইম সিরিজের সংমিশ্রণ—এক্ষেত্রে আরও জানব।
- Kafka Connect: MQTT সোর্স কনেক্টর MQTT ব্রোকার থেকে ডেটা কাফ্কা ক্লাস্টারে স্থানান্তর করতে ব্যবহৃত হয়।
অ্যাজার সার্ভিসেস
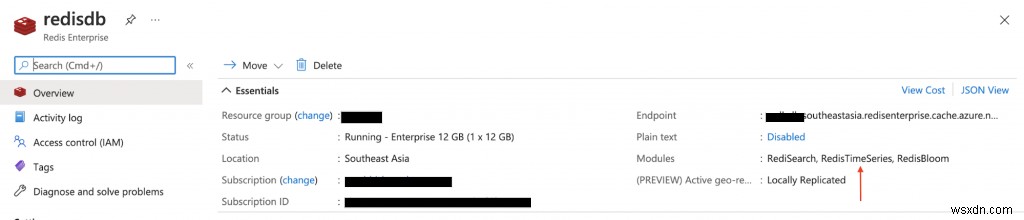
- অ্যাজার ক্যাশ ফর রেডিস এন্টারপ্রাইজ টিয়ারস: এন্টারপ্রাইজ টিয়ারগুলো রেডিস এন্টারপ্রাইজের উপর ভিত্তি করে তৈরি, যা রেডিস থেকে একটি কমার্শিয়াল ভারিয়েন্ট। রেডিসটাইমসিরিজের পাশাপাশি, এন্টারপ্রাইজ টিয়ার RediSearch এবং RedisBloom-ও সাপোর্ট করে। কাস্টমারদের এন্টারপ্রাইজ টিয়ারসের জন্য লাইসেন্স অর্জনের চিন্তা করতে হয় না। অ্যাজার ক্যাশ ফর রেডিস এই প্রক্রিয়াকে সুগম করে, যেখানে কাস্টমাররা অ্যাজার মার্কেটপ্লেস অফারের মাধ্যমে এই সফ্টওয়্যারের লাইসেন্স পেতে এবং তার জন্য অর্থ প্রদান করতে পারে।
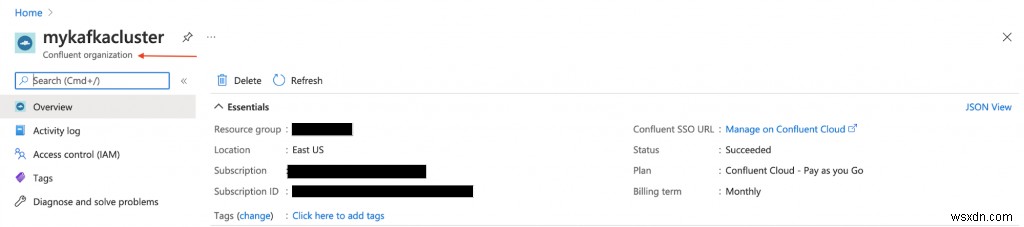
- অ্যাজারে Confluent Cloud: একটি ফুলি ম্যানেজড অফারিং যা অ্যাপাচি কাফ্কা সার্ভিস হিসেবে প্রদান করে, অ্যাজার থেকে Confluent Cloud-এ একীভূত প্রোভিশনিং লেয়ারের giúp। এটি ক্রস-প্ল্যাটফর্ম ম্যানেজমেন্টের ভার কমিয়ে দেয় এবং অ্যাজার ইনফ্রাস্ট্রাকচারে Confluent Cloud ব্যবহার করার জন্য একটি সমন্বিত অভিজ্ঞতা প্রদান করে, যাতে আপনি সহজেই Confluent Cloud-কে আপনার অ্যাজার অ্যাপ্লিকেশনগুলোর সাথে ইন্টিগ্রেট করতে পারেন।
- অ্যাজার স্প্রিং ক্লাউড: অ্যাজার স্প্রিং ক্লাউডের 덕분에 স্প্রিং বুট মাইক্রোসার্ভিসগুলো অ্যাজারে ডিপ্লয় করা সহজ। অ্যাজার স্প্রিং ক্লাউড ইনফ্রাস্ট্রাকচারের চিন্তা দূর করে, কনফিগারেশন ম্যানেজমেন্ট, সার্ভিস ডিসকভারি, CI/CD ইন্টিগ্রেশন, ব্লু-গ্রিন ডিপ্লয়মেন্ট, এবং আরও অনেক কিছু প্রদান করে। সার্ভিসটি সारा ভারী কাজ করে যাতে ডেভেলপাররা তাদের কোডে ফোকাস করতে পারে।
দ্রষ্টব্য: কিছু সার্ভিস লোকালি হোস্ট করা হয়েছে সাদৃশ্যের জন্য। প্রোডাকশন-গ্রেড ডিপ্লয়মেন্টে আপনি সেগুলো অ্যাজারে চলাতে চাইবেন। উদাহরণস্বরূপ, আপনি কাফ্কা কনেক্ট ক্লাস্টারকে MQTT কনেক্টরসহ অ্যাজার কуберনেটস সার্ভিসে चलाাতে পারেন।
সংক্ষেপে, এন্ড-টু-এন্ড ফ্লো:
- একটি স্ক্রিপ্ট সিমুলেটেড ডিভাইস ডেটা তৈরি করে যা লোকাল MQTT ব্রোকারে পাঠানো হয়।
- এই ডেটা MQTT কাফ্কা কনেক্ট সোর্স কনেক্টর দ্বারা সংগ্রহ করা হয় এবং অ্যাজারে চলমান Confluent Cloud কাফ্কা ক্লাস্টারের একটি টপিকে পাঠানো হয়।
- এটি আরও অ্যাজার স্প্রিং ক্লাউডে হোস্ট করা স্প্রিং বুট অ্যাপ্লিকেশন দ্বারা প্রক্রিয়া করা হয়, যা তারপর অ্যাজার ক্যাশ ফর রেডিস ইনস্ট্যান্সে এটি স্থায়ী করে।
এখন প্র্যাক্টিক্যাল অংশ শুরু করা যাক! এর আগে, নিচের مواردগুলো নিশ্চিত করুন।
পূর্বশর্ত:
- একটি অ্যাজার অ্যাকাউন্ট — আপনি এখান থেকে ফ্রিতে পেতে পারেন
- Azure CLI ইনস্টল করুন
- JDK 11 (যেমন OpenJDK)
- Maven এবং Git-এর একটি সাম্প্রতিক সংস্করণ
ইনফ্রাস্ট্রাকচার কম্পোনেন্ট সেট আপ করুন
ডকুমেন্টেশন অনুসরণ করে Azure Cache for Redis (Enterprise Tier) প্রোভিশন করুন যা রেডিসটাইমসিরিজ মডিউলের সাথে আসে।
অ্যাজার মার্কেটপ্লেসে Confluent Cloud ক্লাস্টার প্রোভিশন করুন। একটি কাফ্কা টপিক তৈরি করুন (নাম ব্যবহার করুন mqtt.device-stats) এবং শংসাপত্র তৈরি করুন (API কী এবং সিক্রেট) যা পরবর্তীতে আপনার ক্লাস্টারের সাথে নিরাপদে সংযোগের জন্য ব্যবহার করবেন।
আপনি অ্যাজার পোর্টাল বা Azure CLI ব্যবহার করে Azure Spring Cloud এর একটি ইনস্ট্যান্স প্রোভিশন করতে পারেন:
az spring-cloud create -n <Azure Spring Cloud সার্ভিসের নাম> -g <রিসোর্স গ্রুপের নাম> -l <লোকেশন দিন যেমন southeastasia>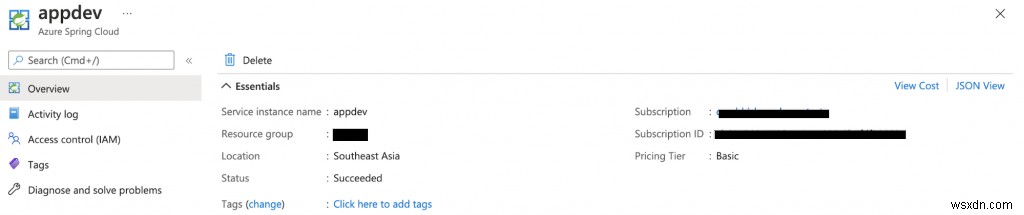
আগে যাওয়ার আগে, গিটহাব রিপো ক্লোন করুন:
git clone https://github.com/abhirockzz/redis-timeseries-kafka cd redis-timeseries-kafkaলোকাল সার্ভিস সেট আপ করুন
কম্পোনেন্টগুলো شامل:
- Mosquitto MQTT ব্রোকার
- MQTT সোর্স কনেক্টরসহ Kafka Connect
- টাইম-সিরিজ ডেটা ড্যাশবোর্ডে ট্র্যাক করার জন্য Grafana
MQTT ব্রোকার
আমি লোকালি ম্যাকএসে mosquitto ব্রোকার ইনস্টল এবং চালু করেছি।
brew install mosquitto brew services start mosquittoআপনার OS-এর জন্য সংশ্লিষ্ট ধাপগুলো অনুসরণ করুন বা এই ডকার ইমেজ ব্যবহার করতে পারেন।
Grafana
আমি লোকালি ম্যাকএসে Grafana ইনস্টল এবং চালু করেছি।
brew install grafana brew services start grafanaআপনার OS-এর জন্য একইভাবে করতে পারেন বা এই ডকার ইমেজ ব্যবহার করতে পারেন।
docker run -d -p 3000:3000 --name=grafana -e "GF_INSTALL_PLUGINS=redis-datasource" grafana/grafanaKafka Connect
আপনি সেটা ক্লোন করা রিপোতে connect-distributed.properties ফাইলটি পাবেন। bootstrap.servers, sasl.jaas.config ইত্যাদি প্রপার্টির মানগুলো রিপ্লেস করুন।
প্রথমে, অ্যাপাচি কাফ্কা লোকালি ডাউনলোড এবং আনজিপ করুন।
একটি লোকাল কাফ্কা কনেক্ট ক্লাস্টার শুরু করুন:
export KAFKA_INSTALL_DIR=<কাফ্কা ইনস্টলেশন ডিরেক্টরি যেমন /home/foo/kafka_2.12-2.5.0> $KAFKA_INSTALL_DIR/bin/connect-distributed.sh connect-distributed.propertiesMQTT সোর্স কনেক্টর ম্যানুয়ালি ইনস্টল করতে:
- এই লিংক থেকে কনেক্টর/প্লাগইন ZIP ফাইল ডাউনলোড করুন, এবং
- Connect worker-এর plugin.path কনফিগারেশন প্রপার্টিতে লিস্ট করা ডিরেক্টরির যেকোনো একটিতে এটি এক্সট্রাক্ট করুন
আপনি যদি লোকালি Confluent Platform ব্যবহার করেন, তবে শুধু Confluent Hub CLI ব্যবহার করুন: confluent-hub install confluentinc/kafka-connect-mqtt:latest
MQTT সোর্স কনেক্টর ইনস্ট্যান্স তৈরি করুন
mqtt-source-config.json ফাইলটি চেক করুন। kafka.topic-এর জন্য সঠিক টপিক নাম দিন এবং mqtt.topics অপরিবর্তিত রাখুন।
curl -X POST -H 'Content-Type: application/json' https://localhost:8083/connectors -d @mqtt-source-config.json # কনেক্টর স্ট্যাটাস চেক করার আগে এক মিনিট অপেক্ষা করুন curl https://localhost:8083/connectors/mqtt-source/statusডিভাইস ডেটা প্রসেসর অ্যাপ্লিকেশন ডিপ্লয় করুন
আপনি যে গিটহাব রিপোটি ক্লোন করেছেন, সেখানে consumer/src/resources ফোল্ডারে application.yaml ফাইলটি খুঁজুন এবং নিচের মানগুলো রিপ্লেস করুন:
- Azure Cache for Redis হোস্ট, পোর্ট এবং প্রাইমারি অ্যাক্সেস কী
- অ্যাজারে Confluent Cloud API কী এবং সিক্রেট
অ্যাপ্লিকেশন JAR ফাইল বিল্ড করুন:
cd consumer export JAVA_HOME=<এবসোলিউট পাথ দিন যেমন /Library/Java/JavaVirtualMachines/zulu-11.jdk/Contents/Home> mvn clean packageএকটি Azure Spring Cloud অ্যাপ্লিকেশন তৈরি করুন এবং JAR ফাইলটি সেখানে ডিপ্লয় করুন:
az spring-cloud app create -n device-data-processor -s <Azure Spring Cloud ইনস্ট্যান্সের নাম> -g <রিসোর্স গ্রুপের নাম> --runtime-version Java_11 az spring-cloud app deploy -n device-data-processor -s <Azure Spring Cloud ইনস্ট্যান্সের নাম> -g <রিসোর্স গ্রুপের নাম> --jar-path target/device-data-processor-0.0.1-SNAPSHOT.jarসিমুলেটেড ডিভাইস ডেটা জেনারেটর শুরু করুন
আপনি যে গিটহাব রিপোটি ক্লোন করেছেন, সেখানে স্ক্রিপ্টটি ব্যবহার করতে পারেন:
./gen-timeseries-data.shনোট—এটি শুধু mosquitto_pub CLI কমান্ড ব্যবহার করে ডেটা পাঠায়।
ডেটা device-stats MQTT টপিকে পাঠানো হয় (এটি না কাফ্কা টপিক)। আপনি CLI সাবস্ক্রাইবার দিয়ে ডাবল চেক করতে পারেন:
mosquitto_sub -h localhost -t device-statsConfluent Cloud পোর্টালে কাফ্কা টপিক চেক করুন। আপনার Azure Spring Cloud-এ ডিভাইস ডেটা প্রসেসর অ্যাপের লগও চেক করুন:
az spring-cloud app logs -f -n device-data-processor -s <Azure Spring Cloud ইনস্ট্যান্সের নাম> -g <রিসোর্স গ্রুপের নাম>Grafana ড্যাশবোর্ড উপভোগ করুন!
localhost:3000-এ Grafana UI ব্রাউজ করুন।
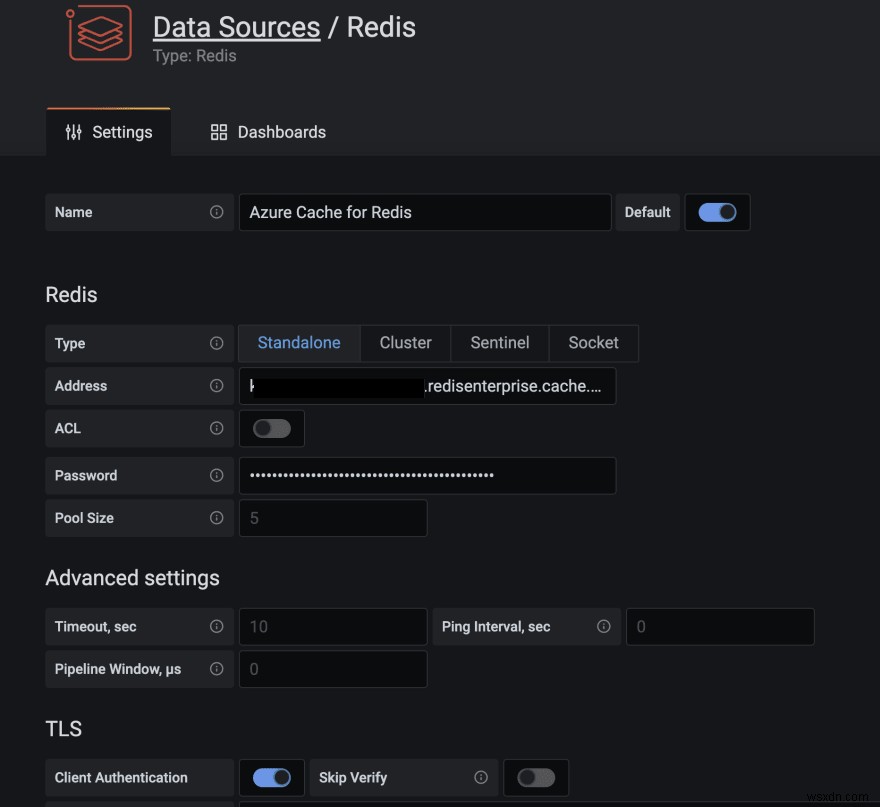
Grafana-এর জন্য রেডিস ডেটা সোর্স প্লাগইন যেকোনো রেডিস ডাটাবেসের সাথে কাজ করে, Azure Cache for Redis সহ। ডেটা সোর্স কনফিগার করার জন্য এই ব্লগ পোস্টের নির্দেশাবলী অনুসরণ করুন।
আপনি যে গিটহাব রিপোটি ক্লোন করেছেন, সেখানে grafana_dashboards ফোল্ডারের ড্যাশবোর্ডগুলো ইম্পোর্ট করুন (যদি সাহায্য দরকার হয় তবে Grafana ডকুমেন্টেশন দেখুন)।
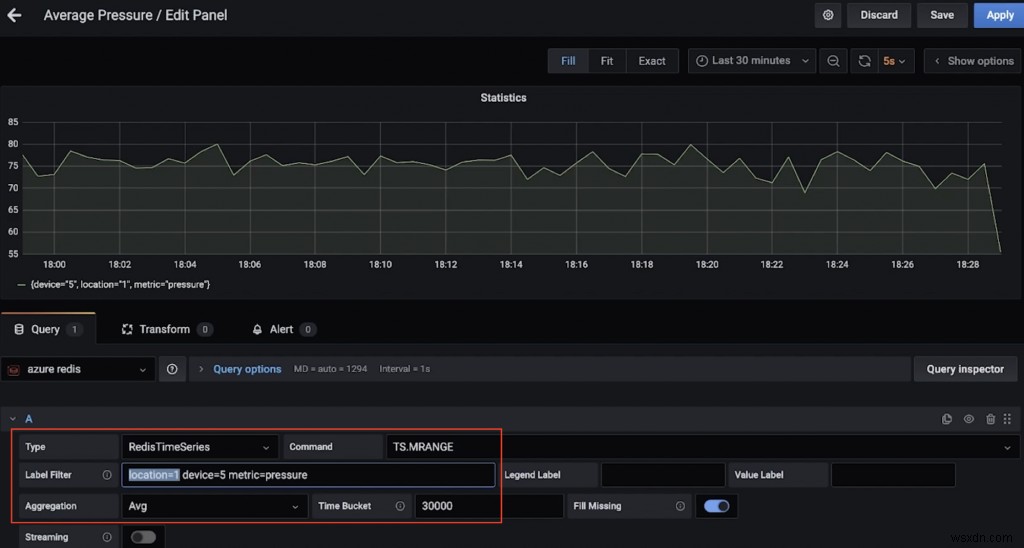
উদাহরণস্বরূপ, এখানে একটি ড্যাশবোর্ড যা লোকেশন ১-এ ডিভাইস ৫-এর গড় চাপ (৩০ সেকেন্ডের ওপর) দেখায় (TS.MRANGE ব্যবহার করে)।
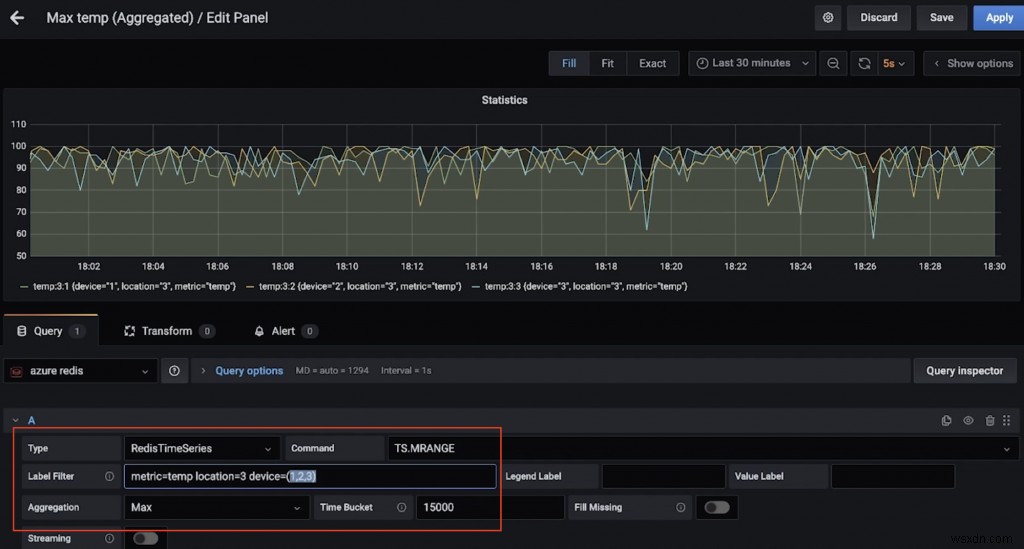
এখানে আরেকটি ড্যাশবোর্ড যা লোকেশন ৩-এ একাধিক ডিভাইসের সর্বোচ্চ তাপমাত্রা (১৫ সেকেন্ডের ওপর) দেখায় (আবার TS.MRANGE-এর فضل)।
তো, আপনি কি কিছু রেডিসটাইমসিরিজ কমান্ড চালাতে চান?
redis-cli চালু করুন এবং Azure Cache for Redis ইনস্ট্যান্সের সাথে সংযোগ করুন:
redis-cli -h <azure redis hostname যেমন myredis.southeastasia.redisenterprise.cache.azure.net> -p 10000 -a <azure redis access key> --tlsসরল কোয়েরি দিয়ে শুরু করুন:
# লোকেশন ১-এ ডিভাইস ৫-এর চাপ TS.GET pressure:1:5 # লোকেশন ৪-এ ডিভাইস ৫-এর তাপমাত্রা TS.GET temp:4:5লোকেশন অনুযায়ী ফিল্টার করে সব ডিভাইসের তাপমাত্রা এবং চাপ পান:
TS.MGET WITHLABELS FILTER location=3নির্দিষ্ট টাইম রেঞ্জের মধ্যে এক বা একাধিক লোকেশনের সব ডিভাইসের তাপমাত্রা এবং চাপ বের করুন:
TS.MRANGE - + WITHLABELS FILTER location=3 TS.MRANGE - + WITHLABELS FILTER location=(3,5)- + শুরুর থেকে সর্বশেষ টাইমস্ট্যাম্প পর্যন্ত সবকিছু বোঝায়, তবে আপনি আরও নির্দিষ্ট হতে পারেন।
MRANGE আমাদের যা দরকার ছিল! আমরা একটি নির্দিষ্ট লোকেশনে নির্দিষ্ট ডিভাইস দিয়ে ফিল্টার করতে পারি এবং আরও তাপমাত্রা বা চাপ অনুযায়ী ড্রিল-ডাউন করতে পারি:
TS.MRANGE - + WITHLABELS FILTER location=3 device=2 TS.MRANGE - + WITHLABELS FILTER location=3 metric=temp TS.MRANGE - + WITHLABELS FILTER location=3 device=2 metric=tempএই সবগুলো অগ্রিগেশনসহ কাম্বাইন করা যায়।
# সব টেম্প ডেটা পয়েন্টই উপযোগী নয়। প্রতিটি টেম্প ডেটা পয়েন্টের বদলে গড় (অথবা সর্বোচ্চ) কীভাবে? TS.MRANGE - + WITHLABELS AGGREGATION avg 10000 FILTER location=3 metric=temp TS.MRANGE - + WITHLABELS AGGREGATION max 10000 FILTER location=3 metric=tempএই অগ্রিগেশন করে একটি ভিন্ন টাইম সিরিজে সংরক্ষণ করার জন্য একটি নিয়ম তৈরি করা সম্ভব।
শেষ হলে, অবাঞ্ছিত খরচ এড়াতে রিসোর্স ডিলিট করতে ভুলবেন না।
রিসোর্স ডিলিট করুন
- Confluent Cloud ক্লাস্টার ডিলিট করার জন্য ডকুমেন্টেশনের ধাপগুলো অনুসরণ করুন—আপনার যা দরকার সেটি Confluent অর্গানাইজেশন ডিলিট করা।
- একইভাবে, Azure Cache for Redis ইনস্ট্যান্সও ডিলিট করুন।
আপনার লোকাল মেশিনে:
- Kafka Connect ক্লাস্টার বন্ধ করুন
- Mosquito ব্রোকার বন্ধ করুন (যেমন
brew services stop mosquitto) - Grafana সার্ভিস বন্ধ করুন (যেমন
brew services stop grafana)
আমরা রেডিস এবং কাফ্কা ব্যবহার করে টাইম-সিরিজ ডেটা ইনজেস্ট, প্রসেস এবং কোয়েরি করার একটি ডেটা পাইপলাইন অন্বেষণ করেছি। আপনি পরবর্তী ধাপগুলির চিন্তা করুন এবং প্রোডাকশন-গ্রেড সমাধানের দিকে বাড়ুন, তবে আরও কিছু বিষয় বিবেচনা করা উচিত।
অতিরিক্ত বিবেচনা
রেডিসটাইমসিরিজ অপ্টিমাইজ করা
- রিটেনশন পলিসি: এই সম্পর্কে চিন্তা করুন যেহেতু আপনার টাইম-সিরিজ ডেটা পয়েন্টগুলো ডিফল্টভাবে ট্রিম বা ডিলিট হয় না।
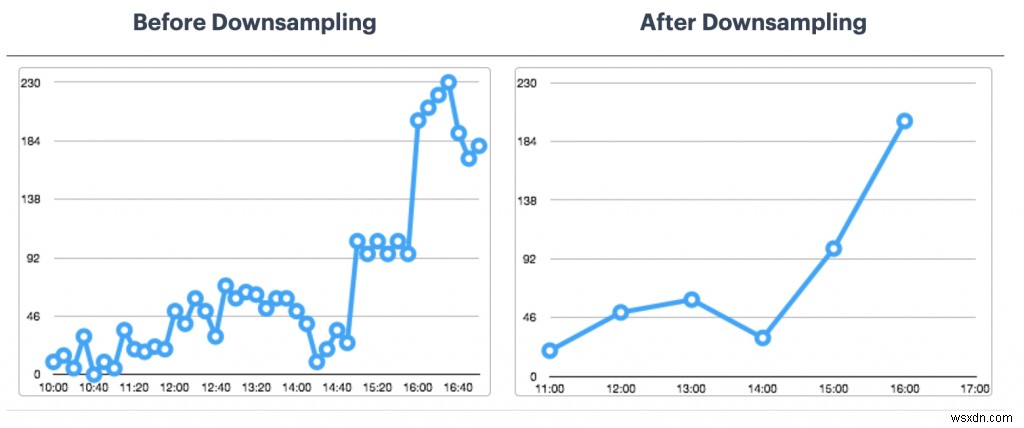
- ডাউন-স্যাম্পলিং এবং অগ্রিগেশন নিয়ম: আপনি কি চাইবেন ডেটা চিরকাল সংরক্ষণ করা? এটি যত্ন নেওয়ার জন্য উপযুক্ত নিয়ম কনফিগার করুন (যেমন
TS.CREATERULE temp:1:2 temp:avg:30 AGGREGATION avg 30000)। - ডুপ্লিকেট ডেটা পলিসি: ডুপ্লিকেট স্যাম্পেল কীভাবে হ্যান্ডল করতে চান? নিশ্চিত করুন যে ডিফল্ট পলিসি (BLOCK) আপনার প্রয়োজন। না হলে অন্যান্য অপশন বিবেচনা করুন।
এটি একটি ব্যাপক তালিকা নয়। অন্যান্য কনফিগারেশন অপশনের জন্য রেডিসটাইমসিরিজ ডকুমেন্টেশন দেখুন।
লং-টার্ম ডেটা রিটেনশন কী?
ডেটা মূল্যবান, টাইম সিরিজও! আপনি এটিকে আরও প্রক্রিয়া করতে চাইতে পারেন (যেমন মেশিন লার্নিং চালাতে ইনসাইট বের করতে, প্রিডিক্টিভ মেইনটেন্যান্স, ইত্যাদি)। এর জন্য আপনাকে ডেটা বেশি সময় ধরে রাখতে হবে, এবং এটিকে কস্ট-ইফেক্টিভ এবং কার্যকর করার জন্য আপনি একটি স্কেলেবল অবজেক্ট স্টোরেজ সার্ভিস চাইবেন যেমন Azure Data Lake Storage Gen2 (ADLS Gen2)।
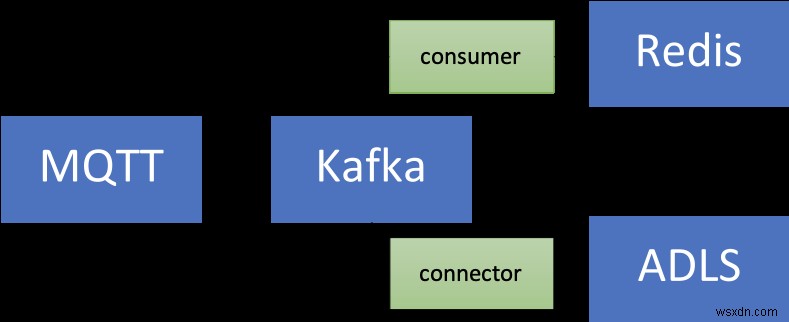
এখানেও একটি কনেক্টর আছে! আপনি Confluent Cloud-এর জন্য ফুলি-ম্যানেজড Azure Data Lake Storage Gen2 সিংক কনেক্টর ব্যবহার করে বিদ্যমান ডেটা পাইপলাইনকে উন্নত করতে পারেন, যাতে ডেটা ADLS-এ প্রক্রিয়া এবং সংরক্ষণ করা যায় এবং তারপর Azure Synapse Analytics বা Azure Databricks ব্যবহার করে মেশিন লার্নিং চালানো যায়।
স্কেলেবিলিটি
আপনার টাইম-সিরিজ ডেটা ভলিউম শুধু এক দিকে যেতে পারে—ওপরে! আপনার সমাধান স্কেলেবল হওয়া অত্যন্ত গুরুত্বপূর্ণ:
- কোর ইনফ্রাস্ট্রাকচার: ম্যানেজড সার্ভিসesas টিমগুলিকে ইনফ্রাস্ট্রাকচার সেট আপ এবং মেইনটেইন করার বদলে সমাধানটিতে ফোকাস করতে দেয়, বিশেষ করে রেডিস এবং কাফ্কা যেন জটিল ডিস্ট্রিবিউটেড সিস্টেম।
- Kafka Connect: ডেটা পাইপলাইন trịক্ষে, আপনি ভালো হাতের নিচে আছেন কারণ কাফ্কা কনেক্ট প্ল্যাটফর্ম الأصلا স্টেটলেস এবং হরিজন্টালি স্কেলেবল। আপনার কাফ্কা কনেক্ট ওয়ার্কার ক্লাস্টার আর্কিটেক্ট এবং সাইজ করার জন্য অনেক অপশন আছে।
- কাস্টম অ্যাপ্লিকেশন: এই সমাধানে যেন ছিল, আমরা কাফ্কা টপিকসে ডেটা প্রসেস করার জন্য একটি কাস্টম অ্যাপ্লিকেশন তৈরি করেছিলাম। خوشকিস্মতিতে, একই স্কেলেবিলিটি বৈশিষ্ট্যগুলো এখানেও প্রযোজ্য। হরিজন্টাল স্কেলের দিক থেকে, এটি সীমাবদ্ধ শুধু আপনার কাফ্কা টপিক পার্টিশনের সংখ্যা দ্বারা।
ইন্টিগ্রেশন: শুধু গ্রাফানা নয়! রেডিসটাইমসিরিজ Prometheus এবং Telegraf-এর সাথে ইন্টিগ্রেট হয়। যাইহোক, এই ব্লগ পোস্ট লেখা পর্যন্ত কাফ্কা কনেক্টর নেই—এটি একটি চমৎকার অ্যাড-অন হবে!
উপসংহার
হ্যাঁ, আপনি রেডিসকে (প্রায়) সব কিছুতে ব্যবহার করতে পারেন, টাইম-সিরিজ ওয়ার্কলোডসহ! টাইম-সিরিজ ডেটা সোর্স থেকে রেডিস এবং তার বাইরে পর্যন্ত ডেটা পাইপলাইন এবং ইন্টিগ্রেশনের এন্ড-টু-এন্ড আর্কিটেকচার সম্পর্কে ভাবতে ভুলবেন না।
