

আমরা RediSearch 2.0 ডেভেলপমেন্টের প্রথম মাইলস্টোন রিলিজ ঘোষণা করে খুশি। RediSearch একটি রিয়েল-টাইম সার্চ ইঞ্জিন যা আপনাকে আপনার Redis ডেটা কোয়েরি করতে দিয়ে জটিল প্রশ্নের উত্তরে পৌঁছাতে সাহায্য করে।
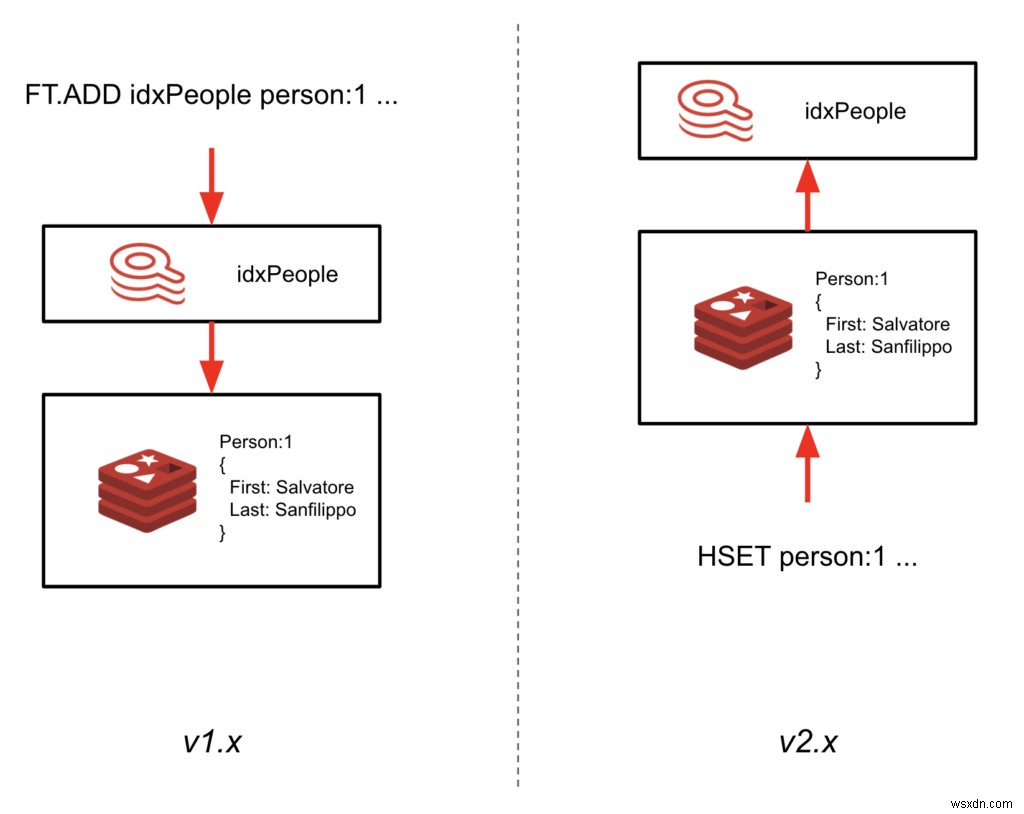
এই মাইলস্টোন, যাকে 2.0-M01 نامیده হয়েছে, ইন্ডেক্সগুলো ডেটার সাথে কীভাবে সিঙ্কে রাখা হয় তার পুনঃআর্কিটেকচারকে চিহ্নিত করে। ডেটা ইন্ডেক্সের মাধ্যমে লিখতে হয়ে যেতে না ( FT.ADD কমান্ড ব্যবহার করে), RediSearch এখন হ্যাশে লেখা ডেটাকে ফলো করবে এবং স্বয়ংক্রিয়ভাবে ইন্ডেক্স করবে।
এখানে বড় সুবিধা হলো আপনি এখন আপনার বিদ্যমান Redis ইনস্ট্যান্সে RediSearch যোগ করতে পারেন এবং আপনার অ্যাপ্লিকেশন কোড আপডেট ছাড়াই একটি সেকেন্ডারি ইন্ডেক্স তৈরি করতে পারেন। এটি আপনাকে তাত্ক্ষণিকভাবে আপনার বিদ্যমান ডেটায় RediSearch ব্যবহার শুরু করতে দেয়, শুধু RediSearch মডিউল লোড করে এবং স্কিমা সংজ্ঞায়িত করে। RediSearch 2.0-এর জেনারেল অভেইলেবিলিটি এই ফলে অপেক্ষা করা হচ্ছে।
(দ্রষ্টব্য: এই নতুন ফিচারটি API-তে কিছু পরিবর্তন আনে (নিচে তালিকাভুক্ত)। আমরা যতটা সম্ভব ব্যাকওয়ার্ড কম্প্যাটিবিলিটি বজায় রাখতে চেষ্টা করি, কিন্তু এই কেসে এটি সম্ভব নয়। কাস্টমার ফিডব্যাক সংগ্রহ করার সাথে সাথে আমরা সামঞ্জস্য এবং ফিক্স করার পরিকল্পনা করছি।)
API পরিবর্তন
উপরোক্ত উল্লেখ অনুযায়ী, এই RediSearch 2.0 মাইলস্টোনে API-তে বেশ কিছু পরিবর্তন অন্তর্ভুক্ত:
- ইন্ডেক্সটি আর কী স্পেসে থাকে না। যদি আপনি ডেটাবেসে ইন্ডেক্স লিস্ট করতে ইন্ডেক্স কী (idx:<index name>) ব্যবহার করতেন, তবে এটি আর কাজ করবে না। যাইহোক, আমরা একটি কমান্ড FT._LIST আনা করেছি যা ডেটাবেসের সকল ইন্ডেক্স রিটার্ন করবে।
- ইন্ডেক্স অবশ্যই প্রিফিক্স/ফিল্টার সহ তৈরি করতে হবে। এইগুলো নির্দিষ্ট করে যে কোন ডকুমেন্টগুলো RediSearch দ্বারা স্বয়ংক্রিয়ভাবে ইন্ডেক্স হবে। আপনি একটি সহজ প্রিফিক্স এবং/অথবা একটি জটিল ফিল্টার এক্সপ্রেশন নির্দিষ্ট করতে পারেন।
- আপগ্রেড সম্ভব নয়। যদি আপনার पास পুরনো ভার্সনের RediSearch দিয়ে তৈরি একটি RDB থাকে, তবে RediSearch 2.0 সেটি পড়তে পারবে না। বর্তমানে, আপনাকে পুরো ডেটাসেট রি-ইন্ডেক্স করতে হবে। যাইহোক, আমরা GA রিলিজের জন্য একটি আপগ্রেড প্রসেসের ওপর কাজ করছি।
- এটি শুধু Redis 6 এবং তার উপরে কাজ করে।
- FT কমান্ডগুলো তাদের Redis-সমতুল্য কমান্ডগুলোর সাথে ম্যাপ করা হয়েছে। এটি বিদ্যমান অ্যাপ্লিকেশনগুলোর RediSearch 2.0-এর সাথে কাজ করতে रहने দেয়। ম্যাপিংগুলো নিম্নরূপ:
- FT.ADD => HSET
- FT.DEL => DEL (ডিফল্টভাবে DD)
- FT.GET => HGETALL
- FT.MGET => HGETALL
- ইনভার্টেড ইন্ডেক্সটি আর RDB-তে সেভ হয় না। এর মানে এটি নয় যে পার্সিস্টেন্সি সাপোর্ট করা হয় না। RediSearch ইন্ডেক্স ডেফিনিশন RDB-তে সেভ করে এবং Redis শুরু হওয়ার পর ব্যাকগ্রাউন্ডে ডেটা ইন্ডেক্স করে। আপনি FT.INFO কমান্ড ব্যবহার করে ইন্ডেক্সিং স্ট্যাটাস চেক করে রি-ইন্ডেক্সিং কখন শেষ হয়েছে তা জানতে পারেন।
নতুন API
API-তে সবচেয়ে বড় আপডেট হলো ইন্ডেক্স কীভাবে তৈরি করা হয়। RediSearch 2.0-এ FT.CREATE কমান্ড ব্যবহার করা হয় ইন্ডেক্স তৈরি করতে। API-তে যোগগুলো এখানে হলদে হাইলাইট করা হয়েছে:
FT.CREATE {index} ON {structure} [PREFIX {count} {prefix} [{prefix} ..] [FILTER {filter}] [LANGUAGE_FIELD {lang_field}] [LANGUAGE {lang}] [SCORE_FIELD {score_field}] [SCORE {score}] [PAYLOAD_FIELD {payload_field}] [TEMPORARY {seconds}] [MAXTEXTFIELDS] [NOOFFSETS] [NOHL] [NOFIELDS] [NOFREQS] [STOPWORDS {num} {stopword} ...] SCHEMA {field} [TEXT [NOSTEM] [WEIGHT {weight}] [PHONETIC {matcher}] | NUMERIC | GEO | TAG [SEPARATOR {sep}] ] [SORTABLE][NOINDEX] ...
আসুন কিছু ডিটেলে যাই:
- ON {structure} বর্তমানে শুধু HASH সাপোর্ট করে
- PREFIX {count} {prefix} ইন্ডেক্সকে বলে যে কোন কীগুলো ইন্ডেক্স করা উচিত। আপনি ইন্ডেক্স করতে چندین প্রিফিক্স যোগ করতে পারেন। যেহেতু আর্গুমেন্টটি অপশনাল, ডিফল্ট হলো * (সব কী)
- FILTER {filter} একটি ফিল্টার এক্সপ্রেশন RediSearch অ্যাগ্রিগেশন এক্সপ্রেশন ল্যাঙ্গুয়েজের পুরো। @__key ব্যবহার করা সম্ভব যা কীটি যোগ করা/পরিবর্তন করা হয়েছে অ্যাক্সেস করতে
- LANGUAGE এবং SCORE আপনাকে সব ডকুমেন্টের জন্য ডিফল্ট ল্যাঙ্গুয়েজ এবং স্কোর ওভাররাইড করতে দেয় যেগুলো ইন্ডেক্স হয়েছে
- LANGUAGE_FIELD, SCORE_FIELD, এবং PAYLOAD_FIELD আপনাকে ডকুমেন্ট-স্পেসিফিক ল্যাঙ্গুয়েজ এবং স্কোরিং রাখতে দেয়, এবং পেলোডকে ডকুমেন্টের মধ্যে একটি ফিল্ড হিসেবে ব্যবহার করতে দেয়।
অন্যান্য সীমাবদ্ধতা এবং পরিবর্তন
RediSearch 2.0-M01 মাইলস্টোন আরও কিছু আপডেট আনে:
- NOSAVE আর সাপোর্ট করা হয় না।
- হ্যাশ আপডেট করা ইমপ্লাই করে যে পুরো ডকুমেন্টটি ইন্ডেক্স হবে (কীস্পেস নোটিফিকেশনগুলো ঠিক করে না কোন ফিল্ডগুলো পরিবর্তন হয়েছে)। তাই আংশিক আপডেট ধীর হবে। দ্রষ্টব্য যে আমরা এই পরিস্থিতিতে পারফরম্যান্স উন্নত করার অপশনগুলি এখনও araştোচ করছি।
- ফিল্ড নাম এখন কেস-সেনসিটিভ, তাই একটি ফিল্ড "FOO" ডিক্লেয়ার করা এবং "foo" হিসেবে ইন্ডেক্স করা কাজ করবে না।
- FT.ADD কমান্ডটি এখানে দেখানো মত hset-এ ম্যাপ করা হবে:
FT.ADD idx doc1 1.0 LANGUAGE eng PAYLOAD payload FIELDS f1 v1 f2 v2
ম্যাপ করা হয়েছে
HSET doc1 __score 1.0 __language eng __payload payload f1 v1 f2 v2
এর মানে হলো আপনার ইন্ডেক্সের স্কোর, ল্যাঙ্গুয়েজ এবং পেলোড ফিল্ডগুলো অবশ্যই __score, __language, __payload নামে থাকতে হবে যথাক্রমে যাতে ম্যাপিং प्रत्यাশা অনুযায়ী কাজ করে।
- FT.ADDHASH আর সাপোর্ট করা হয় না। HSET ব্যবহার করুন।
- FT.OPTIMIZE আর সাপোর্ট করা হয় না, RediSearch গারবেজ কালেকশন ফাংশনটি ইন্ডেক্স অপ্টিমাইজ করার জন্য দায়বদ্ধ।
উপসংহার
আমরা এই পরিবর্তনগুলো নিয়ে খুব এক্সাইটেড কারণ এখন আপনি আপনার বিদ্যমান Redis ডেটাবেসে RediSearch লোড করতে পারেন এবং আপনার হ্যাশে থাকা বিদ্যমান ডেটা ইন্ডেক্স করতে পারেন, আপনার অ্যাপ্লিকেশন লজিক আপডেট ছাড়াই যখন আপনি এই ডকুমেন্টগুলো ম্যানিপুলেট করেন। আপনি এই মাইলস্টোন রিলিজটি GitHub থেকে সোর্স কোড নেয়া বা 1:99:1 RedisSarch Docker ইমেজ ব্যবহার করে ট্রাই আউট করতে পারেন। এই ভার্সন এখনও প্রোডাকশন-রেডি নয়, কিন্তু আমরা আপনার সাথে শেয়ার করতে চেয়েছিলাম আপনার ফিডব্যাক পাওয়ার জন্য। অনুগ্রহ করে যেকোনো মন্তব্য বা ইস্যু আমাদের GitHub রিপোজিটরি বা Redis কমিউনিটি ফোরামে শেয়ার করুন।
