

ব্যাকগ্রাউন্ড টাস্ক স্কেলের জন্য ওয়েব অ্যাপ্লিকেশন বিবেচনা করার সময় মূল স্তম্ভের একটি। বেসিক আইডিয়া সহজ: একটি ক্লায়েন্ট আপনার ওয়েব অ্যাপ্লিকেশনে একটি রিকোয়েস্ট করে এবং সেই রিকোয়েস্ট হ্যান্ডল করার время, আপনার অ্যাপ কয়েকটি টাইম-এক্সপেনসিভ টাস্ক পারফর্ম করে। ক্লায়েন্টকে দ্রুত রেসপন্স দিতে, অ্যাপ একটি ব্যাকগ্রাউন্ড জব একটি ব্যাকগ্রাউন্ড প্রসেসিং সিস্টেমে এনকিউ করে। ব্যাকগ্রাউন্ড প্রসেসিং তারপর সকল ভারী কাজ (কম্পিউটেশন বা I/O অপারেশন) নেয়। ব্যাকগ্রাউন্ড জব ইফেক্টিভলি ব্যবহার করা আপনার ওয়েব অ্যাপ্লিকেশন স্কেল করার সবচেয়ে গুরুত্বপূর্ণ বিল্ডিং ব্লকের একটি।
রেলস ডেভেলপার হিসেবে, আমরা কয়েকটি অসাধারণ লাইব্রেরির আশীর্বাদ প্রাপ্ত যেগুলোর প্রতিটির ভিন্ন সুবিধা, অসুবিধা, এবং এমনকি ব্যাকএন্ড ডাটাবেস আছে। এই লাইব্রেরিগুলো যেকোনো ভারী কাজ অফলোড করা সহজ করে দেয়, যা আমাদের অ্যাপ্লিকেশনকে দ্রুত রেসপন্স করতে এবং কম রিসোর্সে আরও বেশি ইউজার সার্ভ করতে দেয়।
কিছুক্ষণ আগে পর্যন্ত, আমরা Honeybadger-এর অধিকাংশ ব্যাকগ্রাউন্ড প্রসেসিং জবের জন্য Sidekiq ব্যবহার করতাম। এটি আমাদের ব্লেজিং-ফাস্ট ইউজার এক্সপেরিয়েন্স এবং আমরা যা ইনজেস্ট করি সেটার বড় পরিমাণ ডেটা প্রসেস করার জন্য একটি রোবাস্ট পাইপলাইন মেইনটেইন করতে সাহায্য করেছিল।
Sidekiq আমাদের জন্য কোথায় চুকাচ্ছে?
তবুও, রেডিসের কিছু সীমাবদ্ধতা আছে। কিছুক্ষণ আগে পর্যন্ত, আমরা সকল জব প্রসেসিং, আমাদের এরর-ট্র্যাকিং এন্ডপয়েন্টের ইনজেস্ট সহ, Sidekiq-এ করতাম। এরর ট্রাফিক অত্যন্ত ভেরিয়েবল। আমাদের কিউতে জবের সংখ্যা ১০x বা ২০x বাড়ে যেতে - ফলে বড় ব্যাকলগ তৈরি হয় যতক্ষণ না আমাদের অটোস্কেলিং পর্যাপ্ত ওয়ার্কার স্পিন আপ করে ক্যাচ আপ করে। কিন্তু বড় সমস্যা ছিল আমাদের ElastiCache ক্লাস্টারে মেমরি এক্সহাস্টেশন।
আমাদের ElastiCache ক্লাস্টারের মধ্যે পর্যাপ্ত জব ট্রাফিক যাচ্ছিল যে ডাউনস্ট্রিম প্রসেসিং-এ যেকোনো উল্লেখযোগ্য विलম্ব ক্লাস্টারকে মেমরি আউট করতে পারে। আমরা নন-কিউ ডেটা স্টোর করার জন্য আলাদা একটি ক্লাস্টার ব্যবহার করি, তবে সময়ের সাথে সাথে, কিছু নন-কিউ ডেটা প্রাইমারি ক্লাস্টারে ও দেখতে পাওয়া গেছে, যা আউট-অফ-মেমরি এররের কেসে ইভিক্টেড হতে পারে। আরও ক্রিটিক্যাল সমস্যা হলো, ক্লাস্টার মেমরি আউট হলে নতুন জব একসেপ্ট করতে পারা নয়।
একটি সেকেন্ডারি ইস্যু হলো রেডিস/ElastiCache ডিফল্টরূপে volatile-lru ইভিকশন পলিসি ব্যবহার করে। এর ফলাফল হলো হাই মেমরি ইউসেজের সময়, রেডিস TTL সেট করা লিস্ট রিসেন্টলি ইউজড ডেটা রিমুভ করে। এক সময় Honeybadger-এ এমন একটি ইভেন্ট হয়েছিল যেখানে আমাদের মেমরি ইউসেজ যথেষ্ট হাই ছিল যে রেডিস ক্যাশ ক্লিয়ার করতে শুরু করলো যের সময় আমরা চাইনি। सौভাগ্যবশত, ইভিক্টেড ডেটা রিপ্রোডাসিবল (TTL-এর কারণে), তাই আমরা কোনো পার্মানেন্ট ডেটা হারালাম না।
তবুও, এটা আমাদের সামনে একটি প্রশ্ন রেখে দিয়েছে যেটা সমাধান করা লাগবে - যদি একই ইভেন্ট আবার ঘটে এবং আমরা এমন ডেটা হারাতে শুরু করি যা রিবিল্ড করা যায় না? কীভাবে নিশ্চিত করব যে কখনো কাস্টমার ডেটা হারাব না? কাস্টমার এরর ডেটা হ্যান্ডল করা আমাদের বিজনেসের মূল, তাই আমাদের একটি সিস্টেম দরকার যা ডেটা লসের বিপরীতে রেজিলিয়েন্ট।
ডেটা ইনজেস্ট করার জন্য Kafka ব্যবহার
Kafka একটি ডিস্ট্রিবিউটেড ইভেন্ট পাইপলাইন যা স্কেলেবিলিটি এবং রেজিলিয়েন্স উভয় দেয়। আমাদের недав সমক Инসাইটস লঞ্চের সাথে, আমরা Kafkaকে আমাদের ইভেন্ট ডেটা প্রসেস করার ইনফ্রাস্ট্রাকচার হিসেবে দাঁড় করাতে খুব এক্সপেরিয়েন্স পেয়েছি। এরপর, আমরা একই টেকনোলজি স্ট্যাক ব্যবহার করে আমাদের এরর ইনজেস্ট ডেটা প্রসেস করতে চেয়েছিলাম। আমরা Kafka ব্যবহার করে রিডানডেন্ট স্টোরেজ, बेटার এক্সপ্যান্ডাবিলিটি, এবং আরও সস্তা খরচ অর্জন করতে চেয়েছিলাম।
যেহেতু আমরা Insights-এর জন্য আমাদের নিজস্ব AWS MSK ক্লাস্টার রান করছিলাম, আমাদের ইতিমধ্যে ইনফ্রাস্ট্রাকচার এবং অটোস্কেলিং সেটআপ ছিল। এর মানে আমাদের "শুধু" কয়েকটি টপিক সেট আপ করতে হতো এবং কিছু কনজিউমার তৈরি করতে হতো যারা আমাদের Sidekiq ওয়ার্কারদের মত কোড রান করবে। কনসেপ্টটি খুব সিম্পল ছিল যা আমাদের Kafka কনজিউমার ফাইন-টিউনিং-এ বেশি ফোকাস করতে দিয়েছিল।
Sidekiq থেকে Karafka-এ মাইগ্রেশন
Honeybadger একটি মেজেস্টিক মনোলিথ হিসেবে আর্কিটেক্টেড, এবং Karafka আমাদের সেই আর্কিটেকচার রাখতে সাহায্য করে। আমরা ইতিমধ্যে আমাদের কিছু Insights ডেটা প্রসেস করার জন্য Karafka ব্যবহার করছিলাম, তাই কয়েকটি নতুন কনজিউমার যোগ করা একটি সহজ কাজ ছিল।
Karafka এবং Sidekiq-এর মধ্যে একটি প্রধান পার্থক্য হলো জবগুলো কীভাবে রিট্রিভ করা হয়। Karafka-এ, জবগুলো ব্যাচড হয়ে থাকে এবং একটি সিঙ্গেল কনজিউমার রানে একসাথে প্রসেস হয়। কনজিউমারে, আমরা মেসেজের অ্যারে এর ওপর ইটারেট করে Sidekiq ওয়ার্কার ইনলাইন রান করতে পারি:
class NoticeConsumer < ApplicationConsumer
  def consume
    messages.each do |message|
      NoticeWorker.new.perform(message.payload)
    end
  end
end
আমাদের বিবেচনা করতে হয়েছিল আরেকটি পার্থক্য হলো এরর হ্যান্ডলিং কীভাবে কাজ করে। Sidekiq-এ, যেহেতু প্রতিটি জব অ্যাটমিক, একটি ওয়ার্কার নিজের এরর রিট্রাই এবং ফেইলিউর কলব্যাক দিয়ে হ্যান্ডেল করে। Kafka-এর ব্যাচিং বিহেভিয়ারের সাথে, এরর হ্যান্ডলিং-এর জন্য আরও অপশন আছে। সবচেয়ে নোটেবল, Karafka একটি মেকানিজম প্রদান করে যাকে Dead Letter Queue বলা হয়। এটি আপনাকে ব্যাচ বা ইনডিভিজুয়াল বেসিসে এরর হ্যান্ডলিং স্পেসিফাই করতে দেয়।
dead_letter_queue(
  topic: "ingestion.errors.dead",
  max_retries: 5,
  independent: true
)
যখন Karafka কনজিউমার যেকোনো ইনডিভিজুয়াল মেসেজ প্রসেস করতে ফেল করে, সেটা ৫ বার রিপ্রসেস করার চেষ্টা করে। ৫তম আটেম্প্টে ফেল করলে, মেসেজটি স্পেসিফাইড টপিকে পাঠায়। independent: true অপশন কনজিউমারকে বলে যে শুধু ফেল করা মেসেজটি DLQ-তে পাঠাতে হবে, পুরো ব্যাচ নয়।
Karafka মনিটরিং এবং স্কেলিং
যেแบบে বের হয়েছে, Karafka কনজিউমার মনিটরিং এবং স্কেল করা খুব কমপ্লেক্স। AWS/MSK এবং Karafka উভয় থেকে অনেক জিনিস ট্র্যাক করা যায়, এবং আপনার সিস্টেম টিউন করার জন্য অনেক নব আছে। এটা আপনার কোড কী করছে, ডেটা ফ্লোর বিহেভিয়র - এগুলোতে সতর্ক মনোযোগ দরকার।
AWS CloudWatch-এ আমরা অনেক জিনিস মনিটর করি, কিন্তু কয়েকটি Kafka-স্পেসিফিক মেট্রিক যা আমরা দেখি:
- SumOffsetLag — একটি স্পেসিফাইড টপিক এবং কনজিউমার গ্রুপের জন্য, এটি সব পার্টিশনের অফসেট ল্যাগের সমষ্টি।
- EstimatedMaxTimeLag — একটি স্পেসিফাইড টপিক এবং কনজিউমার গ্রুপের জন্য, এটি আনুমানিক পরিমাণ যা সকল পার্টিশন ক্যাচ আপ করতে লাগবে বর্তমান অফসেট পর্যন্ত।
Karfka কিছু গরেট ইন্সট্রুমেন্টেশনও প্রদান করে, কিন্তু আপনাকে এই ডেটা পাবলিশ এবং স্টোর করতে হবে নিজে:
- processing_lag* — এই ভ্যালু প্রতিটি কনসাম্ড ব্যাচের জন্য উপলব্ধ। এটি বলে Kafka থেকে মেসেজ নেওয়া থেকে প্রসেসিং শুরু হওয়া পর্যন্ত কত টাইম লেগেছে।
- consumption_lag* — এই ভ্যালু processing_lag-এর মত কিন্তু এটি ব্যাচের লাস্ট মেসেজ Kafka সিস্টেমে প্রবেশ করার থেকে আপনার কনজিউমার প্রসেসিং শুরু করার পর্যন্ত সময়।
- duration* — একটি কনজিউমার একটি পুরো ব্যাচ মেসেজ প্রসেস করার জন্য কত টাইম নেয়।
যেแบบে বের হয়েছে, Sidekiq প্রসেস স্কেল করা Karafka কনজিউমার প্রসেস স্কেল করার থেকে খুব আলাদা। Sidekiq-এর প্যারালেলাইজেশন বাড়াতে হলে, আপনি আপনার রেডিস ইনস্ট্যান্স যতটুকু হ্যান্ডেল করতে পারে ততটুকু প্রসেস যোগ করতে পারেন। Kafka-এ, আপনি আপনার টপিকের পার্টিশন প্রতি সর্বোচ্চ ১ প্রসেস বাউন্ড থাকবেন। থাম্ব রুল হিসেবে, আপনি চাইবেন আপনার প্ল্যান করা পার্টিশন থেকে বেশি পার্টিশন থাকে যেন একজন Kafka কনজিউমার ১-র বেশি পার্টিশনে অ্যাসাইন করা যায়।
একটি জিনিস মনে রাখতে হবে স্কেল আপ এবং স্কেল ডাউন Kafka কনজিউমার খুব লেন্থি অপারেশন হতে পারে। কনজিউমার গ্রুপ থেকে কনজিউমার যোগ বা বাদ দিলে গ্রুপকে নিজে রিব্যালেন্স করতে হয়। এর মানে পার্টিশন রি-অ্যাসাইন করা প্রয়োজন। রি-অ্যাসাইনমেন্টের সময়, কনজিউমার মেসেজ প্রসেসিং বন্ধ করে দেয়। যদিও sticky-cooperative অ্যাসাইনমেন্ট দিয়ে এই সমস্যা কিছুটা মিটিগেট করা যায়, সাধারণত আপনি রিব্যালেন্স এড়াতে চাবেন রিসোর্স ওভার-প্রোভিশনিং দিয়ে।
আমরা বর্তমানে SumOffsetLag-কে আমাদের স্কেলিং মেট্রিকের একটি হিসেবে মনিটর করছি। একটি গুরুত্বপূর্ণ জিনিস নোট করতে হবে রিব্যালেন্সিংয়ের সময় এই মেট্রিক রিপোর্ট করা হয় না। তাই আপনি কল্পনা করতে পারেন, একটি রিব্যালেন্সিং পিরিয়ডে, এই মেট্রিকটা ড্রাস্টিক্যালি বাড়বে যতক্ষণ না রিব্যালেন্সিং শেষ হয়। এটাও একটা কারণ যে স্কেলিং কম রাখা গুরুত্বপূর্ণ।
Honeybadger-এ Karafka-এর জন্য কী আসছে?
আমরা আমাদের Kafka/Karafka ইমপ্লিমেন্টেশন ১০০% এক মাসে বেশি সময় ধরে চালাচ্ছি এবং বলতে পারি আমরা খুব সन्तুষ্ট। তবুও, জানা ভালো লাগে যে আমরা যেকোনো মুহূর্তে Sidekiq-এ ফলব্যাক করতে পারি এক বাটন চাপলে যদি কখনো এই সিস্টেমগুলোর মেইনটেনেন্স করতে হয়। এটা আমাদের আরও বেশি রেজিলিয়েন্স দেয় যখন এই সিস্টেমগুলোর যেকোনো একটিতে মেইনটেনেন্স ওয়ার্ক করতে হয়।
Sidekiq থেকে Karafka-এ মাইগ্রেশনের প্রক্রিয়ায়, আমরা Kafka এবং Karafka-র সাথে কাজ করার বিষয়ে আরও অনেক কিছু শিখেছি। আপনি যদি Honeybadger জেমের লেটেস্ট ভার্সনে আপডেট না করে থাকেন, তবে চেক আউট করুন! আমি Karafka প্লাগইনে কিছু নতুন ফিচার যোগ করেছি। আপনার Insights ইনেবল থাকলে, আমাদের জেম কিছু গুরুত্বপূর্ণ স্ট্যাট ট্র্যাক করা শুরু করবে যাতে আপনার Kafka সিস্টেমের সামগ্রিক স্বাস্থ্যের একটি ভালো ভিউ পান।
উপরন্তু, এখন আমাদের একটি Insights Karafka Dashboard আছে যা আপনাকে এই ডেটা ভিজুয়ালাইজ করতে সাহায্য করবে এবং আপনার Kafka কনজিউমার কীভাবে বিহেভ করছে সেটা বুঝতে দেবে। Karafka Dashboard-এর জন্য প্লাগইনে মেট্রিক্স ইনেবল থাকতে হবে। সেটা করতে আপনার honeybadger.yml-এ নিচের কনফিগ যোগ করুন:
karafka:
  insights:
    metrics: true
ড্যাশবোর্ড কীভাবে দেখাবে তার একটি নমুনা:
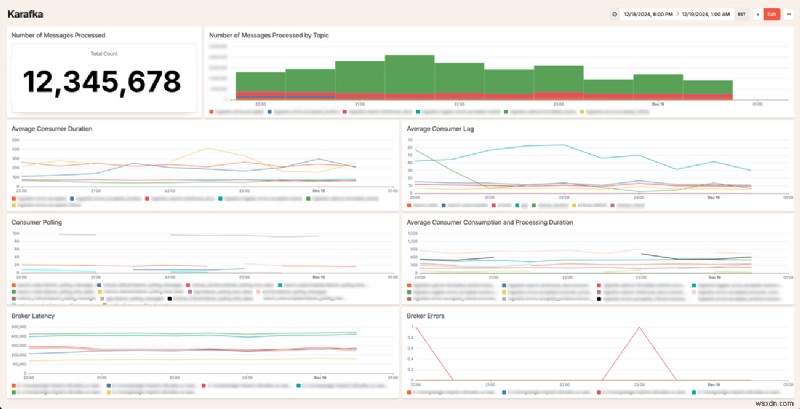
আমরা এক্সাইটেড আমাদের কাস্টমাররা কীভাবে এই ডেটা ব্যবহার করে তাদের নিজস্ব Kafka সিস্টেম উন্নত করবে তা দেখতে। আপনার যদি Sidekiq থেকে Karafka-এ কীভাবে মাইগ্রেট করেছি, বা সাধারণত Kafka কীভাবে ব্যবহার করি সেটা নিয়ে কোনো প্রশ্ন থাকে, তবে আমাদের সাথে যোগাযোগ করতে দ্বিধা করবেন না!
