

ওয়েব স্ক্র্যাপার বিল্ড করার এই সিরিজের তৃতীয় অংশে স্বাগতম। এই টিউটোরিয়ালে, আমি আমার নিজের পডকাস্ট সাইট থেকে ডেটা স্ক্র্যাপ করার একটি উদাহরণ দিয়ে যাব। আমি বিস্তারিত কভার করব কীভাবে আমি ডেটা এক্সট্রাক্ট করলাম, হেল্পার ও ইউটিলিটি মেথডগুলো কীভাবে তাদের কাজ করে, এবং কীভাবে সব পাজল পিসগুলো একসাথে আসে।
টপিক্স
- আমার পডকাস্ট স্ক্র্যাপ করা
- Pry
- স্ক্র্যাপার
- হেল্পার মেথডস
- পোস্ট লিখা
আমার পডকাস্ট স্ক্র্যাপ করা
আসুন 이제 পর্যন্ত শিখেছি সেটি প্র্যাকটিসে লাগাই। বিভিন্ন কারণে, আমার পডকাস্ট Between | Screens-এর রিডিজাইন খুব দিন ধরে বাকি ছিল। কিছু সমস্যা ছিল যেগুলো আমাকে সকালে ঘুম থেকে জেগে তখন চিৎকার করতে বাধ্য করত। তাই আমি একটি সম্পূর্ণ নতুন স্ট্যাটিক সাইট সেট আপ করার সিদ্ধান্ত নিলাম, যা Middleman দিয়ে বিল্ট এবং GitHub Pages-এ হোস্টেড।
আমি নতুন ডিজাইন 뒷ে ভালো পরিমান সময় লাগালাম Middleman ব্লগকে আমার প্রয়োজন অনুযায়ী টুইক করার পর। অবশিষ্ট ছিল কন্টেন্ট ইমপোর্ট করা আমার ডাটাবেস-ব্যাকড সিনাতারা অ্যাপ থেকে, তাই আমাকে বিদ্যমান কন্টেন্ট স্ক্র্যাপ করে আমার নতুন স্ট্যাটিক সাইটে ট্রান্সফার করতে হতো।
হাতে খড়ি করে এটা করা আমার টেবিলে ছিল না—প্রশ্নই নেই—কারণ আমি আমার বন্ধু Nokogiri এবং Mechanize-র ওপর নির্ভর করতে পারতাম কাজটি করতে। আপনার সামনে যা আছে সেটি একটি যথেষ্ট ছোট স্ক্র্যাপ জব যা খুব জটিল নয় কিন্তু কিছু আকর্ষণীয় টুইস্ট অফার করে যা ওয়েব স্ক্র্যাপিং নовичকদের জন্য শিক্ষামূলক হবে।
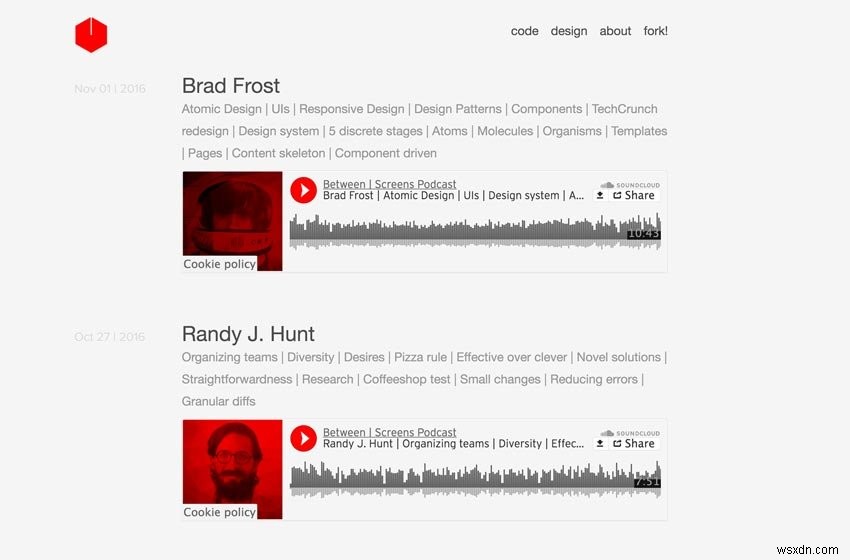
নিচে আমার পডকাস্ট থেকে দুটি স্ক্রিনশট দেওয়া আছে।
পুরনো পডকাস্টের স্ক্রিনশট
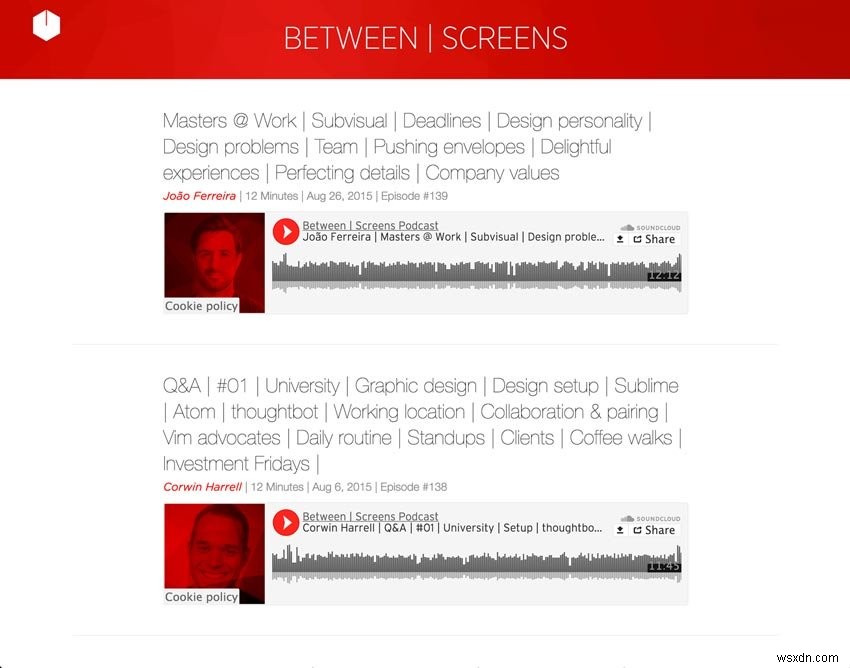
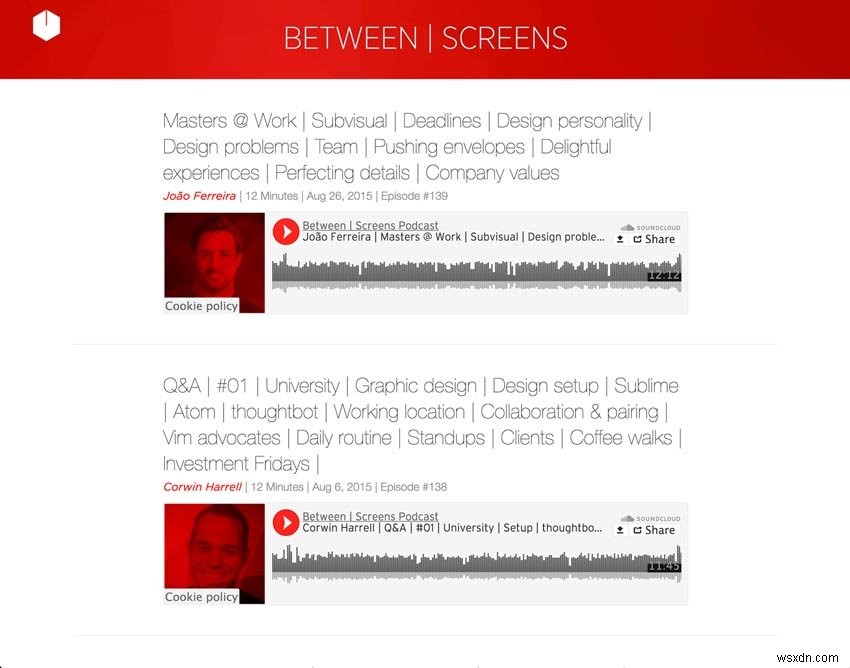
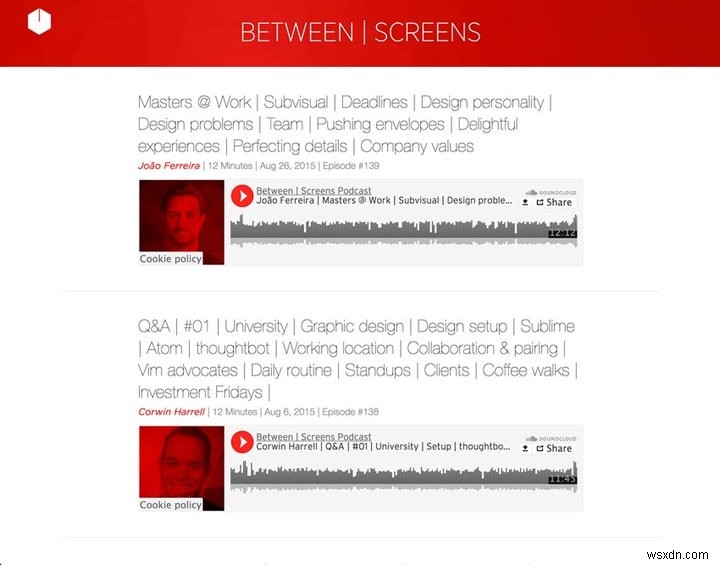
নতুন পডকাস্টের স্ক্রিনশট
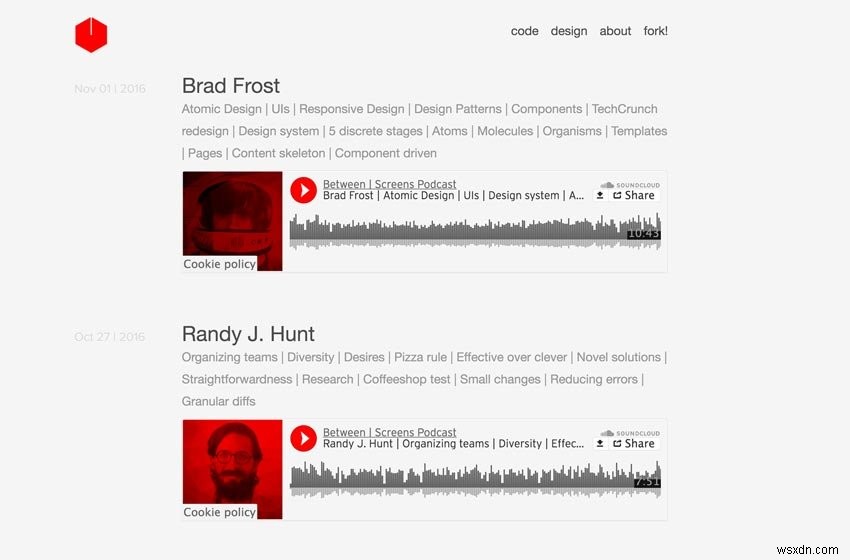
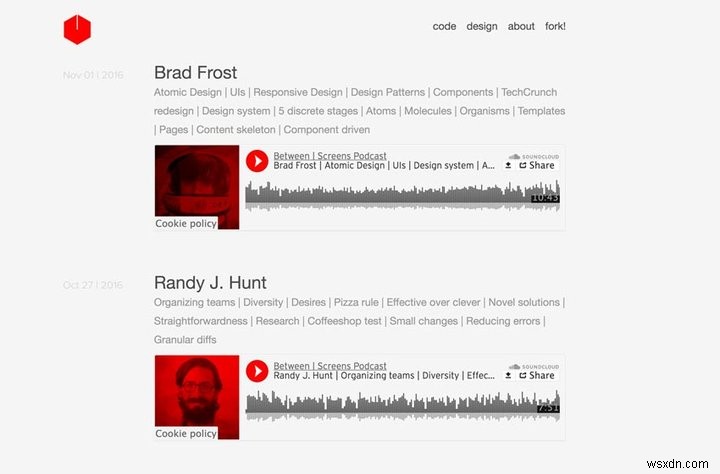
আসুন ব্রেক ডাউন করি আমরা কী অর্জন করতে চাই। ২১টি পেজিনেটেড ইনডেক্স সাইটে ছড়িয়ে থাকা ১৩৯টি এপিসোড থেকে নিচের ডেটা এক্সট্রাক্ট করতে চাই:
- টাইটেল
- ইন্টারভিউই (সাক্ষাত্কারগ্রহীতা)
- টপিক লিস্টসহ সাবহেডার
- প্রতিটি এপিসোডের সাউন্ডক্লাউড ট্র্যাক নম্বর
- তারিখ
- এপিসোড নম্বর
- শো নোটস থেকে টেক্সট
- শো নোটস থেকে লিংকগুলো
আমরা পেজিনেশন এর মাধ্যমে ইটারেট করব এবং Mechanize-কে প্রতিটি এপিসোডের লিংক ক্লিক করব। ফলোয়িং ডিটেইল পেজে, আমরা উপরের সকল ইনফরমেশন পাব যা আমাদের দরকার। সেই স্ক্র্যাপ করা ডেটা ব্যবহার করে, আমরা প্রতিটি এপিসোডের জন্য মার্কডাউন ফাইলগুলোর ফ্রন্ট ম্যাটার এবং "বডি" পপুলেট করব।
নিচে আপনি দেখতে পাবেন কীভাবে আমরা এক্সট্রাক্ট করা কন্টেন্ট দিয়ে নতুন মার্কডাউন ফাইলগুলো কম্পোজ করব। আমি মনে করি এটি আমাদের সামনের সুযোগের সম্পর্কে একটি ভালো আইডিয়া দেবে। এটি আমাদের ছোট স্ক্রিপ্টের চূড়ান্ত ধাপ। চিন্তা করবেন না, আমরা এর ওপর বিস্তারিত যাব।
def compose_markdown
def compose_markdown(options={})
  <<-HEREDOC
---
title: #{options[:interviewee]}
interviewee: #{options[:interviewee]}
topic_list: #{options[:title]}
tags: #{options[:tags]}
soundcloud_id: #{options[:sc_id]}
date: #{options[:date]}
episode_number: #{options[:episode_number]}
---
#{options[:text]}
HEREDOC
end
আমি কিছু ট্রিকও যোগ করতে চায়ছিলাম যা পুরনো সাইট পারফর্ম করত না। একটি কাস্টমাইজড, কম্প্রিহেনসিভ ট্যাগিং সিস্টেম আমার জন্য অত্যন্ত গুরুত্বপূর্ণ ছিল। আমি চেয়েছিলাম শোতারা একটি গভীর ডিসকভারি টুল পান। তাই প্রতিটি ইন্টারভিউইর জন্য ট্যাগ এবং সাবহেডারকে ট্যাগে ভাগ করা প্রয়োজন ছিল। যেহেতু আমি প্রথম সিজনে একলেই ১৩৯টি এপিসোড তৈরি করেছিলাম, সাইটটিকে সেই সময়ের জন্য প্রস্তুত করতে হতো যখন কন্টেন্টের পরিমান কম্ব থ্রু করা কঠিন হয়ে যাবে। বুদ্ধিমানের মতো স্থাপিত রিকমেন্ডেশনসহ একটি গভীর ট্যাগিং সিস্টেমই পথ ছিল। এতে আমি সাইটটিকে লাইটওয়েট ও ফাস্ট রাখতে পারলাম।
আসুন আমার সাইটের কন্টেন্ট স্ক্র্যাপ করার সম্পূর্ণ কোডে এক নজর দেই। চारों দিকে তাকিয়ে বড় পিকচার বুঝতে চেষ্টা করুন। যেহেতু আমি আপনাকে বিগিনার সাইডে আশা করি, আমি খুব বেশি অ্যাবস্ট্রাক্ট না করে ক্লেরিটির দিকেঝুকে রইলাম। আমি কয়েকটি রিফ্যাক্টরিং করেছি যা কোড ক্লেরিটিতে সাহায্য করেছিল, কিন্তু আপনার জন্য কিছু মিট ওড়ে রেখেছি যাতে আপনি এই আর্টিকেল শেষ হলে সেগুলো 갖고 খেলতে পারেন। কারণ গুণগত শেখা তখন হয় যখন আপনি পড়ার বাইরে জিয়ে কিছু কোড 갖고 নিজে ট্রাই করেন।
পথে চলাকালীন, আমি আপনাকে উত্সাহিত করছি আপনার সামনের কোড কীভাবে উন্নত করা যায় সেটি চিন্তা করতে। এটি এই আর্টিকেলের শেষে আপনার চূড়ান্ত টাস্ক হবে। আমার একটা হিন্ট: বড় মেথডগুলো ছোট ছোট মেথডে ভাঙা সবসময় একটি ভালো শুরূয়াত। একবার আপনি কোডটি কীভাবে কাজ করে সেটি বুঝলে, আপনি সেই রিফ্যাক্টরিং-এ মজা পাবেন।
আমি ইতিমধ্যে একটিブンচ মেথড ছোট, ফোকাসড হেল্পার হিসেবে এক্সট্রাক্ট করেছি। আপনি সহজে অ্যাপ্লাই করতে পারবেন যা আপনি আমার পূর্বের আর্টিকেলগুলো থেকে কোড ਸਮেল এবং তাদের রিফ্যাক্টরিং সম্পর্কে শিখেছেন। যদি এখনও এটি আপনার মাথায় ঢুকে না, চিন্তা করবেন না—আমরা সবাই সেখানেই ছিলেন। শুধু চেষ্টা চালিয়ে যান, কোনো সময় věщи দ্রুত ক্লিক করা শুরু করবে।
পূর্ণ কোড
require 'Mechanize'
require 'Pry'
require 'date'

# Helper Methods
# (Extraction Methods)
def extract_interviewee(detail_page)
  interviewee_selector = '.episode_sub_title span'
  detail_page.search(interviewee_selector).text.strip
end

def extract_title(detail_page)
  title_selector = ".episode_title"
  detail_page.search(title_selector).text.gsub(/[?#]/, '')
end

def extract_soundcloud_id(detail_page)
  sc = detail_page.iframes_with(href: /soundcloud.com/).to_s
  sc.scan(/\d{3,}/).first
end

def extract_shownotes_text(detail_page)
  shownote_selector = "#shownote_container > p"
  detail_page.search(shownote_selector)
end

def extract_subtitle(detail_page)
  subheader_selector = ".episode_sub_title"
  detail_page.search(subheader_selector).text
end

def extract_episode_number(episode_subtitle)
  number = /[#]\d*/.match(episode_subtitle)
  clean_episode_number(number)
end

# (Utility Methods)
def clean_date(episode_subtitle)
  string_date = /[^|]*([,])(.....)/.match(episode_subtitle).to_s
  Date.parse(string_date)
end

def build_tags(title, interviewee)
  extracted_tags = strip_pipes(title)
  "#{interviewee}"+ ", #{extracted_tags}"
end

def strip_pipes(text)
  tags = text.tr('|', ',')
  tags = tags.gsub(/[@?#&]/, '')
  tags.gsub(/[w\/]{2}/, 'with')
end

def clean_episode_number(number)
  number.to_s.tr('#', '')
end

def dasherize(text)
  text.lstrip.rstrip.tr(' ', '-')
end

def extract_data(detail_page)
  interviewee = extract_interviewee(detail_page)
  title = extract_title(detail_page)
  sc_id = extract_soundcloud_id(detail_page)
  text = extract_shownotes_text(detail_page)
  episode_subtitle = extract_subtitle(detail_page)
  episode_number = extract_episode_number(episode_subtitle)
  date = clean_date(episode_subtitle)
  tags = build_tags(title, interviewee)
  options = {
    interviewee: interviewee,
    title: title,
    sc_id: sc_id,
    text: text,
    tags: tags,
    date: date,
    episode_number: episode_number
  }
end

def compose_markdown(options={})
  <<-HEREDOC
---
title: #{options[:interviewee]}
interviewee: #{options[:interviewee]}
topic_list: #{options[:title]}
tags: #{options[:tags]}
soundcloud_id: #{options[:sc_id]}
date: #{options[:date]}
episode_number: #{options[:episode_number]}
---
#{options[:text]}
HEREDOC
end

def write_page(link)
  detail_page = link.click
  extracted_data = extract_data(detail_page)
  markdown_text = compose_markdown(extracted_data)
  date = extracted_data[:date]
  interviewee = extracted_data[:interviewee]
  episode_number = extracted_data[:episode_number]
  File.open("#{date}-#{dasherize(interviewee)}-#{episode_number}.html.erb.md", 'w') { |file| file.write(markdown_text) }
end

def scrape
  link_range = 1
  agent ||= Mechanize.new
  until link_range == 21
    page = agent.get("https://between-screens.herokuapp.com/?page=#{link_range}")
    link_range += 1
    page.links[2..8].map do |link|
      write_page(link)
    end
  end
end

scrape
আমরা কেন require "Nokogiri" করলাম না? Mechanize আমাদের সকল স্ক্র্যাপিং চাহিদা পূরণ করে। যেমন আমরা পূর্বের আর্টিকেলে আলোচনা করেছিলাম, Mechanize Nokogiri-এর ওপর তৈরি এবং আমাদের কন্টেন্ট এক্সট্রাক্ট করতে দেয়। তবে প্রথম আর্টিকেলে সেই জেম কভার করা জরুরি ছিল যেহেতু আমাদের সেটির ওপর বিল্ড করতে হতো।
Pry
প্রথমে প্রথম। আমাদের কোডে ঝাঁপড় দেওয়ার আগে, আমি মনে করি আপনাকে দেখানো জরুরি যে আপনি কীভাবে দক্ষতার সাথে চেক করতে পারেন আপনার কোড প্রতিটি ধাপে প্রত্যাশা অনুযায়ী কাজ করছে কিনা। আপনি অবশ্যই লক্ষ্য করেছেন, আমি মিক্সে আরেকটি টুল যোগ করেছি। অন্যান্য mellett, Pry ডিবাগিং-এ খুব কার্যকর।
আপনি যদি আপনার কোডে যেকোনো জায়গায় Pry.start(binding) রাখেন, আপনি সঠিক সেটি পয়েন্টে আপনার অ্যাপ্লিকেশন ইনস্পেক্ট করতে পারবেন। আপনি অ্যাপ্লিকেশনের নির্দিষ্ট পয়েন্টে অবজেক্টগুলোর ভিতরে ঝাঁকতে পারেন। এটি আপনার অ্যাপ্লিকেশনকে ধাপে ধাপে নেওয়ায় খুব সাহায্য করে নিজের পায়ে নিজে ঠোکر খাওয়া ছাড়া। উদাহরণস্বরূপ, আমাদের write_page ফাংশনের ঠিক পরে এটি রাখি এবং চেক করি link আমাদের আশা অনুযায়ী কিনা।
Pry
...
def scrape
  link_range = 1
  agent ||= Mechanize.new
  until link_range == 21
    page = agent.get("https://between-screens.herokuapp.com/?page=#{link_range}")
    link_range += 1
    page.links[2..8].map do |link|
      write_page(link)
      Pry.start(binding)
    end
  end
end
...
যদি আপনি স্ক্রিপ্টটি রান করেন, আমরা নিচের কিছু পাব।
আউটপুট
$ ruby noko_scraper.rb
321: def scrape
322: link_range = 1
323: agent ||= Mechanize.new
324:
326: until link_range == 21
327: page = agent.get("https://between-screens.herokuapp.com/?page=#{link_range}")
328: link_range += 1
329:
330: page.links[2..8].map do |link|
331: write_page(link) =>
332: Pry.start(binding)
333: end
334: end
335: end
[1] pry(main)>
যখন আমরা তখন link অবজেক্ট চাইব, আমরা চেক করতে পারব আমরা সঠিক ট্র্যাকে আছি কিনা অন্য ইমপ্লিমেন্টেশন ডিটেইল 쪽으로 যাওয়ার আগে।
টার্মিনাল
[2] pry(main)> link
=> #<Mechanize::Page::Link "Masters @ Work | Subvisual | Deadlines | Design personality | Design problems | Team | Pushing envelopes | Delightful experiences | Perfecting details | Company values" "/episodes/139">
দेखতে পাচ্ছি যা আমাদের দরকার। চমৎকার, আমরা এগিয়ে যেতে পারি। পুরো অ্যাপ্লিকেশনে ধাপে ধাপে এটি করা একটি গুরুত্বপূর্ণ অভ্যাস যাতে আপনি হারিয়ে না যান এবং আপনি সত্যিকারের বুঝতে পারেন কীভাবে কাজ করে। আমি এখানে Pry-র ওপর আর বেশি আলোচনা করব না কারণ এতে আমার কমপক্ষে আরেকটি পূর্ণ আর্টিকেল লাগবে। আমি শুধু এটি স্ট্যান্ডার্ড IRB শেলের বিকল্প হিসেবে ব্যবহার করার সুপারিশ করতে পারি। চলে আসি আমাদের মূল কাজে।
স্ক্র্যাপার
এখন যেহেতু আপনার পাজল পিসগুলোকে পরিচিত होनेয় সুযোগ পেয়েছেন, আমি সুপারিশ করি আমরা সেগুলো এক এক করে যাই এবং কয়েকটি আকর্ষণীয় পয়েন্ট ক্লেরিফাই করি। কেন্দ্রীয় পিসগুলো থেকে শুরু করি।
podcast_scraper.rb
...
def write_page(link)
  detail_page = link.click
  extracted_data = extract_data(detail_page)
  markdown_text = compose_markdown(extracted_data)
  date = extracted_data[:date]
  interviewee = extracted_data[:interviewee]
  episode_number = extracted_data[:episode_number]
  file_name = "#{date}-#{dasherize(interviewee)}-#{episode_number}.html.erb.md"
  File.open(file_name, 'w') { |file| file.write(markdown_text) }
end

def scrape
  link_range = 1
  agent ||= Mechanize.new
  until link_range == 21
    page = agent.get("https://between-screens.herokuapp.com/?page=#{link_range}")
    link_range += 1
    page.links[2..8].map do |link|
      write_page(link)
    end
  end
end
...
scrape মেথডে কী হয়? প্রথমে, আমি পুরনো পডকাস্টের প্রতিটি ইনডেক্স পেজের ওপর লুপ করি। আমি হারোকু অ্যাপের পুরনো URL ব্যবহার করছি যেহেতু নতুন সাইটই betweenscreens.fm-এ অনলাইনে আছে। আমার ২০টি পেজ এপিসোড ছিল যা আমাকে লুপ করতে হতো।
আমি লুপটি ডিলিমিট করলাম link_range ভেরিয়েবল দিয়ে, যা প্রতিটি লুপে আপডেট হতো। পেজিনেশন attravers করা ছিল এই ভেরিয়েবলটিকে প্রতিটি পেজের URL-এ ব্যবহার করার%。 সহজ এবং কার্যকর।
def scrape
page = agent.get("https://between-screens.herokuapp.com/?page=#{link_range}")
তারপর, যখনই আমি আরেকটি পেজ পেতাম আরো আটটি এপিসোড স্ক্র্যাপ করার জন্য, আমি page.links ব্যবহার করি যাতে আমরা যেসব লিংক ক্লিক করতে চাই সেগুলো আইডেন্টিফাই করতে পারি এবং প্রতিটি এপিসোডের ডিটেইল পেজে ফলো করতে পারি। আমি লিংকের একটি রেঞ্জ (links[2..8]) সাথে যাওয়ার সিদ্ধান্ত নিলাম কারণ এটি প্রতিটি পেজে কনসিস্টেন্ট ছিল। এটি প্রতিটি ইনডেক্স পেজ থেকে আমার দরকারি লিংকগুলো টার্গেট করার সবচেয়ে সহজ পথ ছিল। CSS সিলেক্টরের সাথে হাতপা ফুলাতে হয়নি।
তারপর সেটি ডিটেইল পেজের লিংক write_page মেথডে ফিড করি। যहीं অধিকাংশ কাজ হয়। আমরা সেই লিংক নেই, ক্লিক করি, এবং ডিটেইল পেজে ফলো করি যেখানে থেকে আমরা এর ডেটা এক্সট্রাক্ট শুরু করতে পারি। সেই পেজে আমরা সকল ইনফরমেশন পাই যা আমাকে নতুন সাইটের জন্য মার্কডাউন এপিসোড কম্পোজ করতে লাগে।
def write_page
extracted_data = extract_data(detail_page)
def extract_data
def extract_data(detail_page)
  interviewee = extract_interviewee(detail_page)
  title = extract_title(detail_page)
  sc_id = extract_soundcloud_id(detail_page)
  text = extract_shownotes_text(detail_page)
  episode_subtitle = extract_subtitle(detail_page)
  episode_number = extract_episode_number(episode_subtitle)
  date = clean_date(episode_subtitle)
  tags = build_tags(title, interviewee)
  options = {
    interviewee: interviewee,
    title: title,
    sc_id: sc_id,
    text: text,
    tags: tags,
    date: date,
    episode_number: episode_number
  }
end
আপনি উপরে দেখতে পাচ্ছেন, আমরা সেটি detail_page নেই এবং এর ওপর এক বन्च এক্সট্রাকশন মেথড অ্যাপ্লাই করি। আমরা interviewee, title, sc_id, text, episode_title, এবং episode_number এক্সট্রাক্ট করি। আমি কয়েকটি ফোকাসড হেল্পার মেথড রিফ্যাক্টর করেছি যা এই এক্সট্রাকশন দায়িত্বের আধিকারী। চলে এক নজর দিয়ে আসি:
হেল্পার মেথডস
এক্সট্রাকশন মেথডস
আমি এই হেল্পারগুলো এক্সট্রাক্ট করেছি কারণ এতে আমাকে স্মলার মেথড ওভারঅল রাখতে পারল। তাদের বিহেভিয়র এনক্যাপসুলেট করা জন্যও গুরুত্বপূর্ণ ছিল। কোডও ভালো পড়া যায়।那些में से 대부분 detail_page আর্গুমেন্ট হিসেবে নেয় এবং আমাদের Middleman পোস্টের জন্য নির্দিষ্ট ডেটা এক্সট্রাক্ট করে।
def extract_interviewee(detail_page)
  interviewee_selector = '.episode_sub_title span'
  detail_page.search(interviewee_selector).text.strip
end
আমরা পেজে একটি নির্দিষ্ট সিলেক্টর খুঁজি এবং অপ্রয়োজনীয় হোয়াইটস্পেস ছাড়া টেক্সট পাই।
def extract_title(detail_page)
  title_selector = ".episode_title"
  detail_page.search(title_selector).text.gsub(/[?#]/, '')
end
আমরা টাইটেল নেই এবং ? এবং # রিমুভ করি কারণ এগুলো আমাদের এপিসোড পোস্টের ফ্রন্ট ম্যাটারে ভালো খেলে না। ফ্রন্ট ম্যাটারের বিষয়ে নিচে আরো।
def extract_soundcloud_id(detail_page)
  sc = detail_page.iframes_with(href: /soundcloud.com/).to_s
  sc.scan(/\d{3,}/).first
end
এখানে আমাদের আমাদের হোস্টেড ট্র্যাকের সাউন্ডক্লাউড আইডি এক্সট্রাক্ট করতে কিছু এক্সট্রা मेহনত করতে হয়েছে। প্রথমে আমাদের Mechanize iframes লাগবে href của soundcloud.com এবং সেটাকে স্ট্রিং করতে হবে স্ক্যান করার জন্য...
"[#<Mechanize::Page::Frame nil \"https://w.soundcloud.com/player/?url=https%3A//api.soundcloud.com/tracks/221003494&auto_play=false&hide_related=false&show_comments=false&show_user=true&show_reposts=false&visual=true\"> ]"
তারপর ট্র্যাক আইডির ডিজিটের জন্য রেগুলার এক্সপ্রেশন ম্যাচ করি—আমাদের soundcloud_id "221003494"।
def extract_shownotes_text(detail_page)
  shownote_selector = "#shownote_container > p"
  detail_page.search(shownote_selector)
end
শো নোটস এক্সট্রাক্ট করা আবার খুব সিম্পল। আমাদের শুধু ডিটেইল পেজে শো নোটসের প্যারাগ্রাফগুলো খুঁজে বের করতে হয়। কোনো সাপ্রাইজ নেই।
def extract_subtitle(detail_page)
  subheader_selector = ".episode_sub_title"
  detail_page.search(subheader_selector).text
end
সাবটাইটেলের জন্যও একই কথা, সिवায় এটি সাফল্যপूর্বক এপিসোড নম্বর এক্সট্রাক্ট করার প্রস্তুতি।
def extract_episode_number(episode_subtitle)
  number = /[#]\d*/.match(episode_subtitle)
  clean_episode_number(number)
end
এখানে আমাদের আবার রেগুলার এক্সপ্রেশনের অন্য একটি রাউন্ড লাগবে। রেজেক্স অ্যাপ্লাই করার আগে ও পরে কীভাবে দেখে নেই।
episode_subtitle
" João Ferreira | 12 Minutes | Aug 26, 2015 | Episode #139 "
number
"#139"
আর এক ধাপ আমাদের ক্লিন নম্বর পাওয়ার জন্য।
def clean_episode_number(number)
  number.to_s.tr('#', '')
end
আমরা হ্যাশ #সহ নম্বরটি নেই এবং এটি রিমুভ করি। Voilà, আমাদের প্রথম এপিসোড নম্বর 139 এক্সট্রাক্ট হয়েছে। আমি অন্য ইউটিলিটি মেথডগুলোও দেখি একসাথে আনার আগে।
ইউটিলিটি মেথডস
সেই সকল এক্সট্রাকশন কাজের পর, আমাদের কিছু ক্লিনআপ বাকি। আমরা ইতিমধ্যে মার্কডাউন কম্পোজ করার জন্য ডেটা প্রস্তুত করা শুরু করতে পারি। উদাহরণস্বরূপ, আমি episode_subtitle কে আরো স্লাইস করি ক্লিন ডেটা পাওয়ার জন্য এবং build_tags মেথড দিয়ে tags বিল্ড করি।
def clean_date
def clean_date(episode_subtitle)
  string_date = /[^|]*([,])(.....)/.match(episode_subtitle).to_s
  Date.parse(string_date)
end
আমরা আরেকটি রেজেক্স চালাই যা এভাবে ডেটা খুঁজে: " Aug 26, 2015"। আপনি দেখছেন, এটি এখনো খুব সাহায্যকারী নয়। সাবটাইটেল থেকে আমরা যে string_date পাই, সেটি থেকে একটি আসল Date অবজেক্ট তৈরি করতে হবে। অন্যথায় Middleman পোস্ট তৈরি করার জন্য এটি бесполезা হবে।
string_date
" Aug 26, 2015"
তাই আমরা সেটি স্ট্রিং নেই এবং Date.parse করি। ফলাফল অনেক আশাজনক দেখে।
Date
2015-08-26
def build_tags
def build_tags(title, interviewee)
  extracted_tags = strip_pipes(title)
  "#{interviewee}"+ ", #{extracted_tags}"
end
এটি title এবং interviewee নেয় যা আমরা extract_data মেথডের ভিতরে বিল্ড আপ করেছিলাম এবং সব পাইপ ক্যারেক্টার এবং জাঙ্ক রিমুভ করে। আমরা পাইপ ক্যারেক্টারকে কমা দিয়ে রিপ্লেস করি, @, ?, #, এবং &-কে খালি স্ট্রিং দিয়ে, এবং শেষে with-এর সংক্ষিপ্ত রূপের যত্ন নিই।
def strip_pipes
def strip_pipes(text)
  tags = text.tr('|', ',')
  tags = tags.gsub(/[@?#&]/, '')
  tags.gsub(/[w\/]{2}/, 'with')
end
শেষে আমরা ইন্টারভিউইর নামটিও ট্যাগ লিস্টে ইনক্লুড করি, এবং প্রতিটি ট্যাগকে কমা দিয়ে আলাদা করি।
পূর্বে
"Masters @ Work | Subvisual | Deadlines | Design personality | Design problems | Team | Pushing envelopes | Delightful experiences | Perfecting details | Company values"
পরে
"João Ferreira, Masters Work , Subvisual , Deadlines , Design personality , Design problems , Team , Pushing envelopes , Delightful experiences , Perfecting details , Company values"
এই ট্যাগগুলোর প্রতিটি সেই টপিকের পোস্ট কালেকশনে লিংক হয়ে যাবে। এই সব কিছু extract_data মেথডের ভিতরে হয়েছে। আসুন আরেকবার দেখি আমরা কোথায় আছি:
def extract_data
def extract_data(detail_page)
  interviewee = extract_interviewee(detail_page)
  title = extract_title(detail_page)
  sc_id = extract_soundcloud_id(detail_page)
  text = extract_shownotes_text(detail_page)
  episode_subtitle = extract_subtitle(detail_page)
  episode_number = extract_episode_number(episode_subtitle)
  date = clean_date(episode_subtitle)
  tags = build_tags(title, interviewee)
  options = {
    interviewee: interviewee,
    title: title,
    sc_id: sc_id,
    text: text,
    tags: tags,
    date: date,
    episode_number: episode_number
  }
end
এখানে বাকি থাকলো শুধু আমরা এক্সট্রাক্ট করা ডেটার সাথে একটি অপশনস হ্যাশ রিটার্ন করি। আমরা এই হ্যাশকে compose_markdown মেথডে ফিড করতে পারি, যা আমাদের ডেটা রেডি করে দেয় ফাইল হিসেবে লিখে ফেলার জন্য যা আমার নতুন সাইটের জন্য লাগবে।
পোস্ট লিখা
def compose_markdown
def compose_markdown(options={})
  <<-HEREDOC
---
title: #{options[:interviewee]}
interviewee: #{options[:interviewee]}
topic_list: #{options[:title]}
tags: #{options[:tags]}
soundcloud_id: #{options[:sc_id]}
date: #{options[:date]}
episode_number: #{options[:episode_number]}
---
#{options[:text]}
HEREDOC
end
আমার Middleman সাইটে পডকাস্ট এপিসোড পাবলিশ করার জন্য, আমি এর ব্লগিং সিস্টেমকে রিপারপোজ করলাম। "পিউর" ব্লগ পোস্ট তৈরি করার বদলে, আমি আমার এপিসোডের শো নোটস তৈরি করি যা SoundCloud-হোস্টেড এপিসোডগুলো iframe দিয়ে ডিসপ্লে করে। ইনডেক্স সাইটসে, আমি শুধু সেই iframe প্লাস টাইটেল ও কিচু ডিসপ্লে করি।
এটি কাজ করার জন্য যে ফরম্যাট লাগে সেটি কমপোজড কিছু বলা হয় ফ্রন্ট ম্যাটার। এটি মূলত আমার স্ট্যাটিক সাইটের জন্য একটি কি/ভ্যালু স্টোর। এটি আমার পুরনো সিনাতারা সাইটের ডাটাবেস চাহিদাকে রিপ্লেস করছে।
ইন্টারভিউইর নাম, তারিখ, সাউন্ডক্লাউড ট্র্যাক আইডি, এপিসোড নম্বর ইত্যাদি ডেটা আমাদের এপিসোড ফাইলগুলোর 탑ে তিনটি ড্যাশ (---)র মাঝপথে থাকে। নিচে আসে প্রতিটি এপিসোডের কন্টেন্ট—প্রশ্ন, লিংক, স্পন্সর স্টাফ, ইত্যাদি।
ফ্রন্ট ম্যাটার
---
key: value
key: value
key: value
key: value
---
Episode content goes here.
compose_markdown মেথডে, আমি একটি HEREDOC ব্যবহার করি সেটি ফাইল কম্পোজ করতে এর ফ্রন্ট ম্যাটারসহ প্রতিটি এপিসোডের জন্য যেগুলো আমরা লুপ করি। আমরা এই মেথডে ফিড করা অপশনস হ্যাশ থেকে, extract_data হেল্পার মেথডে কালেক্ট করা সকল ডেটা এক্সট্রাক্ট করি।
def compose_markdown
...
<<-HEREDOC
---
title: #{options[:interviewee]}
interviewee: #{options[:interviewee]}
topic_list: #{options[:title]}
tags: #{options[:tags]}
soundcloud_id: #{options[:sc_id]}
date: #{options[:date]}
episode_number: #{options[:episode_number]}
---
#{options[:text]}
HEREDOC
...
এখানেই আছে একটি নতুন পডকাস্ট এপিসোডের ব্লুপ্রিন্ট। এটিই আমরা খুঁজে পেয়েছি। আপনি এই নির্দিষ্ট সিনট্যাক্স: #{options[:interviewee]} নিয়ে চিন্তা করতে পারেন। আমি স্ট্রিং-এর সাথে সাধারণভাবে ইন্টারপোলেট করি, কিন্তু যেহেতু আমি ইতিমধ্যে একটি <<-HEREDOC-এর ভিতরে আছি, আমি ডবল কোটস বাদ দিতে পারি।
আমাদের অরিয়েন্টেশন জন্য, আমরা এখনো লুপের ভিতরে আছি, write_page ফাংশনের ভিতরে প্রতিটি ক্লিক করা লিংকের জন্য যা একটি ডিটেইল পেজে নিয়ে যায় একটি সিঙ্গুলার এপিসোডের শো নোটসের সাথে। এরপর কী হয় সেটি এই ব্লুপ্রিন্টকে ফাইল সিস্টেমে লিখতে প্রস্তুত করা। অন্য কথায়, আমরা একটি ফাইল নাম এবং কম্পোজড markdown_text দিয়ে প্রকৃত এপিসোড তৈরি করি।
সেটি চূড়ান্ত ধাপের জন্য, আমাদের শুধু নিচের উপাদানগুলো প্রস্তুত করতে হবে: তারিখ, ইন্টারভিউইর নাম, এবং এপিসোড নম্বর। প্লাস markdown_text অবশ্যই, যা আমরা এখনই পেলাম compose_markdown- থেকে।
def write_page
...
markdown_text = compose_markdown(extracted_data)
date = extracted_data[:date]
interviewee = extracted_data[:interviewee]
episode_number = extracted_data[:episode_number]
file_name = "#{date}-#{dasherize(interviewee)}-#{episode_number}.html.erb.md"
...
তারপর আমাদের শুধু file_name এবং markdown_text নিয়ে ফাইল লিখতে হবে।
def write_page
...
File.open(file_name, 'w') { |file| file.write(markdown_text) }
...
এটিও ব্রেক ডাউন করি। প্রতিটি পোস্টের জন্য, আমাকে একটি নির্দিষ্ট ফরম্যাট লাগে: কিছু যেন 2016-10-25-Avdi-Grimm-120। আমি এমন ফাইল লিখতে চাই যা তারিখ দিয়ে শুরু হয় এবং ইন্টারভিউইর নাম এবং এপিসোড নম্বর ইনক্লুড করে।
Middleman নতুন পোস্টের জন্য যে ফরম্যাট এক্সপেক্ট করে সেটি ম্যাচ করতে, আমাকে ইন্টারভিউইর নাম নিয়ে আমার হেল্পার মেথড দিয়ে dasherize করতে হলো, Avdi Grimm-কে Avdi-Grimm-এ রূপান্তর করতে। কিছু জাদু নয়, কিন্তু এক নজর দেওয়া যাক:
def dasherize
def dasherize(text)
  text.lstrip.rstrip.tr(' ', '-')
end
এটি আমরা ইন্টারভিউইর নামের জন্য স্ক্র্যাপ করা টেক্সট থেকে হোয়াইটস্পেস রিমুভ করে এবং Avdi ও Grimm-এর মাঝপথের হোয়াইটস্পেসকে ড্যাশ দিয়ে রিপ্লেস করে। ফাইল নামের বাকি অংশ স্ট্রিং-এই ড্যাশ দিয়ে জড়িয়ে দেওয়া হয়েছে: "date-interviewee-name-episodenumber"।
def write_page
...
"#{date}-#{dasherize(interviewee)}-#{episode_number}.html.erb.md"
...
যেহেতু এক্সট্রাক্ট করা কন্টেন্ট সরাসরি একটি HTML সাইট থেকে আসছে, আমি সিম্পলি .md বা .markdown ফাইলনেম এক্সটেনশন হিসেবে ব্যবহার করতে পারি না। আমি .html.erb.md দিয়ে যেতে সিদ্ধান্ত নিলাম। ভবিষ্যতের এপিসোডগুলো যেগুলো আমি স্ক্র্যাপ ছাড়া কম্পোজ করব, সেগুলোর জন্য আমি .html.erb অংশ বাদ দিতে পারি এবং শুধু .md দরকার হবে।
এই ধাপের পর, scrape ফাংশনের লুপটি শেষ হয়, এবং আমাদের একটি সিঙ্গুলার এপিসোড থাকা উচিত যা এভাবে দেখাবে:
2014-12-01-Avdi-Grimm-1.html.erb.md
---
title: Avdi Grimm
interviewee: Avdi Grimm
topic_list: What is Rake | Origins | Jim Weirich | Common use cases | Advantages of Rake
tags: Avdi Grimm, What is Rake , Origins , Jim Weirich , Common use cases , Advantages of Rake
soundcloud_id: 179619755
date: 2014-12-01
episode_number: 1
---
Questions:
- What is Rake?
- What can you tell us about the origins of Rake?
- What can you tell us about Jim Weihrich?
- What are the most common use cases for Rake?
- What are the most notable advantages of Rake?
Links:
In">https://www.youtube.com/watch?v=2ZHJSrF52bc">In memory of the great Jim Weirich
Rake">https://github.com/jimweirich/rake">Rake on GitHub
Jim">https://github.com/jimweirich">Jim Weirich on GitHub
Basic">https://www.youtube.com/watch?v=AFPWDzHWjEY">Basic Rake talk by Jim Weirich
Power">https://www.youtube.com/watch?v=KaEqZtulOus">Power Rake talk by Jim Weirich
Learn">https://devblog.avdi.org/2014/04/30/learn-advanced-rake-in-7-episodes/">Learn advanced Rake in 7 episodes - from Avdi Grimm ( free )
Avdi">https://about.avdi.org/">Avdi Grimm
Avdi Grimm’s screencasts:
Ruby">https://www.rubytapas.com/">Ruby Tapas
Ruby">https://devchat.tv/ruby-rogues/">Ruby Rogues podcast with Avdi Grimm
Great ebook:
Rake">https://www.amazon.com/Rake-Management-Essentials-Andrey-Koleshko/dp/1783280778">Rake Task Management Essentials fromhttps://twitter.com/ka8725"> Andrey Koleshko
এই স্ক্র্যাপারটি শেষ এপিসোড থেকে শুরু করবে, অবশ্যই, এবং প্রথম এপিসোড পর্যন্ত লুপ করবে। ডেমোন্সট্রেশন উদ্দেশ্যে, এপিসোড ০১ অন্য যেকোনো কেমন। আপনি টপে ফ্রন্ট ম্যাটার দেখতে পাচ্ছেন এক্সট্রাক্ট করা ডেটা সহ।
এই সব কিছু আগে আমার সিনাতারা অ্যাপের ডাটাবেসে লক করা ছিল—এপিসোড নম্বর, তারিখ, ইন্টারভিউইর নাম, এবং আরও। এখন আমাদের সেটি প্রস্তুত আছে আমার নতুন স্ট্যাটিক Middleman সাইটের অংশ হতে। দুই ট্রিপল ড্যাশ (---)র নিচে যা আছে সেটি শো নোটস থেকে টেক্সট: অধিকাংশ প্রশ্ন এবং লিংক।
চূড়ান্ত চিন্তা
এবং আমরা শেষ করলাম। আমার নতুন পডকাস্ট ইতিমধ্যে আপ এবং রানিং। আমি খুব খুশি যে আমি জমিন থেকে রিডিজাইন করার জন্য সময় নিলাম। এখন নতুন এপিসোড পাবলিশ করা অনেক কুল। ব্যবহারকারীদের জন্য নতুন কন্টেন্ট ডিসকভার করাও স্মুথ হয়ে যাবে।
যে কথা আমি আগে বলেছিলাম, এখন আপনার কোড এডিটরে যাওয়ার সময় যাতে কিছু ফান করতে পারেন। এই কোড নিন এবং এর সাথে একটু ভিড়ান। এটি সিম্পলার করার উপায় খুঁজুন। কোড রিফ্যাক্টরের কিছু সুযোগ রয়েছে।
সামান্যভাবে, আমি আশা করি এই ছোট উদাহরণ আপনাকে একটি ভালো আইডিয়া দিয়েছে যে আপনি আপনার নতুন ওয়েব স্ক্র্যাপিং চপস দিয়ে কী করতে পারেন। অবশ্যই আপনি অনেক বেশি সফিস্টিকেটেড চ্যালেঞ্জ অর্জন করতে পারেন—আমি নিশ্চিত এখানে এমন ছোট ছোট বিজনেস সুযোগও আছে যা এই স্কিল দিয়ে করা যায়।
কিন্তু সবসময়, একটু একটু এগিয়ে যান, এবং যদি জিনিসগুলো একবারে ক্লিক না করে তবে খুব ফ্রাস্ট্রেটেড হবেন না। এটি অধিকাংশ মানুষের জন্য স্বাভাবিক কথা এবং এক্সপেক্টেডও। এটি যাত্রার অংশ। শুভ স্ক্র্যাপিং!
