

Elasticsearch 5-এ সবচেয়ে কুল নতুন ফিচারগুলোর একটা হলো ইনজেস্ট নোড, যা কিছু Logstash-স্টাইল প্রসেসিং Elasticsearch ক্লাস্টারে অ্যাড করে, যাতে ডেটা ইনডেক্স করার আগে ট্রান্সফর্ম করা যায় অন্য কোনো সার্ভিস এবং/অথবা ইনফ্রাস্ট্রাকচার ছাড়া। একটু সময় আগে, আমরা একটি কুইক ব্লগ পোস্ট করেছিলাম কীভাবে CSV ফাইল পার্স করবেন Logstash দিয়ে, তাই আমি ইনজেস্ট পাইপলাইন ভার্সনটি প্রদান করতে চাই তুলনার জন্য।
এখানে আমরা দেখাবো একটি উদাহরণ Filebeat ব্যবহার করে ডেটা শিপ করার জন্য একটি ইনজেস্ট পাইপলাইনে, ইনডেক্স করা, এবং Kibana দিয়ে ভিজ্যুয়ালাইজ করা।
ডেটা
ফ্রি ডেটার জন্য টনস চমৎকার সোর্স রয়েছে, কিন্তু যেহেতু ObjectRocket-এ আমাদের অধিকাংশ Austin, TX-এ থাকি, আমরা data.austintexas.gov থেকে কিছু ডেটা ব্যবহার করব। রেস্টুরেন্ট ইনস্পেকশন ডেটা সেট একটি ভালো সাইজ ডেটা সেট যেটির যথেষ্ট রিলেভেন্ট ইনফরমেশন রয়েছে একটি রিয়েল ওয়ার্ল্ড উদাহরণ দিতে।
নিচে এই ডেটা সেট থেকে কয়েক লাইন দেওয়া হলো ডেটার স্ট্রাকচার বোঝার জন্য:
Restaurant Name,Zip Code,Inspection Date,Score,Address,Facility ID,Process Description
Westminster Manor,78731,07/21/2015,96,"4100 JACKSON AVE AUSTIN, TX 78731 (30.314499, -97.755166)",2800365,Routine Inspection
Wieland Elementary,78660,10/02/2014,100,"900 TUDOR HOUSE RD AUSTIN, TX 78660 (30.422862, -97.640183)",10051637,Routine Inspection
DOH... এটি একটি নাইস, ফ্রেন্ডলি, সিঙ্গেল লাইন পার এন্ট্রি কেস হবেনা, কিন্তু এটা ঠিক আছে। আপনি যেন দেখছেন, Filebeat-এ কিছু বিল্ট-ইন এবিলিটি রয়েছে মাল্টিলাইন এন্ট্রি হ্যান্ডেল করতে এবং ডেটার ভেতর ফেলা নিউলাইনর উদ্দেশ্য ওয়ার্কঅরাউন্ড করতে।
এডিটোরিয়াল নোট: আমি একটি নাইস সিম্পল উদাহরণ প্ল্যান করেছিলাম কম "হিচ" সহ, কিন্তু শেষে, আমি মনে করলাম কিছু টুলস দেখাতে যেটি Elastic Stack আপনার দিয়ে এই সিনেরিওর উদ্দেশ্য ওয়ার্কঅরাউন্ড করতে।
Filebeat সেট আপ করা
প্রথম ধাপ হলো Filebeat রেডি করা ডেটা শিপ করা শুরু করতে আপনার Elasticsearch ক্লাস্টারের দিকে। একবার আপনি Filebeat ডাউনলোড করলেন (চেষ্টা করুন আপনার ES ক্লাস্টারের সেম ভার্সন ব্যবহার করতে) এবং এক্সট্রাক্ট করলেন, এটি ইনক্লুডেড filebeat.yml কনফিগারেশন ফাইল দিয়ে অত্যন্ত সহজ সেট আপ করা যায়। আমাদের সিনেরিওর জন্য, এখানে কনফিগারেশন যা আমি ব্যবহার করছি:
filebeat.prospectors:
- input_type: log
  paths:
    - /Path/To/logs/*.csv
  # Ignore the first line with column headings
  exclude_lines: ["^Restaurant Name,"]
  # Identifies the last two columns as the end of an entry and then prepends the previous lines to it
  multiline.pattern: ',\d+,[^\",]+$'
  multiline.negate: true
  multiline.match: before
#================================ Outputs =====================================
output.elasticsearch:
  # Array of hosts to connect to.
  hosts: ["https://dfw-xxxxx-0.es.objectrocket.com:xxxxx", "https://dfw-xxxxx-1.es.objectrocket.com:xxxxx", "https://dfw-xxxxx-2.es.objectrocket.com:xxxxx", "https://dfw-xxxxx-3.es.objectrocket.com:xxxxx"]
  pipeline: "inspectioncsvs"
  # Optional protocol and basic auth credentials.
  username: "esuser"
  password: "supersecretpassword"
এখানে সব কিছু প্রিটি স্ট্রেটফরওয়ার্ড; আপনার একটি সেকশন রয়েছে ইনপুট ফাইলগুলো কোথা থেকে এবং কীভাবে গ্র্যাব করবেন সেটি স্পেসিফাই করার জন্য এবং একটি সেকশন ডেটা কোথায় শিপ করবেন সেটি স্পেসিফাই করার জন্য। আমি শুধু দুটি পার্ট স্পেসিফিক্যালি কল আউট করব: মাল্টিলাইন বিট এবং Elasticsearch কনফিগারেশন পিস।
যেহেতু এই ডেটা সেটের ফরম্যাটিং সুপার স্ট্রিক্ট নয়, ডবল কোটের ইনকনসিস্টেন্ট ইউজ এবং ডেটার ভেতরে ছড়ানো কিছু নিউলাইন রয়েছে, সেরা অপশন ছিল একটি এন্ট্রির শেষ খুঁজে বের করা, যেটি কনসিস্ট করে একটি নমেরিক আইডি ফলোড বাই ইনস্পেকশন টাইপ χωρίς অনেক ভ্যারিয়েশন বা ডবল-কোটস/নিউলাইন। সেখান থেকে, Filebeat শুধু কিউ আপ করবে যেকোনো আনম্যাচড লাইন এবং প্রিপেন্ড করবে সেগুলো ফাইনাল লাইন যা প্যাটার্ন ম্যাচ করে। আপনার ডেটা ক্লিনার হলে এবং সিম্পল লাইন পার এন্ট্রি ফরম্যাটে আটকে থাকলে, আপনি প্রায় মাল্টিলাইন সেটিংস ইগনোর করতে পারেন।
Elasticsearch আউটপুট সেকশনে দেখতে, এটি স্ট্যান্ডার্ড Elasticsearch সেটিংস সাথে একটি ছোট অ্যাডিশন পাইপলাইনের নাম যা আপনি ব্যবহার করতে চান pipeline: ডিরেক্টিভ দিয়ে। আপনি যদি ObjectRocket সার্ভিসে থাকেন, আপনি শুধু আউটপুট স্নিপেট গ্র্যাব করতে পারেন UI-র "Connect" ট্যাব থেকে, যা প্রিপপুলেটেড আসবে সব সঠিক হোস্টসহ, এবং শুধু pipeline লাইনটি যোগ করুন এবং আপনার ইউজার এবং পাসওয়ার্ড ফিল আপ করুন। এছাড়া, নিশ্চিত করুন আপনার সিস্টেমের IP আপনার ক্লাস্টারের ACLs-এ অ্যাড করা আছে যদি আপনি ইতিমধ্যে না করে থাকেন।
ইনজেস্ট পাইপলাইন তৈরি করা
এখন যেহেতু আমাদের ইনপুট ডেটা এবং Filebeat রেডি, আমরা আমাদের ইনজেস্ট পাইপলাইন তৈরি এবং টিউন করতে পারি। পাইপলাইনের মূল টাস্কগুলো হলো:
- CSV কন্টেন্ট সঠিক ফিল্ডগুলোর মধ্যে Сплиট করা
- ইনস্পেকশন স্কোর ইন্টিজারে কনভার্ট করা
@timestampফিল্ড সেট করা- কিছু অন্যান্য ডেটা ফরম্যাটিং ক্লিন আপ করা
এখানে একটি পাইপলাইন যা সেটি সব করতে পারে:
PUT _ingest/pipeline/inspectioncsvs
{
  "description" : "Convert Restaurant inspections csv data to indexed data",
  "processors" : [
    {
      "grok": {
        "field": "message",
        "patterns": ["%{REST_NAME:RestaurantName},%{REST_ZIP:ZipCode},%{MONTHNUM2:InspectionMonth}/%{MONTHDAY:InspectionDay}/%{YEAR:InspectionYear},%{NUMBER:Score},\"%{DATA:StreetAddress}\n%{DATA:City},?\\s+%{WORD:State}\\s*%{NUMBER:ZipCode2}\\s*\n\\(?%{DATA:Location}\\)?\",%{NUMBER:FacilityID},%{DATA:InspectionType}$"],
        "pattern_definitions": {
          "REST_NAME": "%{DATA}|%{QUOTEDSTRING}",
          "REST_ZIP": "%{QUOTEDSTRING}|%{NUMBER}"
        }
      }
    },
    {
      "grok": {
        "field": "ZipCode",
        "patterns": [".*%{ZIP:ZipCode}\"?$"],
        "pattern_definitions": {
          "ZIP": "\\d{5}"
        }
      }
    },
    {
      "convert": {
        "field" : "Score",
        "type": "integer"
      }
    },
    {
      "set": {
        "field" : "@timestamp",
        "value" : "//"
      }
    },
    {
      "date" : {
        "field" : "@timestamp",
        "formats" : ["yyyy/MM/dd"]
      }
    }
  ],
  "on_failure" : [
    {
      "set" : {
        "field" : "error",
        "value" : " - Error processing message - "
      }
    }
  ]
}
Logstash-এর আলাদা, ইনজেস্ট পাইপলাইনে (এই লেখার সময়) CSV প্রসেসর/প্লাগইন নেই, তাই আপনাকে CSV-গুলো নিজে ট্রান্সফর্ম করতে হবে। আমি একটি গ্রক প্রসেসর ব্যবহার করলাম ভারি লিফটিং করার জন্য, যেহেতু প্রতিটি রোয়ে কয়েক কলাম মাত্র ছিল। অনেক বেশি কলামের ডেটার জন্য, গ্রক প্রসেসর খুব জটিল হতে পারে, তাই আরেকটি অপশন হলো স্প্লিট প্রসেসর এবং কিছু পেনলেস স্ক্রিপ্টিং ব্যবহার করে লাইনটি প্রসেস করা একটি আরও ইটারেটিভ ফ্যাশনে। আপনি এছাড়া দ্বিতীয় গ্রক প্রসেসরও লক্ষ্য করতে পারেন, যা শুধু সেখানে আছে এই ডেটা সেটে জিপ কোডের দুটি ভিন্ন উপায়ে এন্টার করা হয়েছে সেটি হ্যান্ডেল করার জন্য।
ডিবাগ উদ্দেশ্যে, আমি একটি জেনেরিক on_failure সেকশন ইনক্লুড করলাম যা সব এরর ক্যাচ করবে এবং প্রিন্ট করবে কোন টাইপের প্রসেসর ফেইল করেছে এবং মেসেজটি কী যা পাইপলাইন ভাঙল। এটি ডিবাগ অনেক সহজ করে দেয়। আমি শুধু আমার ইনডেক্স কোয়ারী করতে পারি যেকোনো ডকুমেন্ট যেগুলোর error সেট আছে এবং তারপর সিমুলেট API দিয়ে ডিবাগ করতে পারি। আরও সেটি নিয়ে এখন...
পাইপলাইন টেস্ট করা
এখন যেহেতু আমাদের ইনজেস্ট পাইপলাইন কনফিগার্ডেড, আসুন টেস্ট এবং রান করি সিমুলেট API দিয়ে। প্রথম আপনাকে একটি স্যাম্পল ডকুমেন্ট দরকার। আপনি এটি কয়েকভাবে করতে পারেন। আপনি কখনো Filebeat রান করতে পারেন পাইপলাইন সেটিং ছাড়া এবং তারপর শুধু একটি আনপ্রসেসড ডকুমেন্ট গ্র্যাব করতে পারেন Elasticsearch থেকে, অথবা আপনি Filebeat রান করতে পারেন কনসোল আউটপুট ইনাবল করে, Elasticsearch সেকশন কমেন্ট আউট করে এবং নিচেরটি yml ফাইলে অ্যাড করে:
output.console:
  pretty: true
এখানে আমার এনভায়রনমেন্ট থেকে একটি স্যাম্পল ডকুমেন্ট যা আমি গ্র্যাব করেছিলাম:
POST _ingest/pipeline/inspectioncsvs/_simulate
{
  "docs" : [
    {
      "_index": "inspections",
      "_type": "log",
      "_id": "AVpsUYR_du9kwoEnKsSA",
      "_score": 1,
      "_source": {
        "@timestamp": "2017-03-31T18:22:25.981Z",
        "beat": {
          "hostname": "systemx",
          "name": "RestReviews",
          "version": "5.1.1"
        },
        "input_type": "log",
        "message": "Wieland Elementary,78660,10/02/2014,100,\"900 TUDOR HOUSE RD\nAUSTIN, TX 78660\n(30.422862, -97.640183)\",10051637,Routine Inspection",
        "offset": 2109798,
        "source": "/Path/to/my/logs/Restaurant_Inspection_Scores.csv",
        "tags": [ "debug", "reviews" ],
        "type": "log"
      }
    }
  ]
}
এবং রেসপন্স (আমি এটি ট্রিম করেছি সেই ফিল্ডগুলোর মধ্যে যা আমরা সেট করার চেষ্টা করছিলাম):
{
  "docs": [
    {
      "doc": {
        "_id": "AVpsUYR_du9kwoEnKsSA",
        "_type": "log",
        "_index": "inspections",
        "_source": {
          "InspectionType": "Routine Inspection",
          "ZipCode": "78660",
          "InspectionMonth": "10",
          "City": "AUSTIN",
          "message": "Wieland Elementary,78660,10/02/2014,100,\"900 TUDOR HOUSE RD\nAUSTIN, TX 78660\n(30.422862, -97.640183)\",10051637,Routine Inspection",
          "RestaurantName": "Wieland Elementary",
          "FacilityID": "10051637",
          "Score": 100,
          "StreetAddress": "900 TUDOR HOUSE RD",
          "State": "TX",
          "InspectionDay": "02",
          "InspectionYear": "2014",
          "ZipCode2": "78660",
          "Location": "30.422862, -97.640183"
        },
        "_ingest": {
          "timestamp": "2017-03-31T20:36:59.574+0000"
        }
      }
    }
  ]
}
পাইপলাইন অবশ্যই সফল হয়েছে, কিন্তু সবচেয়ে গুরুত্বপূর্ণ, সব ডেটা সঠিক জায়গায় দিয়েছে।
filebeat চালানো
Filebeat রান করার আগে, আমরা একটা লাস্ট জিনিস করব। এই পার্ট সম্পূর্ণ অপশনাল যদি আপনি শুধু ইনজেস্ট পাইপলাইন দিয়ে কমফরটেবল হতে চান, কিন্তু আপনি যদি Location ফিল্ডটি যা আমরা গ্রক প্রসেসরে সেট করেছি জিও-পয়েন্ট হিসেবে ব্যবহার করতে চান, আপনাকে filembeat.template.json ফাইলে ম্যাপিং অ্যাড করতে হবে, নিচেরটি প্রপার্টিজ সেকশনে অ্যাড করে:
"Location": {
  "type": "geo_point"
},
এখন যেহেতু সেটি বের হয়ে গেছে, আমরা Filebeat ফায়ার আপ করতে পারি ./filebeat -e -c filebeat.yml -d "elasticsearch" রান করে।
ডেটা ব্যবহার করা
GET /filebeat-*/_count
{}
{
  "count": 25081,
  "_shards": {
    "total": 5,
    "successful": 5,
    "failed": 0
  }
}
এটা একটি ভাল সাইন! আসুন দেখি কোনো এরর ছিল কিনা:
GET /filebeat-*/_search
{
  "query": {
    "exists" : {
      "field" : "error"
    }
  }
}
{
  "took": 1,
  "timed_out": false,
  "_shards": {
    "total": 5,
    "successful": 5,
    "failed": 0
  },
  "hits": {
    "total": 0,
    "max_score": null,
    "hits": []
  }
}
আরেকটি ভাল সাইন!
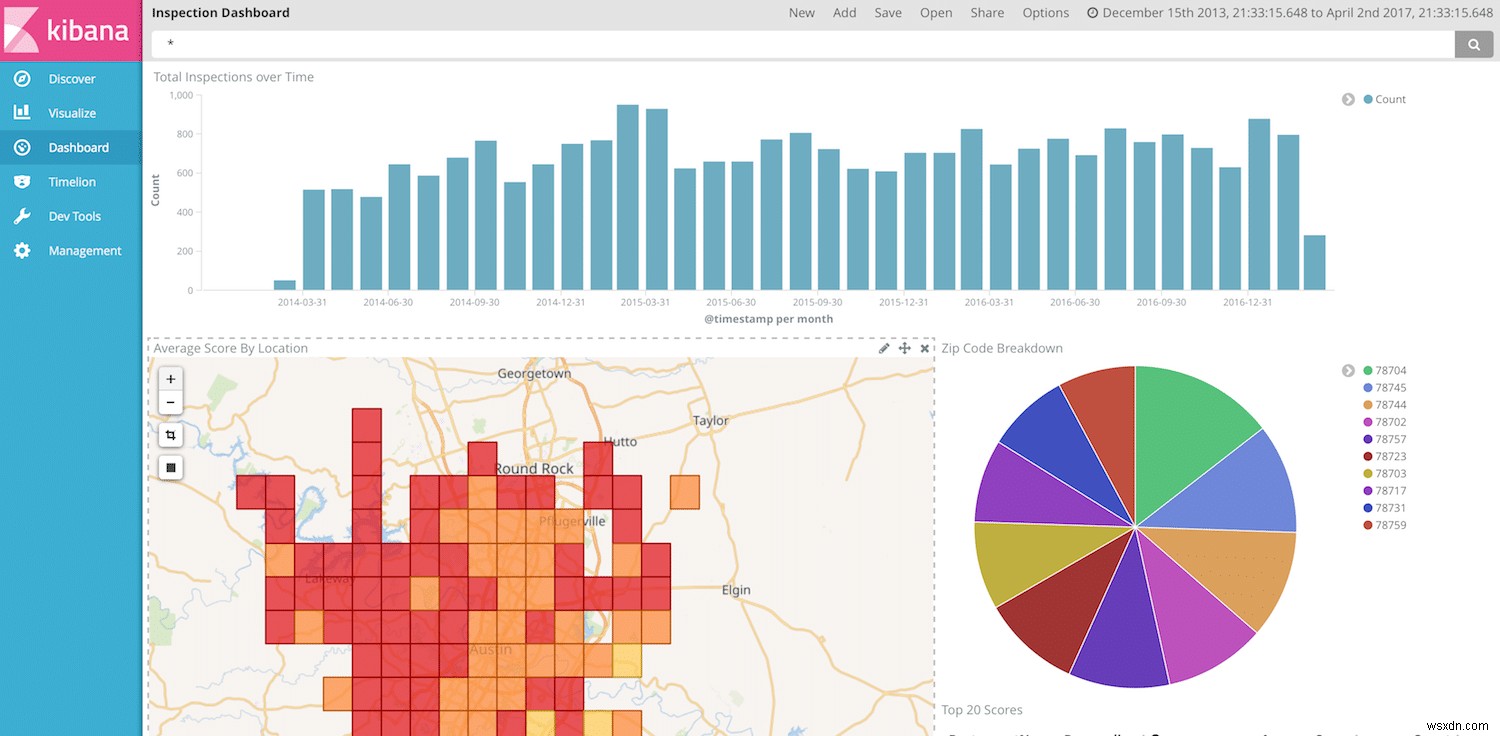
এখন আমরা সেট আপ কৃত্রিম ভিজ্যুয়ালাইজেশন এবং আমাদের ডেটা Kibana-এ দেখাতে। আমরা Kibana ড্যাশবোর্ড তৈরি করার ওয়াকথ্রু অন্য সময় করব, কিন্তু যেহেতু আমাদের ডেটা, রেস্টুরেন্ট নাম, স্কোর এবং লোকেশন রয়েছে, আমাদের প্রাচুর্য ফ্রিডম রয়েছে কিছু কুল ভিজ্যুয়ালাইজেশন তৈরি করার।
চূড়ান্ত নোটস
একবার আবার, ইনজেস্ট পাইপলাইন খুব পাওয়ারফুল এবং ট্রান্সফরমেশন খুব সহজে হ্যান্ডেল করতে পারে। আপনি আপনার সকল প্রসেসিং Elasticsearch-এ মুভ করতে পারেন এবং শুধু লাইটওয়েট Beats আপনার হোস্টসে ব্যবহার করতে পারেন, Logstash কোথাও পাইপলাইনে রিকোয়ার না করে। যेड্যাক, ইনজেস্ট নোডে Logstash-এর চেয়ে কিছু গ্যাপ রয়েছে। উদাহরণস্বরূপ, ইনজেস্ট পাইপলাইনে উপলব্ধ প্রসেসরের সংখ্যা এখনও লিমিটেড, তাই CSV পার্স করার মত সিম্পল টাস্ক Logstash-এ যেন সহজ নয়। Elasticsearch টিম লাগতার নতুন প্রসেসর রোল আউট করছে, তাই আশা করি পার্থক্যের লিস্ট ছোট থেকে ছোটتر হয়ে যাবে।
